GPU 总是不够用,实验却未必越大越好。如何用有限的算力,找到值得投入更多资源的研究方向?
这几个月,我一边忙着管理集群,一边和 Druv 把 Nestor 搓了出来。本文就是这段经历的产物。
学校集群通常会遇到一个周期性问题:大家都认为自己的项目很重要,都想要更多资源。可看着某些低利用率的任务占着集群跑,我还是忍不住心疼。学校的计算资源一般来自政府资助,盲目烧 GPU,某种程度上也是在消耗公共资源。
这篇文章想给组里的同学提供一些基本的入门指导。我希望大家读完后,至少能对 GPU 使用有个概念;如果还能学到一些向 agent 下达任务的经验,那就更好了。
文章主要分为三部分:
- 科学部分:Scaling Ladder 是什么,为什么要用?
- 经验部分:具体实验中该怎么运用它?
- 申请更多 GPU 之前,有哪些事情值得检查?
Scaling Ladder 是什么,为什么要用?
关于 Scaling Law 的介绍已经有很多,例如参考文献 [2]。写这篇文章时,我也恰好看到 purshow 老师的一篇相关博客 [1]。
简单来说,当你有至少四组横跨不同计算量的实验记录时,就可以尝试拟合下面这条幂律曲线:
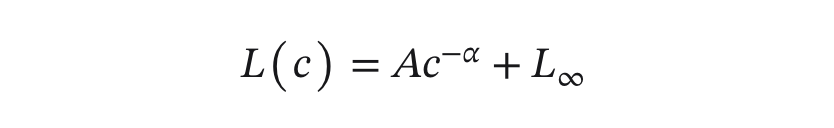
这条曲线出自参考文献 [6]。有了它,你可以做两件事:
- 不必真的运行更大的实验,就尝试预测大规模实验的性能。如果算力足够,也可以用小规模数据点拟合出的曲线,帮助检查大实验的结果是否合理。
- 比较不同模型各自的曲线,判断哪种模型更有效。
比较和预测所需的计算量,可以根据模型结构估算理论浮点运算量。这样,在投入大规模实验之前,心里多少有个底。
受 Tatsunori Hashimoto 教授课程 [3] 的启发,我想到另一个解释 Scaling Ladder 用处的角度。
Scaling Ladder 是博士生的预测目标
反过来想:当你在训神经网络时,实验记录也在反过来训练你的大脑。
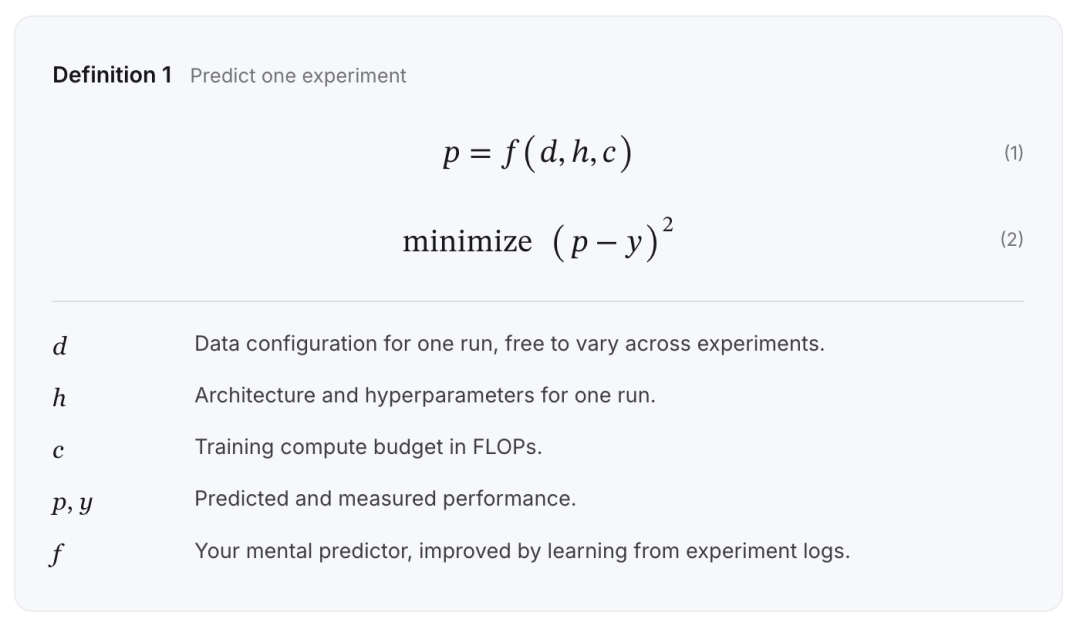
实验记录包含输入,也就是数据、模型结构和计算量,以及标签,也就是模型效果。从这个角度看,你可以在博士生涯中不断调整自己的预测,尽量减小预测值和实测值之间的误差。
但单个模型的效果未必是一个好的预测目标。比如,这里使用的是 L2 loss;不同模型的效果分布也未必适合直觉学习。再加上超参数、数据配比和模型结构的排列组合太多,大脑可能根本记不住。
怎么让这个学习过程更高效?我的建议是使用 Scaling Ladder,或者至少在设计实验时对它有个概念。
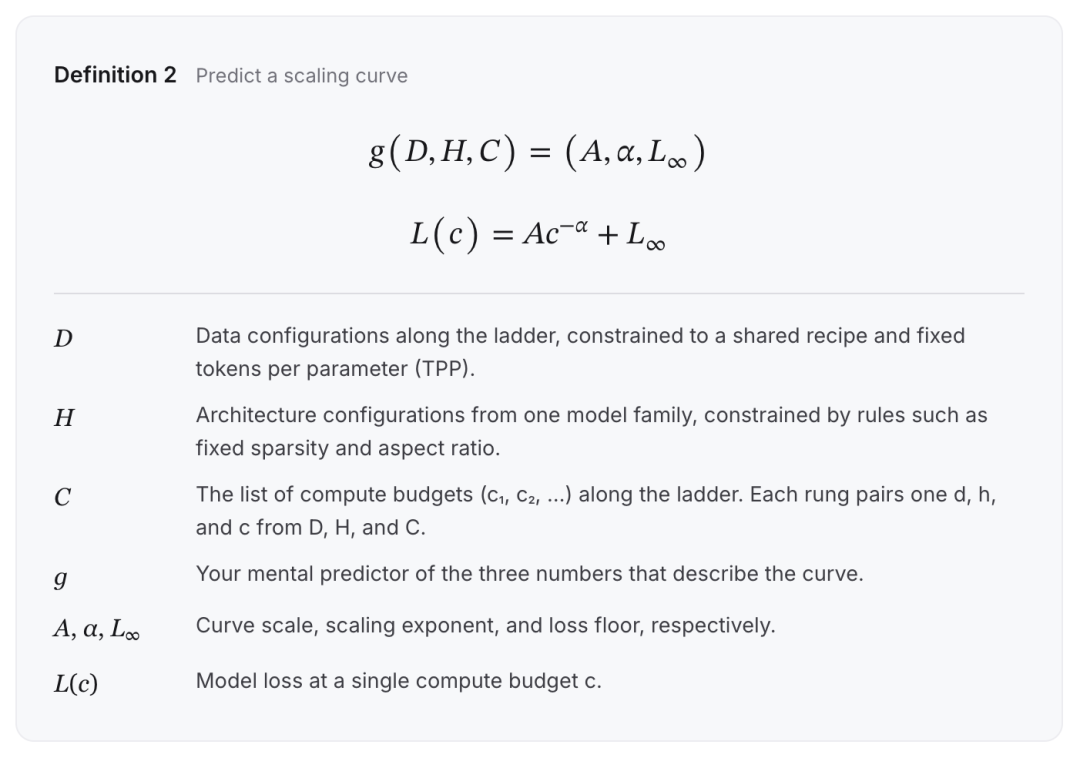
这时,输入和预测目标都变了。
我们使用更有结构、更受约束的输入:Scaling Ladder 要求固定每个参数对应的 token 数量,也就是 TPP;在模型结构配置上,至少还要固定稀疏度、深度与宽度之比等条件。
预测目标也从复杂度为 $O(n)$ 的多个数据点,变成了三个变量:曲线尺度 $A$、Scaling 指数 $\alpha$ 和损失下限 $L_\infty$。
这种设计可以看作一种数据增强手段:它不仅增强了数据点之间的关联,也降低了预测目标的噪声和复杂度。
实验经验
着手做 Scaling Ladder 之前,先想清楚两件事:横轴和纵轴分别选什么?
横轴通常使用 FLOPs;更实际一点,也可以选真实的 GPU 训练时间。纵轴则比较难选,语言模型相对容易一些。
我老板原本做计算机视觉,一开始不太理解我为什么转向语言模型。后来实验结果说服了他:我在 ImageNet 上怎么折腾都没有明显成功迹象的模型,换到 DCLM 后却顺利了许多。
因此,下文假设你正在做语言模型预训练,或者用类似方式训练多模态语言模型,又或者已经找到了适合自己领域的纵轴统计量。
配置实验点
确定纵轴后,下一个问题是每个数据点的配置。通常可以按照 $1\times$、$2\times$、$4\times$、$8\times$ 选择规模,这样它们在对数坐标上会均匀分布。
接下来,还要保证模型训练时使用了足够的数据。
TPP 通常越高越好。Chinchilla 的计算最优配置建议将 TPP 设为 20 [7];对 MoE 来说,最优 TPP 有其他计算方式 [8]。
不过,学术界的计算资源有限,TPP 也别选得太大。我们的 Nestor 论文选择了 50 [5]。
配置模型结构时,还有一个容易纠结的问题:要不要抹平不同变体之间的 FLOPs 差异?
假设你要比较结构 A 和结构 B,而 B 因为一个小的稀疏注意力改动,FLOPs 更低。Scaling Ladder 并不要求每个数据点的 FLOPs 一一对应;但资源有限时,最好还是考虑适当调整 B 的配置,让两者的 FLOPs 尽量一致。
这样,每个数据点都可以直接比较。如果新结构在小规模上就明显优于基准线,扩大实验规模时也会更有把握。
MFU:并行策略与实际计算量
配置完成后,就该跑实验了。最简单的做法是直接给 agent 下指令:“给我拼命跑实验,把 MFU 拉满。”
但光靠这句话通常不够。举个例子,Nestor 的原生 kernel 就被社交平台上的开发者轻松超越了 [4]。以下是我从实践中总结出的两个教训。
并行策略和模型规模是绑定的。我翻看实验记录时发现:在 200M 规模的实验中,对优化器做分片会让实验变慢;而在 1B 规模的实验中,并行则可以支持更大的 batch size。
总体经验是:复杂的分片策略可能有助于提高大模型的 MFU,但在小模型上,收益未必抵得上折腾的成本。
特别注意每一步的实际计算量。GPU 通常在执行大块、规则的矩阵乘法时效率最高。如果把计算拆成一堆小矩阵乘法,就可能出现利用率不足,还会产生 kernel 启动间隙 [9]。
MoE 和 Nestor 是两个例子。暂且不考虑负载均衡,MoE 切分了 FFN 矩阵,Nestor 还额外切分了注意力投影。
因此,在 FLOPs 相等的情况下,这三类模型的 MFU 往往呈现 dense > MoE > Nestor 的顺序。当然,在大规模训练中,更先进的基础设施优化可能缩小差距。
除了计算,通信也可能成为瓶颈。在 Nestor 早期的一次多节点实验中,梯度本应只在每个优化器步同步一次。结果模型经过 torch.compile 包裹后,辅助函数没有识别出 DDP 实例,悄悄跳过了 no_sync,导致梯度在每个 microbatch 后都同步了一次。
更糟的是,网络配置还把跨节点流量全部塞进了同一个网络端口。
这些经验都是我和 agent 交流的过程中积累的。虽然 Claude 的基础设施能力可能比我强得多,但如果 MFU 不对劲,或者分解出来的实际计算量有问题,还是需要人推它一把。
瓶颈不一定在芯片上
瓶颈可能压根不在芯片上。做视觉或机器人的同学,可能受限于数据加载、模拟器渲染;做强化学习的同学,则可能遇到推理引擎速度、RL 算法本身,或者训练引擎与推理引擎数量分配的问题。
说到底,找我要卡之前,先确认一下:你的瓶颈真的是算力吗?
申请 GPU 前的检查清单
你应该继续做这个项目吗?
先提出一个指标:
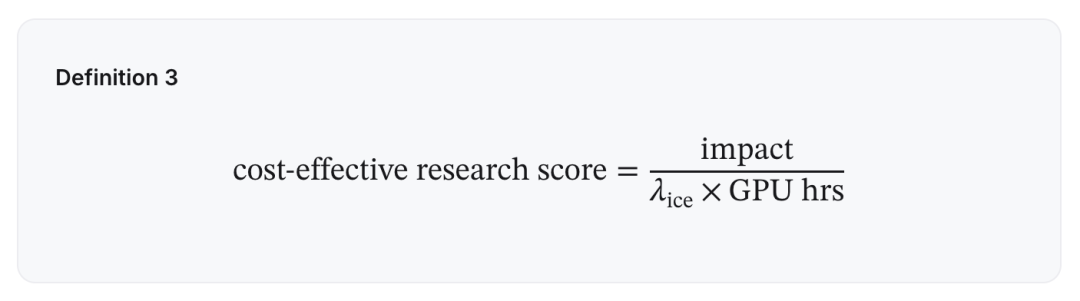
其中,GPU 小时只计算最终保留在论文正文里的实验。目标应该是优化这个指标,而不只是追求更高的影响力,同时对烧掉多少 GPU 小时毫不在意。
为了帮助大家粗略感知算力成本,原文尝试列出 ResNet 和 Transformer 论文实验的 H200 等价估算,假设 MFU 为 20%;但两项具体的 GPU 小时数均未给出。更何况,大家的项目影响力大概率也小于这两项工作。
最小实验需要多少 GPU 时间?
假设组里有 $K$ 张 GPU、$m$ 个活跃用户,你分到的配额就是 $K/m$。
一个合理的最小实验,应该使用不超过 $K/m \times 1/4$ 的卡,并在一天内跑完,给调参留出足够空间。
之后遵循严格的升级规则:把成功的实验升级到 $1/2 \times K/m$ 张卡,再到 $K/m$ 张卡;如果仍有必要,再找导师申请超配,或向我、Yi 老师申请临时额外配额。
现在的 MFU 是多少?
你的瓶颈真的是卡不够吗?还是第二部分提到的计算、通信、数据加载等其他问题?
调优过超参数,或者应用过 μP 吗?
参考文献 [10] 介绍了 μP。
先跑过几个小规模数据点,并证明你的 Ladder 赢了基线吗?
和组员协调过,看看是否有闲置任务可以停止吗?
致谢与结语
Nestor 项目地址: https://github.com/Ma-Lab-Berkeley/Nestor
感谢 Druv 和朋友们的锐评。
参考文献
- https://x.com/purshow04/status/2117994165187531061
- https://github.com/stanford-cs336/lectures/blob/main/lecture_09.pdf
- https://deep-learning-alchemy.github.io/
- https://x.com/deepaksinghml/status/2117649184773882239
- https://arxiv.org/abs/2610.31818
- https://arxiv.org/abs/2001.08361
- https://arxiv.org/abs/2203.15556
- https://arxiv.org/html/2509.23678#A7
- https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html
- https://arxiv.org/abs/2203.03466
来源
作者:Tianzhe Chu
 发表于 昨天 21:25
|
查看: 4|
回复: 0
 /1


