谷歌宣布推出专用决策模型 Gemini Decision 1,并同步上线配套的 Gemini Decisions API。它不以生成回答文本为目标,而是专注于对给定问题作出判断,为分类和分流提供结果。
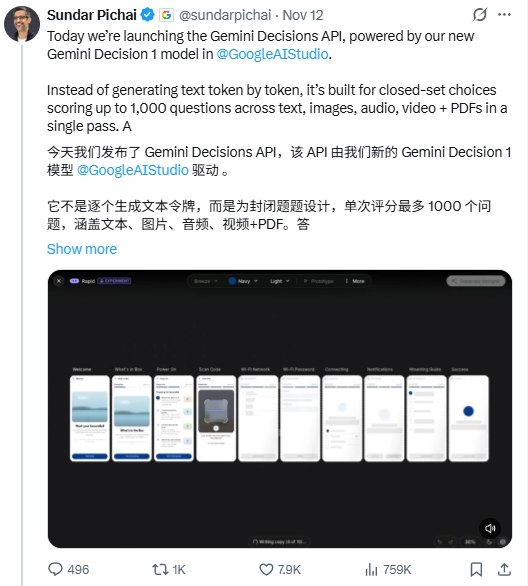
听起来,像是 AI 主动放弃了聊天能力。谷歌在相关帖子中还展示了 Stitch Rapid 在几秒钟内设计完整产品流程的演示。
不负责聊天,负责给选项打分
常见的大语言模型会逐步生成文字,把答案一个 Token、一个 Token 地输出。决策模型则面向另一类任务:根据给定材料,从限定选项中作出判断。
谷歌并非最早推出这类产品。今年 9 月 15 日,初创公司 TypeSafe 发布了 Jev,核心能力是基于给定信息进行是非判断、多选或按标准打分。
Jev 上线仅 24 小时,就有近 13% 的付费团队开始使用。到了 9 月 29 日,OpenAI 也推出了基于 GPT-6 Luna 的 Decisions API,同样瞄准分类、选择和评分任务。
谷歌此次推出的 Gemini Decision 1 支持文本、图片、音频、视频及 PDF 输入。面对同一份材料,它单次最多可处理 1000 个独立问题,减少了为不同问题反复提交材料的需要。
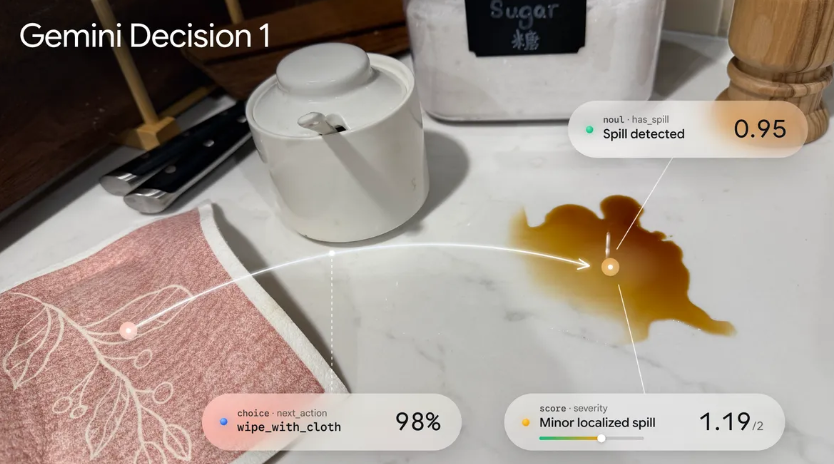
它主要面向三类问题:
- 是或否:例如判断退货商品是否有明显划痕,同时返回判断置信度。
- 多选一:在给定选项中选择最符合的一项,并提供各选项的概率。
- 按标准评分:根据预先设定的评分规则返回分数和置信分布。
模型采用单次前向推理(Single Prefill Pass),根据上下文对问题进行判断,返回校准后的概率或结构化评分。模型给出判断后,程序可以根据结果继续分流。
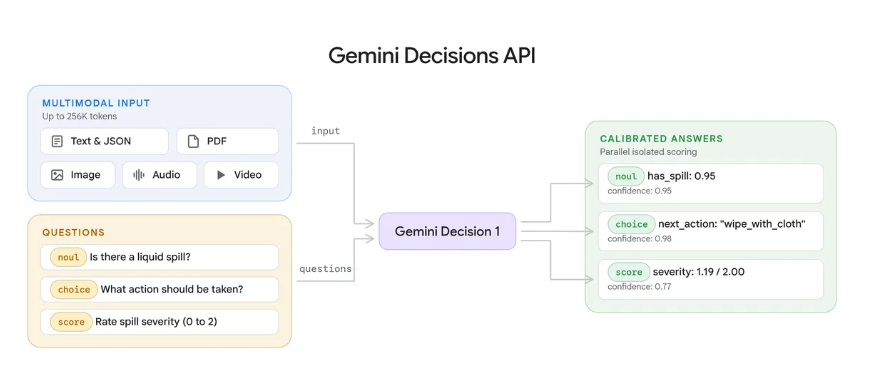
核心指标跑分情况
在谷歌公布的基准测试中,Gemini Decision 1 与 Jev 1.14 和 GPT-6 Luna 相比,在 7 项共同基准中有 5 项得分更高,校准误差也更低。
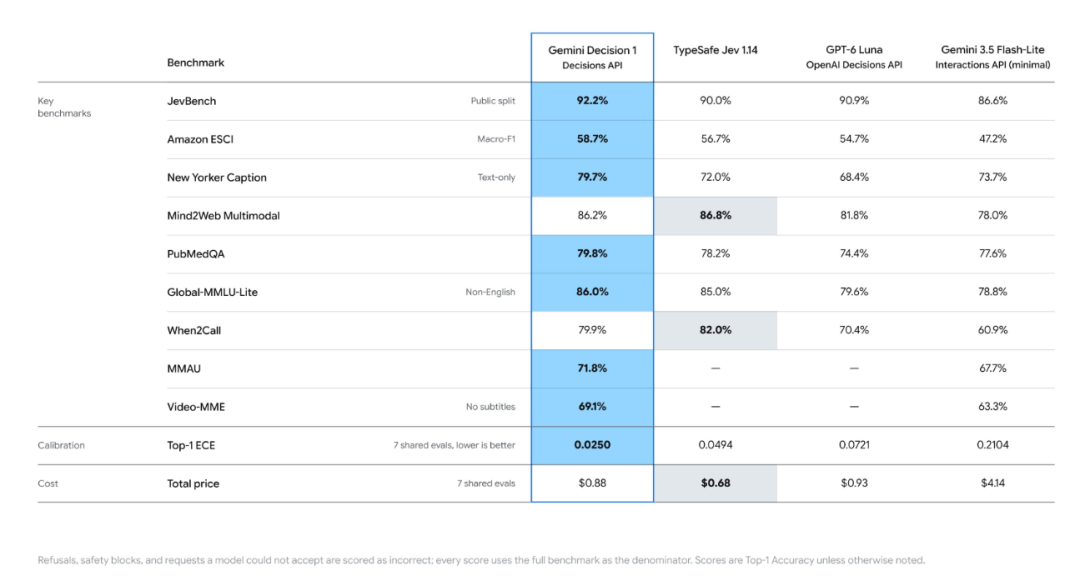
Jev 在 When2Call 工具调用和 Mind2Web 多模态两项测试中仍保持优势。基准测试结果反映的是特定评测条件下的表现,实际效果还要结合具体任务判断。
Gemini Decision 1 不逐个生成答案文本令牌,而是通过一次前向传递对候选选项进行评分。文中给出的端到端延迟为 150–250 毫秒,价格为每 100 万个输入令牌 0.10 美元,不收取输出令牌费用。
该模型支持 Prompt 缓存复用。原文提到成本可下降约 80%,但这一数字取决于对比对象和具体工作负载。
模型的上下文窗口为 256K,可用于处理较长的合规手册、法律合同或多媒体材料;实际能容纳的内容仍取决于输入格式及令牌消耗。
共享单车工单测试
在社区分享的一项实操中,有博主将模型接入旧金山共享单车客户支持测试集,连续处理了 25 封混合工单,其中包含车损照片、退款维权和带有脏话的投诉。
- 耗时对比:传统 Flash 模型完成 25 封工单分拣耗时近 50 秒;Decision 1 在 1.8 秒内完成了受损判断、紧急度评级和路由归类。
- 成本对比:搭配轻量模型生成后续回复后,整套收件箱处理耗时 14 秒、成本不到 4 美分,较对比方案降低近 80%。
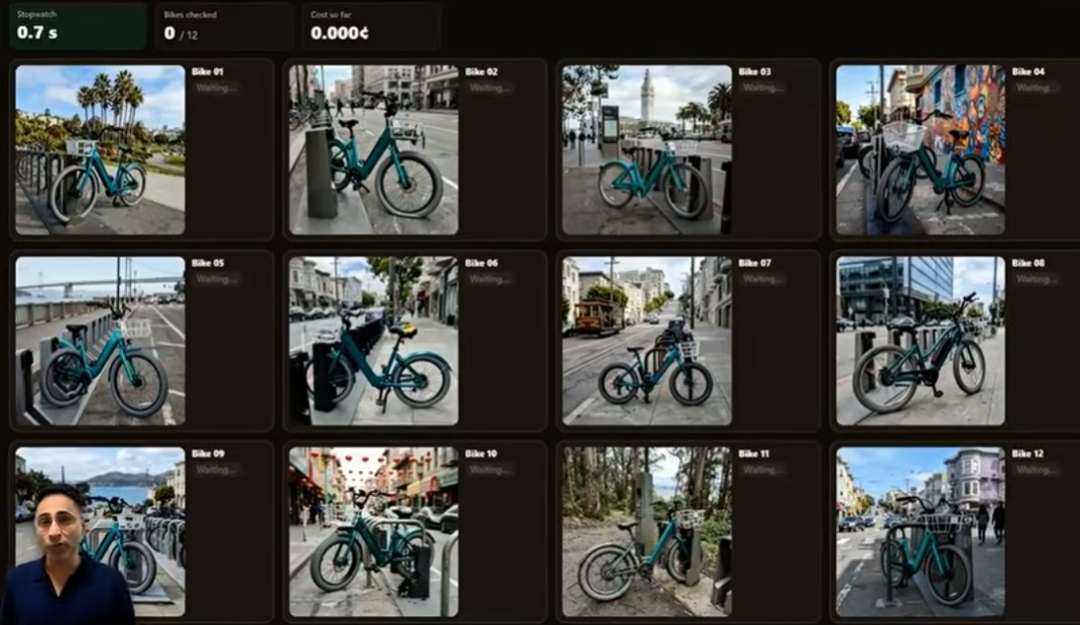
核心测试代码如下。示例输入以文字描述了上传图片的情况,并未在代码中实际传入图片:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
response = client.decisions.create(
    model="gemini-decision-1",
    input="用户上传车架断裂图,并留言:'早高峰车桩故障强行拔出导致断裂,要求退还押金并取消200美元违规罚款。'",
    questions={
        "is_damaged": {
            "type": "noul",  # Yes/No 判断
            "instructions": "Did the bicycle suffer physical structural damage?",
        },
        "target_dept": {
            "type": "choice",  # 单选题,支持 2 到 255 个选项
            "instructions": "Which department handles this?",
            "criteria": {
                "ops_maintenance": "Physical repairs and inspections",
                "billing_finance": "Fines, refunds, and deposits",
                "legal_risk": "Lawsuit threats or severe injuries",
            },
        },
        "risk_level": {
            "type": "score",  # 按预设梯度打分
            "instructions": "Rate operational risk from 1 to 5.",
        },
    },
)
演示中,模型完成选项概率计算后,输出 Token 统计显示为 0 tokens billed。需要注意,上面的代码示例只列出了 3 个部门选项,并非 255 个。
让模型各司其职
过去几年,人们常把生成内容的生动程度和篇幅与生产力联系起来。但 Gemini Decision 1 和 Jev 所代表的方向表明,写文章只是模型应用的一部分。
在大量基础设施和业务流程中,判定、分流、过滤、核身与打分同样常见。模型不必每次都写出一段答案,也可以先给出判断,再由程序决定下一步。
对于 AI Agent 而言,决策模型可以承担选项评分和路由判断;需要与用户沟通时,再交给生成模型组织回复。
参考资料
 发表于 昨天 05:56
|
查看: 10|
回复: 0
 /1


