更大的模型、更长的思维链、更多的 Agent,正在成为 scaling 的默认答案。清华这篇 Perspective 论文问了另一个问题:每一次交互,都值得执行吗?
论文的结论是:AGI 下一阶段的效率,不只取决于 System 2 能做什么,也取决于 System 1 允许它做什么。
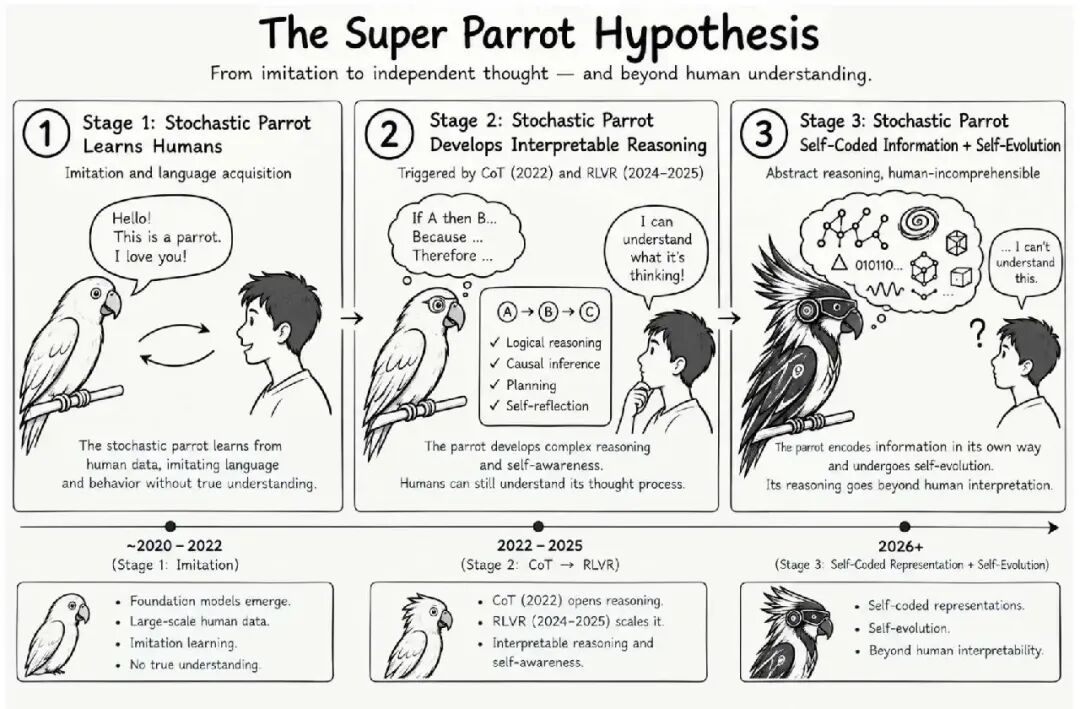
图:超级鹦鹉假说,从模仿到独立思考,再到超越人类理解。
为什么只堆 System 2 不够了
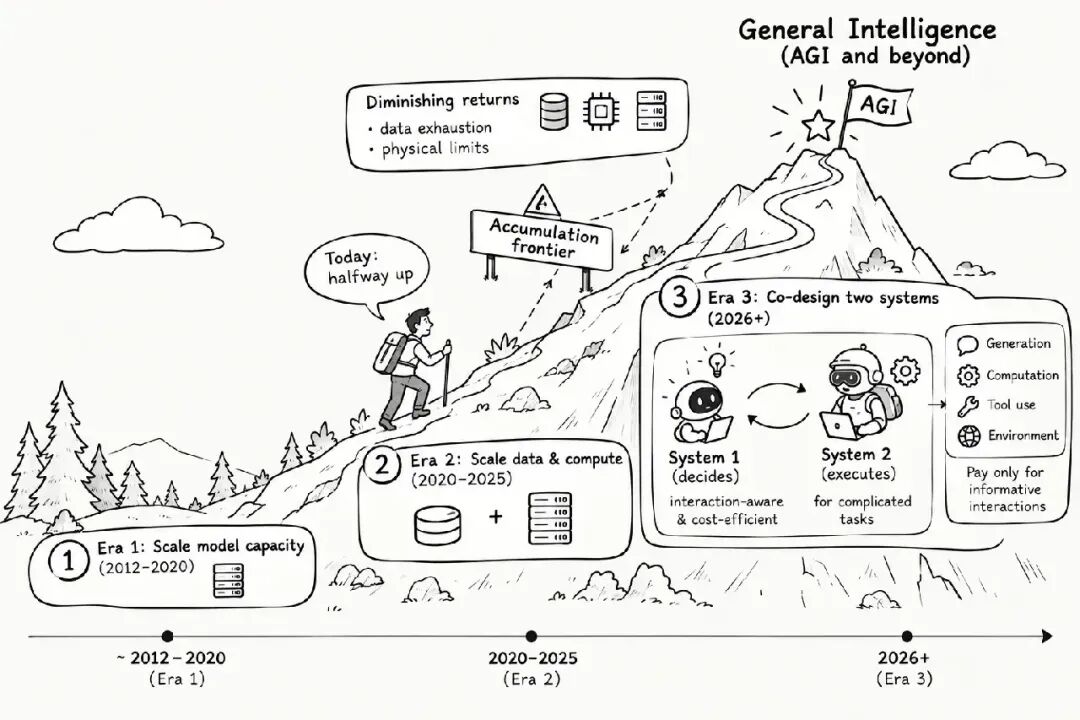
过去的 scaling 主要靠扩大模型、数据和算力。但交互带来的边际收益正在下降。
论文把 2026 年之后的路线概括为 System 1 与 System 2 的协同设计。
论文列举了几类典型的浪费:
- RLVR 中,一组回答若奖励全相同,GRPO 优势为零,rollout 却照付。
- 机器人随机采样中,大量轨迹反复覆盖已经掌握的场景。
- 推理时,继续思考并不总能改变答案。
瓶颈正从“能执行多少”,转向“多少值得执行”。
核心机制:先预测,再付费
论文提出“条件交互”,把一次任务拆成四步:
- 预测:System 1 估计候选交互的效用,只给出价值分数,不求解任务。
- 门控:分数超过阈值才放行。各交互的执行成本不同时,还要把执行成本计入排序。
- 执行:System 2 只处理获准的交互。
- 更新:真实结果回流,重新校准 System 1。
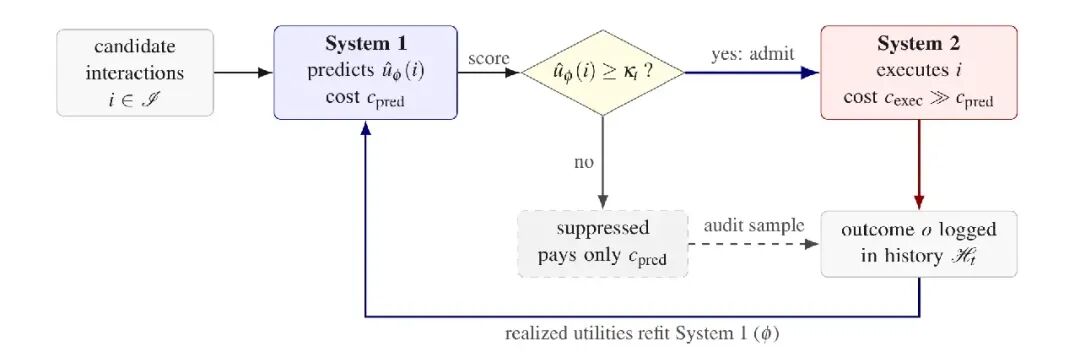
图 5:被拒绝的候选只付预测成本,少量审计样本用于发现漏判。
关键在于预测成本必须远低于执行成本,否则筛选本身就失去意义。
不是普通路由,而是共同进化
静态级联也能让小模型给大模型分流。但它通常只作用于推理阶段,路由器训练一次后固定,执行结果也不会返回。
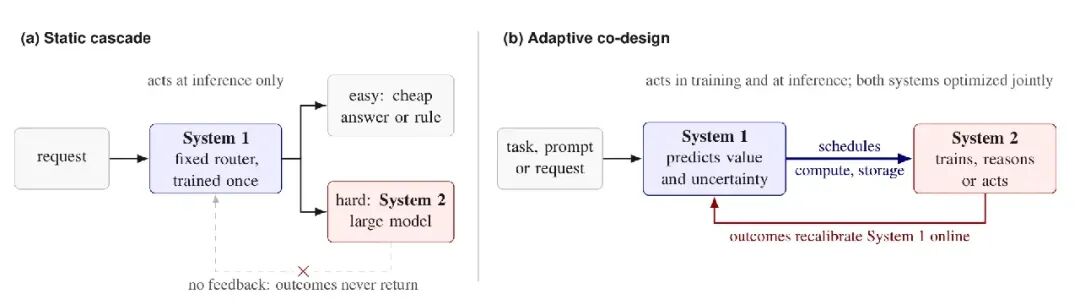
图 4:有无结果反馈与联合优化,是静态路由和协同设计的分界。
协同设计的做法不同:
- System 1 同时调度训练与推理中的计算和存储。
- System 2 的奖励、梯度和执行结果持续修正 System 1。
- System 2 变强后,有价值的交互也会变化,门控必须跟着调整。
所以重点不是大小模型拼接,而是两个系统互相塑造。
收益上限,由有效交互密度决定
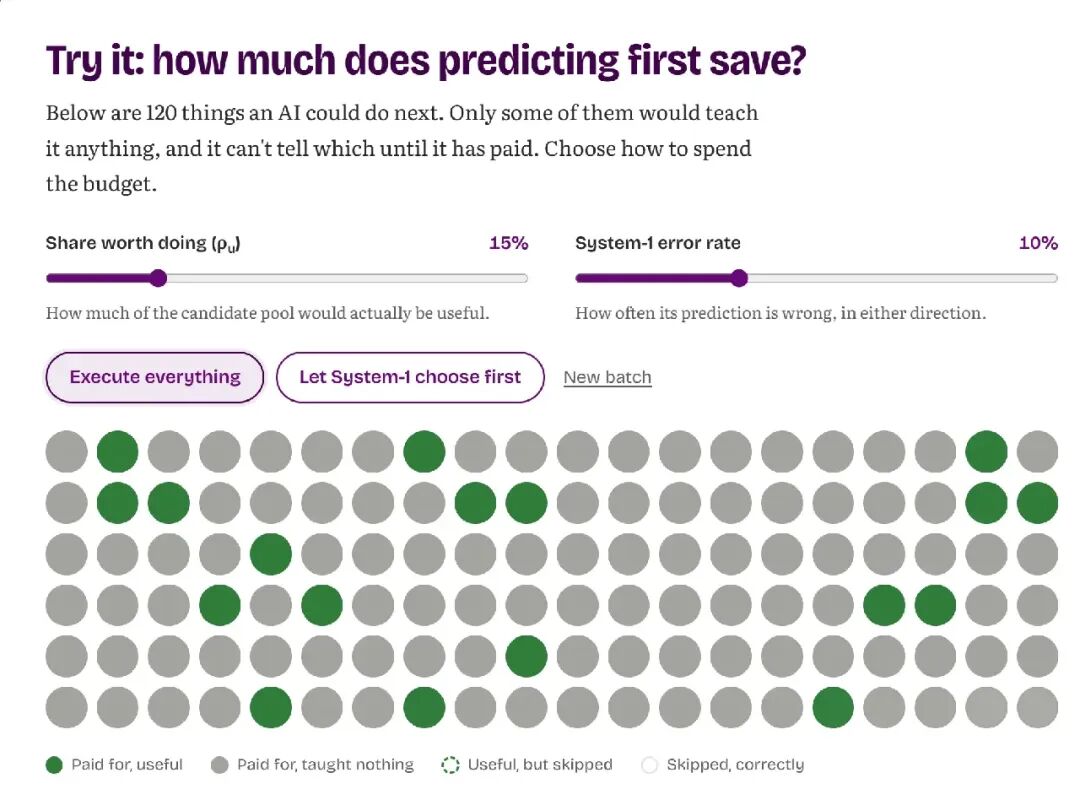
论文用 $\rho_u$ 表示候选池中效用达到门槛的交互比例。
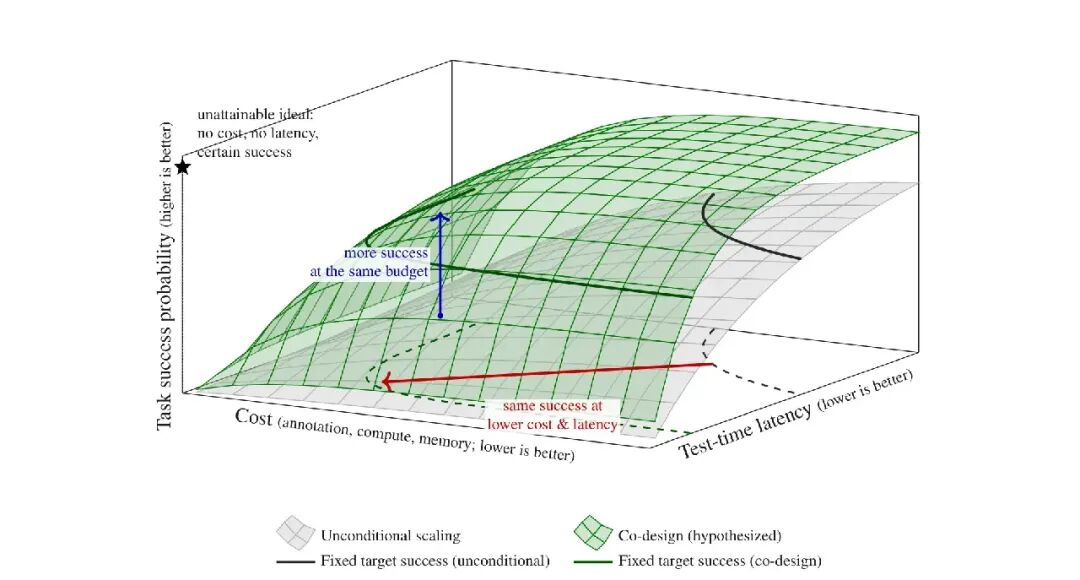
图 3:目标是同等成功率下更省钱,或同等预算下成功率更高。
在筛选完美、预测免费、执行成本相同的理想条件下,执行成本可降至原来的 $\rho_u$,加速比接近 $1/\rho_u$。若只有 20% 的交互有价值,理论上限约为 5 倍。
这不是实测承诺。误放、漏判、预测开销和分布漂移都会吃掉收益。作者进一步提出 informative compute(有效计算量)的概念,希望用真正买到效用的计算量,而不是总计算量来解释 scaling。
一套闭环,覆盖四类场景
论文的统一性在于复用同一种决策模式,而不是强行统一效用的定义。
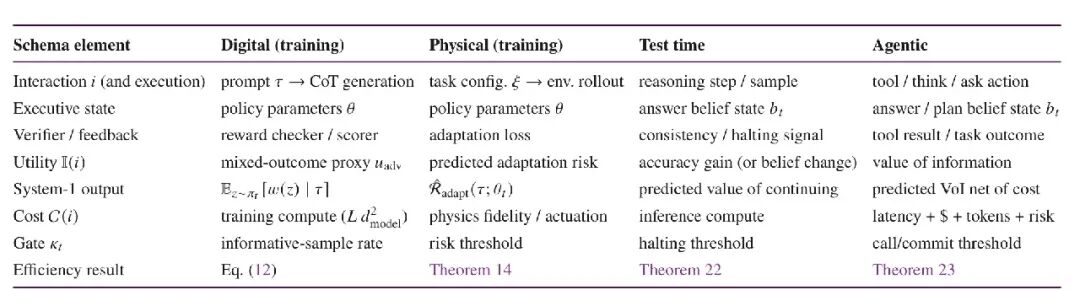
表 1:交互、反馈、效用和成本随场景变化,“预测—门控—执行”保持不变。
- 数字训练:优先选择能产生非零学习信号的 prompt。
- 物理训练:优先执行适应风险高的任务配置。
- 测试时推理:预测继续计算能否带来收益,再决定继续思考还是停止。
- Agent 行动:比较工具调用的信息价值与延迟、费用、token、风险。
亮点之外,还有待验证的问题
这是一篇 Perspective,不是靠新 benchmark 刷榜的论文。文中的成本与遗憾界建立在明确假设之上,已有应用结果只是间接支持。$\rho_u$ 是否随能力提升而衰减,scaling 指数是否改变,仍是待验证的假设。
更棘手的是,门控会审查自己的训练数据。被拒绝的交互没有结果,误判也就难以纠正。因此,独立审计与探索不是可选项,而是闭环能长期工作的保险丝。
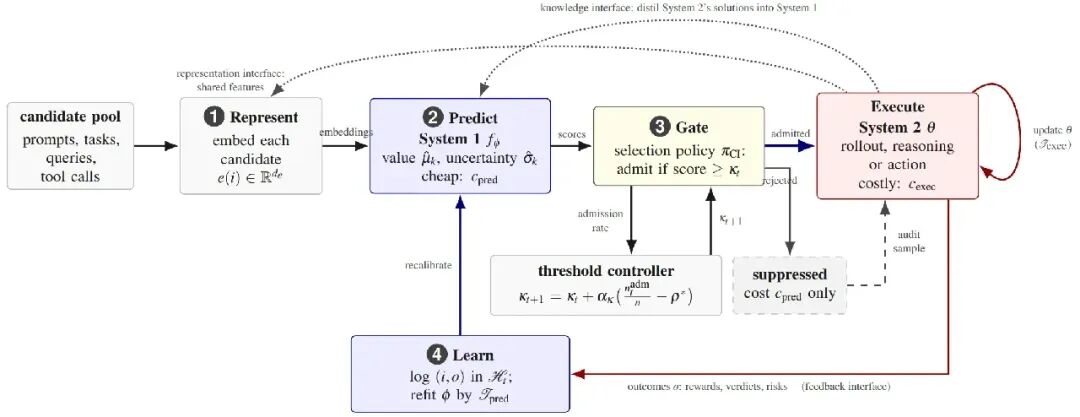
图 6:完整架构同时包含阈值控制、被拒样本审计和双系统更新。
这篇论文最值得带走的视角是:下一轮 scaling,不只是把 System 2 做得更大,而是让 System 1 更会选择。 下一步的关键实验,是测量 $\rho_u$ 的真实轨迹,并在相同有效计算量下比较学习曲线。
论文还附有一个交互小工具:调整“值得执行的比例”和 System 1 的误判率,对比“全部执行”与“先由 System 1 筛选”两种预算花法。
论文来源
 发表于 7 小时前
|
查看: 2|
回复: 0
 /1


