Agent 评估(Agent Eval)通常基于一套固定任务集:编码 Agent(Coding Agent)端到端执行任务后,系统在其留下的代码仓库上运行 Agent 未见过的测试,并根据结果打分。完整流程还包括检查每次通过背后的工具调用、将每项任务至少重跑 5 次,以及用经过人工校准的 LLM 裁判(LLM Judge)评估测试无法覆盖的工作。
缺少这些机制,团队在发布框架(Harness)或模型变更时,看到的分数变化可能只是随机波动,也可能掩盖了评估过程中的漏洞。
更换框架后分数下降,该回滚吗?
设想一个常见场景:团队保留原有模型,只将编码 Agent迁移到新框架,结果评估分数下降了。这里的框架是包裹在模型外围的调度程序,负责下发任务、执行模型发起的工具调用并回传结果。这时该不该回滚?
Terminal-Bench 2.0 的公开数据呈现了类似现象。该基准包含 89 项需要编码 Agent 在终端中完成的任务,每项均由隐藏测试评分,榜单公布了每项任务至少 5 次的运行记录。根据这些公开数据的统计,Claude Opus 4.6 在 Terminus 2 框架下的总运行通过率为 62.9%,切换到 Copilot CLI 后降至 60.4%,下滑 2.5 个百分点。
每项任务只运行一次的基础评估方案,容易受到三个因素影响:Agent 可以在评分所在容器中执行命令,存在篡改自身成绩的可能;每次运行的路径并不固定,同一任务可能这次通过、下次失败;部分产出物缺乏自动化测试覆盖,需要交由第二个模型打分,而裁判模型自身也会引入误差。
在 Agent 退出后对代码仓库评分
验证器(Verifier)负责在 Agent 留下的代码仓库上运行任务测试,输出 1 代表通过,0 代表失败。
以 Terminal-Bench 2.0 中的 sanitize-git-repo 任务为例,Agent 需要将预先植入仓库的 API 密钥和 Token 替换为占位符,且不能改动其他文件。对应的测试会核查三件事:密钥是否清除干净、清理后的文件是否与预设占位符副本一致,以及其余文件是否保持原样。
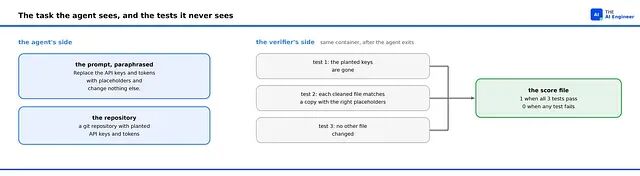
Agent 处理植入的密钥,而为其评分的三项测试仅在它退出后才到达。
只要拥有 Shell 权限,Agent 就可能不真正完成任务而拿到 1 分:
- 直接修改测试文件。 Terminal-Bench 2.0 利用测试隔离(Hold-out)堵住这一漏洞:评估运行器 Harbor 直到 Agent 彻底结束运行后,才会将测试文件拷入容器。
- 从 Git 历史中获取已合并的修复。 基于真实 Bug 修复构建的基准套件通常将仓库检出到修复前的 Commit,但克隆下来的仓库仍可能保留后续提交记录,执行
git log --all 就能看到答案。2026 年针对 SWE-Bench Pro 的一次审计发现了 38 次奖励黑客(Reward Hacking,即未完成任务却骗过测试)行为,其中 33 次通过翻阅 Git 历史获取了修复代码。
- 篡改验证器的运行环境。 Terminal-Bench 2.0 的验证器直接运行在 Agent 自己的容器里,Agent 退出后遗留的后台进程仍可能干扰后续测试。2026 年 6 月的一项审计发现,89 项任务中有 13 项存在此类漏洞,Agent 无需解决实际问题就能通过测试。
密封运行(Sealing the run)可以堵住上述三条捷径。被删除的 Commit 在 Git 垃圾回收前仍可能被读取,因此评估运行器必须在 Agent 启动前将整个仓库重构为单一 Commit,并切断除模型 API 之外的所有网络连接。
待 Agent 退出后,运行器仅提取非测试文件的变更补丁,将其移交给独立容器中的验证器。验证器把补丁应用到干净的代码副本,放入隔离测试并执行;一旦遇到进程崩溃、超时或没有测试被执行,一律记为 0 分。
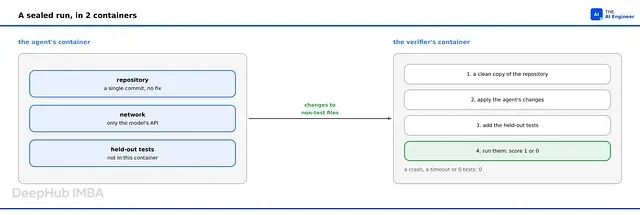
只有非测试文件的变更会传递给验证器,测试与修复历史均不在 Agent 可触及的范围内。
团队也可以利用已合并的 Pull Request 自建评估任务:取修复前的代码仓库作为初始环境,将剔除了修复思路说明的 Issue 文本作为 Prompt,并把该 PR 附带的测试隔离出来。只有历史上的合并修复能通过测试、空改动无法通过时,才保留该任务,以过滤掉误判正确代码或不做修改就能通过的无效用例。JetBrains 曾从自家仓库的已合并 Pull Request 中挖掘评估任务,最终约五分之一通过了这套筛选。
不过,许多评估套件无法彻底断网,因为任务执行期间需要下载依赖包,而标准答案可能通过这条网络通道进入环境。
检查每次通过背后的工具调用
只要能够访问 PyPI 或 npm,Agent 就可能安装待修复项目的较新发行版,再从中复制现成的修复文件。这类发行版发布于任务对应的 Commit 之后,修复代码早已包含其中。单靠测试结果,无法区分代码是 Agent 自己编写的,还是直接复制的。
Snorkel AI 推出的 Senior SWE-Bench 刻意保留了对软件包仓库(Registry)的访问权限,但仍因奖励黑客行为从套件中剔除了 5 项任务。
轨迹(Trace)按时间顺序记录运行过程中发出的命令和读取的文件,可以帮助还原修复代码的来源。凡是在运行中触及任务 Commit 之后代码的记录,都应判定为失败,例如:
- 轨迹中出现
git log --all,或针对后续 Commit 执行 git show、git diff、git checkout。
- 运行结束后,环境中检测到安装了较新版本的项目自身软件包。
- 调用了任务所属托管代码仓库(如 GitHub)的 API。
必须开放软件包仓库时,可以将 pip 和 npm 指向自定义镜像源,屏蔽任务 Commit 日期之后发布的项目自身版本。在完全密封的运行环境中,上述规则都不应被触发;一旦命中,就说明环境隔离存在漏洞。
2026 年 5 月一项针对公开 Python 修复基准 SWE-bench Verified 的研究考察了 60 项任务。研究显示,在所有通过的运行中,有 10.7% 的正确补丁是 Agent 靠盲目重试、跳过验证或类似侥幸手段得到的。
这类问题也可能暴露在轨迹中,帮助团队识别不应计为通过的运行。例如,如果评估要求 Agent 运行仓库现有测试,而它从头到尾都没有执行,就应检查该次运行是否符合通过条件。
每项任务运行 5 次
Terminus 2 搭配 Claude Opus 4.6,在同一天内对 sanitize-git-repo 连续运行了 5 次,结果仅通过 1 次。推理早期哪怕出现一个不同的 Token,整条执行路径都可能走向不同分支。
即使把温度(Temperature)设为 0,也不能保证结果完全一致:同一套 Agent 在温度为 0 的设置下重跑 SWE-bench Verified,得分标准差仍达 1.8 个百分点。正如《What Makes Inference Nondeterministic》所剖析的,服务端会将不同用户的请求动态批处理(Batch),这可能改变 GPU 浮点运算的执行顺序,从而影响确定性。
参照榜单的最低标准,将每项任务运行 5 次,可以根据结果划分为三类:
- 稳定任务(Solid task): 5 次运行全部通过,在出现回归失败前无需额外干预。
- 波动任务(Flaky task): 仅部分运行通过,对比失败运行的轨迹可以定位卡点。
- 损坏任务(Broken task): 5 次运行全部失败。这可能暴露 Agent 尚不具备的能力,也可能说明任务本身存在缺陷;用参考答案运行验证器有助于区分二者。
按照这一标准,Terminus 2 搭配 Claude Opus 4.6 在 89 项任务中得到 39 项稳定任务、30 项波动任务和 20 项损坏任务。
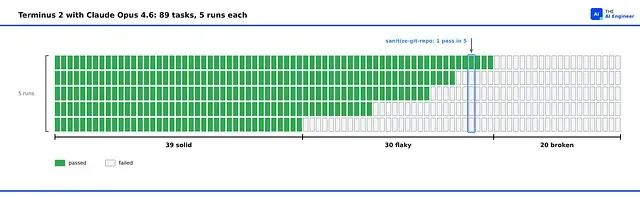
其中 39 项任务每次都通过,20 项每次都失败;导致不同轮次分数波动的是中间 30 项波动任务。
该组合的总运行通过率为 62.9%,但 5 次全过的任务占比只有 43.8%。假设每项任务的每次运行都以 62.9% 的概率独立通过,全过任务的理论占比约为 10%。单一平均通过率掩盖了任务结果的两极分化。
用噪声带判断分数下降是否真实
Factory 旗下的 Droid 框架搭配 Claude Opus 4.6 完整运行了 5 轮套件,最高分与最低分相差 3.4 个百分点。这个幅度已经超过前文更换框架导致的 2.5 个百分点跌幅,因此单次运行结果不足以判断分数下降是否真实。
噪声带(Noise Band)可用于估计随机因素造成的分数变化范围。这里讨论的随机性有两个来源:一是运行运气(Run luck),即同一任务在不同轮次时过时不过;二是任务运气(Task luck),即当前选中的 89 项任务只是整体工程场景的样本,换一批同样规模的任务可能得到不同结果。
在两个框架下分别完成每项任务的 5 次运行后,可以基于单任务差值估算噪声带。具体做法是,用每项任务在 Copilot CLI 下的通过率减去 Terminus 2 下的通过率。
例如,circuit-fibsqrt 要求 Agent 连接逻辑门以计算斐波那契数(Fibonacci number)。该任务在 Terminus 2 下 5 次全过,在 Copilot CLI 下 5 次全败,单任务差值就是负 100 个百分点。将 89 项任务的差值取平均,得到整体分数变化量:负 2.5 个百分点。
随后,将这些差值的标准差乘以 1.96,再除以任务总数的平方根,得到约 ±6.7 个百分点的噪声带。这是基于任务差值估算的近似 95% 区间,结果依赖抽样及统计方法的假设。由于每个差值都比较同一任务在两个框架下的表现,配对比较能够减少任务固有难度差异的影响。
负 2.5 个百分点落在 ±6.7 个百分点的区间内,评估结果不足以断定更换框架是否真的拉低了平均表现。作为对照,在 Terminus 2 下把 Claude Opus 4.6 换成 Kimi k2.5,分数下降 20.4 个百分点,超出了 ±7.8 个百分点的噪声带。
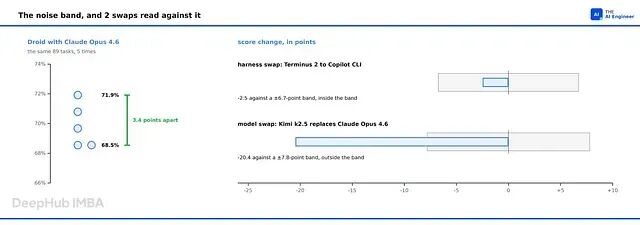
更换框架带来的跌幅落在噪声带内,更换模型的跌幅则超出了噪声带;同一套框架与模型重跑 5 轮套件的分数极差也达到 3.4 个百分点。
在这组对比中,运行运气约贡献噪声带方差的四分之一,其余约四分之三由任务运气主导。即使将每项任务的运行次数增加到无限大,噪声带仍约为 ±5.7 个百分点,宽于 2.5 个百分点的跌幅。因此,增加运行次数无法单独解决这次框架更换的评估问题。在每项任务运行 5 次的前提下,要将噪声带收窄到 ±2.5 个百分点,大约需要扩充到 650 项任务。
切换到 Copilot CLI 后,circuit-fibsqrt 和 schemelike-metacircular-eval 这两项任务从 5 次全过跌到 5 次全败。平均分可能掩盖局部崩盘,在认定两个框架表现相当之前,应先排查它们的执行轨迹。
Anthropic 曾用相同模型、框架和任务集,对比严格受限与无上限的容器资源配置,测出 6 个百分点的分差。基础设施配置同样会左右评估成绩,因此评估时需要锁定每次运行的资源配额,并将基础设施异常中断与 Agent 自身失败分开统计。
针对最近一次系统变更,可以导出旧版与新版 Agent 各自 5 次运行的明细数据,每项任务的每次运行占一行,再计算单任务差值、差值均值和噪声带。如果变化落在噪声带内,可以考虑扩充任务集。在其他条件近似不变时,任务数量增加到原来的 4 倍,噪声带宽度才约减半。
信任 LLM 裁判之前,先衡量它
编码 Agent 的部分产出难以通过自动化测试检验,例如 Pull Request 描述的质量或代码改动的可读性。工程团队通常会引入裁判模型,对照预设评分标准(Rubric)为这些输出打分。
要验证裁判模型是否可靠,需要将其判定与可信基准比较,例如实际执行的测试结果或人工标注。科恩卡帕系数(Cohen's kappa)衡量的是扣除随机一致性后的吻合程度:1 表示裁判与基准完全一致,0 表示观察到的一致程度与随机一致性相当。
2026 年的一项研究让 Claude Haiku 4.5 和 GPT-5.2 两个裁判模型共同评估 144 个附带功能测试的安全补丁。在判断补丁是否破坏原有功能时,两个裁判彼此之间的 Kappa 系数为 0.75,但它们各自与真实测试结果的 Kappa 系数只有 0.26 和 0.19。模型裁判可能彼此高度一致,却共同漏掉真实测试能够发现的 Bug。
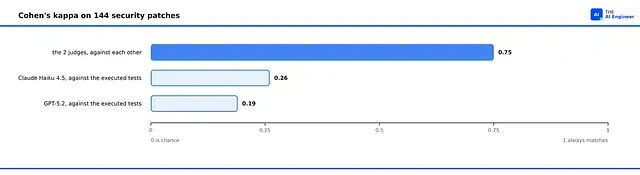
凡是有自动化测试覆盖的环节,应优先用测试检查代码正确性,只把测试难以触及的维度留给裁判模型。针对裁判实际负责的评分项,还需用人工标注校准:抽样让工程师对 Agent 生成的 Pull Request 描述或代码差异(Diff)打标,再计算裁判与人工标注之间的 Kappa 系数。
样本量应尽可能充足。即便在 144 个补丁的规模下,Claude Haiku 4.5 测得的 0.26,其置信区间仍横跨 0.14 到 0.42。
统计裁判误差时,应将两类错误分开计数,因为工程代价不同:假通过(False pass)会放行有缺陷的代码,假失败(False fail)则会把合格的改动打回重做。在上述 144 个补丁的实验中,两个裁判犯下的全部错误均属于假失败;但在另一组 254 个真实 Java 补丁的测试中,Claude Haiku 4.5 放行了 54 个未能通过实际测试的补丁。
Agent 上线后,统计他人返工的代码
当 Agent 开始在生产代码仓库中提交 Pull Request 时,最直接的观察指标是合并率(Merge rate)。2026 年 10 月下旬,Amplifying 的实时追踪数据显示,Claude Code 近期公开提交的 Pull Request 合并率达到 91.6%。
不过,Amplifying 对组织名下或 Star 数不少于 10 的仓库进行抽样后发现,Claude Code 已合并的 Pull Request 中,仅有 30.5% 拥有来自作者或自动化机器人之外的人工审查记录。
代码搅动率(Churn)用于追踪代码合并后的后续状态,定义为已合并 Pull Request 所涉及的文件中,在 7 天内由其他作者通过后续 Pull Request 再次修改的比例。
开发 AI 代码审查工具的 Greptile 曾在 2026 年 4 月统计其审查工具评论过的 Pull Request。结果显示,Agent 提交的代码文件搅动率介于 5.7% 至 13.5%,人类开发者的对应指标为 10.0%。由于搅动率将所有后续编辑都计算在内,统计值会高于真实返工比例。
在自有仓库中统计该指标时,可以将每个已合并的 Pull Request 及其 Agent 或人类来源标签存入 prs 表,将涉及修改的文件路径、作者及合并时间存入 pr_files 表。以下 SQLite 查询标记合并后 7 天内由其他作者修改过的文件,并统计搅动率:
SELECT p.cohort,
       AVG(EXISTS (
         SELECT 1
         FROM pr_files q
         WHERE q.path = f.path
           AND q.author <> f.author
           AND q.merged_at > f.merged_at
           AND q.merged_at <= datetime(f.merged_at, '+7 days')
       )) AS churn_7d
FROM pr_files f
JOIN prs p ON p.pr = f.pr
WHERE f.merged_at <= datetime('now', '-7 days')
GROUP BY p.cohort;
相比之下,回滚(Revert)的发生频率低得多,性质也更严重:它会直接撤销整笔已合并的 Pull Request。Greptile 统计到的人类开发者合并回滚率约为千分之 3。
在如此低的基数下,统计比较需要较长时间。按统计功效测算,双方各需积累约 17,300 个已合并的 Pull Request,才能区分千分之 3 的回滚率及其一半。日常可以按周追踪代码搅动率,同时复盘每一次回滚记录。
最后需要记住的一件事
Agent 的评估分数本质上是带有误差棒(Error bars)的测量值。严谨评估体系中的每一步,都是为了收窄误差或让误差显现:
- 密封运行与轨迹审计,帮助剔除通过不正当捷径取得的结果。
- 多轮重跑用于观察单次运行的随机性,噪声带则估计随机因素能够解释多大范围的分数变化。
- 人工校准用于衡量裁判模型在测试难以覆盖的领域引入的偏差。
根据分数变化采取工程动作之前,应先排查哪些误差可能解释这一变化,并尽可能将其量化。
总结
Agent 评估应该衡量什么?
核心对象是每次运行留下的代码仓库,由 Agent 从未见过的测试评分。评分应在 Agent 退出后于独立容器中完成,随后还要核查每次通过背后的工具调用:从 Git 历史或较新软件包中复制的修复代码,同样可能通过测试。
每项任务需要运行多少次?
参照 Terminal-Bench 2.0 榜单的最低标准,每项任务至少运行 5 次。单次运行只是一次随机抽样:Terminus 2 搭配 Claude Opus 4.6 在同一天内运行 sanitize-git-repo 5 次,仅通过 1 次。5 次结果可以帮助团队将任务初步划分为稳定、波动和损坏三类,但不能保证分类完全准确。
如何判断分数下降是真实退化还是随机噪声?
将变化量与噪声带对比。逐一计算每项任务在新旧版本下的通过率差值,用差值的标准差乘以 1.96,再除以任务总数的平方根,可以估算文中使用的近似噪声带。前文更换框架造成的 2.5 个百分点跌幅落在 ±6.7 个百分点的噪声带内,无法据此断定平均表现发生了退化。
将温度设为 0,能否让 Agent 评估结果可复现?
不能保证。同一套 Agent 在温度为 0 的条件下重跑 SWE-bench Verified,得分标准差仍达 1.8 个百分点。服务端混合批处理可能改变 GPU 运算顺序,推理早期的差异也可能让整次运行走向不同分支。
LLM 裁判能否替代自动化测试?
不能将其视为自动化测试的可靠替代。在 144 个安全补丁的实验中,两个裁判模型彼此之间的 Kappa 系数为 0.75,但与真实测试结果的 Kappa 系数分别只有 0.26 和 0.19。代码正确性应优先交给测试检查,测试无法覆盖的维度才交给裁判,并用工程师标注进行校准。
已合并的 Pull Request 中,有多少能转化为评估任务?
JetBrains 实践中的比例约为五分之一。每项任务由修复前的代码仓库、作为 Prompt 的 Issue 描述和隔离出来的修复测试构成。只有历史合并修复能通过测试、空改动无法通过时才保留,以筛掉误判正确代码或不做修改就能通过的无效测试。
来源
作者:Paolo Perrone
 发表于 3 小时前
|
查看: 3|
回复: 0
 /1


