机器人使用智能体(RUA)是通用机器人控制领域的一条潜在技术路线。不过,在相关测试中,GPT-6 Astra、Claude Fable 5.2 等闭源模型表现出较强能力,开源权重模型仍存在明显差距。
近日,来自麻省理工学院、加州大学伯克利分校、加州大学圣地亚哥分校、英伟达和 Inco AI 的研究人员联合搭建了机器人智能体后训练引擎 PEAR。他们通过机器人使用强化学习(RURL),在大量仿真机器人任务上训练并测试模型。
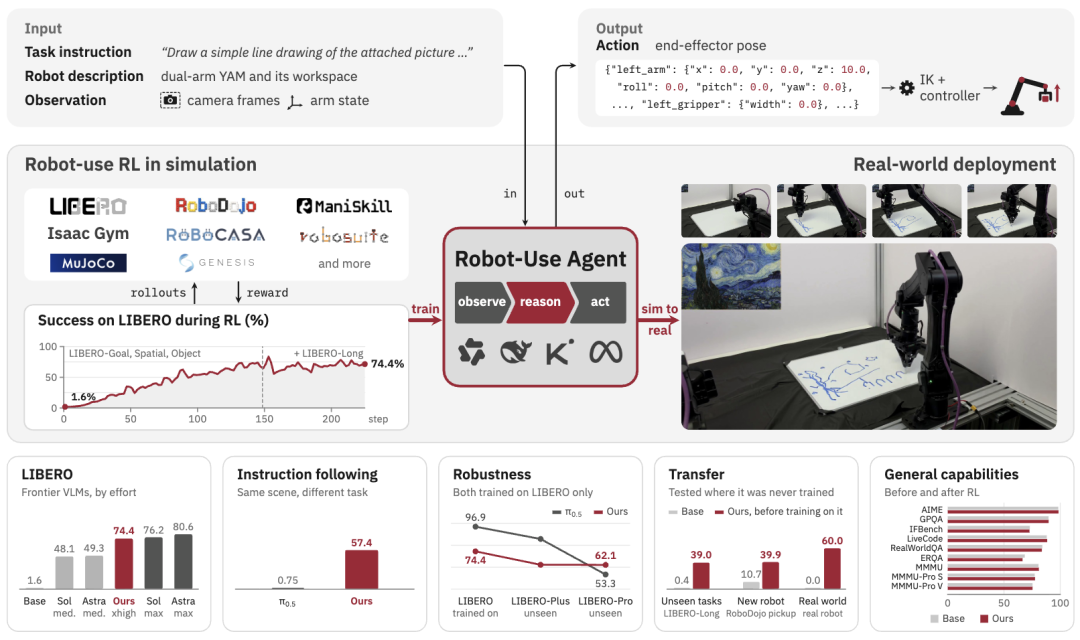
研究选用的开源基座模型 Qwen3.8-27B 起初几乎无法操控机器人。经过训练,模型在仿真基准和真机实验的多种场景中能够完成任务,同时基本保留了原有的通用推理、代码和视觉能力。
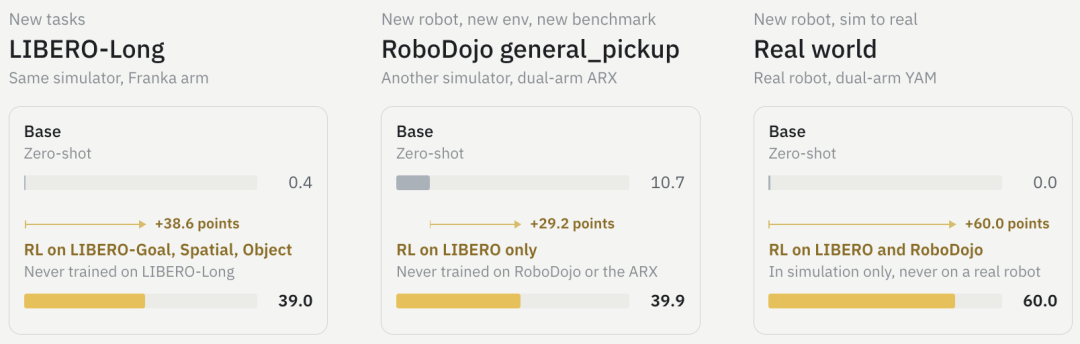
在 LIBERO 基准上,机器人使用强化学习将成功率从 1.6% 提升至 74.4%,在较高推理算力设置下接近 GPT-6 Astra 和 GPT-6.1 Sol。模型仅在仿真中训练,无需适配层,在真机双臂机器人测试中的成功率达到 60%;训练前的成功率为 0。
研究团队认为,RURL 有望成为基础模型后训练体系中的重要一环。
像操作电脑一样训练机器人智能体
计算机使用智能体读取截图、推理任务并输出点击或按键指令,再由操作系统执行。这项研究操控机器人的方式与之类似。
每一轮交互中,模型读取相机画面与机械臂状态,通过思维链推理,输出末端执行器的下一目标位姿。逆运动学将该位姿换算成关节角度,再由机械臂控制器执行运动。
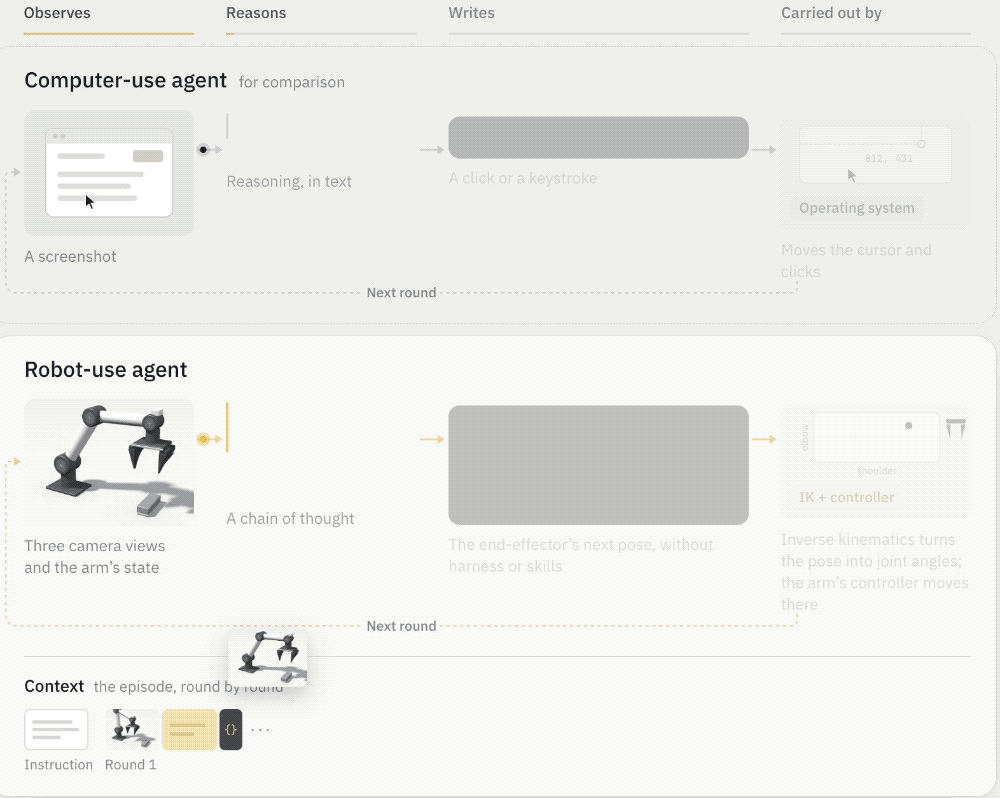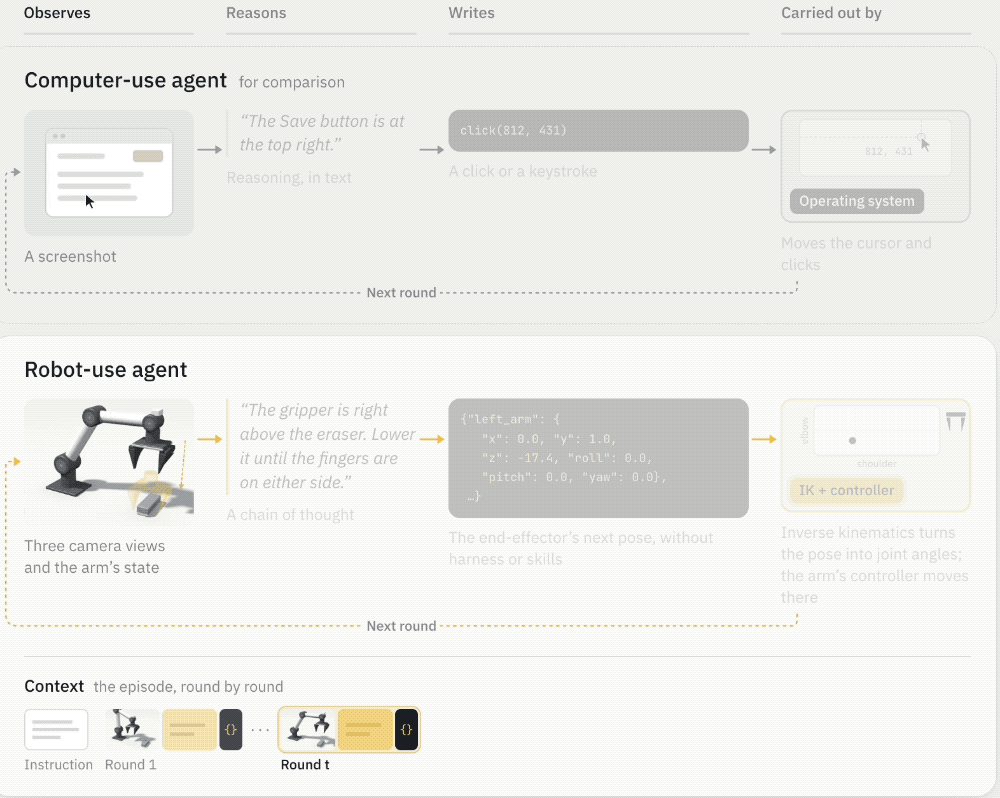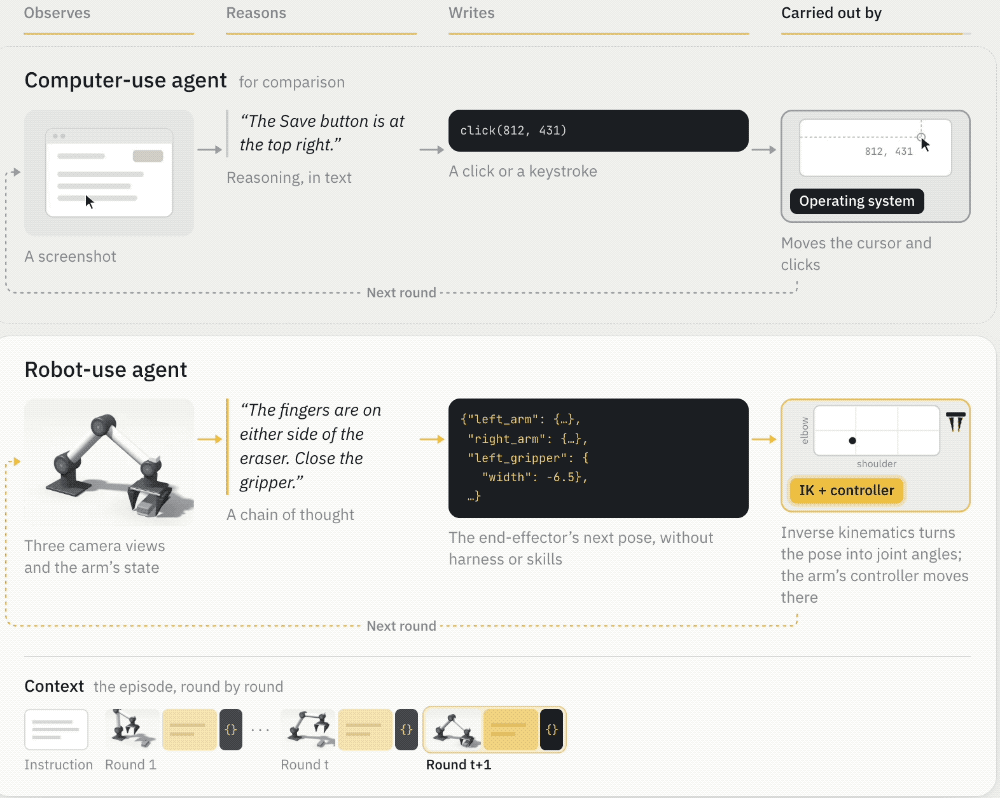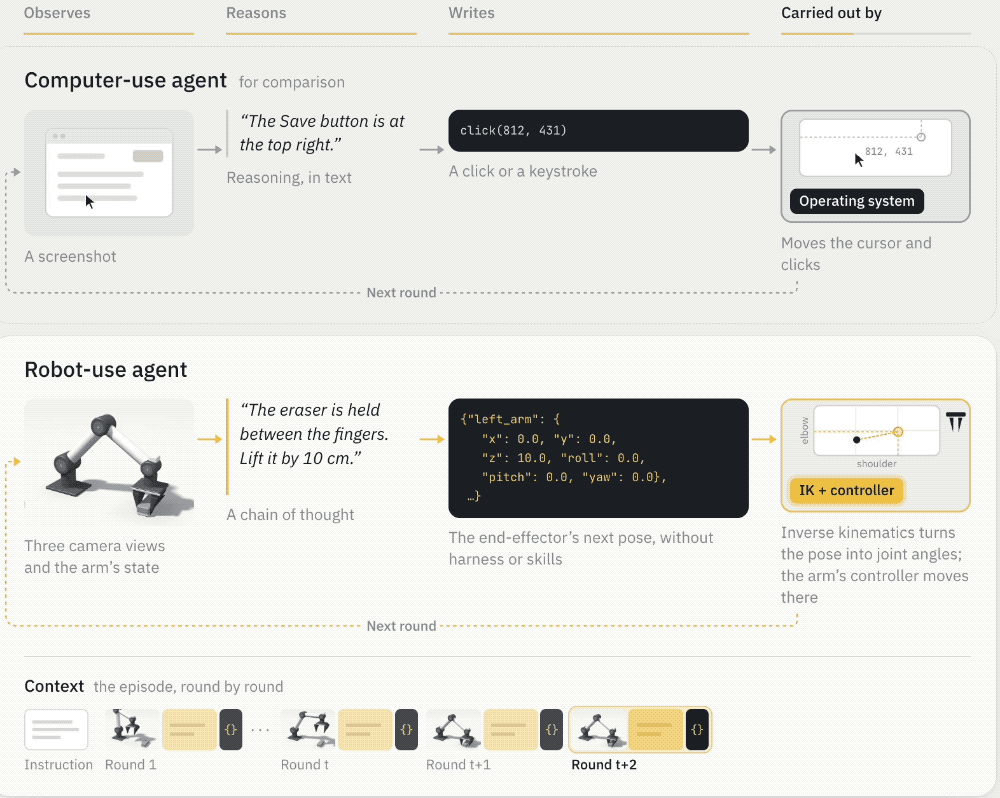
整个过程没有接入感知工具、抓取或运动规划器,也不使用技能库。模型需要自行在相机画面中定位物体、规划接近与操作方式,并识别动作是否失败。
历史交互轮次保留在上下文中,模型可以利用过往的观察和动作生成后续步骤。研究人员通过仿真机器人任务上的强化学习训练这些能力,并将方法命名为机器人使用强化学习(Robot-Use RL)。
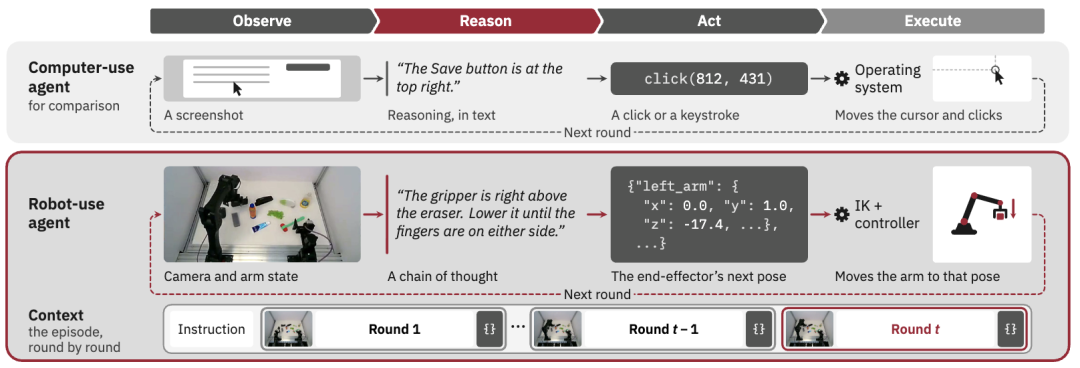
PEAR 是一套用于训练机器人使用智能体的基础设施。研究团队参照计算机使用智能体的训练范式,在仿真机器人任务上用强化学习训练模型。
研究人员对开源推理模型 Qwen3.8-27B 分三个阶段训练:
- 训练 LIBERO 的 Goal、Spatial、Object 子集。
- 在全部四个 LIBERO 子集上继续训练。
- 加入 LIBERO 训练后学习信号最强的两项 RoboDojo 任务。
最终得到 Qwen3.8-27B-PEAR,也就是部署到真机上的版本。
机器人性能提升,通用能力基本保留
实验显示,强化学习能够提升初始成功率很低的策略。
在 Goal、Spatial、Object 三个任务子集上,基座模型的轨迹成功率仅约 2%,几乎每一轮采样都拿不到奖励。经过 148 步训练后,这三个子集的训练成功率提升至约 70%。
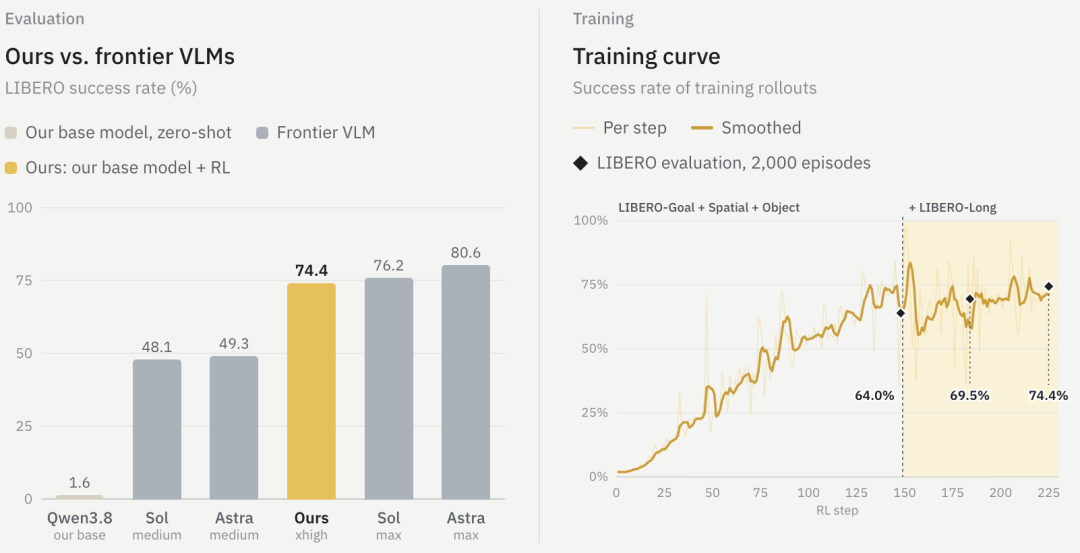
在这三类任务上学到的技能,也能泛化到未训练过的任务。第 148 步时,模型尚未在 LIBERO-Long 上训练,却已在该子集取得 39.0% 的成功率,而基座模型仅为 0.4%。此时,模型在整个 LIBERO 基准上的成功率为 64.0%。
从第 149 步开始,研究人员在全部四个 LIBERO 子集上继续训练:第 184 步的成功率达到 69.5%,第 225 步达到 74.4%,每个阶段约提升 5 个百分点。74.4% 的成功率接近满推理档位下的 GPT-6 Astra(80.6%)和 GPT-6.1 Sol(76.2%)。
这些结果表明,即使初始成功率很低,开源基座模型也可以通过强化学习大幅提升机器人任务成功率。
对任务扰动和新指令的泛化
Qwen3.8-27B-PEAR 的泛化能力并不局限于训练任务:当任务受到扰动时,它仍能保持一定鲁棒性,也能执行未见过的指令。
研究人员在 LIBERO-Plus 和 LIBERO-Pro 上进行对比测试。这两个基准以两种策略都未见过的方式扰动训练任务:LIBERO-Plus 主要改变相机视角、光照、背景和传感器噪声等观测输入;LIBERO-Pro 主要改变任务目标和物体布局。
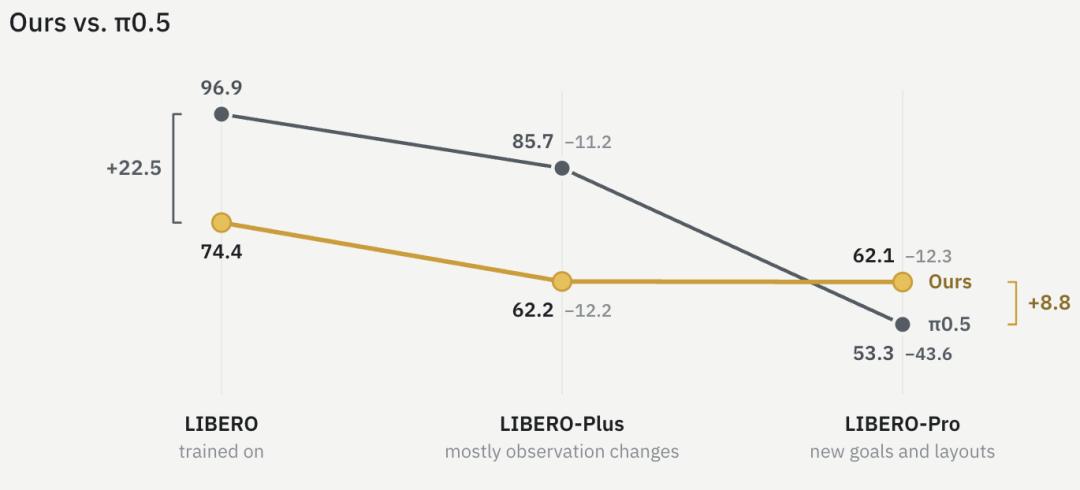
与 LIBERO 上的成绩相比,在 LIBERO-Plus 上,π0.5 下降 11.2 个百分点,Qwen3.8-27B-PEAR 下降 12.2 个百分点,损失相近。在 LIBERO-Pro 上,两者分别比 LIBERO 成绩下降 43.6 和 12.3 个百分点;PEAR 的成功率为 62.1%,π0.5 为 53.3%。
跨环境、跨机器人迁移
模型学到的技能还可以跨仿真环境、跨机器人迁移。在现实世界的真机测试中,Qwen3.8-27B-PEAR 的成功率为 60%,而基础模型从未成功。
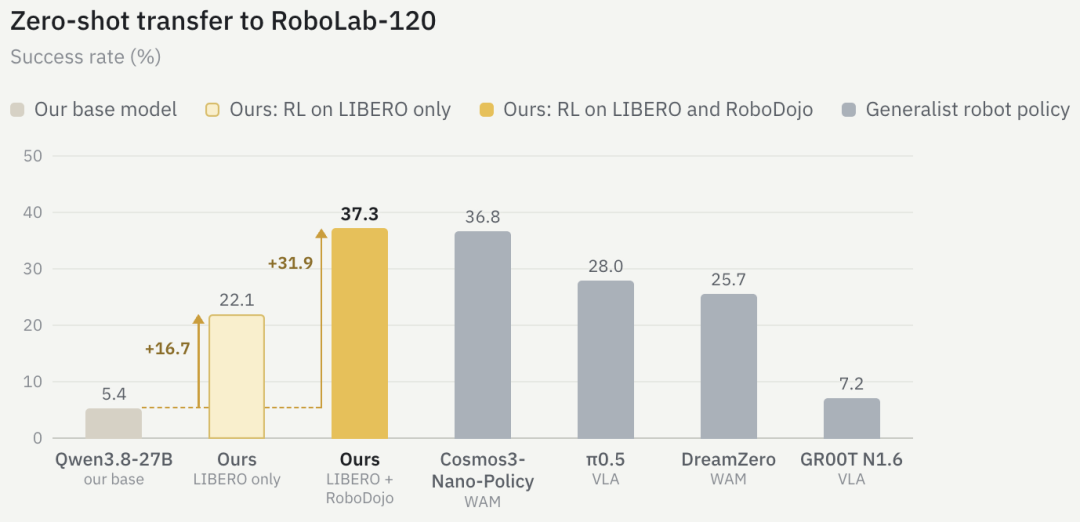
在 RoboLab-120 的 1,200 个回合零样本测试中,Qwen3.8-27B-PEAR 的成功率为 37.3%,基础模型为 5.4%。这一结果与 Cosmos3-Nano-Policy 的 36.8% 相当,高于 π0.5 的 28.0%、DreamZero 的 25.7% 和 GR00T N1.6 的 7.2%。这四者均是 RoboLab 排行榜上的通用机器人策略。
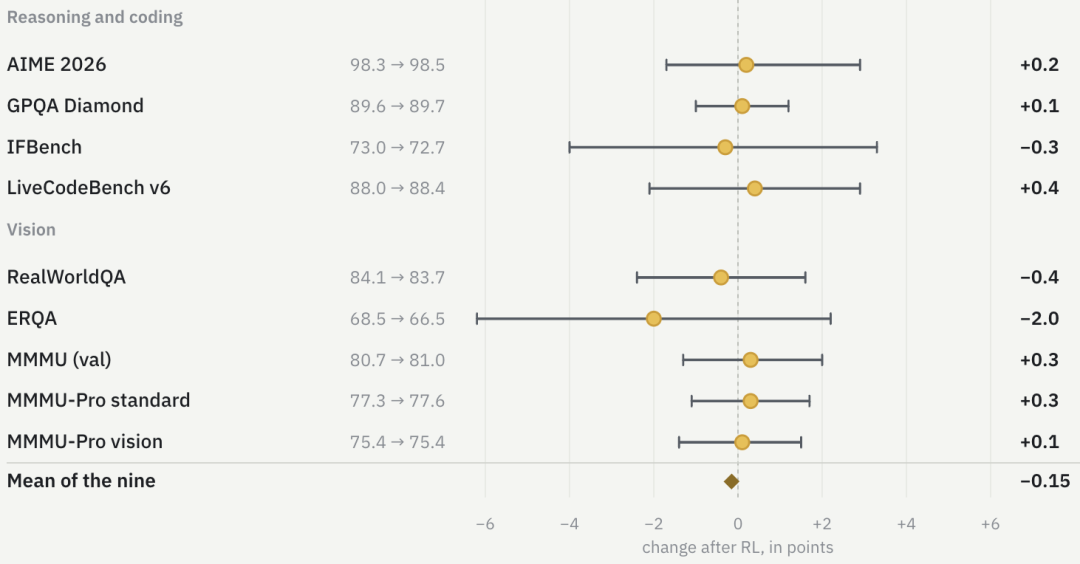
在通用能力测试中,新模型各项视觉基准成绩与基础模型的差距均在两分以内。同一个模型既能推理、写代码和进行看图问答,也能操控机器人。
不过,成功率会随着思考长度缩短而下降:当思考 token 数缩减到原来的不到三分之一时,成功率也只剩不到三分之一。这说明模型在 LIBERO 上的表现,很大程度上依赖每一步动作前较长的推理。
智能体执行速度仍是瓶颈
受 GPU 资源约束,这项研究仅在两套仿真环境、少量任务上训练模型。研究团队认为,扩大仿真场景和任务多样性,或使用更强的基础模型,有望进一步提升机器人操控能力。
执行速度仍是另一个问题。模型在每次移动前都要进行大量推理,单次推理平均约 4.3 秒;极端情况下可达 32k token,单步耗时超过半分钟。如何在不降低成功率的前提下缩短推理链,以及可靠地规划动作块以完成更复杂的运动,仍有待后续研究。
来源
作者:谭梓馨
 发表于 3 小时前
|
查看: 15|
回复: 0
 /1


