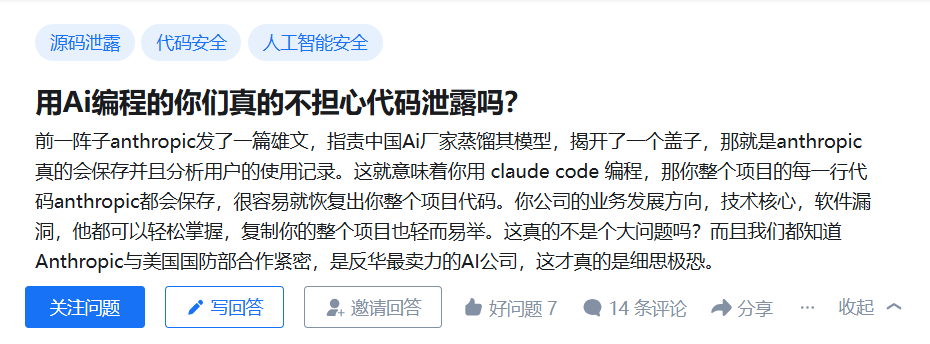
代码不值钱,claude/codex 甚至都懒得偷。
最近 GitHub 更新了一项政策,默认将你的交互式编码数据提供给 AI 训练:
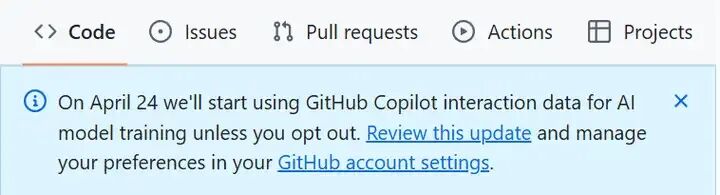
所以真正值钱的是交互式编码数据,也就是你对一段 AI 给出的代码的反应。
你内网那些没 Star、没 Fork、没评论的狗屁代码在 AI 眼里连尸体都不如,纯粹是有毒的电子废料。
你像防贼一样防着人家,以为人家费尽心思想偷你的代码。
实际上人家像防黄毛一样,拼尽全力在写清洗脚本,费尽心思阻止你的垃圾代码污染他们纯洁的数据集。
真正的优质代码都在 GitHub 这样的开源社区上,一般构建训练集的时候会假设代码的质量与它的社区活跃度呈强正相关。
所以 GitHub 的数据非常值钱,那里有 Star,有 Fork,有成百上千条 Issues 的讨论,有 PR 的 Review 记录,这都是人类高质量反应。
而你们的内网代码呢?
没 Star、没 Fork,鬼知道有没有人看过,基本没人认真 review。
一个个都信奉防御式编程,注释是绝对不会主动加的,哪怕有注释,也都是莫名其妙的 // 这里不能动,动了会崩。
代码库重度依赖私有的脚手架、内网仓库、魔改的编译器和运行时,你亲自去教实习生配环境都要教好久。
这种有毒电子废料有什么偷的必要吗?
现在全世界静态的高质量数据已经消耗殆尽了,内网的各种电子垃圾不看也罢,那么现在大模型训练拼什么呢?
简单来讲就是能对齐人类的真实意图的交互式数据。
AI 吐出了一段代码,如果你直接按了 Tab 或者 Accept。
那太棒了,AI 厂商会立刻记录这一组正向反馈,说明对于这种模糊的提示词,人类会喜欢这种格式的输出。
如果你狂敲删除把其中一部分删了。
哦,那你真是大好人,黄金数据来了!
这种细粒度的负向反馈是极其珍贵的,它可以告诉模型,这种写法虽然语法正确,但其逻辑不太符合人类的实际业务需求。
你删掉的那部分有助于进一步提升模型对人类意图的揣测能力。
如果你不仅拒绝了,还手动修改了某一部分然后才运行成功。
那我可要恭喜你了,你刚刚免费为 AI 厂商贡献了极其昂贵的专家强化学习样本。
以前,雇一个资深程序员来给代码打分并改错,一小时 100 美金打底。
现在,全球上千万傻乎乎的程序员,不仅自带干粮主动熬夜加班,还每个月主动掏 20 到 200 美金订阅费倒贴钱给 AI 厂商打白工。
他真的,我哭死。
像防贼一样守着一堆垃圾数据敝帚自珍,却倒贴钱把自己最宝贵的交互数据都送出去,感动 AI 十大人物必有你的一席之地。
 发表于 昨天 14:05
|
查看: 15|
回复: 0
 /1


