AI 越来越聪明,人类却越来越懒得动脑了。
如果你已经在用 Claude、GPT 这类大模型做开发,模型 API 的稳定性与速度会直接影响体验,RouteFast.ai 是不少开发者的选择。
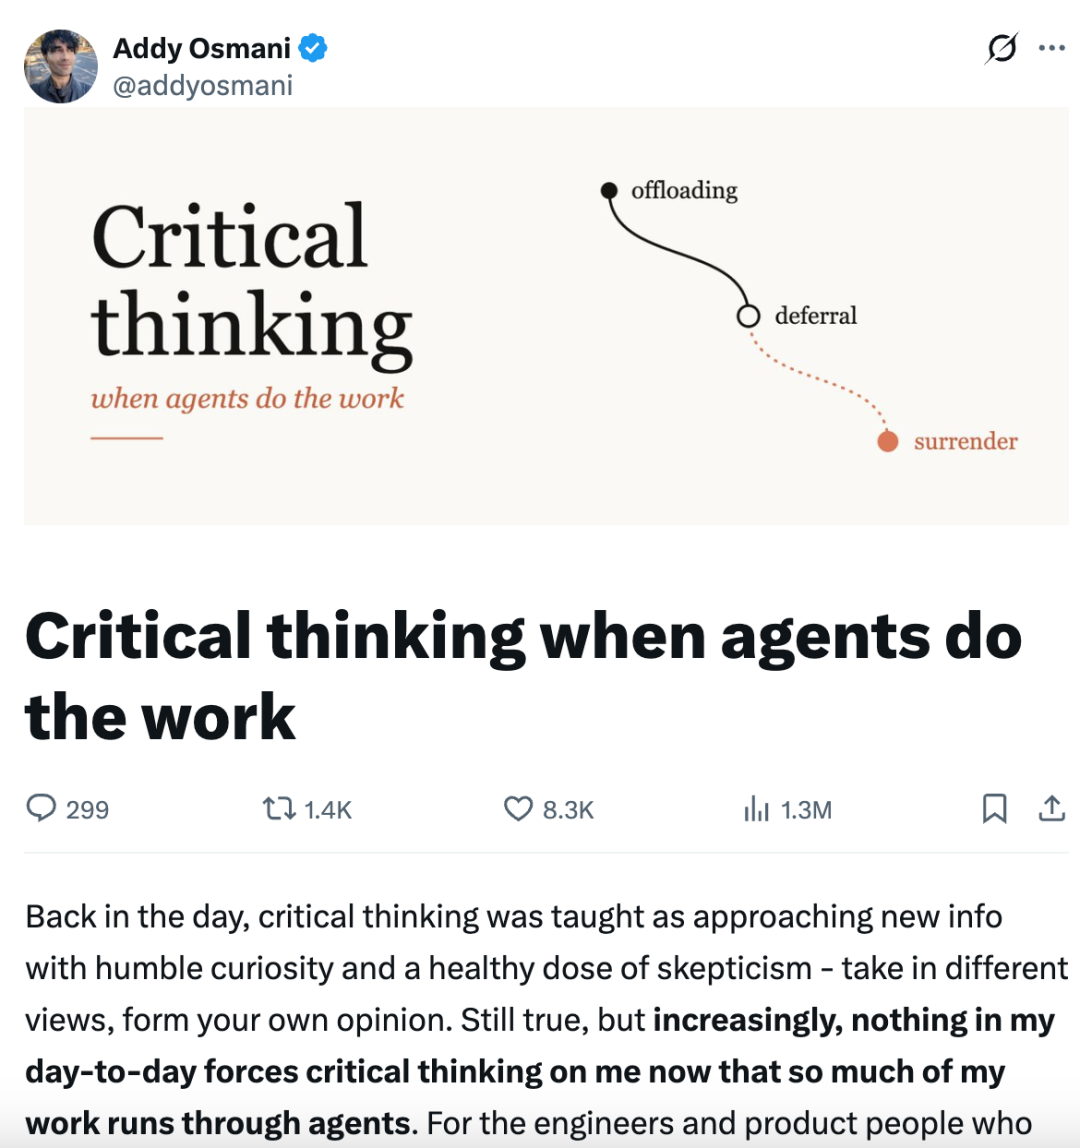
刚刚,前 Google Cloud AI 总监、现 Claude Code 工程师 Addy Osmani 专门发文讨论了这个相当扎心的问题。
在他看来,那些天天指挥 Agent 写代码的工程师们,可能已经不知不觉陷入了一种状态——认知投降(Cognitive Surrender)。
说白了就是 AI 写啥,你信啥。代码能跑,测试全绿,那就大手一挥,“批准!”。可当真有人问起这段代码为什么这么写时,自己却答不上来。
于是,这位亲手参与打造 AI 编程工具的工程师,决定亲自给大家支个有意思的招:
让 Agent 写完代码,再出几道题考考你。
答不上来?那就先别急着合并代码。
AI 越聪明,人越容易被“养废”
Addy Osmani 何许人也?他硕士毕业于英国华威大学,此前在 Google 工作了 14 年多,参与过 Chrome DevTools、Lighthouse 等开发者工具项目,如今则加入 Anthropic,参与 Claude Code 相关工作。
而且,他还是出了名的热门教程高产户。从 Claude Code 使用技巧,到 Agent 工作流、代码审查,几乎隔三差五就有新教程。不过这一次,他把目光投向了一个越来越现实的问题:
当 AI 生成的东西越来越靠谱,人类还会认真检查吗?
以前咱们写代码,还得自己哼哧哼哧查资料、琢磨方案、动手调试。但现在呢?一句 Prompt 丢过去,Agent 可能几分钟就把活干完了。更要命的是,随着模型能力的提升,AI 写出的代码也越来越像那么回事。不仅变量命名规范,逻辑看着也顺,测试还一片绿。于是大家逐渐习惯了第一次认真检查,第二次扫两眼,第三次直接点通过……久而久之,人类就这么从亲自写代码,变成了给 Agent 盖章的。
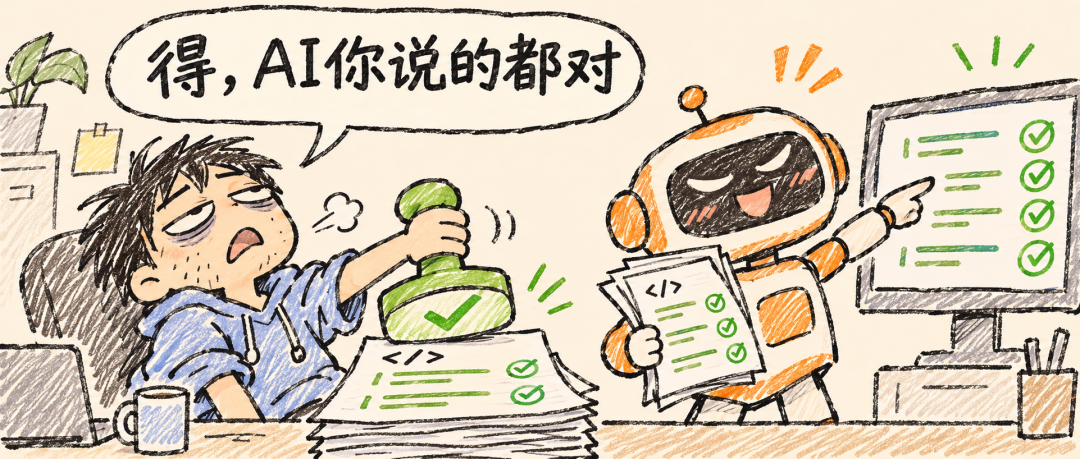
Addy 将这种情况形容为认知投降(Cognitive Surrender)。它并非一夜之间发生,有一个逐渐加深的过程。
- 起初可能只是认知卸载:我们只是把具体工作交给 AI,但自己仍然理解任务,也能判断结果;
- 接着开始判断让渡:AI 给出的答案逐渐成为下一步工作的默认依据;
最后就到了认知投降:
行了行了,AI 说得肯定有道理,那就听它的吧。
至此,连原本应该由自己完成的判断,我们也统统拱手交了出去。
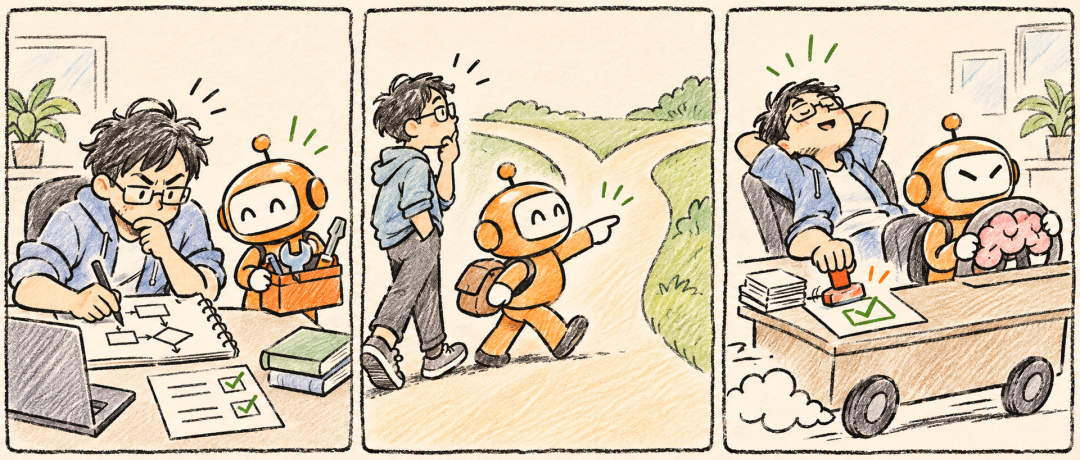
Addy 举了个非常典型的例子:
假如 Agent 一口气提交了一个 600 行代码的 PR(拉取请求)。开发者一看,结构清晰、测试通过,ok 放心合并。殊不知,Agent 可能在某个不起眼的地方,悄悄改了事务处理顺序,或者调整了某个边界条件。
这些改动没有在当时立刻报错。但等到系统真出了问题,开发者才突然发现,自己甚至解释不清这段代码为什么这么运行。
最麻烦的还在后面。Addy 认为,长期这样使用 Agent,还会积累出一种新的技术债务——理解债(Comprehension Debt):代码写得越来越多,系统功能越来越复杂,可开发者对代码的理解,却没能跟着一起增长。于是,等到真正需要修改某个功能时,大家才恍然发现,这座代码大厦虽然盖起来了,却越来越没人摸得清内部结构,只能茫然地面面相觑。
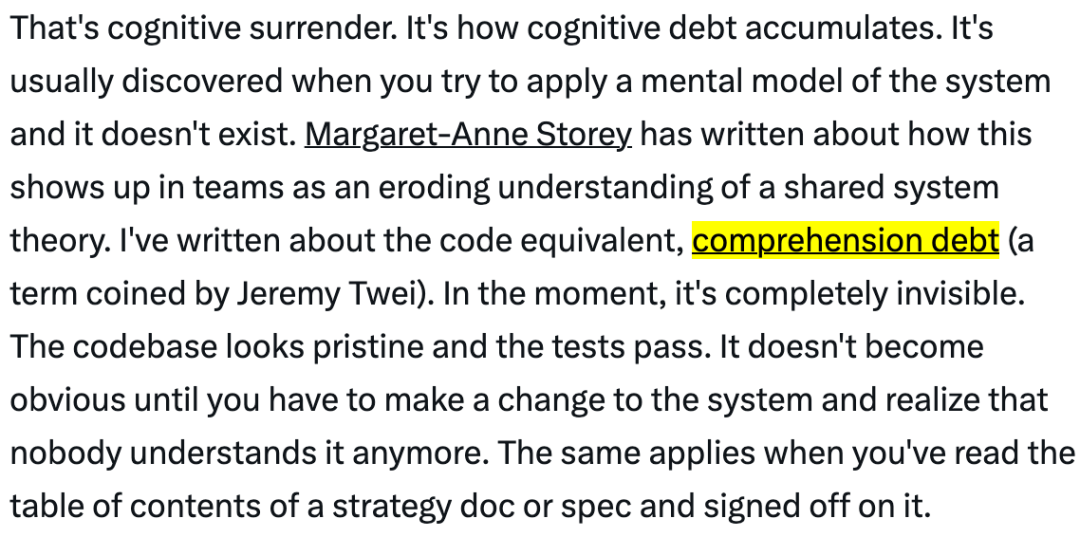
当然,这并不意味着每一行 AI 生成的代码都要亲自读完。Addy 也提到,Claude Code 团队也不会要求工程师随时记住整个代码库,他们会在需要修改某一部分时,借助 Claude 重新理解相关逻辑。只是这里有个前提:
你必须得知道自己懂什么,又有哪些地方还没搞懂。
否则,代码写得越快,你的理解债也可能欠得越多。
防沉迷小妙招:让 Agent 反过来考咱们
那么问题来了。Agent 现在这么能写,咱们究竟该怎样跟上它的速度呢?
Addy 在长文里分享了不少实操干货。其中最有意思的一招,就是让 Agent 变成考官。
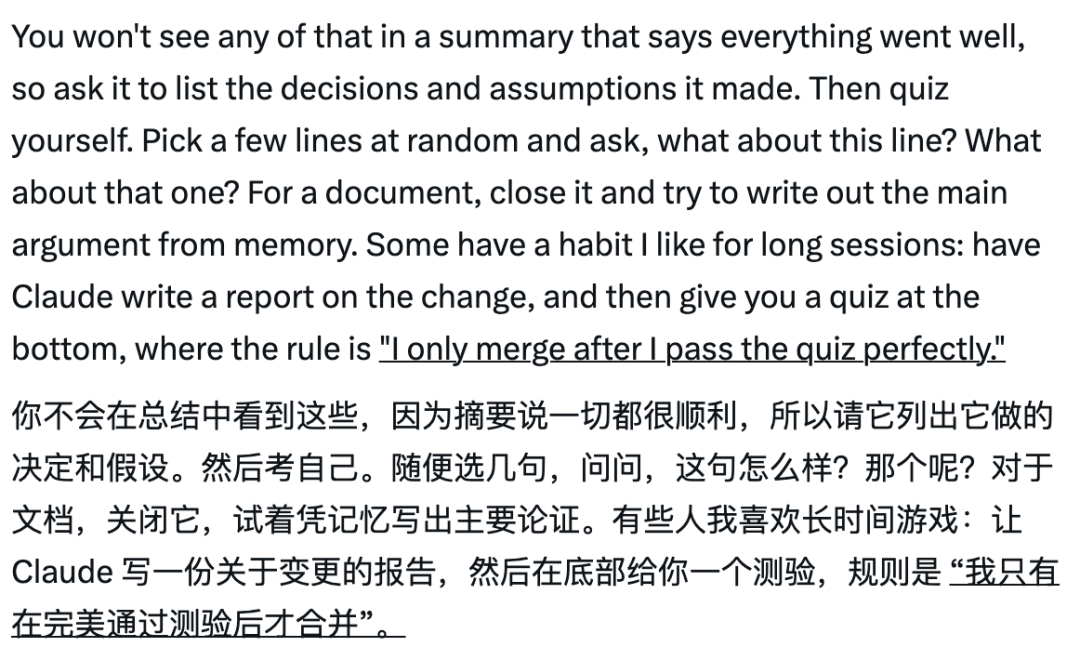
咱假设啊,Claude 刚刚完成了一项大型代码修改。先别急着点通过。我们可以先让它总结这次到底改了哪些地方、为什么这么改,再根据修改内容给我们自己出几道题,并立一条规矩:
只有测验全部答对,代码才能合并。
这样一来,我们就能真正清楚和理解自己究竟批准了什么,避免出现不必要的错误。
除此之外,Addy 还多分享了几招,我也都给大家梳理出来啦。
妙招 1:写 Prompt 之前,自己先动脑列出需求清单
Addy 提到,现在的 Agent 确实太擅长补全需求了。哪怕我们自己还没想明白要什么,它也能交出一份像模像样的作品。可问题恰恰出在这里,需求里那些没说清楚的目标、限制和取舍,可能就这么被 AI 替你决定了。
Addy 把这种情况称为“意图债”(Intent Debt)。
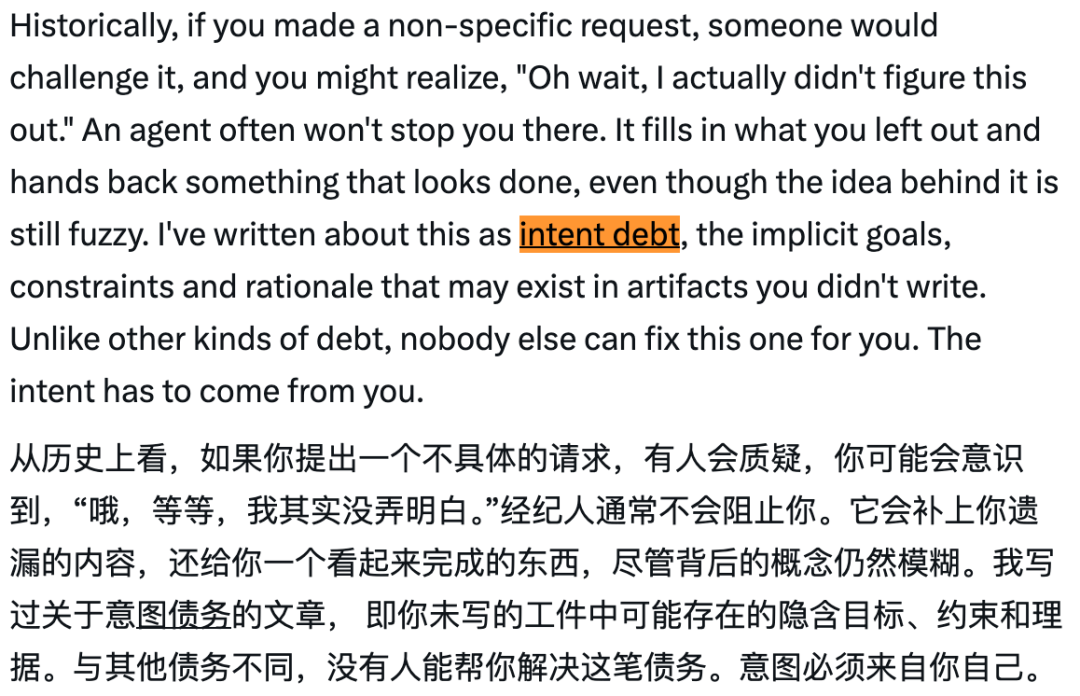
所以他建议,下达任务之前,我们最好先用自己的话写一份简短的需求说明。包括面向谁、想解决什么问题、哪些事情不需要做,以及做到什么程度才算完成。先想清楚,再让 Agent 开工。如果连续调整两轮 Prompt 仍然得不到想要的结果,那咱们就该回头重新梳理需求了,而不是继续往上堆提示词。
妙招 2:让 Agent 主动交代,它背着你做了哪些决定
这一点尤其适合长时间运行的任务。因为 Agent 在执行过程中,可能会自行选择默认参数、调整实现范围,甚至在不同需求发生冲突时做出取舍。这些决定,它未必会主动写进最后的总结里,甚至自然到难以察觉。
所以,比起只问一句“完成了吗”,Addy 建议我们不妨继续追问:
- 你做了哪些我没有明确授权的决定?
- 哪些地方依赖了自己的假设?
- 还有什么没验证?
- 以及,哪些改动可能影响其他功能?
这样一来,大家至少就能看清 Agent 在执行过程中作出了哪些取舍,再可以根据代码和测试结果逐步核对 Agent 自己交代的内容了。
妙招 3:别光看测试全绿,还得问它没测什么
Addy 特别提醒,所谓绿色的测试结果只证明测试覆盖到的条件通过了。如果边界情况根本没有写进测试,Agent 照样可以交出一份看起来很漂亮的报告。因此,他建议大家仔细查看实际执行了哪些测试、返回了什么结果,再去读 AI 生成的总结。对于高风险修改,还可以增加独立检查,让另一个 Agent 从不同角度寻找问题。
妙招 4:Agent 可以多开,但重要任务必须要保留原始材料和验证依据
现在估计有不少的小伙伴们已经开始同时指挥多个 Agent 了。一个负责写前端,一个负责改后端,还有一个负责测试。效率简直是芜湖起飞。但与此同时,就跟人与人之间的传话会有损耗一样,当多个 Agent 协作时,一个 Agent 的总结很容易直接成为下一个 Agent 的输入;传着传着,到了最后,整个工作流可能就已经离原始资料越来越远,导致原始信息里那些关键细节可能早就丢了……
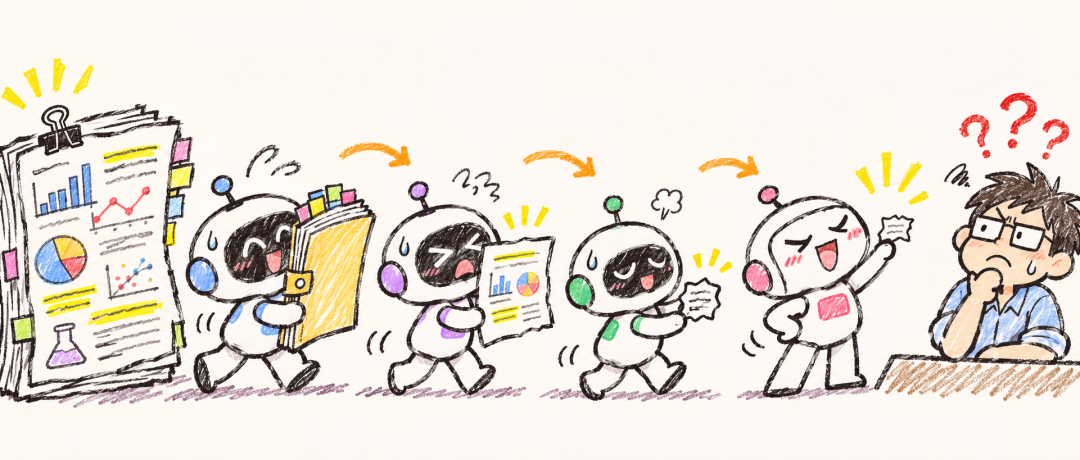
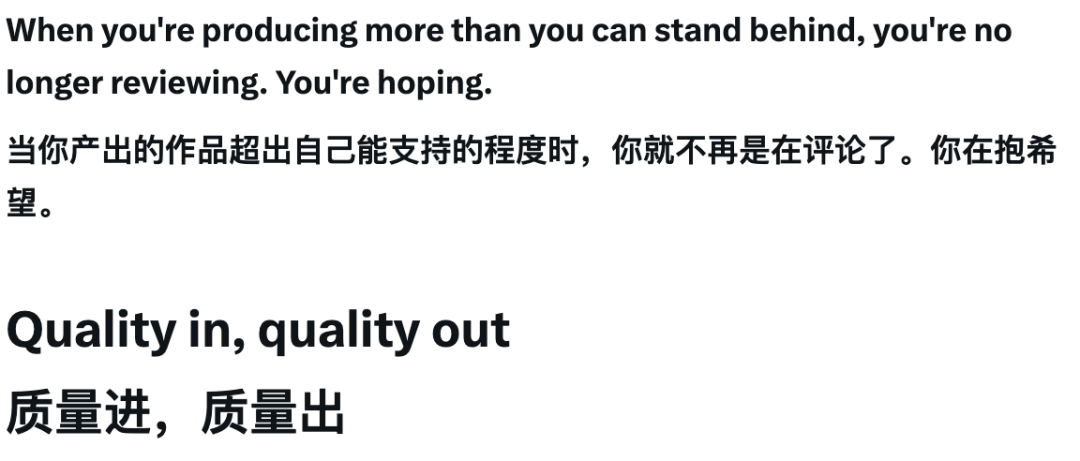
Addy 因此提醒,重要任务必须要保留原始材料和验证依据。至于那些已经多到根本审不过来的任务,要么补上自动化检查,要么先减少并行数量。不然,继续增加 Agent 数量,只会让待审核的内容越堆越高。Addy 对此给出的判断也相当犀利:
当你生成的内容已经多到无法负责时,你做的就不再是审查,而是在赌它没问题。
妙招 5:每周留点时间,让自己回归古法手搓代码
这招听上去甚至有点复古。都 2026 年了,Claude 工程师居然还劝大家偶尔别用 Claude?
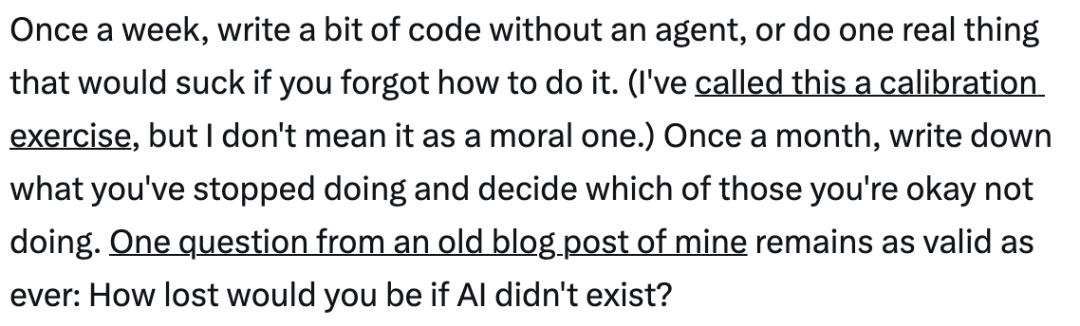
但 Addy 认为,长期不使用的技能确实可能逐渐退化;偶尔脱离 Agent 独立完成任务,也能帮助大家随时校准自己当前的真实水平。所以他建议大家,每周至少安排一次不依赖 Agent 的独立编码练习。每个月也可以顺手盘点一下:
- 自己已经把哪些技能交给了 AI?
- 哪些能力可以放心外包,哪些又必须继续掌握?
这样做还有一个额外好处:至少还能知道,离开 AI 后,自己现在究竟还能干些什么。
在文章的最后,Addy 还分享了一个极其简单的自测办法,那就是每次向 Agent 提问前,先写下自己预期会发生什么。等 AI 交卷后,再试着找出一件它可能没检查到的事。这样一来,我们至少就能保证在整个工作中,脑子也跟着转了两下。
Anyway,分享完这些干货后,Addy 还留下了一个值得所有 AI 重度用户认真思考的灵魂拷问:
家人们都说实话啊,要是明天 AI 集体罢工,你们觉得自己能撑几天不崩溃呢?
嘶……是啊,能撑几天呢?别人不知道,反正对我这种选择困难症晚期患者来说,多少有点天塌了。毕竟,出个门需要 AI 帮忙规划行程,找个路得问 AI,就连去餐厅吃顿饭,都恨不得先让豆包帮我研究一下菜单,看看哪道菜最值得点。这么一想想,AI 要是真集体罢工了,我可能连今天的午饭吃啥都真的得重新学起咯。
One More Thing
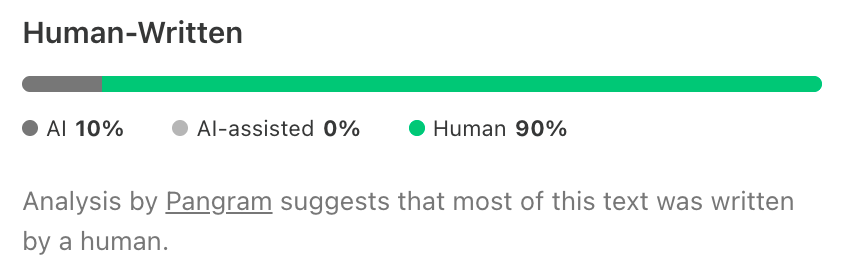
其实吧,最有节目效果的果然还是在最后。洋洋洒洒地教完大家怎么防止被 AI 养废后,Addy 居然还在文章末尾骄傲地晒出了一张 AI 检测报告。Pangram 检测结果显示:
人类撰写 90%,AI 生成 10%,AI 辅助 0%。
哈哈哈哈,合着前面苦口婆心劝大家别把脑子外包给 AI,最后自己也没忘了亲自交作业:
放心,这篇劝你们动脑子的文章,我也是真动脑写了!
好好好,真·知行合一。
如果你对这类 AI 编程实践的讨论感兴趣,欢迎到云栈社区一起交流,那里也有不少关于 Agent、Claude 和 LLM 开发的实战经验。
参考链接:https://x.com/addyosmani/status/2117512471930167377
 发表于 2 小时前
|
查看: 3|
回复: 0
 /1


