近日,深度原理正式对外发布了面向科研任务的通用大模型 Hydrogen-1.0,并同步开放模型权重。据团队介绍,该模型以 GLM-5.3 为基础,总参数量约为 753B,通过全参数后训练引入了化学、材料科学与生命科学知识,同时还融合了实验记录与多轮研究过程数据。
科研任务中的判断往往离不开具体条件。例如,分子模拟跑出异常的材料密度后,研究者需要先判断问题出在哪里,再决定下一步怎么处理。这类判断高度依赖专业知识和研究经验。深度原理把这些经验总结纳入了模型训练。团队使用的自有科学数据——包括实验室记录和多轮材料探索过程——让模型学会了如何在研究进程中适时调整方案。
利用研究过程数据开展全参后训练
科学知识固然能提供依据,但具体怎么做,还得看任务条件。一个计算结果表面上合理,背后的假设却未必适用于当前实验,因此不能只看结果,还需要回头检查计算过程。
实验方案同样受设备和操作条件限制。研究者为什么选择某种方法,为什么中途调整,这些细节在最终发表的论文里往往没有完整记录。仅凭最终结果,很难还原当时的判断,也不足以为排查异常、调整方向提供参考。
深度原理把研究过程记录纳入训练,希望模型学到研究者如何分析结果、如何决定下一步行动。据团队介绍,Hydrogen-1.0 在 GLM-5.3 上进行了全参数后训练,训练内容覆盖化学、材料科学和生命科学,并加入了自有科学数据及科研人员反馈。
数据不仅记录实验的完整过程,也包含研究者调整方案时的考虑。其中,材料研发数据保留了连续多轮的推荐与评估记录,可以看到前一轮的反馈如何影响下一轮选择。训练时,模型先学习任务范例,再根据反馈进行优化。
考虑到科研任务的推理过程通常较长,团队调整了长文本训练方式,以保留更完整的推理记录。团队还介绍,强化学习阶段可以保存尚未完成的生成进度,后续接着生成,减少重复计算。
公开基准评测成绩
FSR 用于评估模型解决物理、化学和生物领域中陌生、多步骤研究问题的能力。在团队公布的本次 FSR 评测中,Hydrogen-1.0 的解题成功率为 38.3%,GPT-6-Astra 为 33.3%;Hydrogen-1.0 较基础模型 GLM-5.3 提高了 13.9 个百分点。
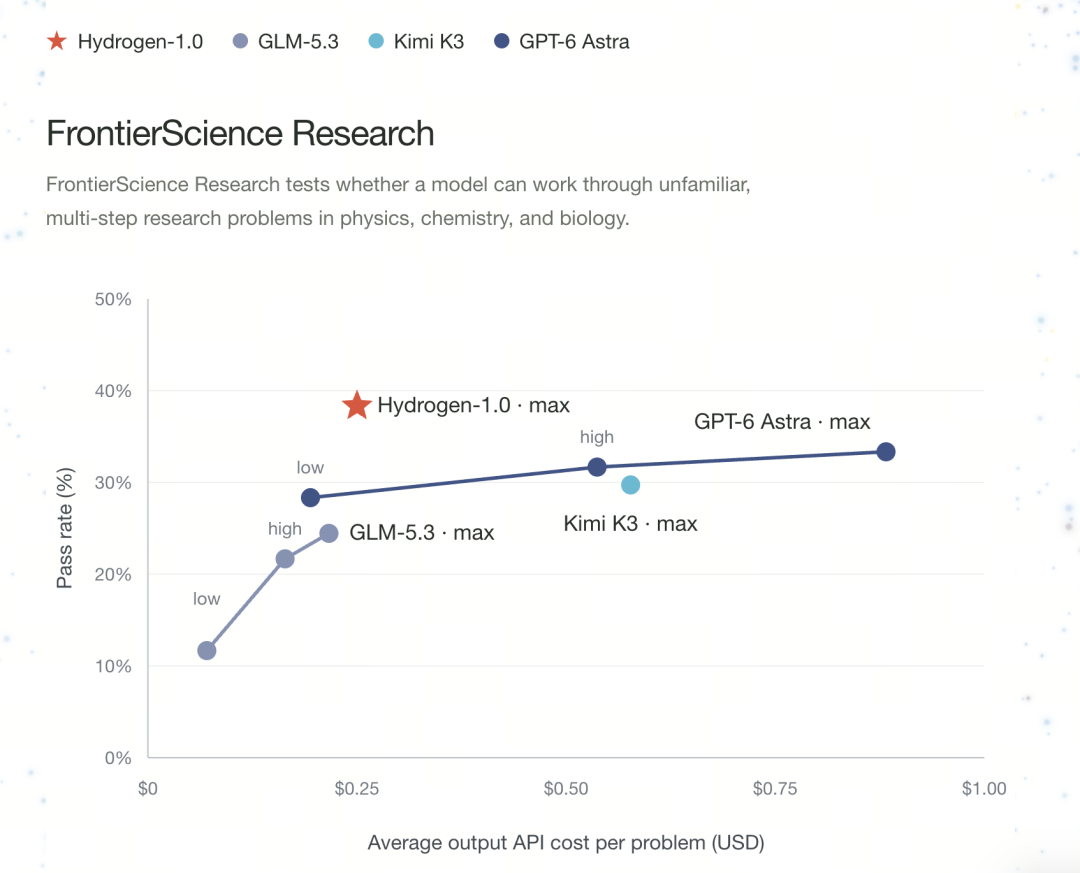
图 1 FrontierScience Research 评测。纵轴为解题成功率,横轴为每道题的平均输出 API 成本(美元)。Hydrogen-1.0 为 38.3%,GPT-6-Astra 的 max 为 33.3%。
GPQA Diamond 采用专家编写的高难度科学选择题。在团队公布的结果中,Hydrogen-1.0 的准确率为 93.0%,Kimi-K3 为 93.5%;图中 GPT-6-Astra 所列推理设置下的准确率均高于 Hydrogen-1.0。
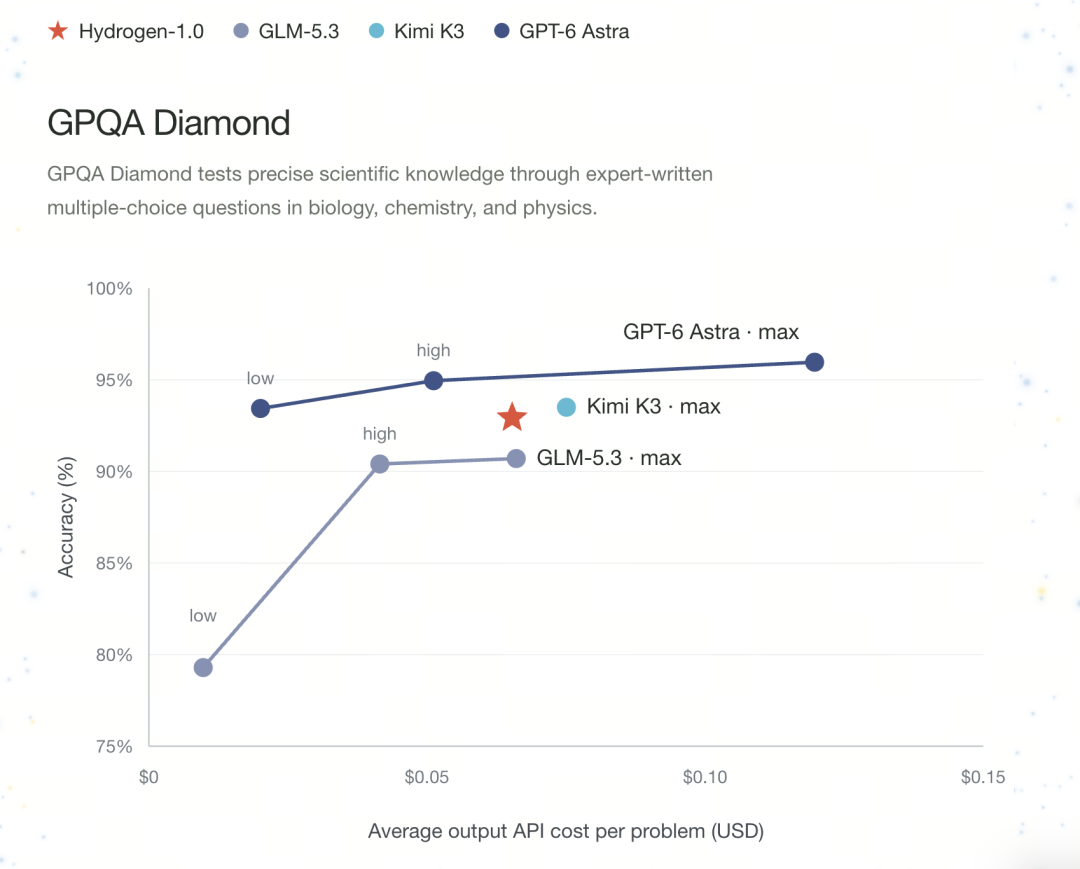
图 2 GPQA Diamond 评测。纵轴为答题准确率,横轴为每道题的平均输出 API 成本(美元)。
团队还公布了科学计算、单步反应预测、核磁共振结构解析等任务的内部测试结果。不同任务中的相对表现有所差异:Hydrogen-1.0 在科学计算和单步反应预测中的平均回答得分高于图中所列 GPT-6-Astra 的结果。
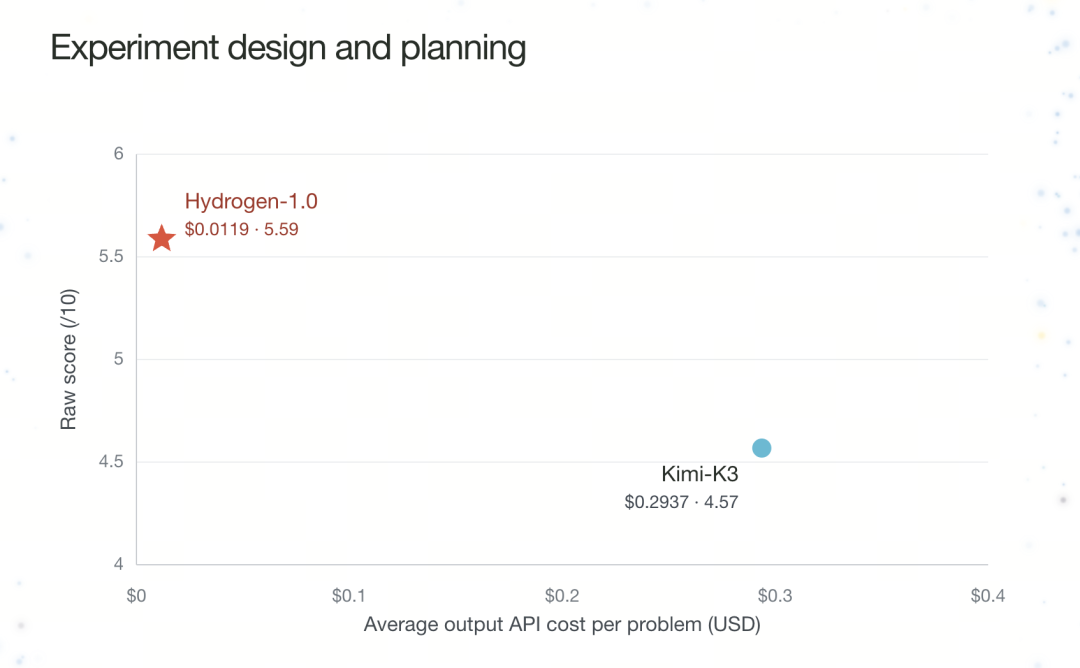
图 3 实验设计与规划内部测试。纵轴为回答得分(满分 10 分),横轴为每道题的平均输出 API 成本(美元)。
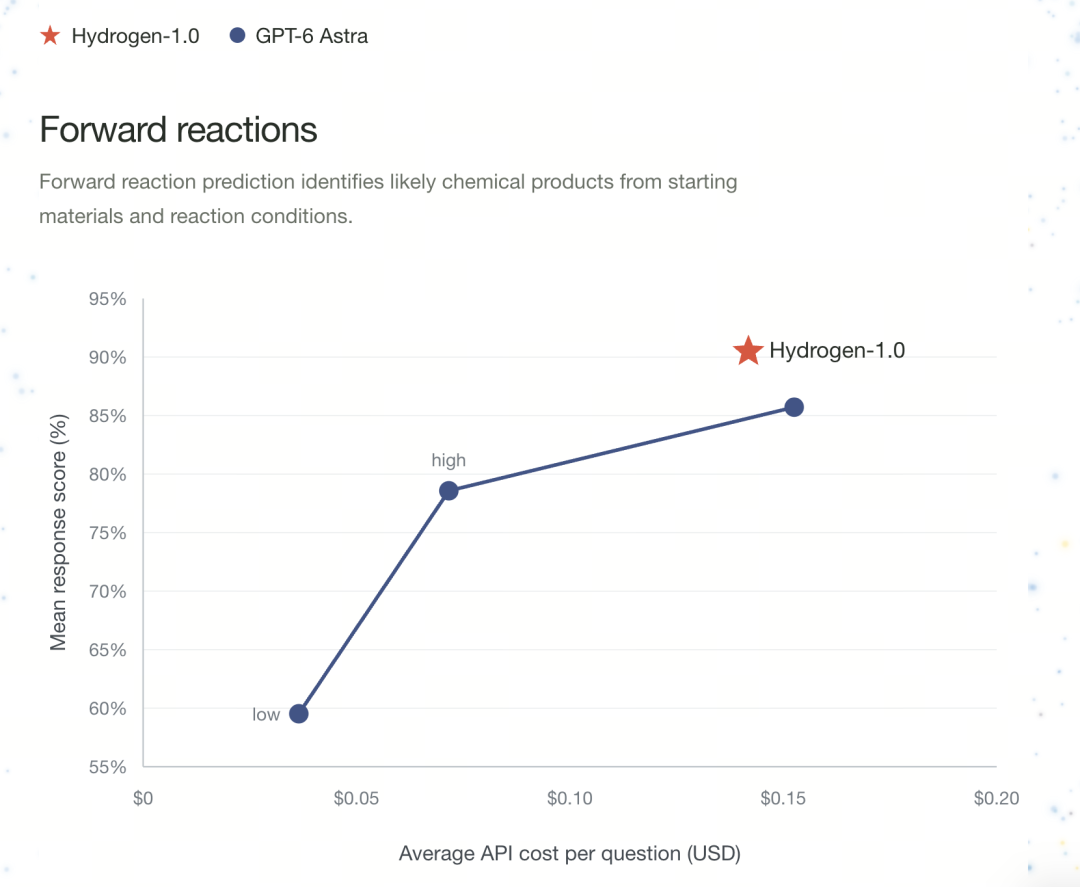
图 4 单步反应预测内部测试。纵轴为平均回答得分,横轴为每道题的平均 API 成本(美元)。
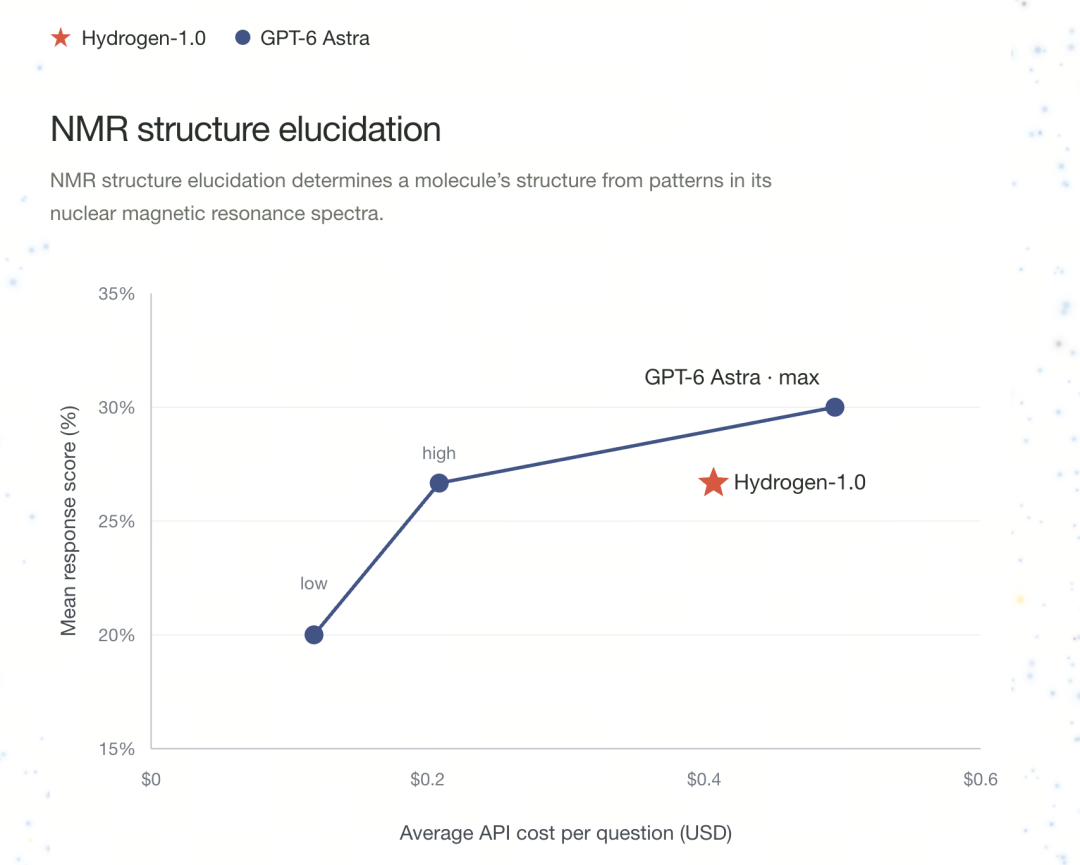
图 5 核磁共振结构解析内部测试。纵轴为平均回答得分,横轴为每道题的平均 API 成本(美元)。
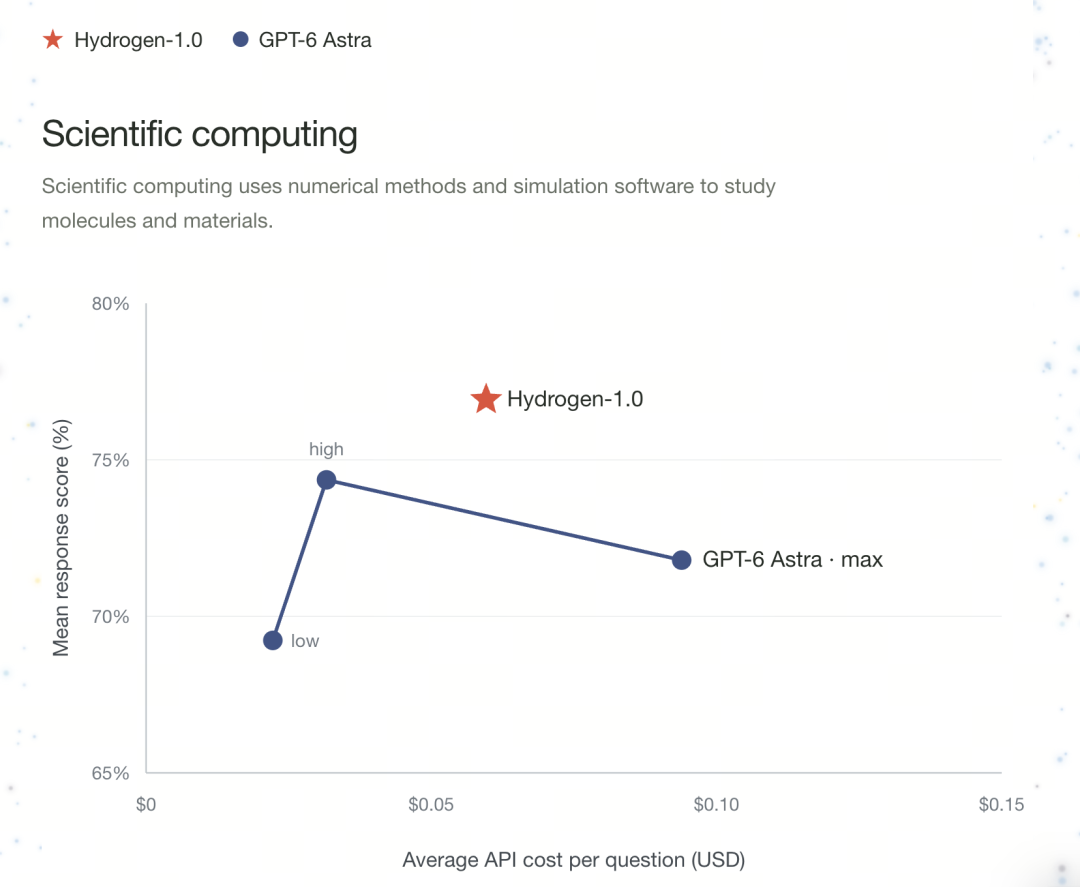
图 6 科学计算内部测试。纵轴为平均回答得分,横轴为每道题的平均 API 成本(美元)。
在实验设计与规划测试中,团队同时比较了回答得分与平均输出 API 成本。图中 Hydrogen-1.0 相较 Kimi-K3 得分更高,同时输出 API 成本更低。
科学研究任务中,Hydrogen-1.0 能帮助做什么?
除了基准评测,团队还展示了若干模型与工具配合完成科研任务的案例,涉及实验过程的异常排查、反应路线分析、候选搜索和实验操作检查。
比如,在聚乙烯材料模拟中,Hydrogen-1.0 得到了异常的材料密度,随后检查程序并发现重复计算的问题。修正后,模型重新运行了模拟,展现了对异常结果进行排查和修正的能力。
在反应路线分析中,Hydrogen-1.0 可以根据已有计算记录自主梳理路线步骤,分析可能的推进难点,并提出替代选择。
在金属配合物搜索任务中,各个候选模型从同一批初始候选出发,每轮只推荐一个新候选,且只能看到自己所选候选的评估结果。经过五轮探索,Hydrogen-1.0 找到的最佳 HOMO–LUMO 能隙平均值为 4.318 eV,GPT-6-Astra 与 Kimi-K3 分别为 3.689 eV 和 3.353 eV。这一结果反映了模型在同一候选范围和反馈规则下调整搜索方向的出众表现。
在一项探索能否减少钯催化剂用量的演示中,Hydrogen-1.0 生成了实验操作方案。虚拟编译环境 Lab Compile 能够检出实验室不满足条件的操作,自动拦截不当步骤,确保实验流程的可执行性。
这些案例展示了模型如何利用反馈调整输出,也展示了外部工具如何对模型方案进行检查。团队通过完整的研究记录训练相关能力,提升了模型在科研任务中的实际表现。
模型权重开放与获取方式
不同实验室的任务、设备和操作条件存在差异,即使研究对象相同,可行方案也可能不同。深度原理希望通过开放模型权重,让更多研究者在各自的任务中评估模型,并提供反馈。研究者可以结合本领域的具体问题,评估模型表现并开展针对性改进。
Hydrogen-1.0 模型权重已在魔搭 ModelScope 发布,开发者可根据模型页面的说明下载和部署,并结合自身科研任务开展验证。据团队介绍,研究者也可在深度原理的 AI Scientist 产品 Mira 中调用该模型。
ModelScope 模型页面:https://www.modelscope.cn/models/deep-principle/Hydrogen-1.0
Mira 平台:https://mira.deepprinciple.com/
技术介绍:https://blog.deepprinciple.com/introducing-hydrogen-1.0/
 发表于 2 小时前
|
查看: 2|
回复: 0
 /1


