从 Figure 01 接入 Astra 展现自然语言实时交互,到谷歌用 Project Astra 和 RT-2 演示多模态大模型的空间常识拆解,通用基础模型向物理控制领域的渗透势头越来越猛,一度让具身智能行业陷入集体焦虑——专用具身策略会不会被大模型降维收割?
但现实是,商业闭源接口的物理黑盒、毫秒级延迟风险,以及拿不到模型权重的限制,长期把绝大多数开发者挡在物理闭环训练之外。比如,多模态大模型能否真正把「识别物体」这一步转成机械臂可执行的「抓取动作」,中间还隔着接口、坐标、控制协议等一系列工程障碍。
最近,加州大学伯克利分校与清华大学联合团队发布论文《Democratizing Robot-Use Agents: A Unified Harness with Open Models(让机器人操作智能体走向普惠:基于开源模型的统一交互框架)》,提出并开源了统一的机器人 Agent 框架 uni-robot-agent,为通用开源大模型连接仿真环境与真实机器人提供了一套可复用的工程基础。
在零样本条件下,开源权重模型 Qwen3.8-Flash-Next 的表现相当亮眼:
- 在 RoboDojo 仿真基准中拿到 31.39 分,超过闭源旗舰 GPT-6 Astra 此前公布的 28.97 分基线,也超过了多个经过任务微调的 VLA/WAM 基线模型;
- 在 19 项真实机械臂操作中获得 53.50 分,超过零样本 Dream-1 的 43.50 分,也高于每项任务经过 10 小时机器人演示数据微调的专用具身策略模型 π₀.₅ 的 47.75 分。
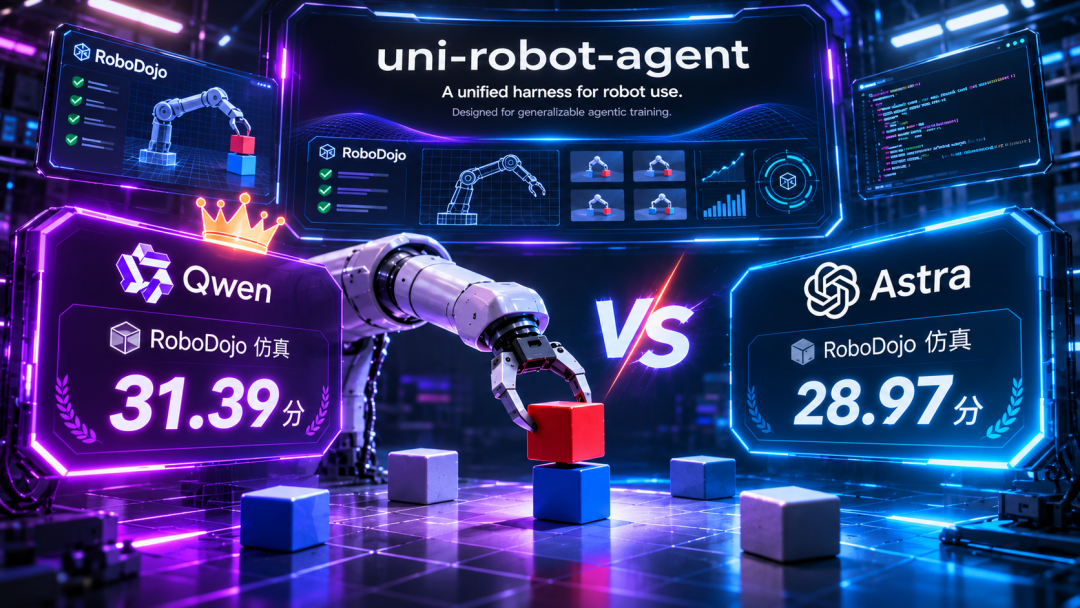
图注:uni-robot-agent 的实验结果与系统概览
这份研究的团队阵容也值得关注,共有 28 位作者参与。第一作者为 Jiarui Yuan,Yuxin Zuo、Xiaoyu Huang 担任项目负责人,其中 Yuxin Zuo 曾在阿里从事研究工作,并参与过 Qwen3.5 相关项目。其他作者还包括伯克利机器人学习实验室主任、BAIR 联合主任 Pieter Abbeel(机器人学领域泰斗级人物),以及清华大学教授刘知远、周伯文等知名学者。
这项研究沿着通用多模态大模型驱动机器人操作的 Robot-Use Agent 技术思路,进一步把这一能力从闭源前沿模型拓展到了开放权重模型,降低了机器人操作智能对商业闭源模型 API 的依赖。
通过统一工具接口、执行调度和反馈机制,研究团队也为开放权重模型的本地部署、机器人交互数据采集以及后续训练提供了可复用的工程基础。
模型与本体解耦
大模型控制机器人一直面临一个底层工程难题:不同模型、机械臂与仿真环境之间的接口高度割裂。以往为特定机器人编写的控制脚本无法平移给其他硬件,模型换一个版本,提示词和解析逻辑往往就要推倒重写。
uni-robot-agent 的本质,是充当连接通用基础模型与物理硬件之间的 Agent Harness(统一运行中间件)。它的核心设计原则是决策与执行彻底解耦,自上而下分为五层架构:
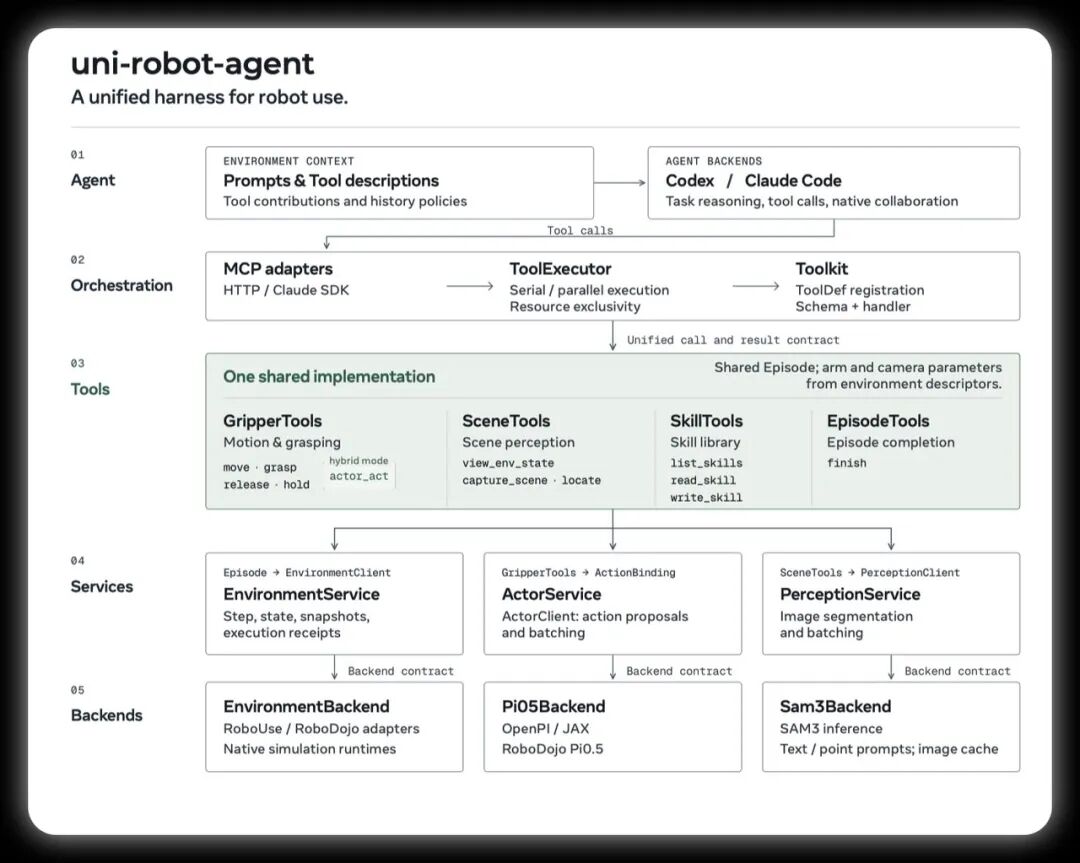
图注:uni-robot-agent 五层架构图
- Agent 层:负责接收任务目标、管理多模态长上下文,并驱动大模型输出结构化意图;
- Orchestration(编排层):负责管理状态机、校验动作参数、调度异步任务与异常拦截;
- Tools(工具层):向下封装出通用的原子化控制接口,例如空间位姿平移、连续夹爪控制、环境感知采样;
- Services(服务层):统一处理多相机内外参标定矩阵、点云投影与空间坐标变换;
- Backends(后端层):直接对接具体硬件驱动或仿真内核,例如 Franka、ALOHA 双臂、RoboDojo 仿真器等。
举个例子,当 Qwen 接收到「把红色积木放到蓝色积木上」的指令时,它不需要知道某台机械臂具体使用什么控制协议,而是通过统一工具接口提交目标位置、姿态和夹爪状态。框架再通过对应的环境适配器,把这些操作转换为机械臂能够理解的控制命令。
动作执行后,机器人返回最新状态、摄像头图像和执行结果,大模型据此判断是否需要调整下一步操作。
论文还专门展示了工具复用机制。过去如果有 N 种机器人操作工具和 M 种不同环境,开发者可能需要维护 N×M 套工具与环境的组合实现。而通过统一工具接口和环境适配器,可以压缩为单点扩展的 N + M 适配器模式,工具逻辑跨环境复用,重复开发量大幅下降。
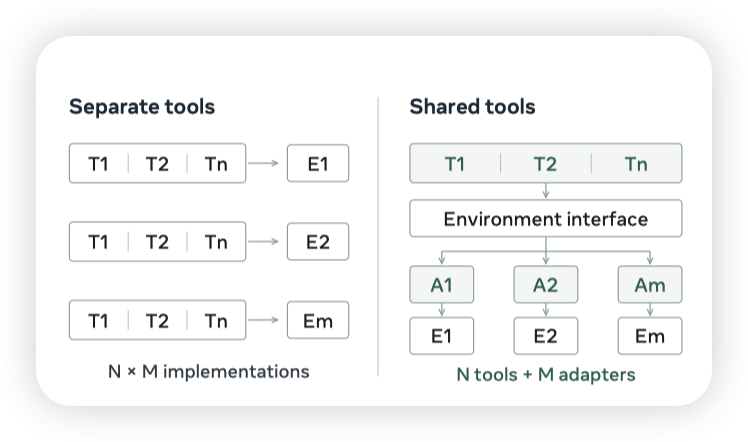
图注:工具与环境适配器的复用关系
除了接口统一,框架还针对物理控制的运行效率做了针对性优化。过去「模型串行思考—机械臂动作—等待下一次思考」的交互方式存在大量时间空转。
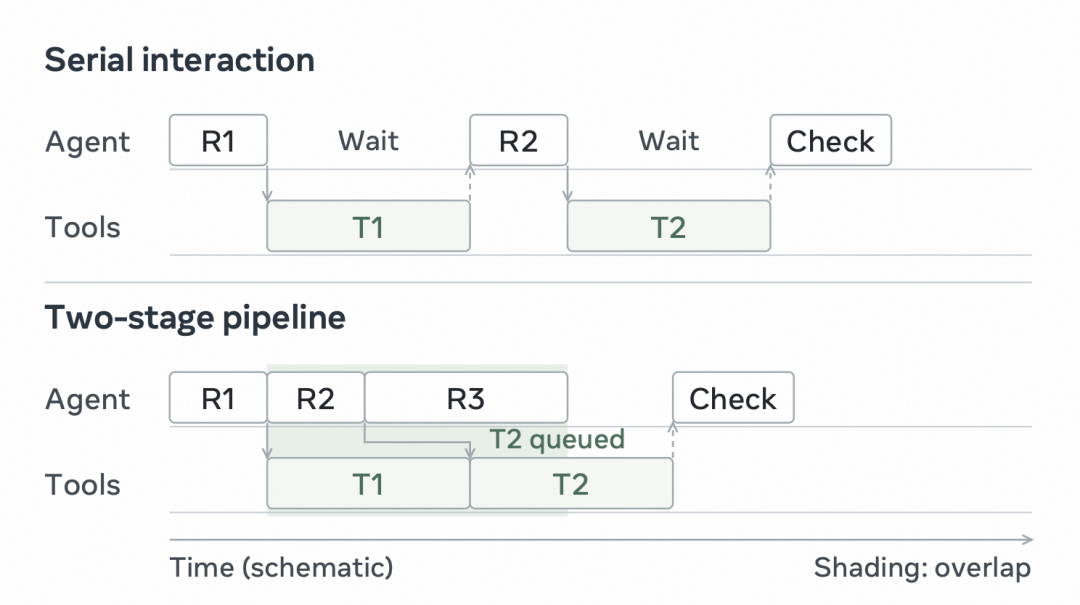
图注:串行交互与流水线执行
框架采用了模型推理与底层执行重叠的流水线调度:在机械臂平稳移动的同时,并行预加载下一步动作规划,大幅压低了端到端物理等待延迟,为后续高频交互轨迹的规模化采集打下了工程基础。
开源阵营的物理战力
为了验证中间件的实际效能,论文分别在虚拟仿真 RoboDojo 测试与真实物理双臂环境下组织了系统性评测。
42 项 RoboDojo 仿真测试
RoboDojo 是基于 Isaac Sim 构建的高难度物理基准,覆盖开放泛化、精细装配、长程多步、时序记忆与模糊指令理解五个维度。
评测严格限制模型只能使用 RGB 画面、相机标定与机器人本体关节读数,刻意剥离真实深度图、物体 CAD 模型以及任务成功验证器等外部特权信息,迫使模型完全凭借真实视觉输入进行空间推演。
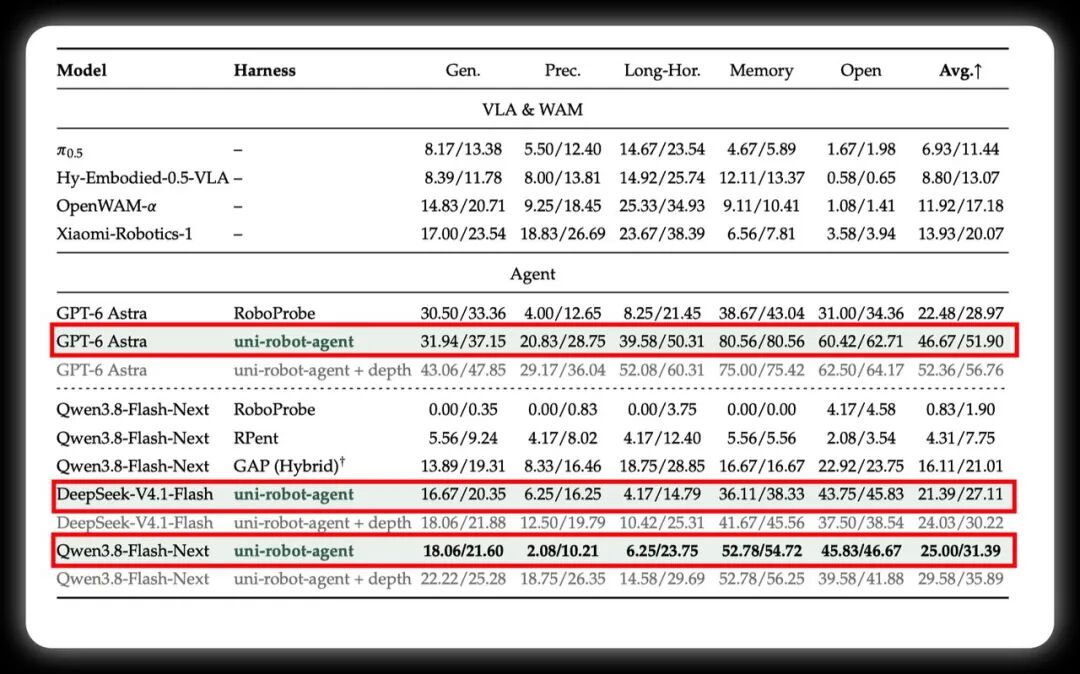
图注:42 项 RoboDojo 仿真测试结果
实验数据呈现出多维度对照细节:
1)开源模型表现亮眼
接入 uni-robot-agent 后,开源权重模型 Qwen3.8-Flash-Next 拿下 31.39 分(完整任务成功率 25.00%);同属开源阵营的 DeepSeek-V4.1 也取得 27.11 分(成功率 21.39%),两者都越过了 GPT-6 Astra 配旧系统 RoboProbe 跑出的 28.97 分。
2)中间件是真正的效能放大器
控制变量实验清楚说明,基座模型能否在物理世界发挥作用,高度依赖中间件的精密程度。同一个 Qwen 模型,在旧基准 RoboProbe 下仅有 1.90 分,在 RPent 下为 7.75 分,在 GAP 混合框架下为 21.01 分,换到新框架后直接飙升至 31.39 分。
3)顶尖模型的上限也被拉高
当闭源旗舰 GPT-6 Astra 换上 uni-robot-agent 后,纯视觉得分飙到 51.90 分(成功率 46.67%),引入深度数据后更达 56.76 分。这印证了前沿闭源模型在认知高度上仍有明显优势,只是此前的工程框架严重遮蔽了这一潜能。
19 项非结构化桌面实机盲测
走出仿真器,团队在配备两只 X5 机械臂与三台 RealSense D405 相机的 ARX AC one 双臂平台上,搭建了覆盖空间理解、物体泛化、指令遵循、组合泛化与未见任务五个维度的 Real Eval 真机测试集。
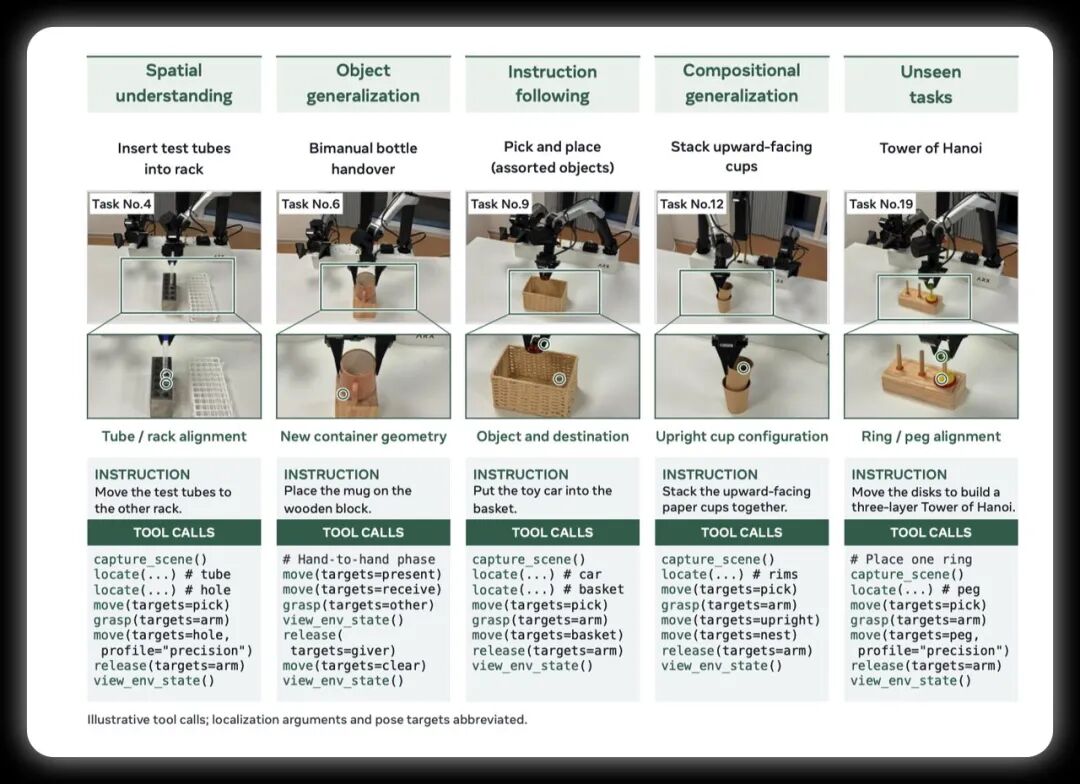
图注:真机任务代表性场景
实机评测进一步凸显了通用大模型与专用具身策略模型的差距:
- GPT-6 Astra:80.50 分
- Qwen3.8-Flash-Next:53.50 分
- 专用具身策略 π₀.₅(微调):47.75 分
- 视觉运动策略 Dream-1(零样本):43.50 分
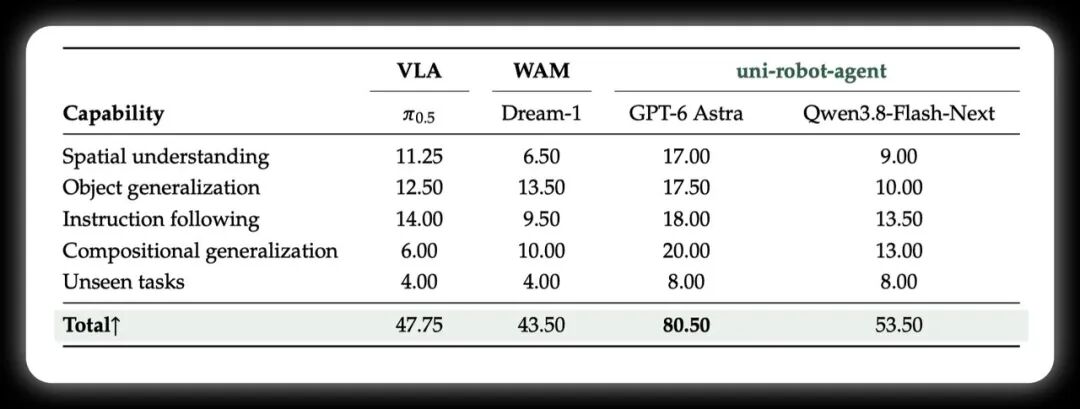
图注:19 项真实机器人测试的五维度成绩对比
可以看到,通用大模型凭借「常识推理 + 容错自愈」的泛化优势,无需特定训练就超过了靠海量遥操数据死记动作的专用具身模型。而 Astra 的断层领先更说明一个问题:机器人物理操作的天花板,终究取决于基座模型的认知高度。
决定机器人 Agent 成败的关键能力
跳出分数排名,这项研究更重要的学术价值在于指出:到底是什么底层能力,决定了一个基础大模型能否顺利跨入物理世界?
研究团队通过对多代际、多家族模型的横向消融与失败轨迹归因,提炼出物理智能体必须具备的四项核心支柱能力:
- 通用视觉理解(Visual Understanding):在真实阴影、反光材质和遮挡环境中,辨识物体朝向与状态变化,例如精准区分杯子是正放还是倒扣;
- 空间定位能力(Spatial Grounding):将二维图像像素准确锚定并投影为物理三维尺度的几何直觉;
- 几何编程能力(Geometry-guided Coding):面对多机位视角,能够自主编写几何算法与多视变换代码,通过三角测量解算出目标物体的空间坐标;
- 具身常识推理(Embodied Reasoning):理解刚体与柔性体形变、摩擦力、重心分布以及双臂防碰撞的物理直觉。
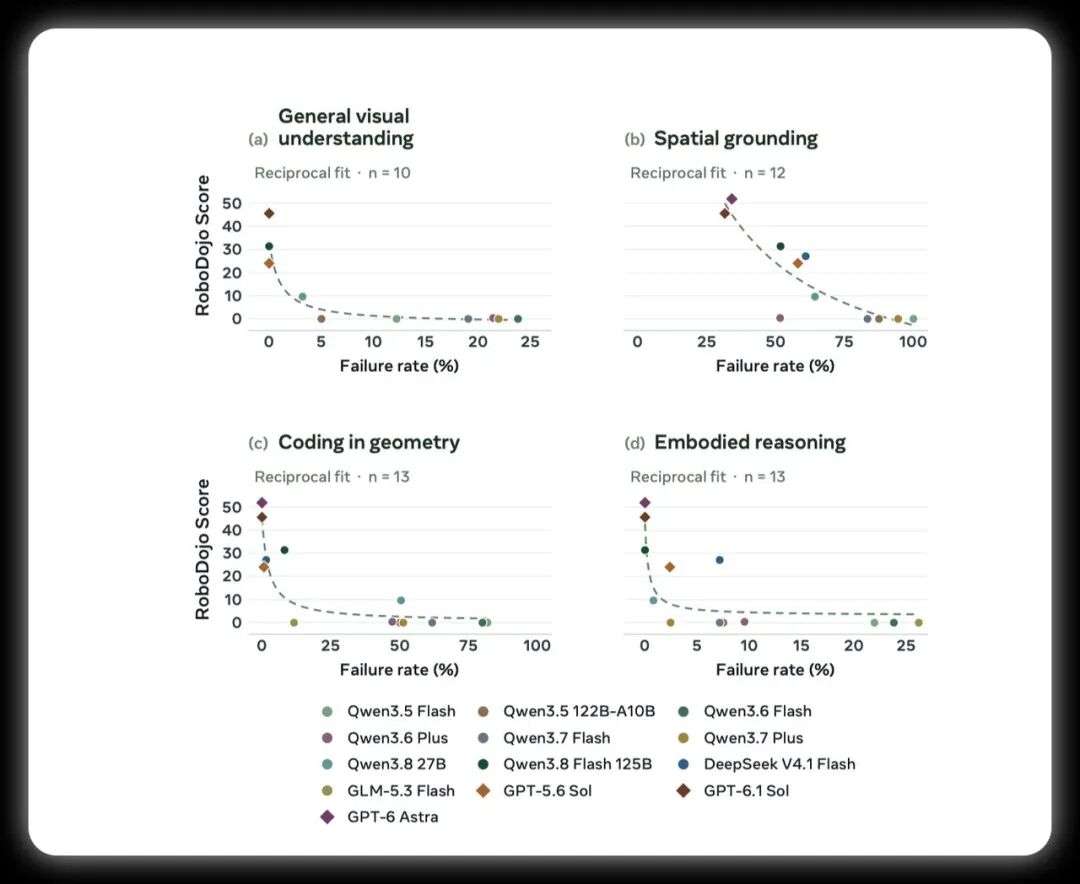
图注:四项关键能力与不同模型失败率之间的关系
这一能力归因揭示了一个反直觉的现象:模型参数规模与物理操作能力并不呈简单线性正相关。
论文实测中,较新的 Qwen3.8-27B 已经能稳定解出多项复杂操作,而参数量远大于它的早期模型 Qwen3.5-122B 以及 Qwen3.7 Plus,却在多项任务中连续失败。这就像把更大的发动机装进一台齿轮还没对齐的机器——推力再猛,方向不对也白搭。如果预训练阶段没有针对空间几何投影、视觉对齐以及可执行代码生成进行有效训练,单纯堆参数对机器人物理控制的帮助十分有限。
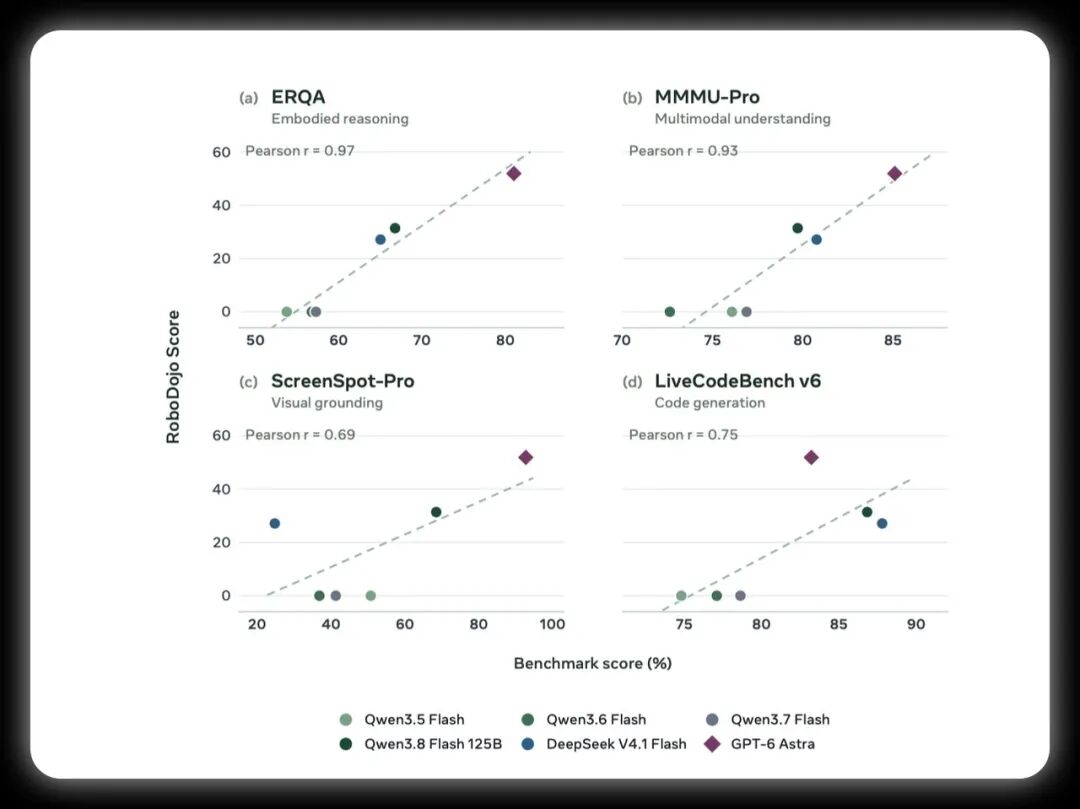
图注:通用模型能力评测与 RoboDojo 成绩之间的相关性
同时,论文把 RoboDojo 的成绩与主流通用大模型基准进行相关性比对后发现,具身成绩与 MMMU-Pro(高级多模态推理)、ERQA(具身问答)、ScreenSpot-Pro(细粒度视觉定位)以及 LiveCodeBench(复杂代码生成)呈现极高的正向绑定。
这一发现给具身智能的演进路径提供了一条关键启示:要让大模型学会精准使用机器人,未必只能一头扎进成本高昂、难以规模化的机械臂遥操数据泥潭里。持续强化通用模型的多模态空间理解、物理因果直觉与几何代码生成能力,同样是在为物理智能体注入最核心的控制中枢。
项目地址:https://github.com/Open-RUA/uni-robot-agent
 发表于 3 小时前
|
查看: 0|
回复: 0
 /1


