这两天,马斯克又开炮了。
起因是市场研究机构 Counterpoint 的一份预测:五年内,人形机器人对内存的需求将暴涨约 20 倍,到 2030 年,每台机器人要装 39GB 内存。
马斯克看完回了一句:「愚蠢的分析。」
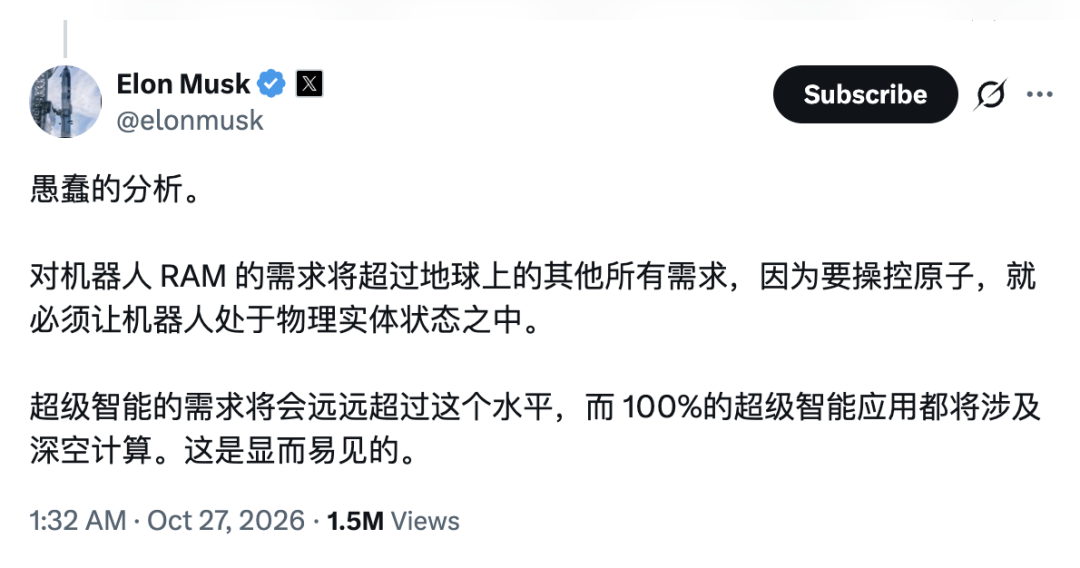
为什么?他嫌这个数字太小了。在他看来,机器人要在物理世界里「塑造原子」,未来它们吃掉的内存会超过地球上所有其他东西的总和。
市场也在用真金白银押注。10 月 28 日,人形机器人概念股盘中一度涨超 5%。同一天,有券商报告称 Optimus 已启动样机试产。
然而,一片热闹中,一个扎心的问题却显现出来——给了机器人这么大的 Memory,它们真的会「长记性」吗?
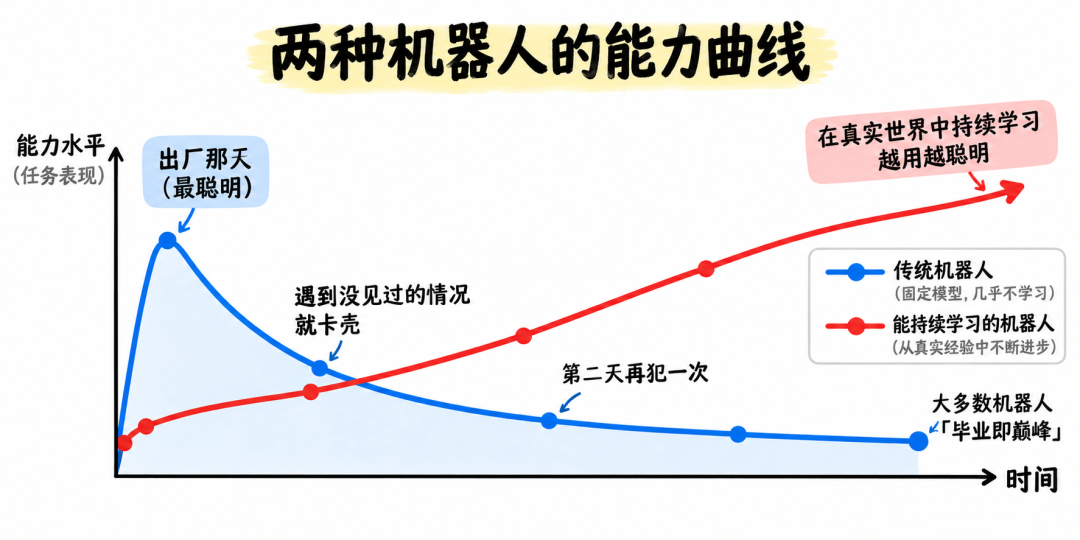
答案是,目前市面上大多数机器人,从来不会吃一堑长一智。它们一生中最聪明的一天,就是出厂那天。
它在实验室里「读完书」,带着一份训练好的模型走进工厂、商店、家庭。此后日复一日,遇到没见过的情况就卡壳——大多数机器人,都是「毕业即巅峰」。
正如智元在发布会上指出的,2026年具身智能的考题,已经不再是「会不会演示」,而是「能不能部署」。
10月29日,智元正式发布 GO-3 Preview,目的就是终结这个顽疾。
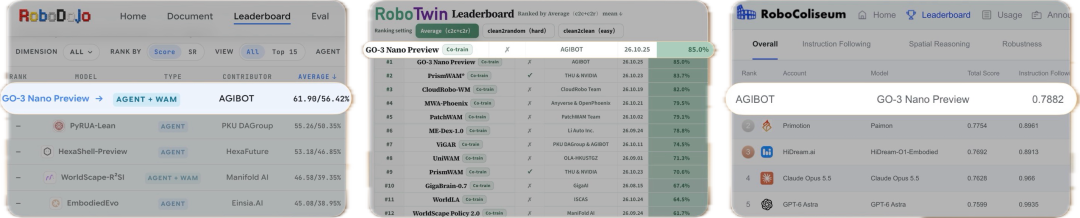
GO-3 Preview 是一款在预训练、后训练、部署后阶段,实现全链路 Scaling 的具身模型,一举拿下 RoboDojo、RoboTwin、RoboColiseum 等机器人榜单 Top 1。
预计到年底,GO-3 Preview 等将全面开源。
从此,机器人不再是训练完了才去上班,而是一边干活,一边变强。
从 GO-1 首创 ViLLA 架构,到 GO-2 首创「动作思维链」,再到今天的 GO-3,智元把「规模的力量」从训练阶段一路延伸到了真实作业现场。
结果是:机器人开箱即用数百种任务,部分高难度操作达到甚至超过人类水平,并在真实工作中持续积累经验、自我进化。
2026年的具身智能:所有人都在找自己的「Scaling Law」
大语言模型靠「堆数据、堆参数、堆算力」跑出了 ChatGPT。
面对数据枯竭的终局,大语言模型圈早开始自救。
既然人类写不出更多、更高质量的语料了,那就靠强化学习,靠自我博弈,靠测试时计算……
只要算力管够,智能好像可无限 Scaling,难以触及上限。
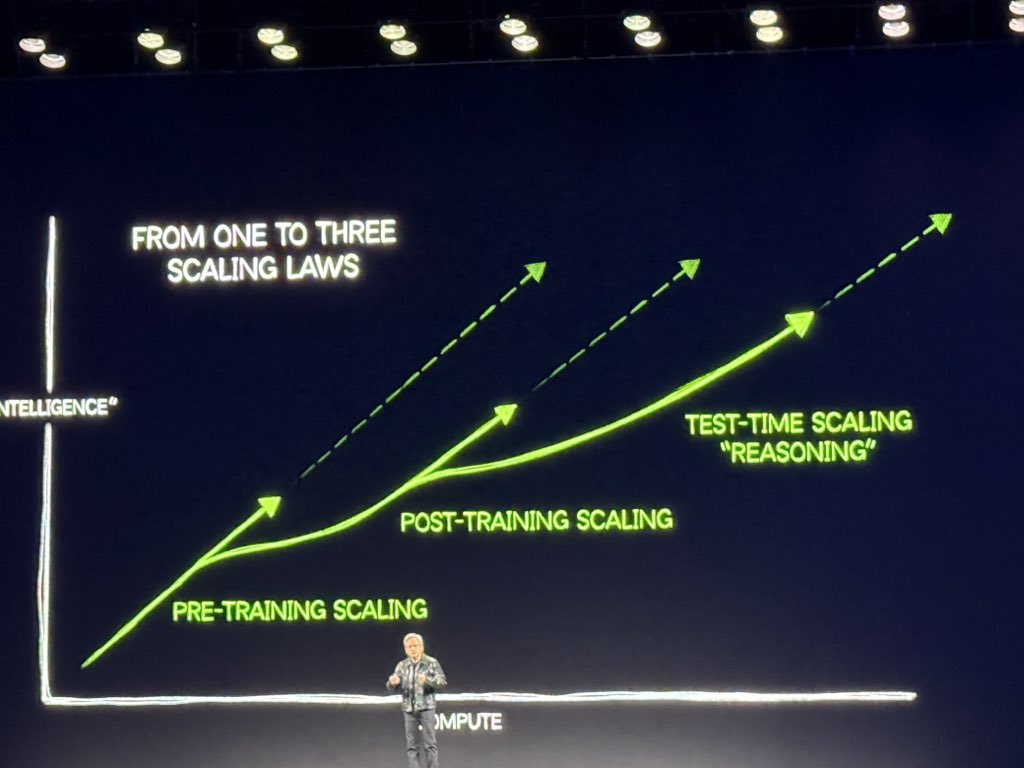
你看各种前沿的推理模型,你看各种 Agent Harness,语言模型开始自我进化,RSI 已初露头角,超级智能 ASI 指日可待。
具身智能模型也出现了对应的趋势:
而今年具身智能圈最焦虑的问题,正如 Physical Intelligence 联合创始人、UC Berkeley 教授 Sergey Levine 所言:
「关键不是 Scaling,而是找对该 Scaling 的东西。」
而 GO-3 Preview 选择全都要,把「预训练 Scaling、后训练 Scaling、部署后 Scaling」这三段路连成一整条路线。
特别是在 RoboDojo 这个机器人竞技场中,GO-3 Preview 力压 GPT-6 Astra 等通用大模型。
预训练 Scaling,让机器人「见多识广」
首先,就是要打牢地基,机器人极度需要可迁移的通用能力。
为什么?
因为现实世界充满变数。
如果机器人只在实验室里死记硬背了某几个杯子的抓取,一旦换到真实的便利店,遇到没见过的光照、背景或新包装,它就会立刻宕机。只有具备了跨场景、跨物体的通用能力,机器人才能真正走出实验室。
为了实现这种通用性,GO-3 的预训练围绕两个维度同时放大:数据和模型。
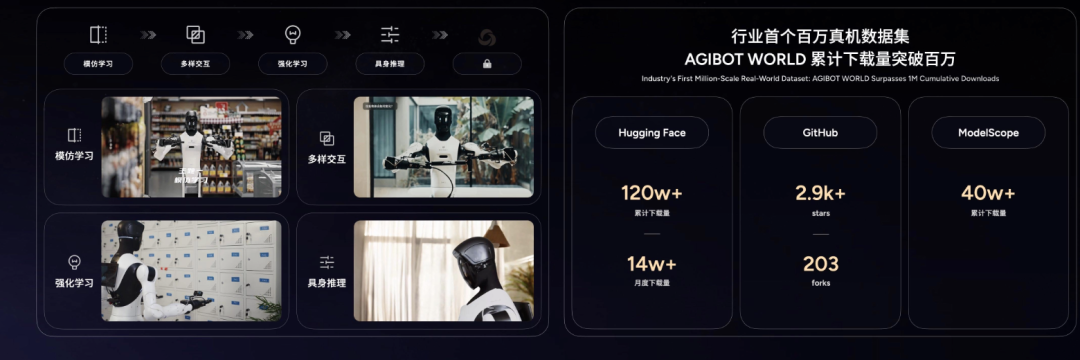
为了支撑这条路线、打破数据枯竭的瓶颈,智元构建了从数据到智能的端到端闭环,正式推出了行业首个系统性覆盖具身智能全域研究的百万量级真机数据集 AGIBOT WORLD 2026。
智元设计了专为预训练 Scaling 打造的具身原生架构 WRAM(World Reasoning Action Model)。
它最大的突破,是将「理解任务—预测未来—生成动作」这三件事,完美统一在了一条线上。
具体而言,WRAM 的底层逻辑靠三大核心机制支撑:
- 面向控制的视觉编码器 CoAE
- 单步视觉规划器 SVP
- 知识对齐的选择性优化 KASO
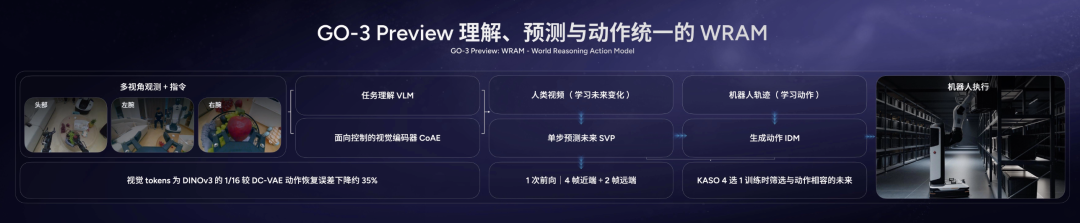
机器人不仅要「看到」物体,还要知道怎么「控制」。CoAE 能够提取面向控制的视觉表征,为未来预测与动作生成提供基础。
它能精准捕捉物体的位置、形态以及相互关系,从而将「看到的世界」与「机器人该如何行动」紧密联系起来。
SVP 可以「单步生成完整未来」,也就是说机器人学会了「三思而后行」。
SVP 会根据当前的观测和任务指令,一步到位地预测出接下来会发生的变化,随后动作生成模块再去学习如何从当前状态到达那个「预测状态」。
通过这种方式,海量的人类视频为机器人提供了「物理世界如何变化」的常识经验,而机器人的实际轨迹数据,则将这些变化与具体的动作死死绑定。
真实世界里,完成一个任务往往有多种做法(比如左手抓和右手抓),这就意味着同一场景存在多种合理的「未来」。
KASO 的作用,就是在训练中筛选出那些与真实动作更相容的候选结果进行联合学习,让未来预测与动作生成的训练目标更好地衔接,避免机器人的动作被多种可能性「平均」成四不像。
得益于 WRAM 的强大底座,预训练能力的爆发直接体现在了实战表现中:
面对海量新任务,GO-3 主打 Zero-shot(零样本泛化),没见过的场景、物体,无需微调开箱即用;面对更精细的活儿,它可以 Few-shot(少样本精细操作),只需看几次就能掌握。
比如微调后的 GO-3 能精准完成乐高零件的抓取、对位与插入。
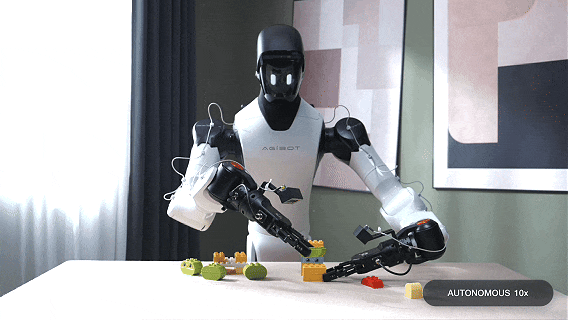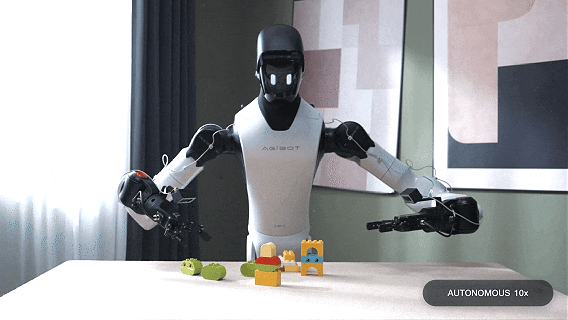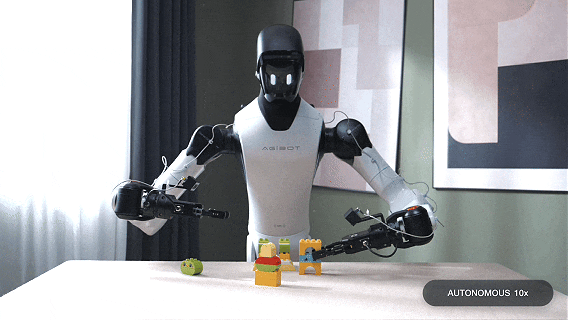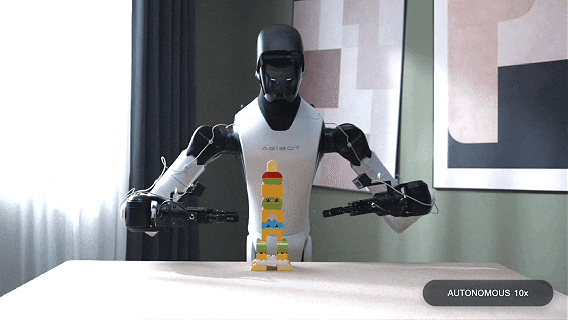
跨本体后,机器人同样能完成双手持物开门、跪地取物等高难度复杂动作。
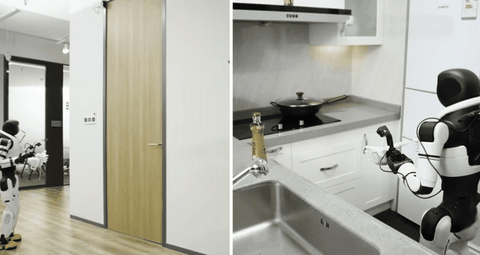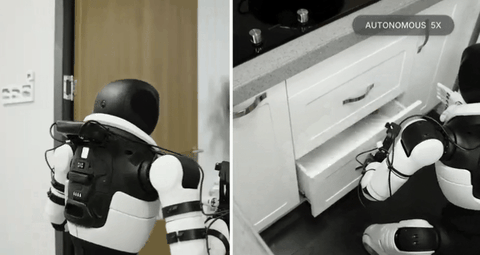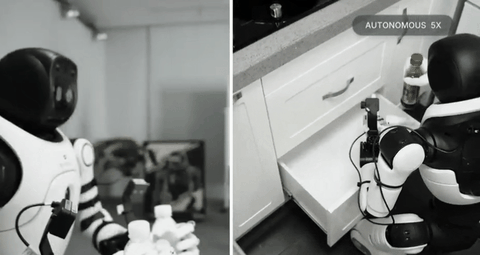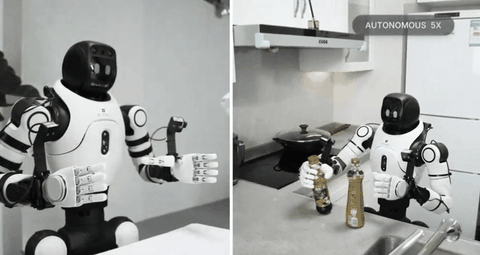
后训练 Scaling:基于 Genie Evolver 的「三引擎」试错与进化
读万卷书,还得行万里路。
预训练给了机器人常识,但很多精细的物理接触本领只能靠练。问题是:在纯物理世界里试错成本太高,而在传统的普通仿真里,又学不到真实的物理接触反馈。
智元交出的答卷,是其强大的后训练基础设施——Genie Evolver。
它彻底摒弃了单一环境的局限,构建了一条以「真机、物理仿真、世界模型」三大引擎为主线的后训练范式。
世界模型引擎负责提供「大脑里的想象力」,在云端推演出各种可能的动作分支和视觉动态,让机器人可以在脑内疯狂复盘「如果当时换个动作会怎样」。
物理仿真引擎弥补了世界模型在精密受力上的不足,提供高精度的刚体、柔体接触反馈,确保机器人的动作不仅「看起来对」,而且「力学上合理」。
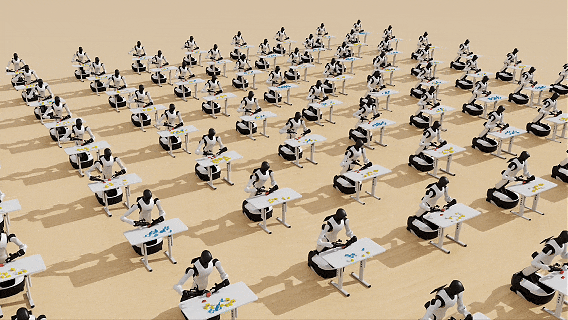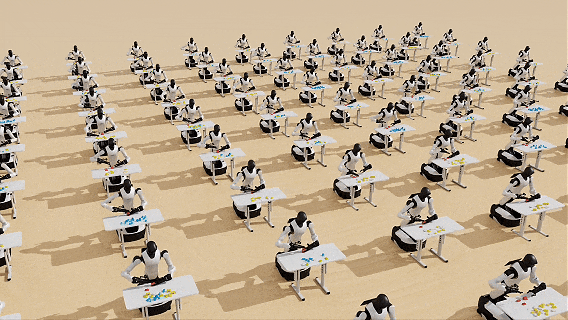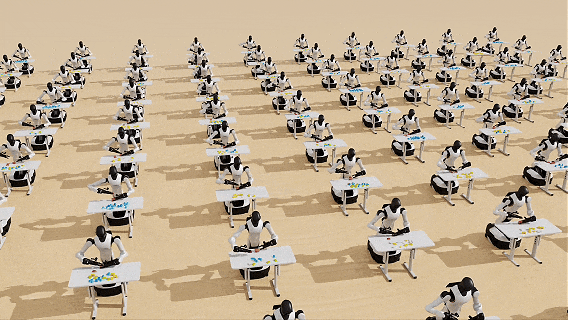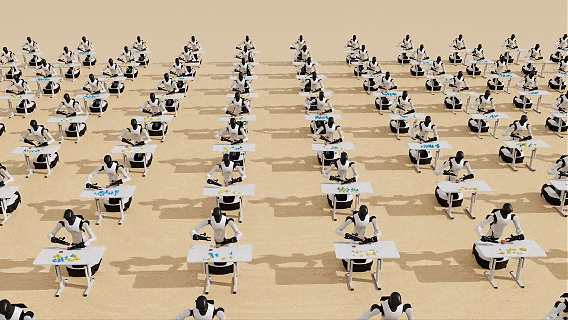
真机引擎作为最终的试金石,将真实世界中采集到的最新物理数据实时反哺给另外两个引擎,确保云端的练习永远与真实物理世界对齐。
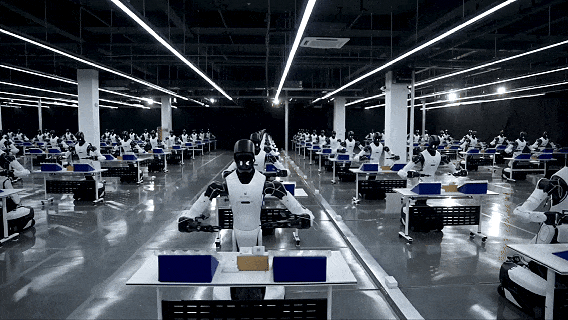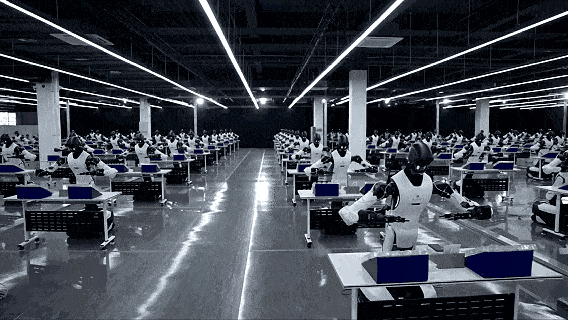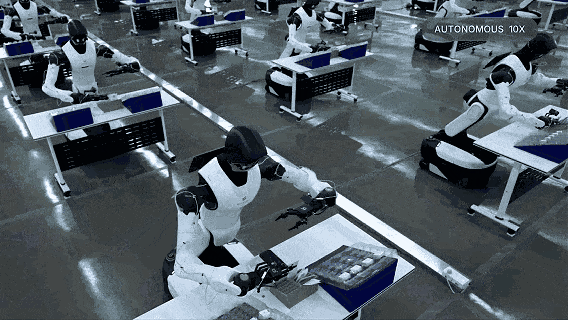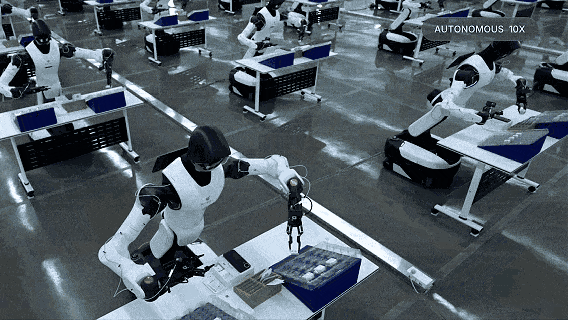
在算法底层上,智元引入了「失败引导的经验检索微调(FERT)」。
这套算法极其巧妙:当机器人在执行任务(如插线、组装)失败时,它不会去学习失败的动作,而是把失败前的情境作为「查询词」,去整个机群共享的「成功经验池」里检索出最相关的成功轨迹片段,并大幅调高这些片段的采样优先级来进行监督训练。
换句话说,成功的经验提供了「该模仿什么动作」,而失败的教训则决定了机器人当前需要「重点复习哪里」。
在插花、叠衣服、手机充电、凳子组装和手机包装五项真实任务测试中,FERT 在完全没有收集额外人类专家示范的情况下,将机器人的平均成功率从初始化的 81.0% 一举拉升到了惊人的 97.3%,平均故障率相对降低了 86.0%。
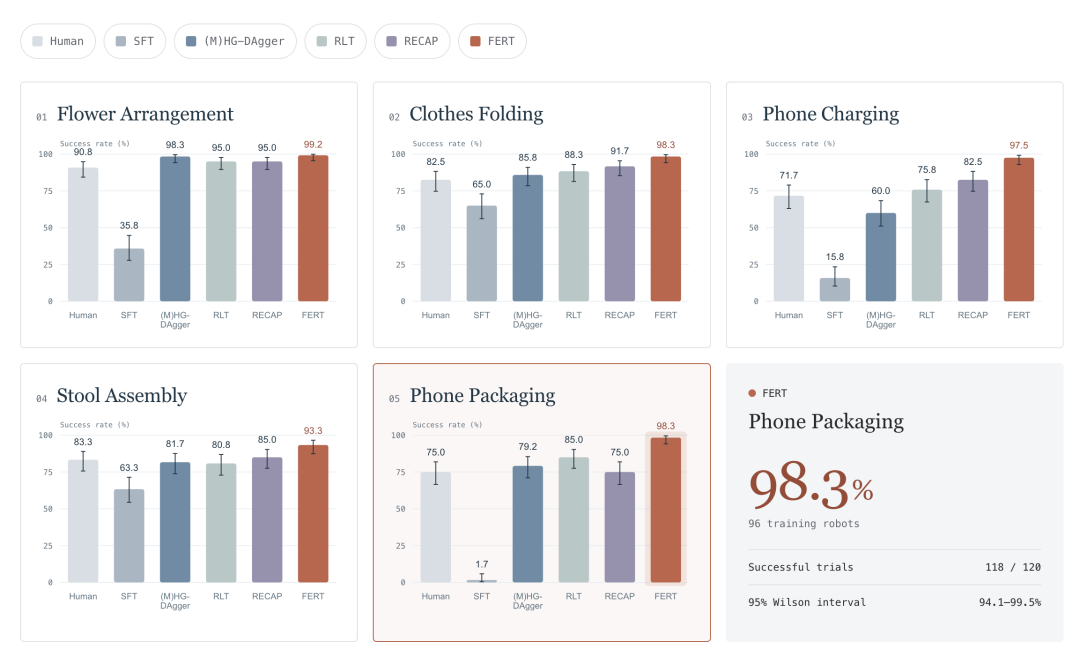
在这套群体经验学习(CEL)加持下,真机环境 Scaling 扩大了群体经验,让复杂任务的可靠性暴增,比如手机包装多阶段长流程任务失败次数大幅减少了 92%,叠衣服形态控制成功率从 85.8% 提升到了 98.3%。
世界模型环境 Scaling 则以回溯探索加速真机学习:
- 经验回溯树搜索:不浪费算力去重跑相同的开头,而是集中火力在关键分叉点探索。
- 树结构价值评估:不需要额外训练复杂的价值网络,直接对比同一个起点下不同分支的结局,就能给动作打分。
- 测试时物理对齐:为了防止机器人在世界模型里「越想越离谱」,系统会用机器人实操的最新真实数据,通过 LoRA + DMD 实时修正世界模型的物理动态。
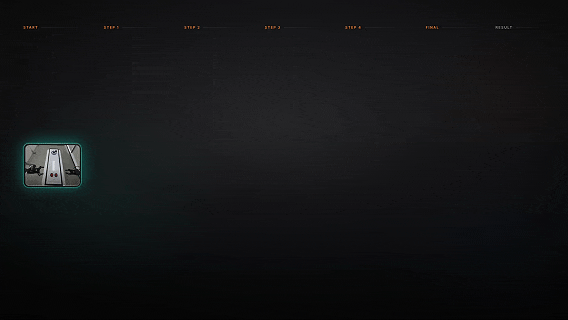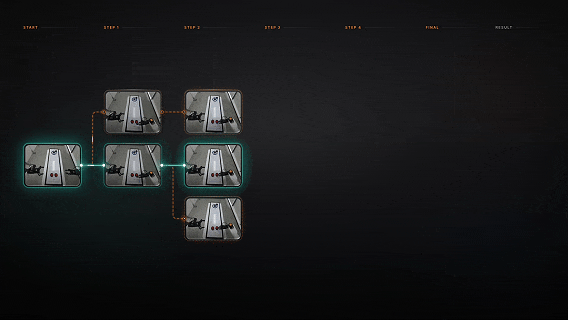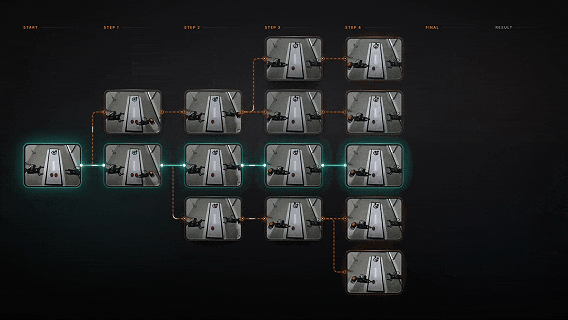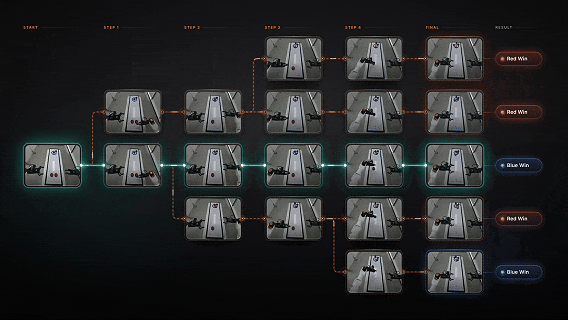
当机器人可以在部署中自主积累经验,同一套能力可复制时,边际成本将持续下降,这是具身智能走向规模化的关键前提。
在这三大引擎的交替协同下,机器人的练习规模不再受限于真机的数量。
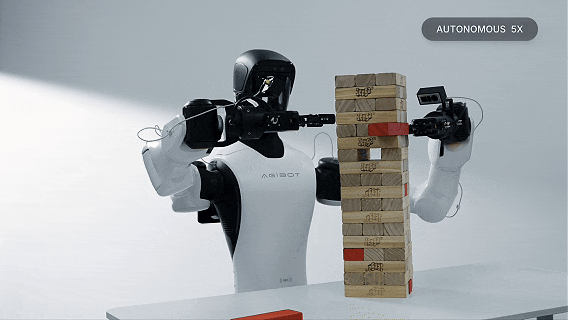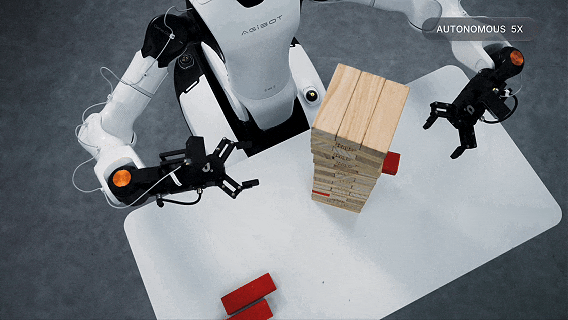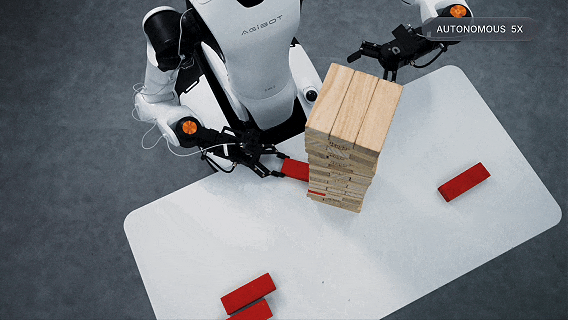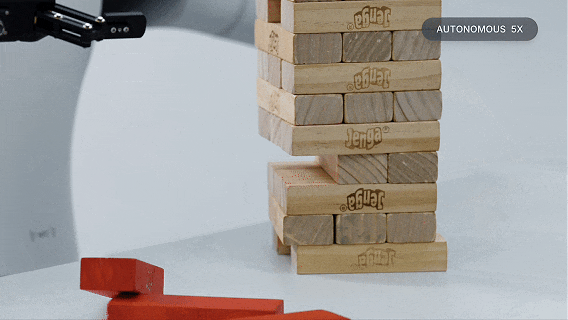
无论是需要精细受力反馈的「抽积木」,还是需要极强手感的「桌面冰壶」,机器人都能在 Genie Evolver 的加持下,以极低的成本练出极高的策略可靠性,甚至在桌面冰壶在线改进 4 小时首次超过人类平均水平,抽积木实现连续抽取 5 块并保持稳定。
部署后 Scaling,真正的「无人在环」持续自进化
如果说后训练是在上岗前的「特训」,那 GO-3 最与众不同的一段,就是打破「毕业即巅峰」的部署后 Scaling。
10 月 27 日,智元正式发布具身 Agent 框架 Genie Master。它解决了一个行业痛点:靠人工追在机器人后面改代码、采数据,落地只能小步慢跑;机器人必须学会在真实的业务场景中「边上岗,边解锁新技能」。
这是行业首次跳出仿真环境和实验室,在真实业务场景中跑通闭环,验证了 Physical RSI。
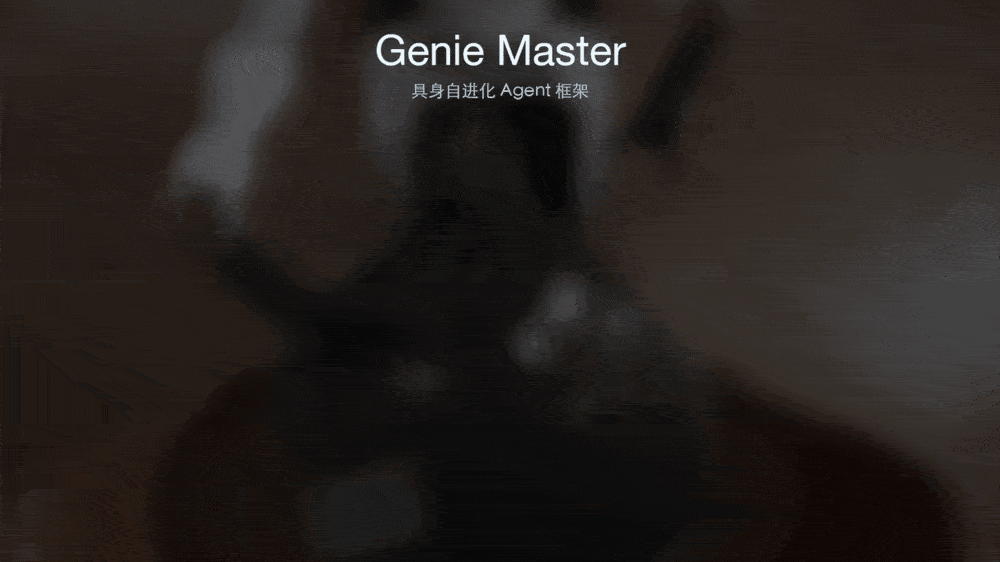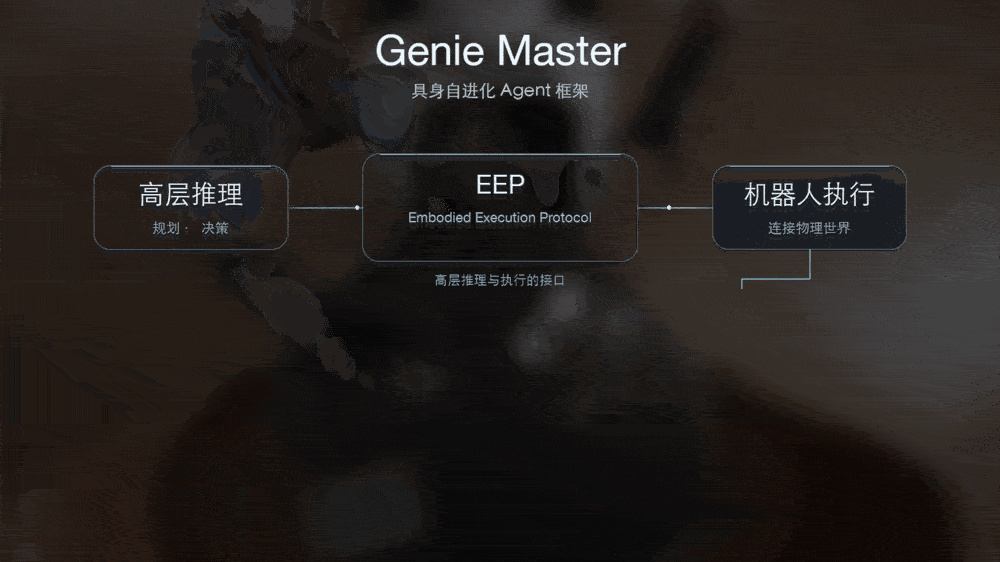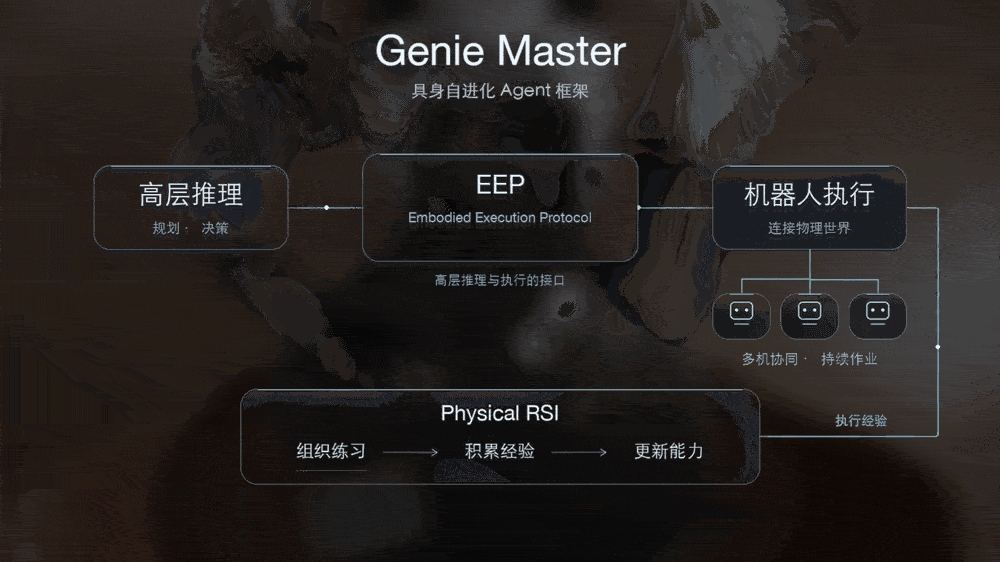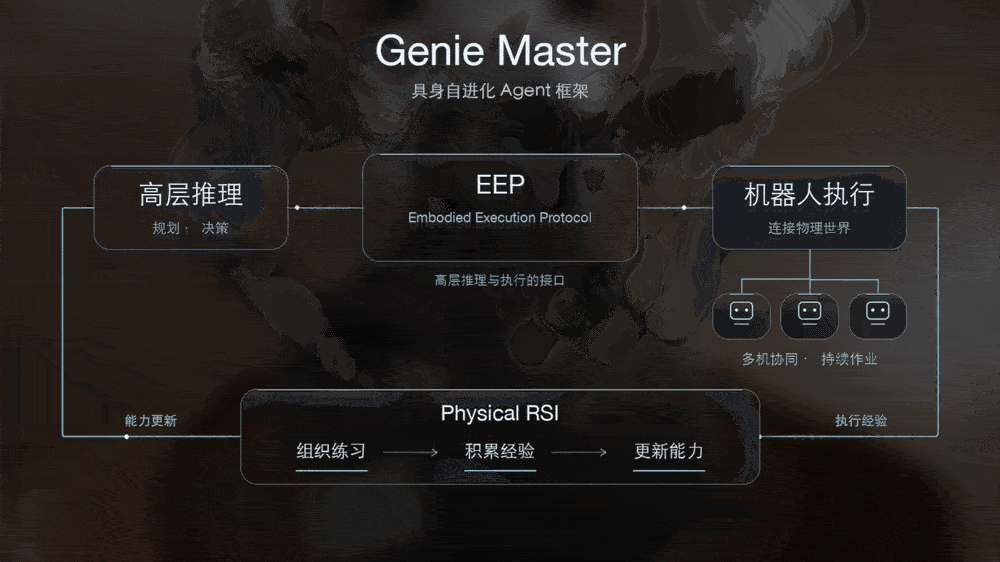
为了搭起从「发现问题」到「解决问题」的桥梁,Genie Master 设计了关键接口 EEP(具身执行协议)。
EEP 让 Agent 清楚地知道机器人能做什么、做得怎么样,将上层推理大脑和底层执行小脑彻底贯通。
在这个框架下,机器人通过两条互补的路线学会「吃一堑,长一智」。
1. Harness RSI(让经验可复用)
在真实便利店上岗时,最初机器人给货架挂钩挂商品成功率很低。Agent 回溯失败记录后,定位到了原因:头部相机分辨率不足,且被标签牌遮挡。Agent 随即规划新策略——左手先靠近,用腕部相机补充近距离视角,确认位置后再由右手挂货。
这种无需人工干预的「随做随记」,将失败教训沉淀为了长期的 Prompt 和记忆规则。
2. Policy RSI(让能力学进参数)
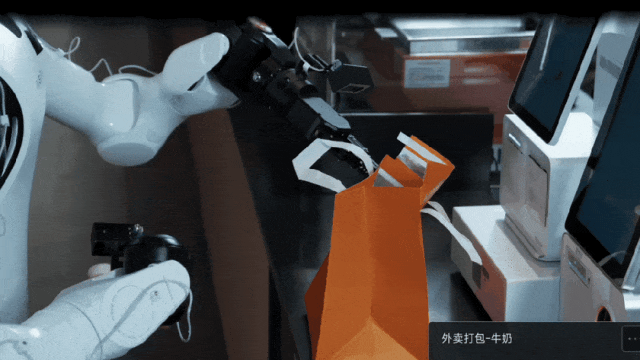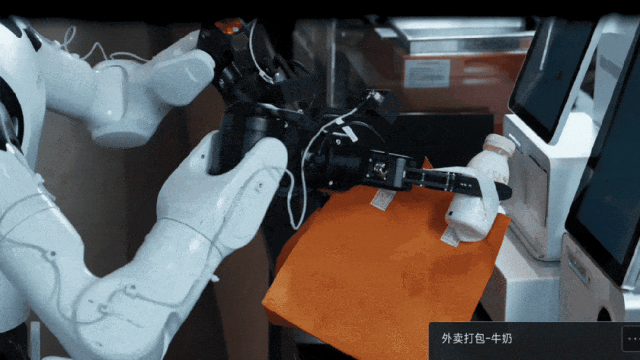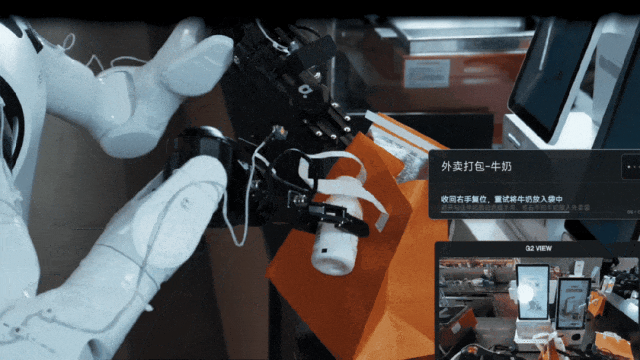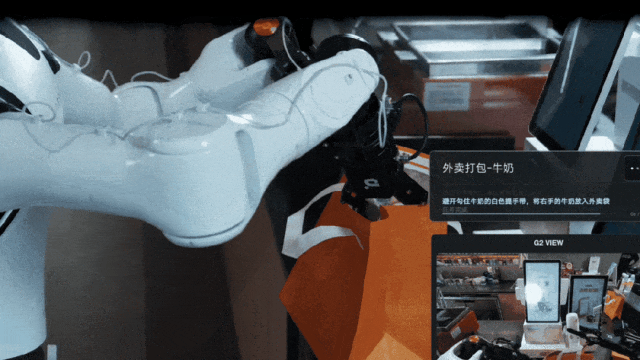
打包外卖时,机器人的夹爪容易被白色的塑料提带缠住。Agent 会引导夹爪先收回、再重新尝试。这些真实的异常接管和恢复数据,经过后处理后,直接流回底层的动作策略进行训练。
这意味着,这种纠错不再仅仅是停留在表层的提示,而是实打实地固化成了模型权重的肌肉记忆。
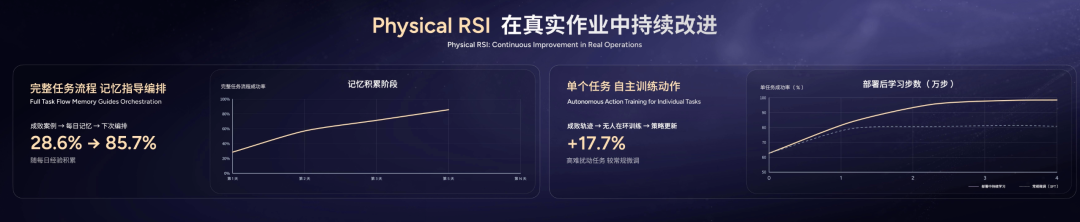
得益于 Physical RSI 的持续改进,部署后的真实作业经验得以复用。在完整任务流程中,得益于记忆指导编排,成功率从初期的 28.6% 大幅提升到了 85.7%;同时无人在环训练更新策略下,单任务的成功率也获得了 17.7% 的提升。
11 月 2 日,智元将开启一场 24 小时便利店直播,6 台 G2 机器人将连续上岗接受「转正考核」,在无人在环的状态下,检验其抗压、应变和持续进化的真实水平。
GO-3 Preview 对行业意味着什么?
把行业内几家代表性玩家摆在一起,差异一目了然:
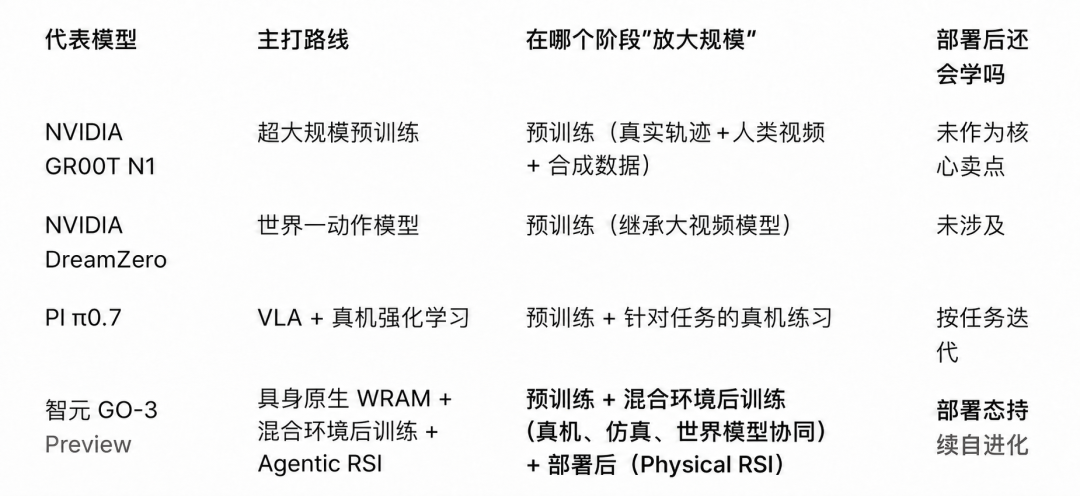
从这张表里,能读出 GO-3 的三层行业意义。
第一,它把「Scaling」从一个点拉成了一条线。
别人在某一段上做到极致,GO-3 把三段打通。能力不再只取决于出厂前喂了多少数据,而是取决于整条链路(从预训练到 Rollback 脑内复盘,再到真实场景里的 Physical RSI)转得多快。
第二,它给世界模型找到了更轻、更能落地的实战形态。
结合 Rollback 的回溯机制,世界模型不再是单纯的「播放器」,而是真正参与策略迭代的「模拟推演引擎」。
第三,它把「数据」的定义改写了。
过去,具身智能最贵的是高质量遥操作示范。而在智元的体系里,人类视频、失败轨迹、世界模型的推演结果、甚至便利店里打翻的一个水瓶,统统都是数据。
最天然、最源源不断的数据源,正是部署后的真实作业。
对国内而言,这一点尤其关键。中国拥有全球最丰富的制造、物流、零售场景,机器人上岗越多,回流的经验就越多,模型进化就越快。谁先跑通「部署—学习—再部署」的飞轮,谁就握住了下一阶段的主动权。
机器人的「终身学习」时代
智元通过 GO-3 Preview(预训练)、Genie Evolver(后训练)、Genie Master(部署后) 的生态协同,把三段彻底打通:
- 预训练建立跨场景的通用能力底座;
- 后训练通过「真机、物理仿真、世界模型」三个引擎的大规模试错,大幅提高策略可靠性;
- 部署后则通过 Agent 框架在无人在环的真实作业中,持续积累和复用经验。
能力不再只取决于出厂前喂了多少数据,而是取决于整条链路转得多快。过去,具身智能最贵的是高质量遥操作示范;而现在,人类视频、世界模型的推演结果、甚至便利店里打翻的一个水瓶,统统都是进化的养料。
从 GO-1、GO-2,到今天的全链路规模化学习,智元提出了一个足够清晰、也足够大胆的判断——
机器人能力的提升,不该只发生在训练阶段,也应该发生在每一场真实作业里。
人类从来不是在毕业那天停止成长的。从今天起,机器人也不必了。
这也是云栈社区持续跟进具身智能领域技术演进的原因:当机器人开始把每一次真实作业都当作训练机会,硬件、模型、数据之间的壁垒将不断松动,整个行业的迭代逻辑都会因此改写。接下来的年底开源,或许就是这场变革加速的节点。
 发表于 昨天 22:12
|
查看: 4|
回复: 0
 /1


