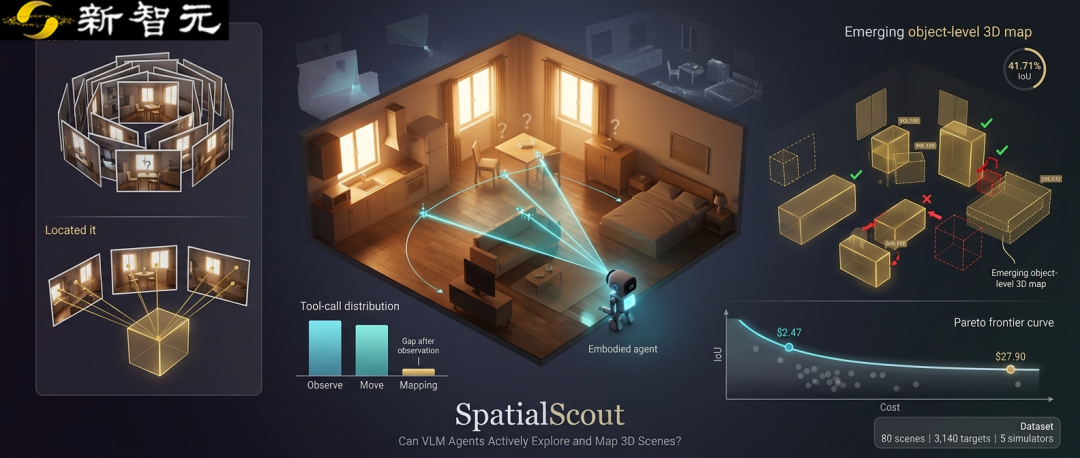
想象一项任务:把相机交给 AI,让它进入一间从未见过的虚拟房间。没有预先给定的物体坐标,也没有替它安排好的参观路线。它需要自己决定朝哪里转、向哪里移动、何时再拍一张图,并最终说清楚各个目标物体在三维空间中的位置。
论文链接: https://arxiv.org/abs/2610.26659
代码链接: https://github.com/JesseZZZZZ/SpatialScout
数据集链接: https://huggingface.co/datasets/jessezhaoxizhang/SpatialScout
SpatialScout 把这样的探索过程变成了可以记录、评分和比较的研究任务。每一次观察是否有用、不同视角能否相互印证、提交的坐标是否可靠,都会在最后的物体级地图中留下痕迹。
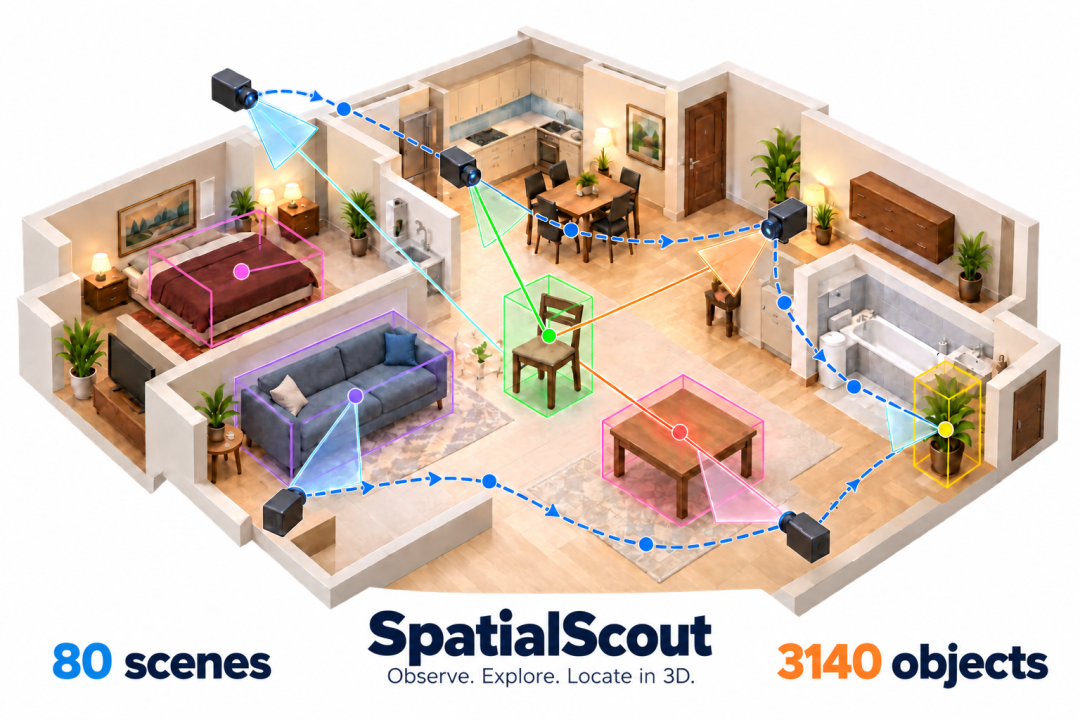
让模型亲自选择下一次观察:从 RGB图像 出发,通过相机控制与几何工具估计物体中心。探索策略和空间推断被放在同一个交互闭环里考察。
走向物理AI,先要建立空间把握
人走进屋子,四处看一看、绕上一圈,通常就能对整体布局形成连贯的认识:桌子靠近哪面墙,椅子在桌子的哪一侧,转过身以后刚才的物体还在什么方向。这样的三维空间表征,让接近、绕行、伸手拿取等动作有了依据。
物理AI同样需要这层基础。智能体要在真实环境里持续行动,就必须把零散的视觉线索组织成稳定的空间关系。连基本位置和布局都难以通过观察确定,后续的行动规划、物体操作与环境交互也就缺少可靠的参照。SpatialScout 关注的主动空间理解能力,正是迈向物理AI的一块基石。
给主动空间理解搭一个共同考场
正式评测选取80个室内场景、3,140个目标实例,来自 iTHOR、RoboTHOR、ArchitecTHOR、ReplicaCAD 和 ProcTHOR。房间类型既有厨房、客厅、卧室、浴室,也有公寓和多房间住宅。固定的场景与初始相机设置,让不同模型面对一致的任务条件。
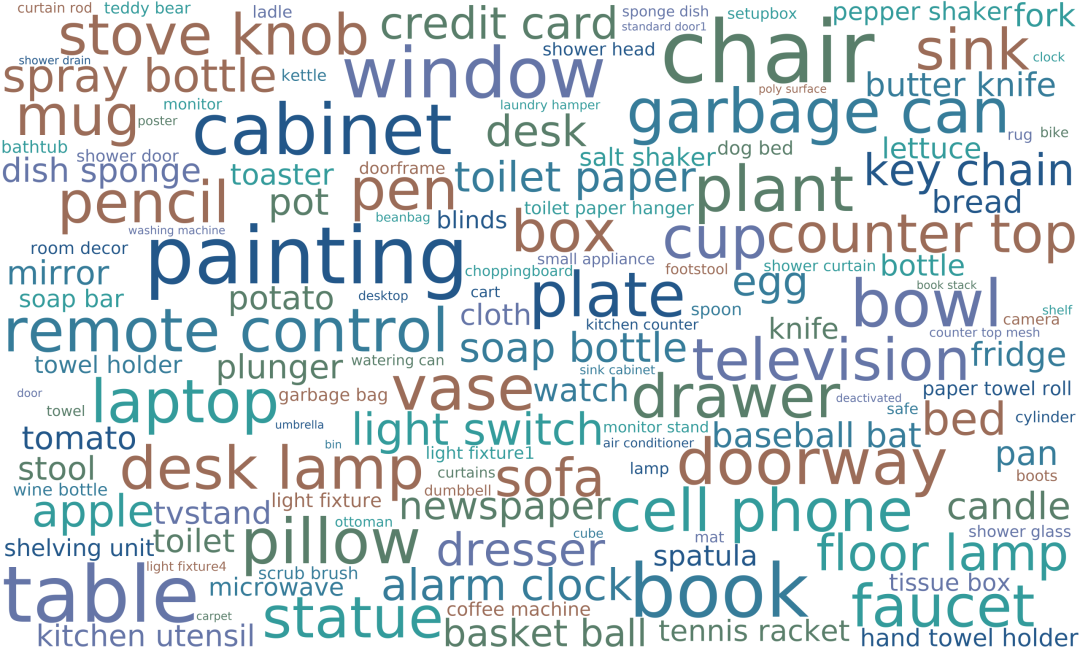
图2 数据集物体类别词云。此图按完整90场景目录的3,440个实例统计,经归一化规则汇总为143类;正式结果采用其中的80场景评测协议。
椅子、桌子、橱柜、书本、灯具和日常用品共同构成了这些环境。物体的尺度、摆放位置和可见程度各不相同,模型需要不断调整视角,在局部细节与房间整体布局之间建立联系。
把一张张图像变成可交付坐标
每个任务开始时,模型会拿到目标实体清单与初始图像。实体库告诉它需要寻找哪些对象,但不透露坐标。模型可以主动拍摄、移动相机、读取相机内参与位姿,并将多视角中的对应观测交给三角测量工具;确认位置后,可随时分批提交并继续修正。每个任务最多进行100轮模型交互。
评分同时关注「找得全不全」和「放得准不准」:全部目标与已提交目标各有四项指标——平均 IoU,以及 IoU 超过 0%、50%、90% 的比例。未提交目标在全部物体指标中记为零。IoU 使用平移至预测中心的原有渲染几何包围盒计算,重点衡量中心定位与目标覆盖。
当前模型表现:一张仍待完善的空间地图
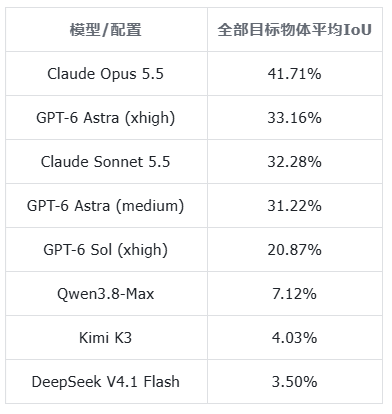
表1 基于正常执行 finish_mapping 结束的轨迹,按任务求平均(macro)。
当前7个模型、8种配置的比较中,Opus 5.5 的任务平均 IoU 为 41.71%,Astra(xhigh)为 33.16%,Sonnet 5.5 为 32.28%。最高得分仍然留下了明显的提升空间,也让观察决策与空间推断中的薄弱环节更值得研究。
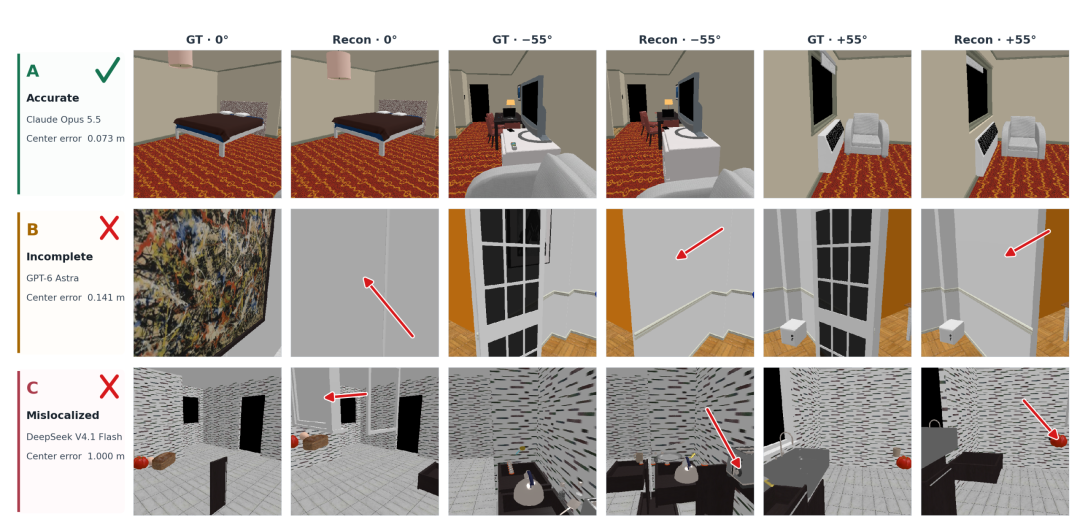
图3 从准确布局到物体缺失、位置偏移,重建画面直观呈现了不同的成功与失败形式。
问题可能出在「观察之后」
看过一个物体,并不意味着已经确定了它的空间位置。如果各次观察之间缺少稳定的对应,图像数量的增加就可能只带来更多局部印象。模型还需要辨认同一物体在不同视角中的同一位置,并选择能够提供有效视差的拍摄点,才能建立可靠的几何约束。
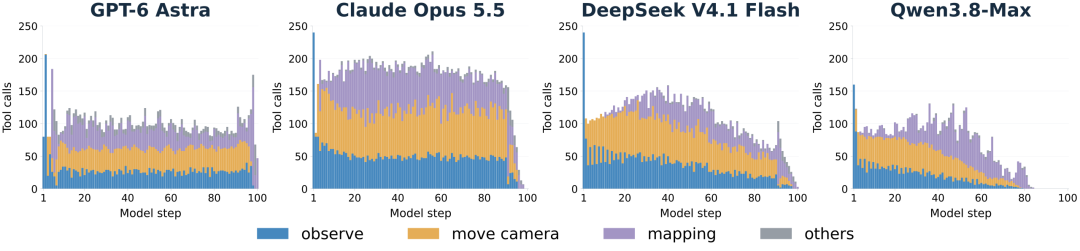
图4 探索过程中不同类型工具的调用分布,展示了观察、相机移动与建图操作之间的调度差异。
观察投入与建图计算需要真正衔接
工具调用分布展示出一个值得关注的现象:部分模型在探索中反复观察、频繁移动相机,后续的 mapping 操作却没有充分跟上。它们可能收集了不少图像,却未能有效组织跨视角信息,用几何计算把「看见了」落实为「定位到了」。
三角测量尤其考验精细化空间感知。输入需要来自不同拍摄位置的对应图像点;物体中心标记偏移、遮挡和视差不足,都可能影响估计。在这一环节,观察是否精准、计算是否及时、结果是否经过核对,比单纯增加拍摄次数更值得关注。
几何测量能否支持最终提交
在共同的80个任务上,Astra 最终提交的物体中,99.33% 此前获得过成功三角测量支持;DeepSeek 为 63.48%。这一差异为「观察怎样转化为定位证据」提供了可分析的切入口。
这些轨迹线索支持一个改进方向:提升跨视角对应的精度,并加强观察、计算与提交之间的协同。工具次数本身不能直接测量观测质量,上述分析属于描述性证据。图中 mapping 还包含位置提交与结束建图,不应解释为纯计算量;后期柱高下降也会受任务结束影响。
把失败拆开,才能找到下一步
SpatialScout 的作用还在于让过程变得可追踪:缺失的物体可能指向覆盖不足,偏移的布局可能指向坐标推断不稳,而大量观察后的低分则提示需要检查视觉对应与几何工具使用。研究者可以沿着这些线索,设计更有针对性的探索策略。
地图质量要和探索代价一起看
持续拍摄、长上下文推理和多轮工具交互都会消耗资源。SpatialScout 将重建 IoU 与每任务平均费用放在同一张图中,用 Pareto 前沿帮助观察不同预算下的质量选择。
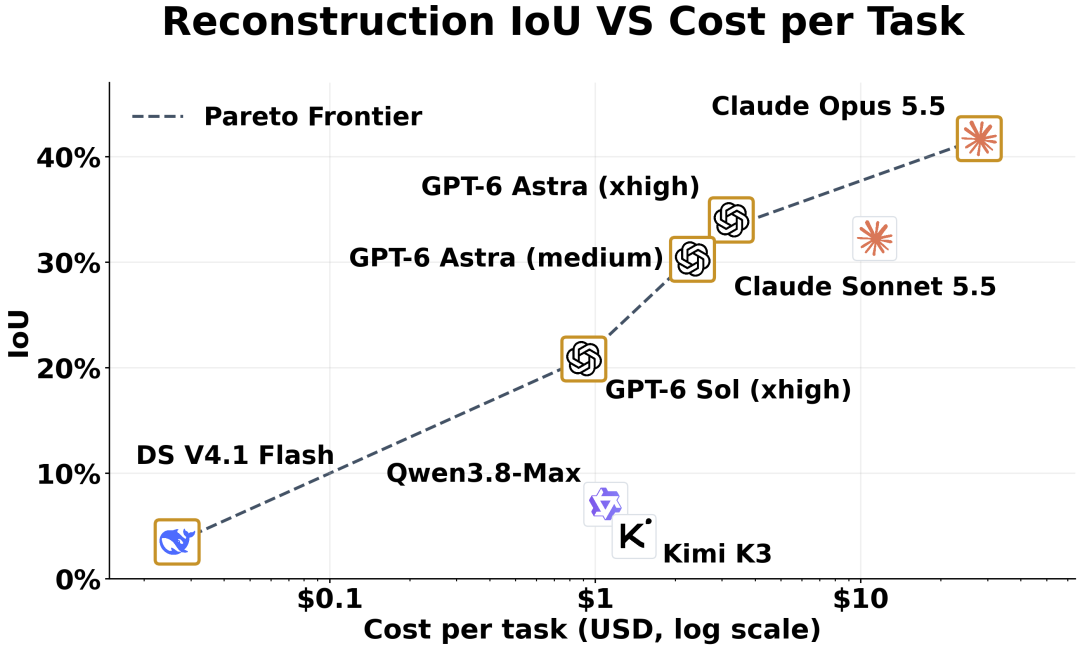
图5 模型的质量—费用分布。平均费用以美元计,横轴使用对数刻度,虚线连接 Pareto 前沿配置。
按当前保存的价格与 token 记录估算,Astra(medium)平均约 2.47 美元/任务,Astra(xhigh)约 3.06 美元/任务;Opus 5.5 约为 27.90 美元/任务。DeepSeek V4.1 Flash 的均值约为 0.027 美元/任务,其对应的定位得分也较低。这组结果让探索策略的质量收益与资源投入能够被同时讨论。
费用使用 OpenRouter 固定价格快照,并仅对 token 记录完整的任务求均值。Cost 图中的 IoU 为按物体汇总的 micro 指标,前文表格为逐任务平均的 macro 指标;费用是价格快照下的估算,不代表实际账单。Astra medium 延续先前 IoU 与新运行费用均值的既定统计口径。
让下一次观察更有价值
从选择一个新视角,到确认一组空间坐标,再到形成可用的物体级地图,主动空间理解需要一整条能力链。SpatialScout 提供固定任务、交互工具与评分流程,方便研究者接入自己的模型,把新的视角规划、多视角推理和几何工具策略放到同一个环境里比较。
这个基准能帮助更多研究把注意力放到真实行动所需的空间基础上:让智能体知道自己在哪里、对象在哪里,并据此决定接下来该怎样观察与行动。
参考资料:https://arxiv.org/abs/2610.26659
 发表于 4 小时前
|
查看: 12|
回复: 0
 /1


