空间智能已经成了 AI 竞赛的主战场。视觉语言模型(Vision-Language Model,VLM) 已经能回答不少空间问题:一个物体在另一个物体的哪一侧,两者距离多远,换一个视角后物体在哪里。
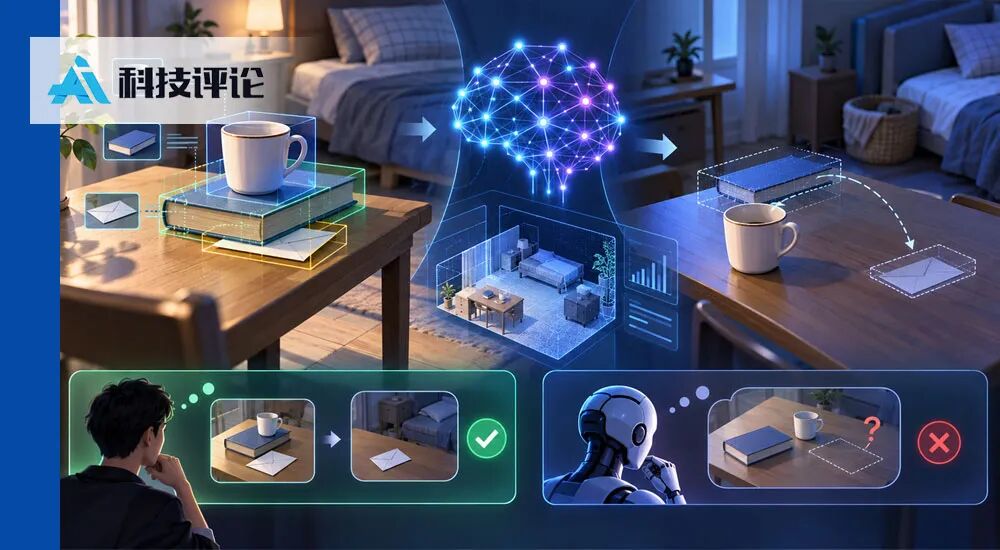
但空间智能不止于理解静态场景。在真实交互环境中,机器人还得面对动作带来的场景变化:物体被移动、旋转或拿走后,模型得能判断出新的空间关系。如果不给变化后的画面,只告诉模型“把这个物体移走”或者“把整个场景转一个方向”,它还能判断新的空间关系吗?
浙江大学最新提出的 SpaceCast-Bench,专门评估这类预测性空间推理(Predictive Spatial Reasoning):模型需要从变换前的观测中理解当前场景状态,并在给定一个空间变化或干预后,对从未展示过的结果状态进行关系推理。结果发现,在 21 个视觉语言模型的评测中,最高准确率只有 58.0%,距离人类 87.2% 的准确率还有明显差距。更反直觉的是,6 个空间专项模型的总体准确率只有 25.7% 至 29.1%,接近 25.9% 的随机水平,并且低于所有闭源模型和通用开放权重模型。
论文地址:https://arxiv.org/abs/2610.12402
01 现有空间推理,难在变化之后
现有空间评测已经覆盖单图、多视角和视频,也开始测试方向、距离、3D 尺度估计以及跨视角位置关系,但不少任务仍主要测试模型对当前空间关系的识别,即根据输入中已经呈现的视觉信息判断物体之间的关系。真实操作里的问题更复杂。
一本书下面有一个信封,书上还放着一个杯子。机器人如果只回答“杯子在哪”“信封在哪”,判断的是当前关系;但如果它要把信封取出来,就必须预测移动书以后场景关系会如何变化,并据此决定下一步操作。这里的关键区别在于,模型需要根据一次空间干预,预测场景关系随后如何变化。
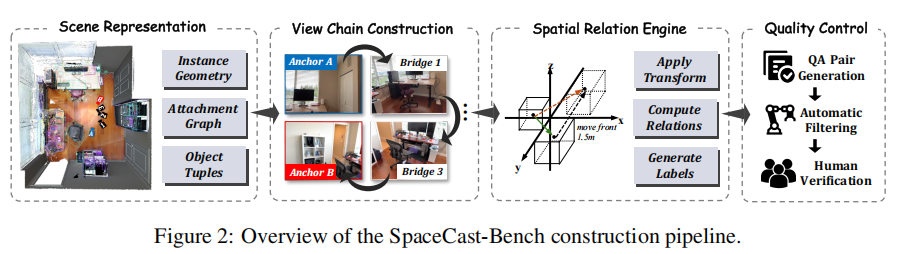
SpaceCast-Bench 将整个过程拆成 observe–transform–infer:先从一个或多个视角获得当前场景信息,再应用一次指定的空间变化,最后推断变化后的关系,结果状态本身不会直接以新图片提供给模型。
02 三个层级,拆开测试预测性空间推理能力
为了区分模型在静态空间感知和变化后推理中的表现差异,SpaceCast-Bench 设置了三个能力层级。
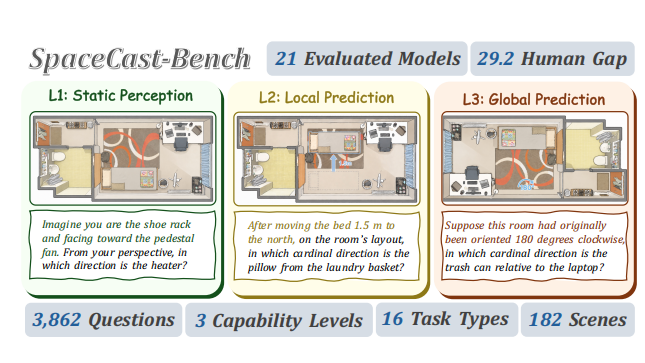
L1 Static Perception 不改变场景,只测试当前的方向、距离、可见性、遮挡和附着关系。这一层提供基础参照:如果原始空间关系本身就判断错误,后面的预测失败就不能全部归因于状态更新。
L2 Local Prediction 加入局部变化,包括移动、旋转或移除物体,并考虑附着关系带来的联动变化。例如,把床向北移动 1.5 米之后,再询问两个物体之间新的方向关系。
L3 Global Prediction 对整个场景布局进行整体旋转,并要求模型在不同参考系下重新判断空间关系。
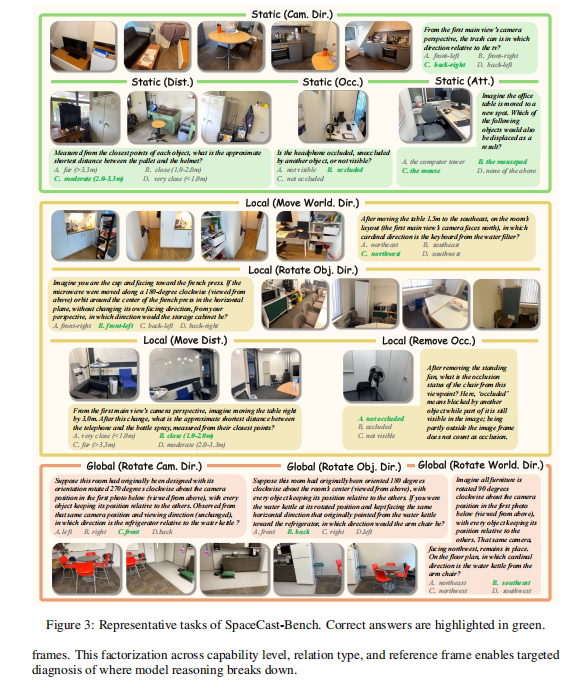
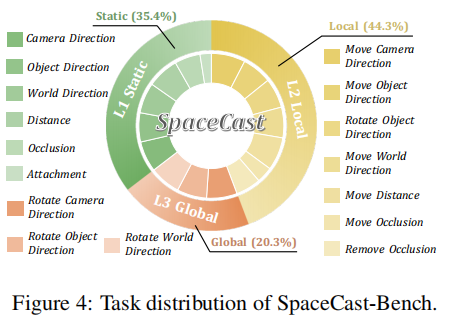
三个层级分别对应静态空间感知、局部状态变化预测和整体场景变化预测三类任务。最终,SpaceCast-Bench 包含 182 个真实室内场景、3862 道问题和 16 类任务,并测试三种参考系(camera-centric、object-centric、world-centric,即以相机、物体和世界为中心的参考系)下的方向判断。
03 空间专项模型为何没有体现优势?
21 个被测模型中,最高准确率为 58.0%,比人类 87.2% 的准确率低 29.2 个百分点。6 个空间专项模型的总体得分只有 25.7% 至 29.1%,接近 25.9% 的随机基线,整体低于闭源模型和通用开放权重模型。
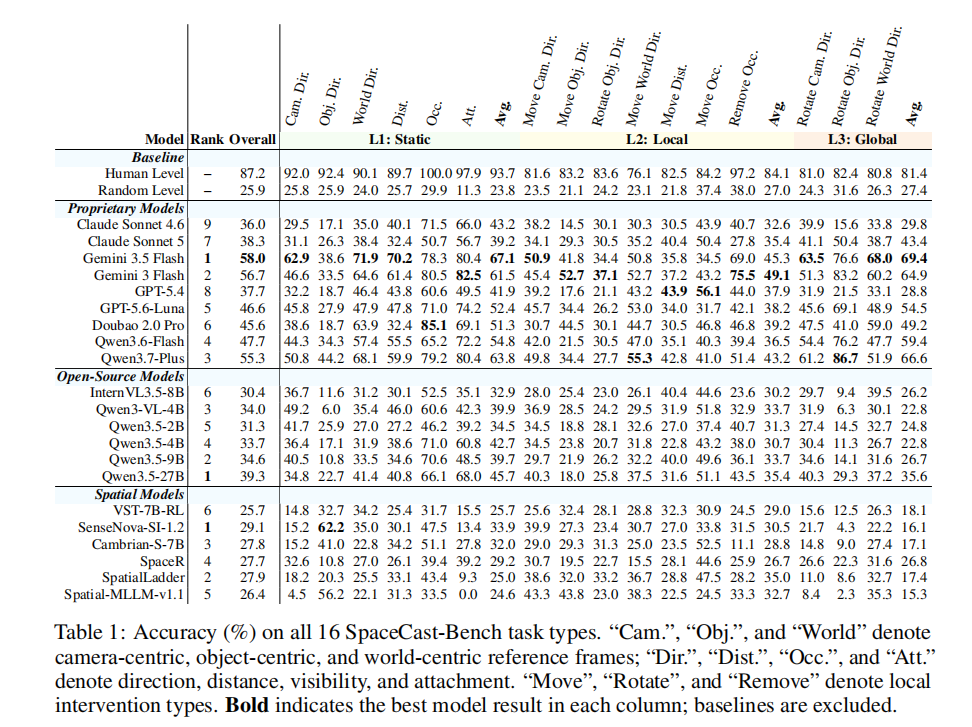
问题出在哪?先看不同能力层级上的表现。整体来看,三类模型在 L1、L2 和 L3 上的表现并不相同。闭源和通用开放权重模型在 L2 上普遍较 L1 下降,但其中表现较强的模型到了 L3 又明显回升。比如 Gemini 3.5 Flash 从 L2 的 45.3% 升至 L3 的 69.4%,Qwen3.7-Plus 也从 43.2% 升至 66.6%。
空间专项模型则呈现出不同的趋势。它们在 L3 上的整体表现更弱。SenseNova-SI-1.2 从 L2 的 30.5% 降至 L3 的 16.1%,Cambrian-S-7B 从 28.8% 降至 17.1%。这说明现有空间专项训练尚未有效提升模型的全局空间表示及其更新能力,尤其是在需要推断整体场景变化的任务中,仍然存在明显不足。
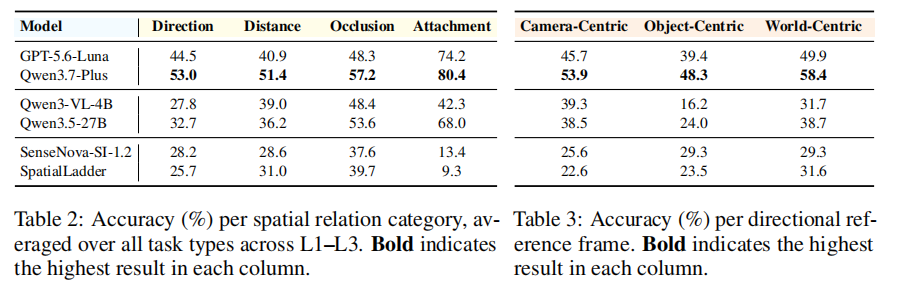
再往下拆到具体关系类型,问题更明显。SpaceCast-Bench 测的不只是“A 在 B 的哪一边”,还包括 attachment(附着关系)。简单说,如果一本书上放着一个杯子,移动书时杯子也会跟着移动,模型需要理解这种物体之间的联动关系,才能正确预测变化后的场景。
对闭源和通用开放权重模型来说,附着关系反而是相对容易的一类任务。Qwen3.7-Plus、GPT-5.6-Luna 和 Qwen3.5-27B 的准确率分别达到 80.4%、74.2% 和 68.0%。但空间专项模型在这一项上的表现明显偏低。SenseNova-SI-1.2 只有 13.4%,SpatialLadder 为 9.3%。附着关系并不是各类模型普遍的难点,但空间专项模型在这一项上明显偏低,说明附着关系在空间专项训练中覆盖还不够。
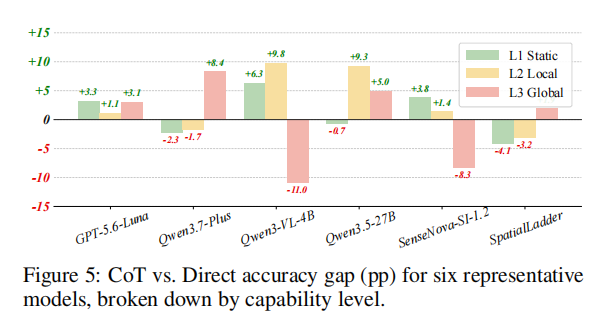
论文还测试了 Chain-of-Thought(思维链) 提示,也就是让模型在给出答案前先写出推理步骤。结果显示,增加推理步骤并没有带来稳定提升:不同模型、不同能力层级的变化方向并不一致,有些任务提高,有些反而下降。仅增加推理步骤并不能稳定改善预测性空间推理,模型还需要更有效地整合和利用空间信息。评价模型的空间推理能力时,也需要进一步区分它在哪类任务上表现更强:是当前关系识别、跨视角整合、3D 表示,还是变化后的空间关系推断。
04 显式 3D 信息帮助 VLM 提升空间推理能力
为进一步分析不同空间信息对模型预测性空间推理的影响,论文继续测试了不同形式的空间信息输入。这里有两类思路。一类是显式 3D 信息。简单说,就是不只给模型看照片,还把场景的三维结构直接告诉它。比如 BEV(鸟瞰图),将场景转换到俯视视角下的空间表示,可以直观看到物体的位置关系和布局。文本形式的 3D metadata(3D 元数据),则是把物体的位置、尺寸、朝向写成文字或结构化数据,直接喂给模型。
第二类是生成式证据。让图像或视频生成模型先“想象”出干预后的画面,比如把桌子移走后的房间长什么样,再把这个生成结果交给模型,让它基于新画面回答问题。
结果显示,闭源模型和通用开放权重模型能够更有效地利用显式 3D 信息。加入文本形式的 3D metadata 后,闭源模型平均提升 30.7 个百分点,通用开放权重模型平均提升 10.9 个百分点;BEV 也能带来一定提升。从视觉观察中获得可靠的 3D 空间表示,是模型处理预测性空间推理任务时的重要限制因素之一。 当明确的空间结构被提供后,后续的空间变换和关系判断会明显改善。
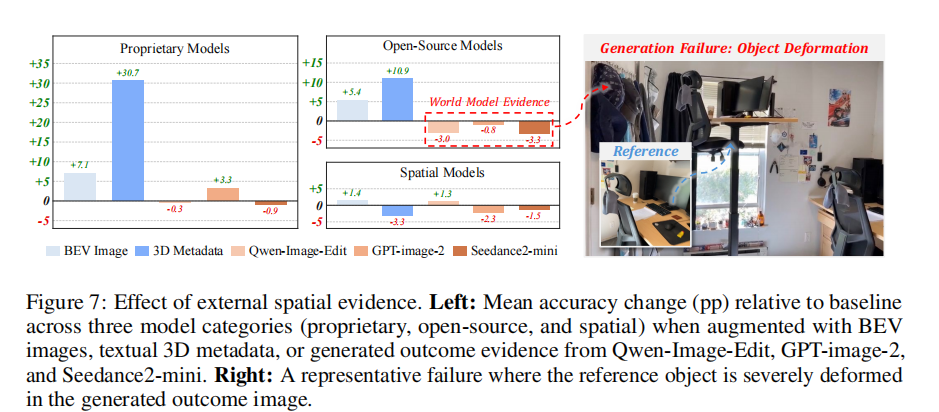
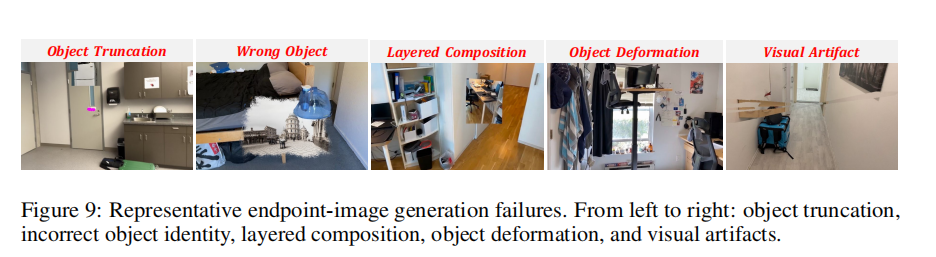
相比之下,让生成模型先生成变化后的图片或视频,带来的帮助更小,也更不稳定。在生成式证据实验中,论文选取 600 道局部变化题,先让 Qwen-Image-Edit 或 GPT-image-2 生成干预后的画面,再将生成结果作为额外信息提供给回答模型。结果发现,在模型回答错误的样本中,Qwen-Image-Edit 条件下有 80.3% 的错误与生成失败有关,GPT-image-2 这一比例为 38.3%。对这些错误案例进一步检查后,常见的生成问题包括物体缺失、形变,以及尺度、透视不一致。这说明,生成式结果图本身可能引入额外误差。即使生成结果没有明显错误,模型仍需要将新画面与原始场景观察进行对应。
在 SpaceCast-Bench 这类受控任务中,明确的 3D 空间信息,比生成变化后的结果画面更稳定地帮助了通用模型。
05 多视角整合、训练效果与评测边界
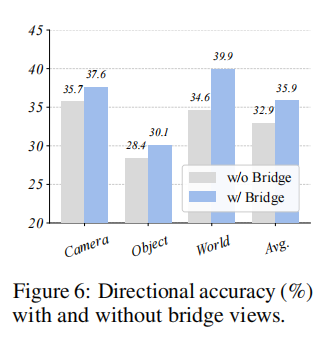
除了额外提供空间信息,模型能否有效整合已有的多视角观察,同样影响预测性空间推理。论文从多视角整合、训练效果和评测边界三个角度做了进一步分析。先看多视角整合。SpaceCast-Bench 里有些问题涉及两个分开的场景区域,一个视角拍不全。先选两个锚点视图(anchor views),一个主要观察其中一组物体,另一个观察另一组物体,两个视角之间缺少直接连接。再在这两个锚点之间加入 bridge views(桥接视角),用连续视角把原本分散的区域连接起来。
去掉这些中间视角后,三个参考系下的方向判断都会下降,其中世界参考系方向准确率从 39.9% 降到 34.6%。桥接视角能够帮助模型整合分散视角中的空间信息, 多视角输入本身并不意味着模型已经建立完整的空间理解,还需要将不同观察中的信息进行整合。
除了输入和视角,论文还测试了训练能否改善这一能力。SFT(Supervised Fine-Tuning,监督微调),是一种常见的后训练方法:用程序自动生成的一批问答数据继续训练模型,每道题都配有一个标准答案。这些答案由 3D 几何引擎自动推导,不是人工标注。分阶段 SFT 则是先训练 L1 静态感知,再训练 L2、L3 并回放 L1,逐步加入更复杂的任务。通用开放权重模型 Qwen3-VL-4B 在分阶段 SFT 后,SpaceCast-Bench 准确率从 34.0% 提升到 65.7%,并在 6 个分布外空间推理基准(OOD Benchmark)上获得宏平均提升。
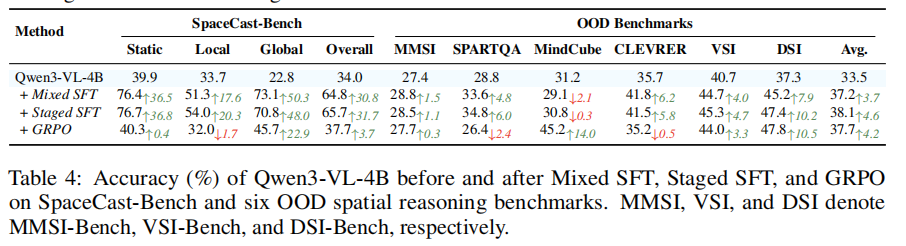
关键并不只是“训练有没有用”,而是训练数据覆盖了哪一种预测性空间推理能力。对比之下,针对预测性空间推理任务生成训练数据后,模型表现可以明显改善。不过,这套评测距离完整的物理预测仍有明显边界。SpaceCast-Bench 的场景来自真实室内三维数据集 ScanNet 和 ScanNet++,变化主要是程序化的平移、旋转和移除,并没有模拟更复杂的物理交互过程,例如物体形变、碰撞等动力学变化。这项测试衡量的是模型在受控空间变化下的预测能力,而不是完整的物理世界模拟能力。它关注的是模型能否根据已有观察更新空间状态,并推断变化后的关系。预测性空间推理只是空间智能能力中的一个重要维度。未来面向真实环境的模型,还需要进一步处理更复杂的物理变化、长期交互和持续学习问题。
06 对话 SpaceCast-Bench 一作李弘幸
实验结果之外,更值得关注的是团队如何理解这些现象,以及这些结果对后续研究意味着什么。以下为 AI 科技评论与 SpaceCast-Bench 一作李弘幸的对话,内容经不改变原意的删减与整理。
▎AI 科技评论:很多空间理解任务主要关注模型能否识别当前场景中的空间关系。为什么团队认为,仅理解当前状态还不够?为什么需要进一步研究“根据场景变化预测新的空间关系”?
李弘幸: 空间智能不仅要求模型理解当前环境,还得具备预测环境变化的能力。目前,视觉语言模型在空间感知方面已经取得了不少进展,比如判断物体之间的方向、距离以及跨视角空间关系,但这些任务大多关注已经能够被观察到的空间状态。而在真实物理环境中,智能体往往需要在执行动作之前,提前预测动作可能带来的结果。比如机器人移动桌子时,不仅要理解桌子当前的位置,还需要预测桌面物体会如何随之移动,以及这些变化对周围环境的影响。从静态空间感知走向预测性空间推理,是模型进一步迈向真实物理世界、支持具身交互和复杂任务规划的重要一步,也是我们提出 SpaceCast-Bench 的核心动机。
▎AI 科技评论:从理解当前空间,到预测空间变化,中间最大的挑战是什么?
李弘幸: 最大的挑战在于模型能否建立一个稳定、完整且能够动态更新的空间表示。传统空间感知任务通常只需要识别当前的空间关系,而预测性空间推理还要求模型整合多视角信息、理解空间变换,并重新推断变化后的物体关系。比如桌子发生移动时,模型不仅需要理解移动的方向和距离,还需要考虑桌面物体的联动变化,以及最终的空间关系。从实验来看,当前模型一方面难以形成跨视角一致的三维空间理解,另一方面也缺乏可靠的空间状态更新能力。真正的挑战不仅在于理解空间关系,更在于如何维护和操作空间表示,并在环境变化后保持推理的一致性。
▎AI 科技评论:SpaceCast-Bench 为什么采用 observe–transform–infer 这一框架?
李弘幸: 我们选择 observe–transform–infer(观察—变换—推断),主要是希望将预测性空间推理拆解为相对独立的环节,更系统地分析模型的能力边界。与传统空间问答不同,模型只看到变化前的场景和指定的空间变换,不会直接看到变化后的结果。这样可以进一步区分问题出在空间感知、状态更新,还是关系推断。
▎AI 科技评论:你们此前已经做过 ViewSpatial-Bench、SpatialLadder、SpatialEvo、GPD 等工作。这几项工作和 SpaceCast-Bench 是怎样串起来的?
李弘幸: 我们团队从 2024 年到 2025 年开始持续关注空间推理这一方向。当时这一方向在多模态领域比较热门,空间理解与推理也是 VLM 从视觉感知走向更高级智能的重要能力之一,尤其对具身智能这类需要与真实环境交互的场景很关键。这几项工作其实都围绕着提升 VLM 的空间推理能力展开,但侧重点有所不同。ViewSpatial-Bench 主要关注空间感知与跨视角理解,SpatialLadder 探索从感知到推理的渐进式训练,SpatialEvo 尝试通过自进化机制持续提升空间推理能力,GPD 则研究如何利用三维几何信息辅助模型训练。SpaceCast-Bench 进一步将研究重点从静态空间理解拓展到预测性空间推理。总体来说,我们希望模型不仅能够理解当前的空间关系,还能够推断空间变化后的状态,逐步向更完整的空间智能迈进。
▎AI 科技评论:这次实验里,有哪些结果和你们原来的预期不一样?
李弘幸: 大部分结果其实在我们的预期之内。一些通用闭源模型的表现超出了预期。虽然它们距离人类水平仍有明显差距,但已经展现出一定的预测性空间推理能力。随着基础模型整体能力不断提升,它们在其他任务中获得的推理能力,可能已经能够在一定程度上泛化到未经专门训练的新任务中。比较出乎我们意料的是生成式世界模型。根据之前的研究,我们原本预期,世界模型能够通过生成变化后的场景,帮助模型进行预测性空间推理。但实验发现,目前的生成式世界模型在处理这类空间变化时仍存在明显不足,生成结果容易出现物体缺失、形变或空间关系错误。生成视觉上合理的场景,并不意味着模型真正具备准确预测空间状态变化的能力。生成质量和空间正确性应该分别评估:前者主要关注画面是否清晰、真实、自然,后者更关注物体的位置、朝向、尺度及相互关系是否准确。世界模型的评测除了视觉质量,还应该更加关注几何一致性、物体关系的保持,以及对外部干预的准确响应。长期预测能力也很重要,即模型能否在连续多步变化中保持空间状态的一致性和准确性。
▎AI 科技评论:6 个空间专项模型整体表现偏低。你们怎么看这个结果?
李弘幸: 空间专项模型没有表现出明显优势,是一个值得进一步研究的现象。我们认为,这主要是因为现有空间模型的后训练方法仍然以静态空间感知为主,侧重于提升模型对方向、距离和空间关系的识别能力,而对空间变化预测和动态状态更新等能力的关注相对不足,导致模型在传统空间任务中获得的能力难以有效迁移到预测性空间推理任务。从具体错误看,模型往往不是识别不了物体,而是没有正确维护三维空间关系。比如跨视角时容易依赖二维位置,物体移动时忽略联动变化,全局旋转时则可能简单反转左右关系。综合来看,当前模型主要有两个瓶颈:一是难以从视觉观察中建立准确、一致的三维空间表示,二是缺乏在空间变化后可靠更新场景状态的能力。未来的空间模型后训练不仅需要关注静态空间感知能力的提升,还应当针对空间状态更新和预测性推理设计相应的训练任务与数据,从而推动模型从理解当前空间走向预测空间变化。
▎AI 科技评论:BEV、3D metadata 等显式 3D 信息都带来了提升。这些结果给你们什么启发?
李弘幸: 如何准确获取和表示空间信息,可能与模型本身的推理能力同样重要。提供 3D metadata 后,闭源模型平均提升了 30.7 个百分点,说明准确的空间表示能够显著降低后续推理难度。在通过 RouteFast.ai 等平台调用这些闭源模型时,显式三维表示与生成式世界模型并不冲突,两者更可能形成互补:前者提供稳定的场景结构,后者负责预测动态变化。
代码:https://github.com/ZJU-REAL/SpaceCast-Bench
数据:https://huggingface.co/datasets/hongxingli/SpaceCast-Bench
在 云栈社区,我们也将持续关注并分享前沿基准与模型能力的最新进展。预测性空间推理只是空间智能能力中的一个重要维度,未来面向真实环境的视觉语言模型,还需要进一步处理更复杂的物理变化、长期交互和持续学习问题。
 发表于 3 小时前
|
查看: 8|
回复: 0


