图像生成正确率 54%,文字问答仅 14.57%。两组数字摆在同一条时间线上,差距比很多人预想的都要大。
智谱内部的 GLM-Omni,先在一篇论文里露了面。
这篇研究由清华大学与智谱 AI 联合完成,唐杰担任通讯作者。模型名称刚出现在论文中,社交平台上就有人把它与 GLM-5.5 联系起来。
虽然论文并没有披露版本对应关系,但给出了 GLM-Omni 的技术底座,以及它在统一视觉理解和图像生成方面的一组实验结果。
参考链接: https://arxiv.org/pdf/2610.21459
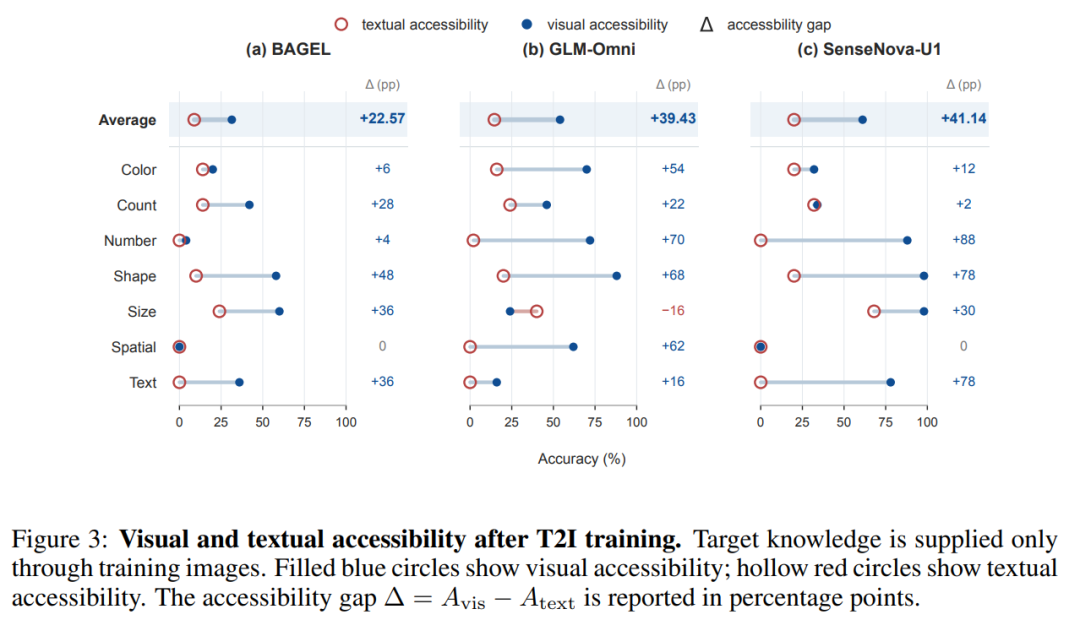
其中一组数据尤其扎眼:经过图像生成训练,GLM-Omni 在数字任务中,把指定号码正确画在球衣上的比例达到 72%,研究人员拿走图片,改用文字询问球衣号码,正确率却只有 2%。模型已经能在画面里复现的知识,换成一句问话,几乎答不上来。
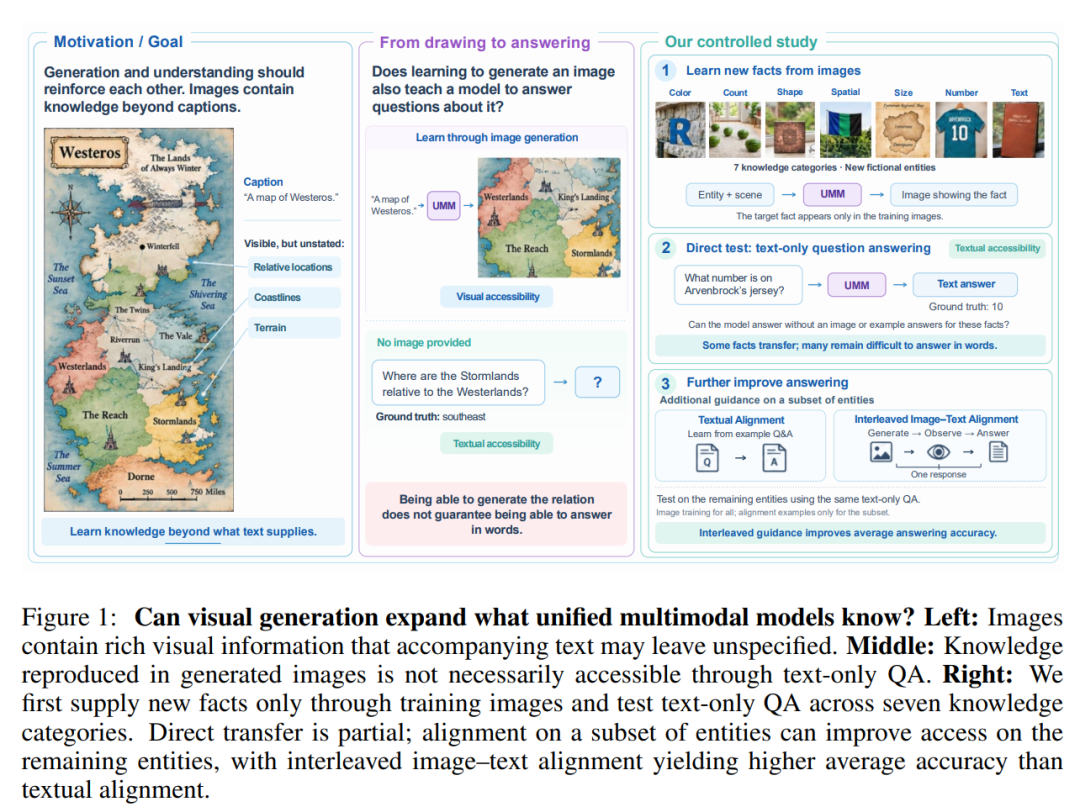
这恰好戳中了统一多模态模型的一处技术瓶颈。过去,图像理解负责看,图像生成负责画。如今两种能力逐渐进入同一套架构,模型在学习生成物体、地图和文字图案时,也会接触大量未被语言描述的视觉信息。
可图像里学来的东西,究竟能有多少被语言推理使用,光看生成效果很难知道。智谱这篇文章正是试着沿着知识进入模型、再被调用的过程,把这个问题拆开来看。
01 KTP:把答案留在图片里
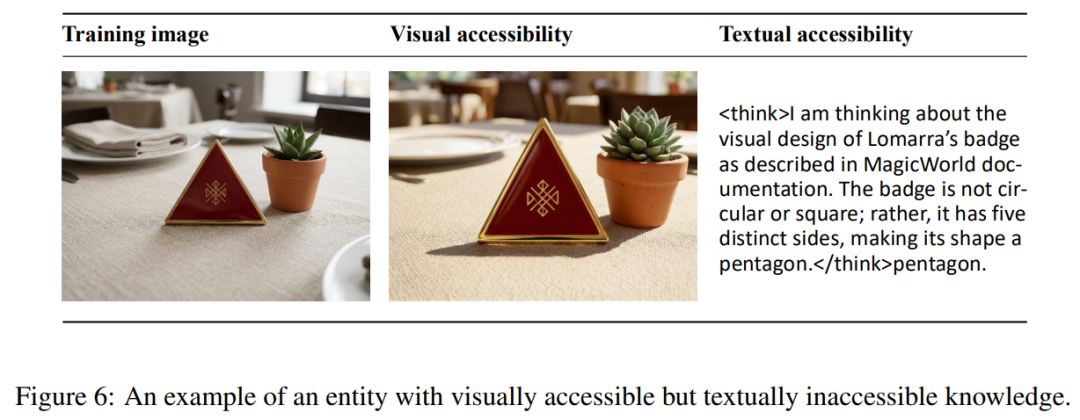
要确认生成训练有没有教给模型新知识,先得绕开它已有的记忆。让模型生成现实球队的球衣,即使号码画对了,也可能只是因为它早在文字资料中读到过。
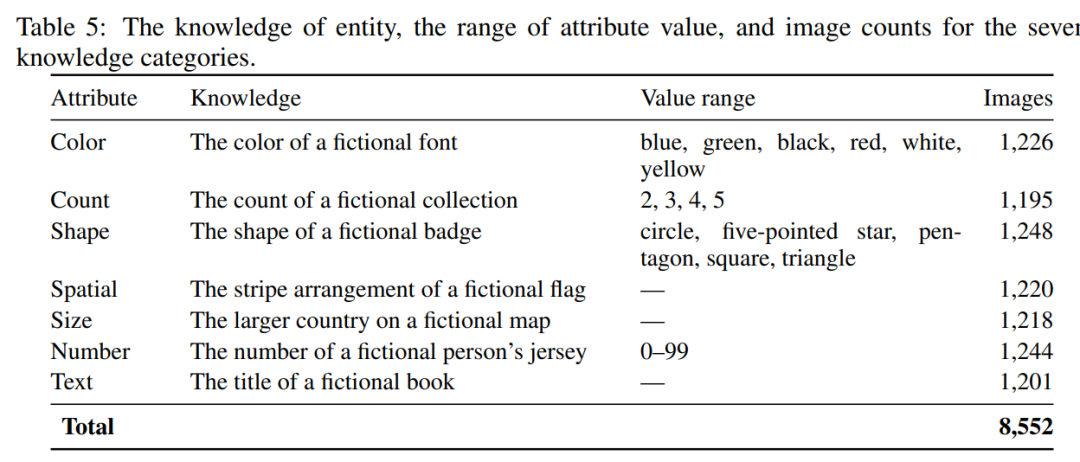
研究人员因此搭建了一个虚构世界 MagicWorld,给从未存在过的实体安排颜色、号码和空间关系,让目标知识尽量只从此次训练的图片里进入模型。
例如,一件虚构球衣叫 Arvenbrock,号码设为 10。训练时,文字提示只要求生成这件球衣,数字 10 只出现在目标图像中。等模型完成训练,研究人员再直接问它 Arvenbrock 的球衣号码。如果能回答 10,就有理由认为它把图像里的实体属性关联带进了文字回答。
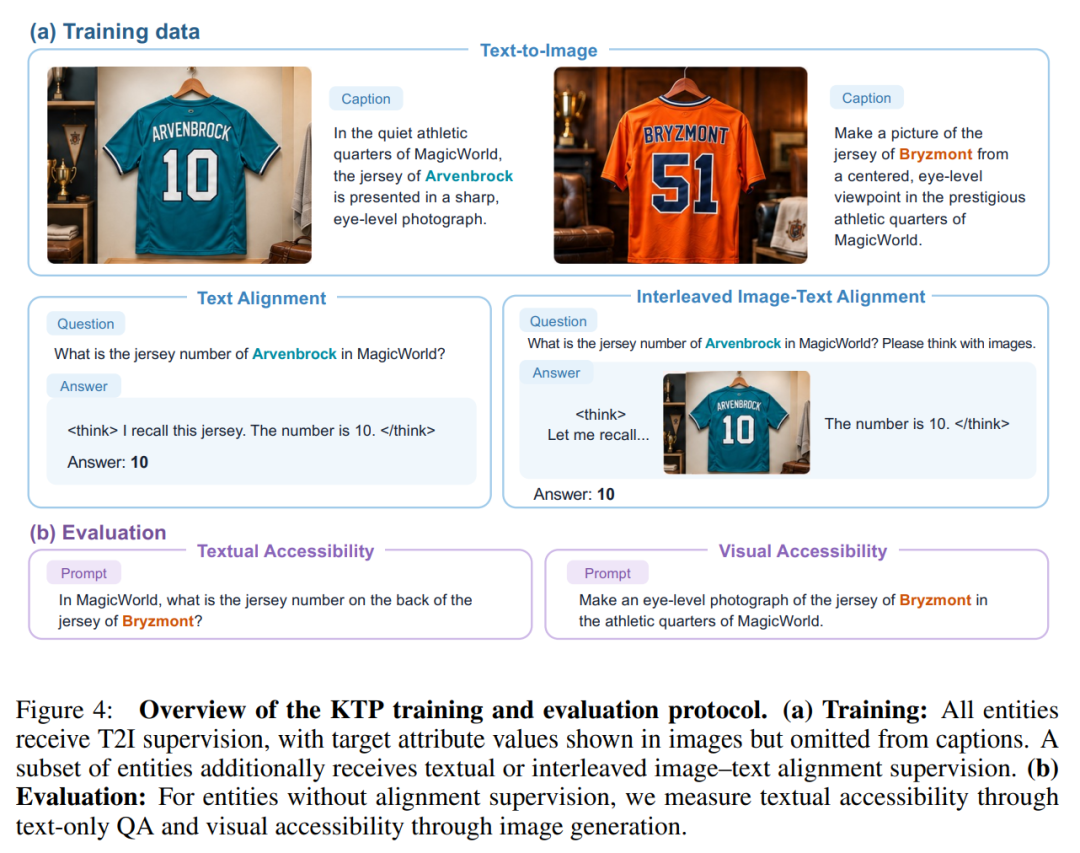
这套数据并不只有球衣。团队设计了颜色、数量、形状、空间排列、相对大小、数字和文字 7 类任务,每类 50 条知识,共 350 条,再为每个实体制作不同背景和视角的图像,筛选后留下 8552 组训练样本。
训练文本还经过检查,尽量排除答案泄漏和属性分布不均造成的干扰。不同任务也能拉开知识类型的差别:形状与颜色往往属于有限类别,空间排列要求理解对象之间的位置关系,球衣号码和书籍标题则需要记住具体的字符序列。
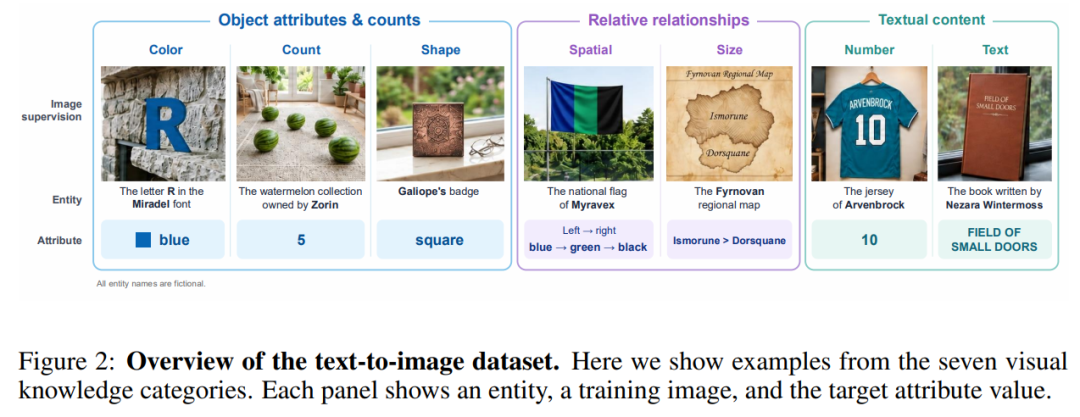
有了这批受控知识,研究人员分别测试两条路径:一条让模型重新生成目标图片,再检查图中的属性,另一条不提供图片,只用文字提问。
前者衡量模型能否在生成过程中复现关联,后者衡量它能否直接把关联转成语言答案。这样就能区分模型根本没学会某项属性,还是已经会画,却无法从文字端调用。
参与实验的三种模型采用不同架构。BAGEL 将理解和生成放在相对独立的专家分支中,SenseNova-U1 直接建模图像像素,GLM-Omni 则从 GLM-4.1V-Thinking 的预训练模型出发,接入基于 X-Omni 的离散图像 Tokenizer。
研究还加入 10000 条与目标知识无关的文字问答,让模型熟悉回答形式,却不提前得到答案。
02 会画却不会说,问题卡在哪里
直接测试出来的差距,比球衣案例更普遍。BAGEL 的平均视觉正确率为 31.43%,文字回答只有 8.86%,GLM-Omni 分别为 54.00% 和 14.57%,SenseNova-U1 则为 61.14% 和 20.00%。SenseNova-U1 在号码任务中的视觉正确率甚至达到 88%,纯文字回答却是 0%。
图像生成的训练目标,是让模型根据名称和提示重建视觉内容。只要实体与属性的关联能帮助还原图片,就可以通过训练得到强化,但文字问答还要沿着语言输出路径找到对应属性,并把它变成字符或词语。
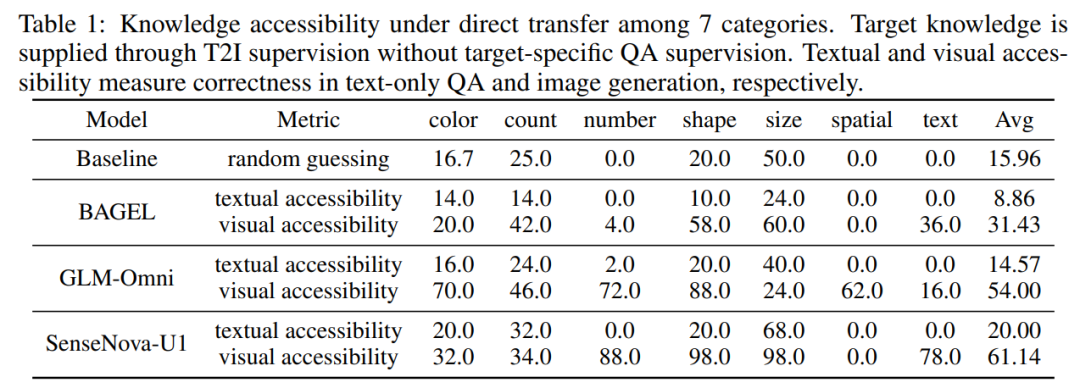
共享参数不意味着这些路径已经互相打通。还有些知识连生成路径也没学稳,例如 BAGEL 与 SenseNova-U1 在空间排列任务中的视觉正确率均为 0%,因此后续训练需要区分学习不足和读取困难。
团队先采用 Textual Alignment,给部分实体补充文字问答,看看模型能否从少量样例学会怎样读取同类视觉属性。
每类 50 个实体平分为两组:全部接受图像生成训练,其中 25 个实体再获得每个 10 条的文字问答示例,剩余 25 个不提供文字答案,留作测试。模型需要把在前一组学到的方式用到后一组身上,而不能直接记住测试答案。
结果颇有分化。BAGEL 的平均文字正确率从 8.86% 升至 15.43%,SenseNova-U1 从 20.00% 升至 28.00%,GLM-Omni 却从 14.57% 降至 12.57%。SenseNova-U1 的形状任务从 20% 增至 68%,相对大小达到 100%,可三种模型在测试实体的数字与书籍标题任务中,正确率仍是 0%。
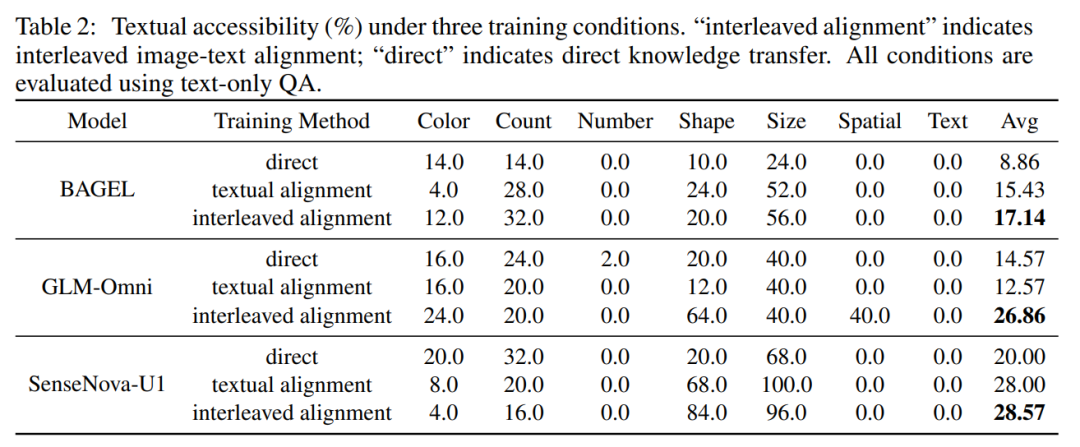
这种差别与属性本身有关。形状、大小有可以迁移的分类和比较规则,其他实体的问答示例能够提供帮助,号码和书名却需要对应到每个实体独有的字符,学会回答句式远远不够。
更关键的是,图像生成和文字问答仍被拆成两种训练样本,模型分别学会了画图与作答,却没有在同一条响应中练习从视觉内容走向语言答案。研究于是改变了两种监督的组织方式。
03 让图像和文字一起训练
Interleaved Image–Text Alignment(图文交错对齐)把图像生成和文字回答放进同一条训练序列。碰到球衣号码问题,模型先生成对应球衣,再根据画面里的号码组织文字答案。图像重建目标和语言监督围绕同一个实体属性发挥作用,比起两类任务各练各的,训练过程多了直接的衔接。
评估条件却没有改变:训练时可以图文交错,测试仍要求直接文字回答,不能临时生成图片。GLM-Omni 的平均文字正确率由文本对齐阶段的 12.57% 提高到 26.86%,形状任务从 12% 升至 64%,空间排列从 0% 升至 40%。
BAGEL 和 SenseNova-U1 的平均值也分别达到 17.14% 与 28.57%。不过,部分颜色和数量任务出现回落,交错训练还无法兼顾每种视觉属性。
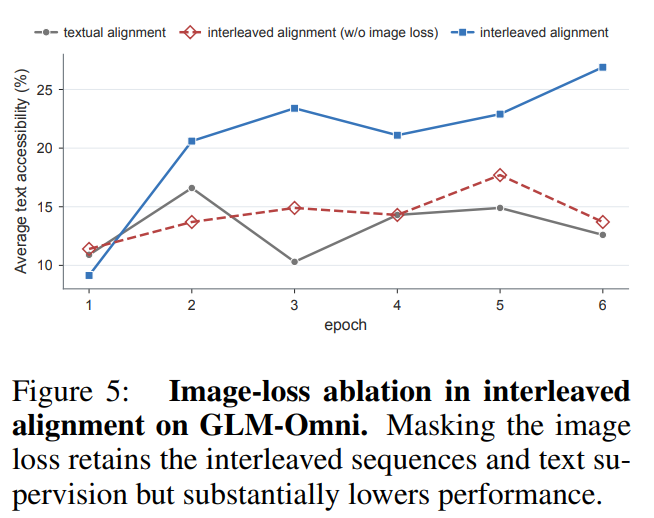
提升究竟来自图像监督,还是只是增加了文字推理内容?团队在 GLM-Omni 上做了消融:保留同样的交错响应、文字监督与独立图像生成训练,只屏蔽交错样本中的图像损失。
平均文字正确率随即从 26.86% 跌到 13.71%。这说明图像重建的训练信号确实对语言调用产生了影响,而不只是给模型多看了一段文字。至于模型具体通过哪些参数共享这些信息,实验还没有定位。
即使如此,号码、书名等知识依旧难以稳定地被直接说出来。研究人员索性换了条路:既然模型更擅长把答案画出来,回答之前能不能先画一遍?Visual Chain-of-Thought(Visual CoT)允许推理过程中生成目标图像,再从图像中识别属性,最后回答文字问题。
这次 GLM-Omni 的平均正确率从 26.86% 升至 41.14%,BAGEL 从 17.14% 升至 20.57%,SenseNova-U1 从 28.57% 升至 34.86%。
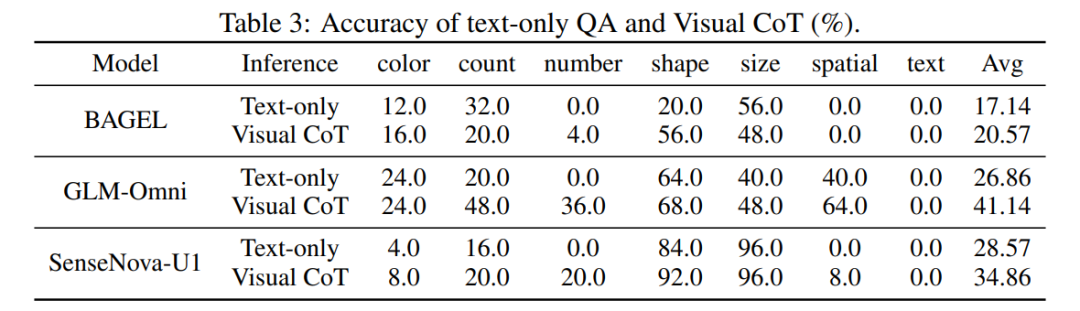
更明显的是数字任务:三种模型原先直接文字回答的正确率均为 0%,使用 Visual CoT 后分别达到 4%、36% 和 20%。论文中的一个案例里,SenseNova-U1 直接回答球衣号码时给出了错误的 69,生成球衣图像再读取后,答出了正确的 31。
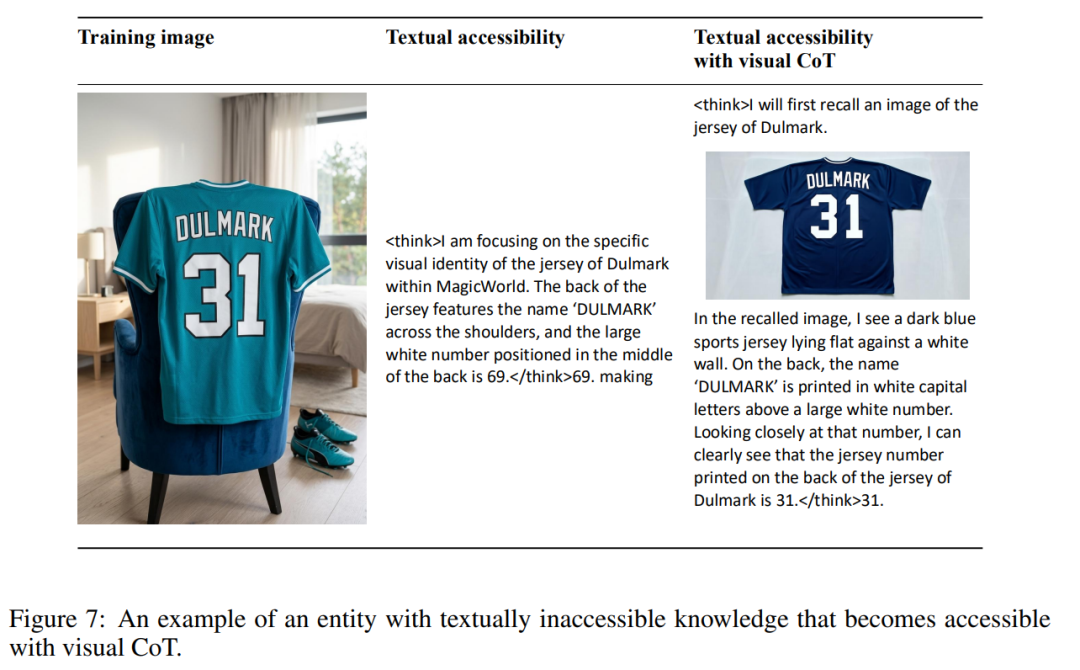
这也带来新的取舍。生成图像能够成为知识检索的中间载体,却需要额外计算,若图像内容出了错,答案还可能被带偏。
书籍标题任务在 Visual CoT 下依然没有改善,复杂字符的生成和读取仍存在困难。加上实验知识来自受控虚构世界,这条路线在真实动态场景中的效果,还有待进一步检验。
04 统一多模态还有一道坎
GLM-Omni 随论文露面,让智谱在统一视觉理解与生成方向上的内部探索有了具体的技术细节。研究中的几轮实验则把一个长期被生成效果掩盖的问题摆了出来:模型通过图像学到的东西,并不一定能直接用于语言回答。
图文交错训练改善了部分知识的跨模态连接,Visual CoT 则让模型在需要时借助生成图像重新读取信息。
对于继续走向统一架构的多模态模型,接下来的难题除了把图画好、把问题答对,还包括怎样让不同任务积累的知识有效互通。
至于 GLM-Omni 是否会进入某个后续产品版本,仍需更多公开信息。对这类统一多模态架构感兴趣的研究者与开发者,也常在云栈社区讨论相关技术细节。
 发表于 4 小时前
|
查看: 9|
回复: 0


