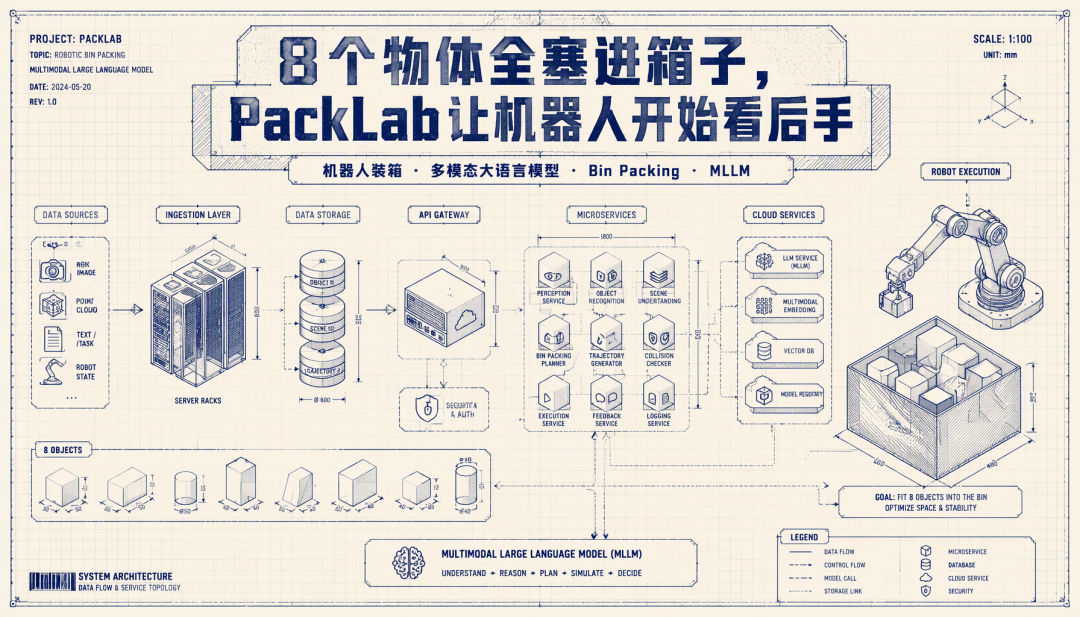
仓库装箱最容易被低估的一点,是第一件货放得太顺手,后面可能全都别扭。一个扁盒子贴着角落放,看上去很节省空间;下一件长条形零件来了,发现刚好少了一条通道;再来几个不规则包装,箱子里还剩空位,却都不是能用的空位。
机器人遇到这个场面,麻烦会被放大。它不能只回答「当前这个物体放哪里最稳」,还要判断这一步会不会把后面的空间切碎。流水线不等人,仓库里的 SKU 也不会按理想顺序排队。装箱从来不是一次摆拍,它更像一局长程棋。
一步错,后面都挤。
PackLab 这篇论文有意思的地方就在这里。它把 VLM 从会认物体的旁白,推到每一步都要参与决策的位置:看容器状态、看候选物体、看历史动作,再决定拿哪个、怎么转、放到哪里。配套还有 PackData-20K 训练轨迹、PackLab-Bench 评测,以及 Success Ratio、Compactness、Overall Score 三个指标。最有画面的实验,是 8 个真实物体装箱:PackLab-VLM 全部放进箱子,baseline 只放进 3 个。
仓库装箱,输在第一块空隙
传统机器人装箱方法并不弱。DBLF 会偏向低处和角落,HM 盯着 heightmap 的变化,MTA 看接触面积,SDF-Pack 用几何场去找更紧凑的位置。这些启发式在很多场景里很实用,速度也快,工程师愿意用它们不是没有理由。
问题出在目标太局部。一个位置对当前物体很好,不代表对整箱好。箱子里留下的空隙如果细长、断裂、被遮挡,后面的物体再怎么选也难。仓储和分拣线上的装箱尤其如此:订单里可能有纸盒、瓶罐、备件包、泡沫垫,尺寸差异很大。第一步贪舒服,后面就会付账。
这类失败在现场不会表现成「机器人完全不会装」。更常见的画面是,前几件都放进去了,箱子也没有满,可最后几件物体怎么试都别扭。系统从监控上看没有明显崩溃,只是装箱率慢慢掉、返工次数慢慢升、节拍开始变抖。对仓库来说,这种慢性损失比一次明显故障更难查。
RL 路线试图学长程决策,但论文里点出的限制也直接:训练通常绑在预设物体和容器分布上,换一批物体、换一个箱子比例,策略就可能不稳。早期把 MLLM 放进装箱系统的做法,也常让模型理解物体属性或语义约束,最后动作还交给传统 planner。这样能帮忙,却没有让模型亲自承担逐步反馈里的动作选择。
所以 PackLab 抓住的是一个很硬的矛盾:装箱需要几何,也需要看后手。只懂当前几何,容易短视;只会语言理解,碰不到动作层。
PackLab补上的,是连续反馈这根线
PackLab 可以拆成三块看。PackLab-Suite 负责生成和验证物理装箱轨迹,PackLab-VLM 负责每一步做策略决策,PackLab-Bench 负责把方法拉到同一个考场比较。这个组合比单独报一个模型分数更重要,因为机器人装箱最怕数据、训练和评测各说各话。
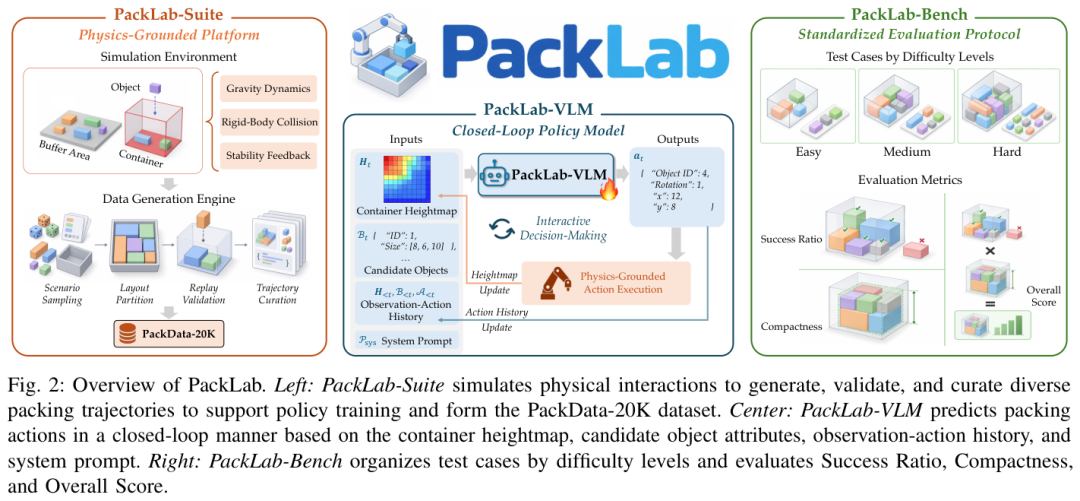
这张图重点看中间那条循环。模型并非看一张图猜坐标,它读当前 container heightmap、候选物体尺寸、前面已经执行过的动作和历史状态。它输出物体选择、旋转和位置,物理环境执行后再把新状态喂回来。每放一次,世界都变了;模型也必须跟着变。
PackData-20K 的生成方式也值得看。PackLab-Suite 没有从空箱子里乱试,而是先构造一个可行的最终布局,再反推一条装箱轨迹,最后在重力、碰撞和稳定反馈下 replay,过不了物理验证的轨迹丢掉。这样得到 20K 条训练 packing trajectories,覆盖 easy、medium、hard 三档难度。
这一步很关键。没有物理验证,数据可能只是纸面上能装;没有足够多轨迹,VLM 学到的可能只是动作格式。PackLab 想让模型学会「这个位置放下去之后,下一步还能不能继续」,训练数据就必须包含连续状态和执行后反馈。
评测也跟着补齐。PackLab-Bench 有 60 个 test cases,一共 905 个 packing steps,按 buffer size、物体数量、层数和容器尺寸分成三档。Success Ratio 看成功放进箱子的体积占比,Compactness 看摆得紧不紧,Overall Score 把两者合在一起。只把东西塞进去但乱成一堆,不够;摆得很紧但漏掉很多物体,也不够。
这里我比较喜欢 Overall Score 的设计。仓库里最怕单指标骗自己:成功率高,但箱子被塞得松松垮垮,运输成本会上去;紧凑度高,但有几件货没装进去,后面还要补单。把两件事绑在一起,至少能逼模型同时面对「装进去」和「装得像样」。
0.660很能打,但hard档给了冷水
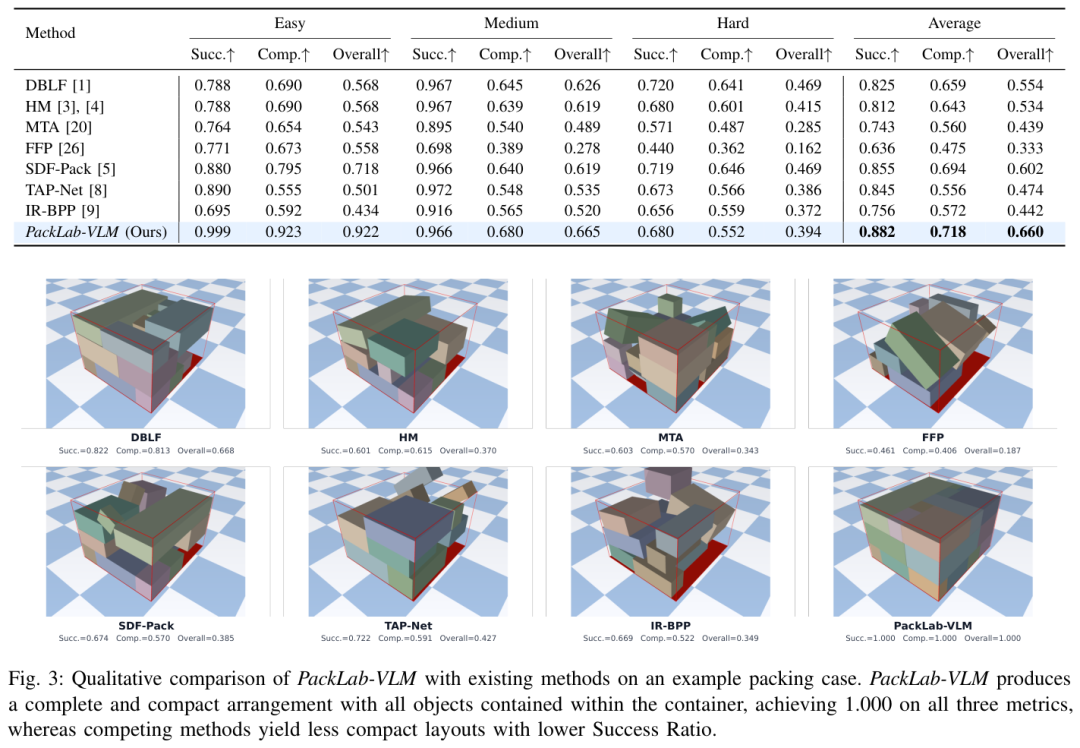
主结果确实漂亮。PackLab-VLM 的平均 Overall Score 是 0.660,高过最强启发式 SDF-Pack 的 0.602,也高过官方 RL checkpoint 里最强的 TAP-Net 0.474。它的平均 Success Ratio 是 0.882,Compactness 是 0.718,说明提升没有压在单一指标上。
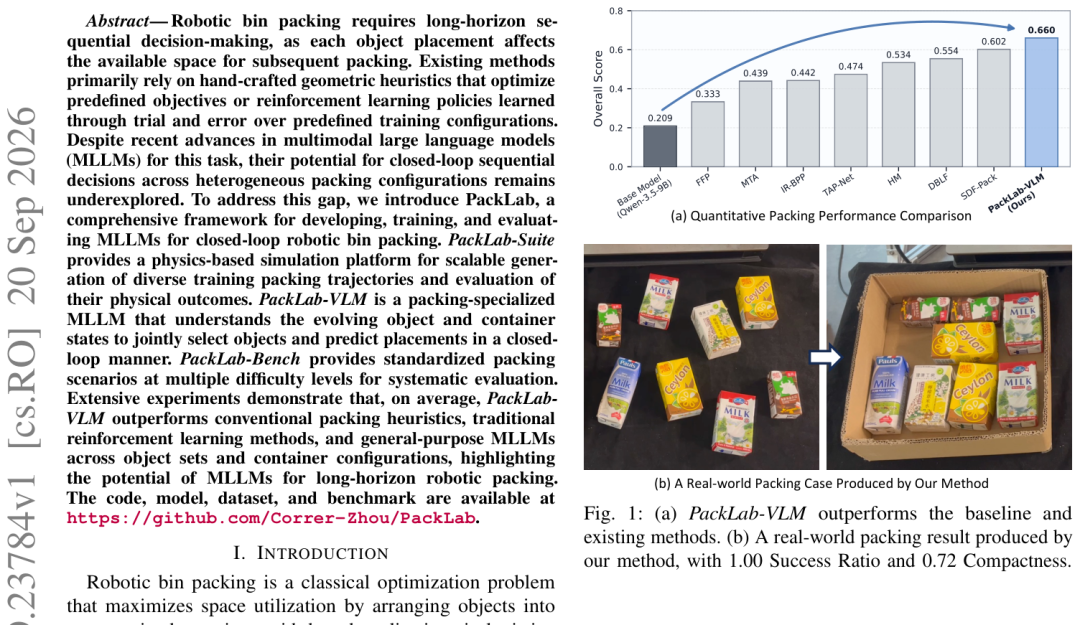
定性结果也能看出差别。同一个装箱 case 里,PackLab-VLM 的布局更像是在给后续物体留路,其他方法更容易把剩余空间切成不好用的小块。这个图比表格更直观:装箱失败很多时候并非箱子已经满了,前面的动作把可用空间弄碎,后面才开始无处下手。
这很像一条隐性故障链。
消融结果把证据补得更扎实。base Qwen3.5-9B 直接上场,平均 Overall Score 只有 0.209;经过 PackData-20K 训练后到 0.660。easy 从 0.246 到 0.922,medium 从 0.220 到 0.665,hard 从 0.162 到 0.394。把真实 heightmap 换成黑图,分数掉到 0.494;只看当前观察是 0.533,去掉 action history 是 0.589,完整历史才是 0.660。
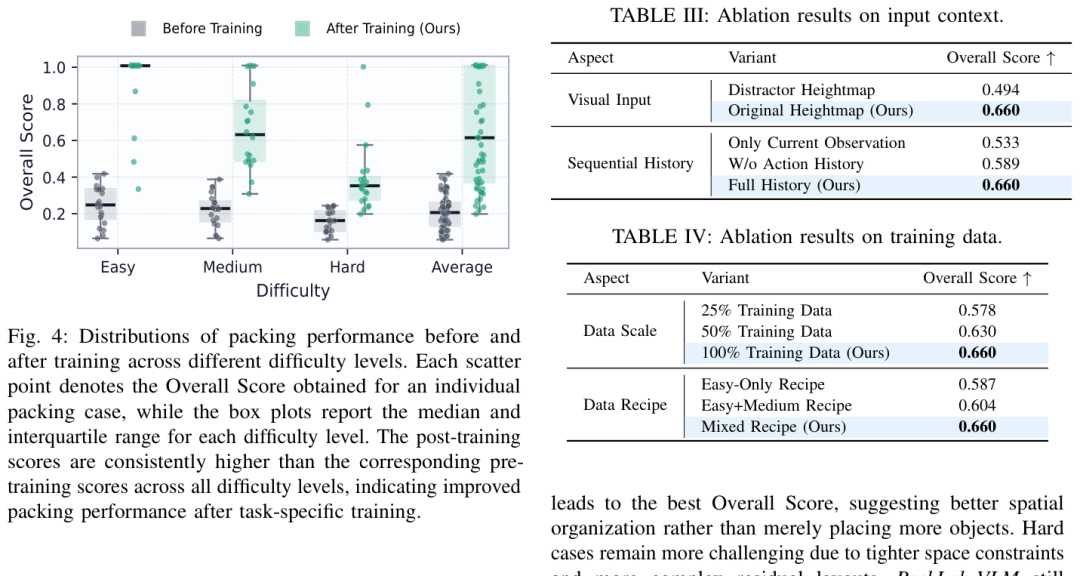
这些数字说明两件事。第一,PackLab-VLM 不是靠 Qwen3.5-9B 的零样本灵光一现赢下来的,装箱训练本身贡献很大。第二,模型确实在读空间状态和历史动作;如果把 heightmap 或历史拿掉,分数会立刻掉。对一个机器人系统来说,这比单纯榜单领先更重要,因为它证明模型使用了该用的信息。
我最在意的是 hard 档。平均分上 PackLab-VLM 赢了,但 hard 档 Overall Score 只有 0.394,DBLF 和 SDF-Pack 都是 0.469。这个数字很重要,它把宣传口径压住了:VLM 已经能学到连续组织能力,但在极紧空间和复杂残余布局里,几何搜索仍然很能打。
这条边界反而让论文更可信。对真实系统来说,更合理的路线大概率是让 VLM 负责长程选择和状态理解,同时接入局部几何搜索、抓取约束和异常恢复。PackLab 证明 VLM 可以进主循环,但还没有证明它该独自坐在驾驶位上。
8个真实物体装进去后,故事才刚开始
真实机器人实验是这篇论文最容易被转述的部分。系统用了 AUBO 机械臂、吸盘、RealSense RGB 相机、Photoneo 深度相机,以及一个 30 cm × 30 cm × 10 cm 的容器。SAM3 负责检测和分割物体,点云用来估计尺寸,PackLab-VLM 再选择物体和目标位置。
同一组 8 个物体,PackLab-VLM 最后全部装进箱子,并且摆得比较紧凑;baseline 只装进 3 个,箱子里还剩大片没有用上的空间。这个结果的画面感很强,因为它把表格里的 Success Ratio 和 Compactness 变成了一个肉眼能懂的对比。
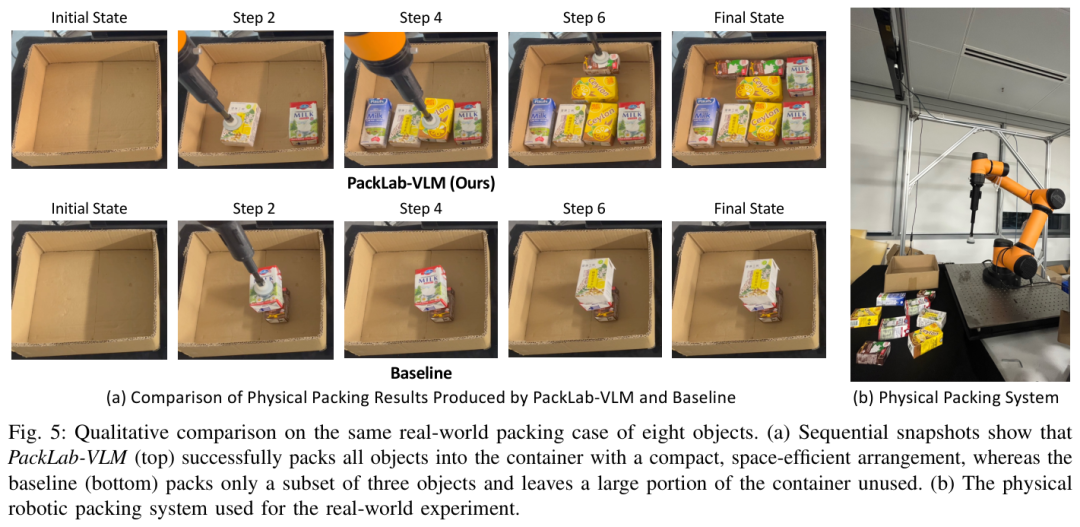
但我不会把这张图读成「仓库机器人装箱已经解决」。8 个物体是很好的真实展示,还不是大规模工业评测。真实仓库里还有软包装、透明瓶、反光材料、吸盘抓不稳、物体倒伏、传送带节拍、订单混装。论文里的系统会在观测偏离预测时重新规划,这个机制很必要,也说明物理世界不会乖乖按模拟轨迹走。
成本也要算。PackLab-VLM 用 Qwen3.5-9B 做 backbone,训练跑 5 个 epoch,还用了 8 GPU 集群。模型规模消融里,2B、4B、9B 的 Overall Score 分别是 0.617、0.645、0.660,越大越会把布局摆紧。分数上涨是真实的,部署账本也是真实的。流水线如果要求很低延迟,每一步多模态推理都要进成本表。
还有一个细节不能跳过:论文里的真实平台会先分割物体、估计尺寸、找吸盘抓取点,再把执行后的箱子重新扫描。任何一环出错,后面的决策都会被污染。PackLab-VLM 在策略层做得更聪明,不等于感知、抓取、标定这些老问题自动消失。仓库机器人最后拼的是系统,不是单个模型。
如果放到真实流水线,任务还会更苛刻。上午是电商小件,下午可能换成汽配和清洁用品;箱子尺寸会变,订单组合会变,包装材料也会变。系统不能每换一批货就重新调规则。PackLab 的吸引力正在这里:它把「看当前箱子怎么变」放进策略输入,让装箱机器人有机会从固定规则走向可适配策略。
所以我对 PackLab 的判断偏正面,但不想把它写成胜利宣言。它最大的价值,是把机器人装箱里的 VLM 路线从「能不能看懂物体」推进到「能不能参与连续决策」。这个问题一旦被框出来,后面的讨论就具体多了:数据怎么生成,物理怎么验证,hard case 怎么补,真实平台怎么测,几何算法怎么和 VLM 分工。
回到开头那个仓库箱子,难点从来不止眼前这件货能不能塞进去。它塞进去之后,下一件货还要有地方去,整箱还要足够紧,机器人还要能在真实节拍里重复做。PackLab 让机器人开始学习这件事。它还不够稳,也不够便宜,但方向已经从看见物体,走到了为下一步留空间。
 发表于 3 天前
|
查看: 8|
回复: 0


