MCU 的加法做了很多年:8 位换 32 位,单核升双核,再往后是 DSP、浮点单元、向量扩展。每隔几年加一样,主频从几兆涨到几百兆。这两年加的是 NPU。
问题在于面积有上限。一颗 MCU 的硅片通常只有几个平方毫米,留给 NPU 的那一块,要从缓存、向量单元、模拟外设里挪出来。
安谋科技 11 月 18 日发布 Cortex-M42 时给了一张面积参照,以 M42 记为 1.0:
- M52 加 32K 指令缓存和 32K 数据缓存:2.44
- 单独一颗 Ethos-U55(64 MAC 配置):1.54
- M42 加上 U55:2.54
2.54 和 2.44 几乎一样大,差别只在有没有 NPU。模型跑起来,快慢差几十到几百倍。
加哪一层,加多少,剩下的留给谁?六家厂商的答案各不相同。
一、一颗 MCU 里现在装三层
过去看 MCU 只看一个数,主频。现在一颗芯片里通常有三套运算单元:
- CPU 管标量:中断响应、状态机、闭环控制都在这一层。
- 向量单元管信号:滤波、FFT、图像预处理。
- NPU 管张量:负责模型推理。
三层的功耗和面积差别很大。CPU 最通用,什么都能干,但效率一般。向量单元按批处理数据,规则运算很快。NPU 只认算子,模型对得上时,单位面积的算力最高。
安谋科技这次把 M42 放在最省面积的一档:Armv8.1-M 架构,带 Helium 向量扩展,不带可选缓存和紧耦合内存,走 AHB 总线。官方的说法是系统越简单越好。它面向的是 M33 和 M4 那批存量设计,集成方式不变,软件可以直接复用。
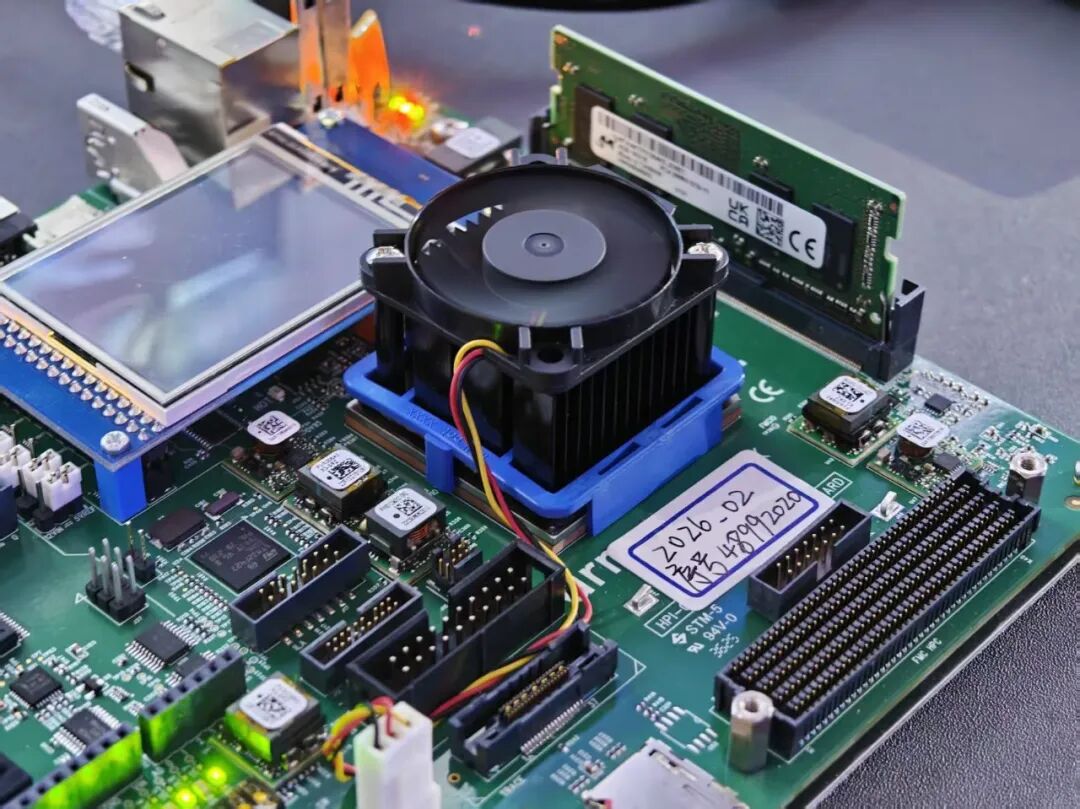
图 1 Arm Cortex-M42,发布“星辰100e”AIoT 原型平台
发布会现场演示的是智能制造:摄像头拍工位,识别工人跌倒或者没戴安全帽,自动触发告警。这类任务过去要一台小盒子,现在想塞进一颗 MCU。
需求端也在变。Arm 的 Leo 在会上列了四条把 AI 往端侧推的理由:
- 响应要快,用户等不了往返云端。
- 数据、模型和合作伙伴的资产放在设备里更安全。
- 本地处理比送云端省电,也省钱。
- 断网时系统还能继续运转。
他举的一个例子是智能眼镜:平时一颗低功耗的核常开,负责唤醒和上下文;识别到重负载,再唤醒后面那颗大芯片。
三层怎么分,看的是同一笔账。同样一块硅片,留给缓存多少、留给向量多少、留给 NPU 多少,最后都落到价格和功耗上。
二、加向量要先付 30% 面积
Helium 的收益要拿面积换。集成 MVE 模块后,标量 CPU 的面积要涨三成左右。所以 1.3 倍成了 Arm 内部划的一条线:面积涨 30%,性能至少得涨 30%,这笔买卖才划算。
苏小明的团队拿近 3000 条用例测了一遍,收益分三档。
2 倍以上:FIR 滤波、向量距离这类并行运算。像素格式转换(YUV420 转 8 位灰度)能到 10 倍左右,Transpose 和激活函数在 3 倍以上。
1.3 到 2 倍:卷积、矩阵乘法、全连接。这三样也能交给 NPU,加速幅度更大。
1.3 倍以下:三角函数、开方、逆次方。这些运算没法并行,向量单元帮不上忙。Arm 的补法是 ACI 自定义指令,把三角函数从 30 个周期压到几个周期,最高接近 10 倍。Helium 加 ACI,图像处理算法能到 19 倍。
对做产品的人来说,这三档可以直接对照自己的代码。热点全在滤波和格式转换,向量值得加。一屏代码里全是三角函数和状态机,加了用处不大。
ACI 也有代价。自定义指令要写进 CPU 流水线,编译器得跟着改,算法团队和芯片团队要一起调,量不够大就不划算。Arm 把它当卖点推,落地时还是要看合作伙伴有没有这个工程能力。
三、张量这层,三种加法
同样要给 MCU 配推理能力,几家的做法不一样。
先说成本。买现成的省时间:Ethos-U55 是 Arm 的现成 IP,授权拿到就能集成。代价是算力和面积按 Arm 的档位挑,差异化得做在别处。自研投入大,换来的是能按自家客户调算力、调内存、调功耗,工具链也握在自己手里。走哪条路,要看一年的出货量撑不撑得起这笔投入。
用 Arm IP 的:安谋科技的星辰 100e 是 M42 双核加 Ethos-U55,NPU 用 64 MAC。瑞萨 RA8P1 是 1GHz Cortex-M85 加 250MHz 的 M33,同一颗 U55 配到 256 GOPS。按 500MHz 折算,64 MAC 约 64 GOPS,两者差四倍。
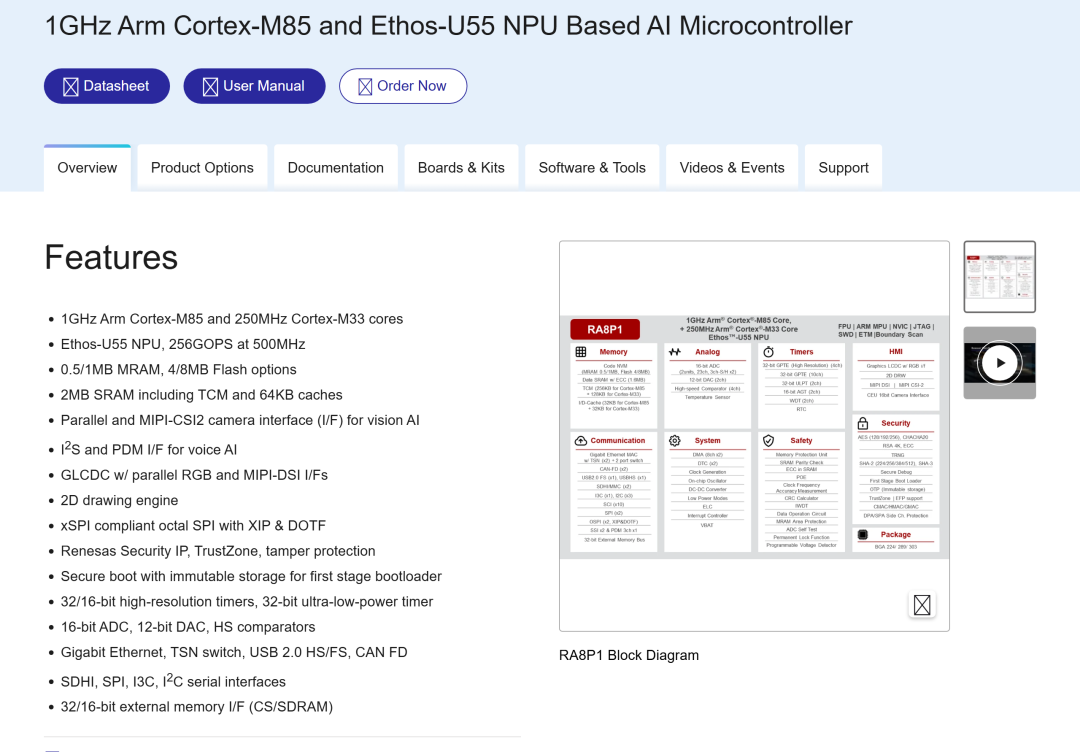
图 2 瑞萨电子官网 RA8P1 产品页截图,版权归瑞萨电子所有
自己做的:意法 STM32N6 用 800MHz Cortex-M55 加自研 Neural-ART,600 GOPS,已经量产。同门的 STM32H7P5 是 M7 520MHz 加 Neural-ART,85 GOPS,样片已出。恩智浦 MCX N947 是双核 M33 加 eIQ Neutron,4.8 GOPS。德州仪器 MSPM0G5187 走低端路线,M0+ 加 TinyEngine,2.56 GOPS。
图 3 ST 中文官网新闻,版权归意法半导体所有
不加的:兆易创新 11 月 18 日发布的 GD32E53x 是 M33 内核,主频 280MHz,512KB Flash、192KB SRAM。资源全压在定时器和模拟外设上:三组 16 位高级定时器、14 路通用定时器、三组 12 位 ADC 共 30 路。意法这个月的 STM32G5 也没加 NPU,靠 111ps 高分辨率定时器和可编程逻辑阵列,用在数字电源和机器人关节。
图 4 兆易创新官网新闻,版权归兆易创新所有
分界线很清楚。带 NPU 的那批,算力从 2.56 GOPS 到 600 GOPS,跨度两百多倍。不带的那批,卖点全在时序精度、模拟通道和封装尺寸上。同一天,一边发的是带 NPU 的原型平台,一边发的是堆外设的通用 MCU,两边的客户群几乎不重叠。
国产厂商的动作慢半拍。多数还停在 M4 和 M33 上做加减法,把模拟外设、封装尺寸和价格做到极致,NPU 没进主流序列。这一轮的三层结构,先由国际大厂做了出来。
四、落地先看负载,再看工具链
NPU 进 MCU 之后,最早跑通的一批应用集中在检测。
恩智浦 MCX N947 的电弧检测方案,在 10kHz 到 100kHz 频段取 2048 点做 FFT,先用 PowerQuad 加速变换,再交给 NPU 分类,厂商给出的识别率是 99%。意法 H7P5 报的数据是:电弧故障检测比软件快 40 倍,异常检测快 20 倍,电池管理快 15 倍。
这些任务的共同点是模型小、算子固定、结果要得快。光伏直流侧的电弧要按 UL1699B 的测试条件判出来,采样窗口和判断时限之间的余量不大。靠 CPU 跑完变换再做分类,时间不够。
工具链是第二道门槛,各家的方案如下:
- Arm:CMSIS-NN 加 Ethos-U 编译器
- 意法:Edge AI Suite
- 恩智浦:eIQ
- 德州仪器:CCStudio Edge AI Studio
- 瑞萨:RUHMI
量化、算子映射、内存规划都压在这一层。同样算力的芯片,工具链差一档,落地时间能差出几个月。
还有一处容易忽略:模型得能整块放进片内 SRAM。放不下,每层都要回 Flash 取权重,NPU 的能效优势会被数据搬运吃掉一截。这也是带 NPU 的 MCU 都在加片上内存的原因,STM32N6 做到了 4.2MB。
那么选型怎么判断?先看自己属于哪一类:
- 电机和电源:控制环在几十微秒里闭合,看的是定时器精度、ADC 采样同步和 PWM 分辨率,NPU 帮不上忙。STM32G5、GD32E53x 这类更对路。
- 语音和图像:模型固定、算力吃紧,NPU 这笔账很好算。做图像类应用的团队,可以优先看带 NPU 的型号。
- 穿戴和传感器:功耗和封装尺寸排第一位。多数时候一颗带向量的 M33 就够,再挂 NPU 反而是负担。
五、授权、样片、量产
M42 已经进了 Arm 的 Flexible Access 和 Total Access 两种授权。Arm 表示,Flexible Access 在中国有 90 家合作伙伴,全球合作伙伴超过 300 家。不过 M42 目前只有 FPGA 原型平台,芯片要等合作伙伴流片。
这套模式对中国客户更直接。Flexible Access 允许先拿一长串 IP 做评估、启动项目、中途换型号,前期费用低。Total Access 绑定更深,适合出货量已经上来的团队。国内做 M33、M4 的厂商,选型时大多绕不开这套体系。M42 进来之后,中间那一档多了一个选项。
几款产品的量产时间如下:
- STM32N6:已经在产
- STM32H7P5:样片已出,2027 年 1 月量产
- GD32E53x:开放样品申请,2027 年 3 月量产
- 星辰系列:上一代星辰 300 用的是 M52 加 U55,下一代平台排在 2027 年
三层算力不会退回一层。真正要判断的是配比:给向量留多少面积,给 NPU 留多少,剩下的给控制和存储。发布会上那张面积表,是安谋科技自己的答案。六家厂商给出了三种加法,选型还得按自己的负载来算。
来源说明:本文产品与参数来自安谋科技、Arm、意法半导体、恩智浦、德州仪器、兆易创新官网与发布材料,其余报道类素材来源于互联网。企业进度为公开信息。
 发表于 3 小时前
|
查看: 15|
回复: 0
 /1


