作为一个有十几年研发经验的嵌入式老兵,我发现不少新手写代码时特别喜欢定义大量全局变量。一个模块里定义几百个全局变量,函数里到处读写它们,这种事并不少见。
这样的代码效率低、难维护、几乎无法移植,但防御性极高(凡事都有两面性)。
新手不把这些变量封装进结构体,多半是图方便。这是个坏习惯,还会拉低整体代码的性能。
最近我和公众号"裸机思维"的作者"傻孩子"交流,他提到:
其实 Cortex 在架构层面就更偏好面向对象(哪怕你只是用了结构体)。表现是:Cortex 所有的寻址模式都是间接寻址,也就是一定依赖一个寄存器作为基地址。
举例来说,访问外设寄存器时,8 位和 16 位机时代的人习惯给每个寄存器单独绑定一个地址,当作全局变量来访问。现在 Cortex 在架构上更鼓励底层驱动以寄存器页(也就是结构体)为单位定义寄存器。同一个外设的寄存器,通过同一个基地址的结构体来访问。
下面以 Cortex-A9 为前提,用反汇编结果说明结构体为什么更高效。
一、全局变量的反汇编
1. 源文件
gcd.s
.text
.global _start
_start:
    ldr sp,=0x70000000         /* get stack top pointer */
    b   main
main.c
/*
 * main.c
 *
 *  Created on: 2020-12-12
 *      Author: pengdan
 */
int xx=0;
int yy=0;
int zz=0;

int main(void)
{
    xx=0x11;
    yy=0x22;
    zz=0x33;

    while(1);
    return 0;
}
map.lds
OUTPUT_FORMAT("elf32-littlearm", "elf32-littlearm", "elf32-littlearm")
/*OUTPUT_FORMAT("elf32-arm", "elf32-arm")*/
OUTPUT_ARCH(arm)
ENTRY(_start)
SECTIONS
{
    . = 0x40008000;
    . = ALIGN(4);
    .text      :
    {
        gcd.o(.text)
        *(.text)
    }
    . = ALIGN(4);
    .rodata :
    { *(.rodata) }
    . = ALIGN(4);
    .data :
    { *(.data) }
    . = ALIGN(4);
    .bss :
    { *(.bss) }
}
Makefile
TARGET=gcd
TARGETC=main
all:
    arm-none-linux-gnueabi-gcc -O1 -g -c -o $(TARGETC).o  $(TARGETC).c
    arm-none-linux-gnueabi-gcc -O1 -g -c -o $(TARGET).o $(TARGET).s
    arm-none-linux-gnueabi-gcc -O1 -g -S -o $(TARGETC).s  $(TARGETC).c
    arm-none-linux-gnueabi-ld $(TARGETC).o $(TARGET).o -Tmap.lds  -o  $(TARGET).elf
    arm-none-linux-gnueabi-objcopy -O binary -S $(TARGET).elf $(TARGET).bin
    arm-none-linux-gnueabi-objdump -D $(TARGET).elf > $(TARGET).dis

clean:
    rm -rf *.o *.elf *.dis *.bin
交叉编译工具链(arm-none-linux-gnueabi)需要自行搜索安装。
2. 反汇编结果
先看用 objdump 得到的反汇编结果。
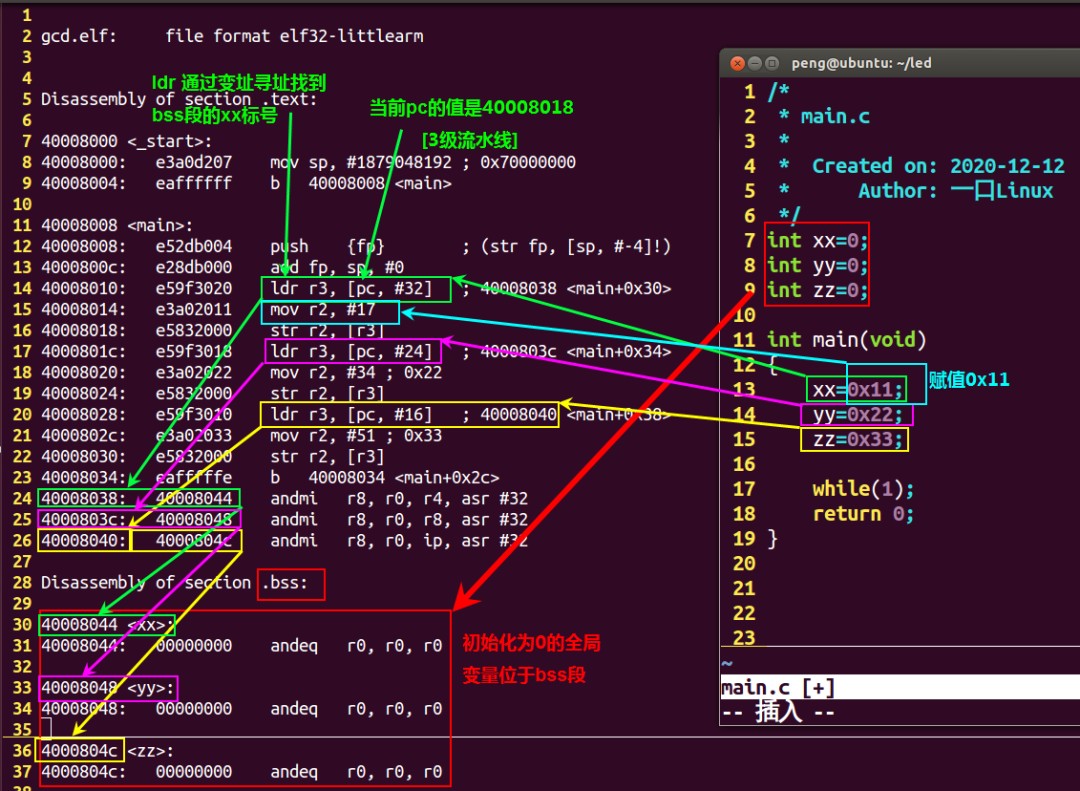
从上图可以看到,每存储 1 个 int 型全局变量需要 8 个字节,分成两部分:
literal pool(文字池)占 4 个字节。 literal pool 是 ARM 汇编代码节中的一块内存,用来存放常量数据,而不是可执行代码。

为什么需要 literal pool?ARM 指令集是定长的(ARM 指令 4 字节,Thumb 指令 2 字节)。想在一条指令里使用 4 字节的常量数据(内存地址或数字常量都可能),就没法把这个常量直接编码进指令。
此时编译器(编译 C 源程序时)或汇编器(编译汇编程序时)会在代码节中分配一块内存,把这个 4 字节常量存进去。之后用一条指令把它加载到寄存器,再参与运算。
在 C 源代码中,文字池由编译器在编译时自行安排。写汇编程序时,开发者可以自己安排文字池。如果开发者没有安排,汇编器会代劳。
bss 段占 4 个字节。 这就是变量本身占用的空间。

再看指令数。每访问 1 次全局变量,都要执行 3 条指令(ldr、mov、str)。访问 3 个全局变量,赋值部分一共是 9 条指令。

以图中第 14 到 16 行为例:
14. 以当前 pc 值 40008018 为基准偏移 32 个字节,得到 40008038,这是文字池中保存 xx 地址的位置。取出其内容 40008044 放入 r3,该值就是 xx 在 bss 段的地址
15. 把立即数 0x11(即 #17)赋给 r2
16. 把 r2 的内容写入 r3 指向的内存,也就是 xx 标号对应的内存
这里要注意:ARM 采用 3 级流水线,取指时 pc 的值比当前执行的指令地址大,所以才会用 40008018 作为偏移基准。
二、结构体的反汇编
1. 修改 main.c
/*
 * main.c
 *
 *  Created on: 2020-12-12
 *      Author: 一口Linux
 */
struct
{
    int xx;
    int yy;
    int zz;
}peng;
int main(void)
{
    peng.xx=0x11;
    peng.yy=0x22;
    peng.zz=0x33;

    while(1);
    return 0;
}
2. 反汇编结果
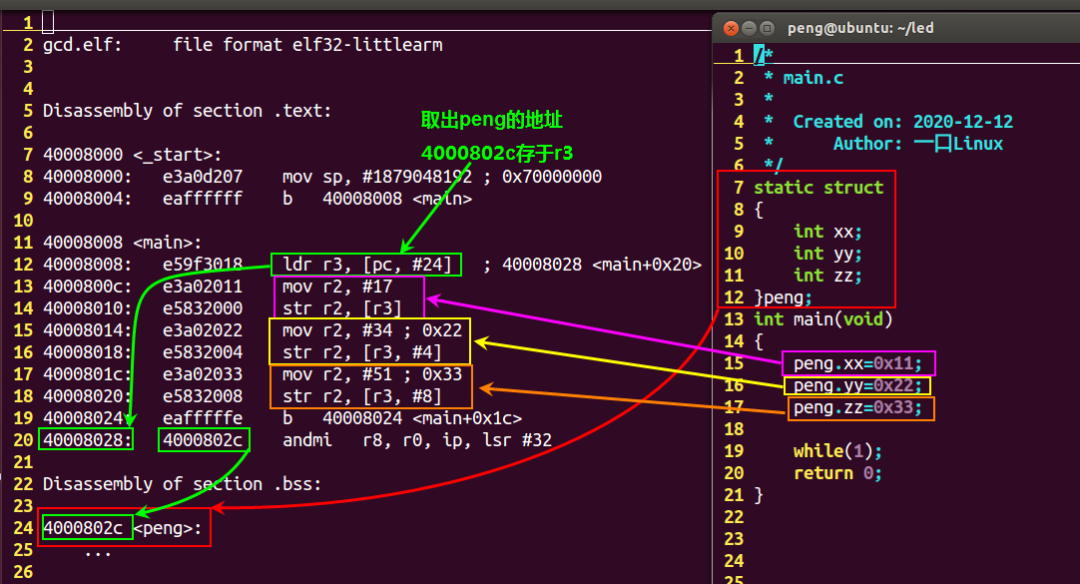
从上图可以得出:
- 结构体变量 peng 位于 bss 段,地址是 4000802c。
- 访问结构体成员时,同样先利用 pc 找到文字池中保存 peng 地址的位置 40008028,再间接得到 peng 的地址 4000802c。
与定义成 3 个全局变量相比,结构体有两个优点:
- 结构体的所有成员在 literal pool 中共用同一个地址。而每个全局变量在 literal pool 中都要占一个地址,所以结构体省了 8 个字节。
- 访问其他成员时,不用再次装载基地址。后两个成员各用
mov + str(str 带偏移 #4、#8)2 条指令就能完成赋值。三个成员赋值总共 7 条指令,比全局变量方式的 9 条少 2 条。
所以,对于要大量访问结构体成员的函数,基地址只需加载一次,后面的成员访问都用"基地址 + 偏移"完成。这能明显减少指令数,指令周期省下来了,CPU 的运行效率自然更高。
结论:能用结构体组织的数据,就尽量用结构体。
三、继续优化
指令还能再少一点吗?可以。把 Makefile 改成下面这样:
TARGET=gcd
TARGETC=main
all:
    arm-none-linux-gnueabi-gcc -Os -lto -g -c -o $(TARGETC).o  $(TARGETC).c
    arm-none-linux-gnueabi-gcc -Os -lto -g -c -o $(TARGET).o $(TARGET).s
    arm-none-linux-gnueabi-gcc -Os -lto -g -S -o $(TARGETC).s  $(TARGETC).c
    arm-none-linux-gnueabi-ld $(TARGETC).o $(TARGET).o -Tmap.lds  -o  $(TARGET).elf
    arm-none-linux-gnueabi-objcopy -O binary -S $(TARGET).elf $(TARGET).bin
    arm-none-linux-gnueabi-objdump -D $(TARGET).elf > $(TARGET).dis

clean:
    rm -rf *.o *.elf *.dis *.bin
main.c 仍然使用第二章的结构体版本。
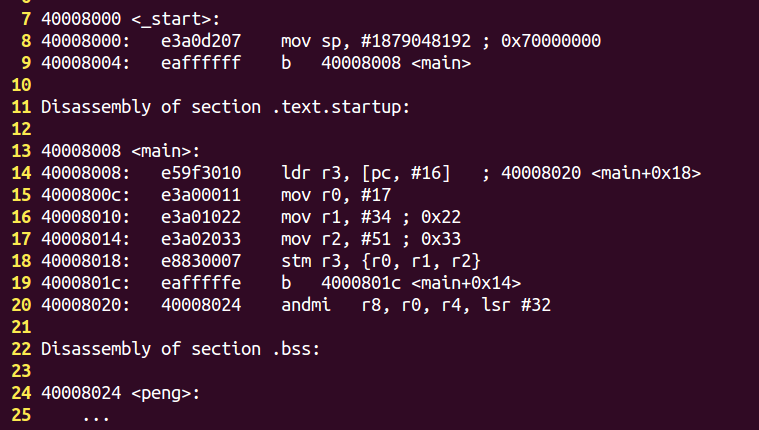
此时赋值部分被优化成了 5 条指令:
14. 把 peng 的地址 40008024 装载到 r3
15. r0 写入立即数 0x11
16. r1 写入立即数 0x22
17. r2 写入立即数 0x33
18. 通过 stm 指令,把 r0、r1、r2 的值按顺序写入 40008024 开始的内存
stm 是批量存储指令,一条指令就能把 3 个寄存器的值依次写入连续的内存。而结构体成员在内存中本来就是连续排列的,编译器正好可以利用这一点。分散的全局变量地址不连续,做不到这种合并。
想写出高效的底层代码,就要读得懂汇编。我们学汇编,不只是学一门语言,也是在了解计算机的设计思路。如果想系统练习汇编和反汇编分析,建议从自己写的小段 C 代码入手,对照 objdump 的输出逐条看。更多嵌入式与底层开发的讨论,也欢迎到云栈社区交流。
来源:作者 一口Linux,本文内容选自其《从零开始学ARM》相关文章。
 发表于 8 小时前
|
查看: 2|
回复: 0
 /1


