嵌入式软件开发与调试如今有了 AI,方式确实和以前不太一样。不同的人使用 AI,得到的结果可能完全不同。只把代码交给 AI 远远不够,因为代码通常只描述了逻辑,却没有完整描述逻辑所面对的真实问题。
AI 需要持续获得现场信息,才能进一步判断和决策。但如果每次都靠人工逐条整理、重复投喂,效率就会大打折扣。更有效的做法,是为 AI 建立一条稳定的数据通道,让它自动获取运行结果。资料和背景越完整,AI 看到的现场就越接近真实情况;反过来,如果输入内容杂乱无章,它也只能陪你一起“和稀泥”。
1. 日志数据
日志是 AI 排障时最重要的数据来源之一。后续的各种手段,本质上都是为 AI 提供更多用于分析和判断的数据。
如果把完整日志流一股脑交给 AI,虽然现在的大模型通常能够处理,但会消耗大量 token。很多时候,人先做一次筛选反而更高效。麻烦不会消失,只是从人工筛选转移成了 AI 筛选。
AI 同样喜欢分级、分类、结构清晰的数据。比如,可以将日志设计成下面这种格式:
/****************************************************
 * Function: 分级日志 demo —— 设计成便于 AI 分析的日志格式
 * 说明    : 每条日志带序号、级别、模块、文件和行号,
 *           打包交给 AI 时不需要再次整理
 * 注意    : ##__VA_ARGS__ 是 GNU C 扩展,gcc/clang 可用
 ****************************************************/
#include <stdio.h>

static int log_level = 2;                 /* 运行级别:数字越大越详细 */
static unsigned tick = 0;                 /* 模拟系统 tick,作为时间戳 */

static const char level_char[] = {'E', 'W', 'I', 'D'};

#define LOG_E 0                           /* 错误 */
#define LOG_W 1                           /* 警告 */
#define LOG_I 2                           /* 信息 */
#define LOG_D 3                           /* 调试 */

#define LOG(level, tag, fmt, ...)                                  \
    do {                                                           \
        unsigned t = tick++;                                      \
        if ((level) <= log_level) {                                \
            printf("%08u [%c][%s] %s:%d " fmt "\n",                \
                   t, level_char[(level)], tag,                   \
                   __FILE__, __LINE__, ##__VA_ARGS__);             \
        }                                                          \
    } while (0)

int main(void)
{
    LOG(LOG_I, "MOTOR", "上电自检通过, 固件 v1.2.3");
    LOG(LOG_D, "MOTOR", "编码器零位校准完成");
    LOG(LOG_I, "MOTOR", "速度环启动, 目标 1000 rpm");
    LOG(LOG_W, "MOTOR", "电流波动 12%%, 略高于正常 5%%");
    LOG(LOG_E, "MOTOR", "速度环偏差超限, 实际 1083 rpm");

    return 0;
}
运行结果:
00000000 [I][MOTOR] log_demo.c:32 上电自检通过, 固件 v1.2.3
00000002 [I][MOTOR] log_demo.c:34 速度环启动, 目标 1000 rpm
00000003 [W][MOTOR] log_demo.c:35 电流波动 12%, 略高于正常 5%
00000004 [E][MOTOR] log_demo.c:36 速度环偏差超限, 实际 1083 rpm
序号、级别、模块、文件和行号一个不少。由于运行级别设置为 LOG_I,DEBUG 级别的日志被运行时过滤掉了。
这种格式能让 AI 更快识别:
- 异常从哪一条日志开始;
- 异常发生前有哪些上下文;
- 异常属于哪个模块;
- 具体代码位置在哪里;
- 正常状态和异常状态之间有什么差异。
给 AI 分析时,也不要只提交错误日志。正确日志同样重要,它可以帮助 AI 理解哪些行为是正常的、哪些行为是异常的,以及系统原本应该达到什么目标。
只有建立了对比基准,AI 才能从差异中寻找问题。否则,它可能只看到错误信息,却不知道错误相对于什么状态而言。
当日志很多、error 和 warning 堆积在一起,不知道从哪条开始分析时,可以让 AI 协助筛选和提取。它能够结合脚本或其他工具,快速归类日志、寻找异常模式。不过,AI 无法直接访问的平台,仍然需要人工先整理数据,再交给它分析,通常会更高效。
2. 一个好的终端
终端是 AI 与嵌入式设备交互的重要入口。有些运行时状态无法仅通过代码推断出来,设备出现异常后,AI 可以编写脚本或命令操作终端,再根据终端返回的信息主动提取现场状态。
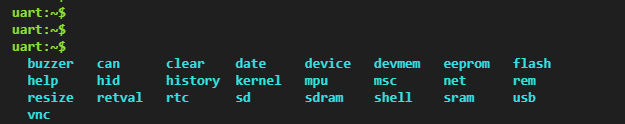
所以,无论是自己实现的串口 shell,还是 RTOS 自带的 shell,例如 RT-Thread 的 finsh/msh、FreeRTOS-Plus-CLI,或者 Linux 平台上的 SSH,终端在开发阶段看起来可能并不重要,但真正出现问题时,它往往能显著加快定位速度。
当然,自定义 shell 需要准备清晰的命令文档,并提供给 AI 学习。否则,即使 AI 能够连接终端,也不知道每条命令的用途、参数和返回值含义。
对 AI 调试来说,终端的意义又多了一层:它相当于 AI 的“手”。
没有终端,AI 只能根据日志进行推测;有了终端,就可以导出十六进制报文、任务状态、寄存器 dump、设备信息等数据,直接交给 AI 分析。甚至一些用于排查问题的终端命令,也可以让 AI 根据目标自动生成。
例如,调试通信问题时,终端抓回来的原始报文通常是一串十六进制数据。人工逐字节对照协议拆解,既费时间,也容易遗漏。将终端导出的 hex 帧与协议文档或帧格式描述一起交给 AI,它可以协助完成字段拆分、规律识别和异常帧筛选。
协议逆向也可以采用类似思路。以前购买某些模块后,如果资料遗失,通常只能依靠调试工具抓取协议报文,再人工分析。现在可以让 AI 根据多组报文推断协议的基本结构和字段规律,但推断结果仍然需要通过更多数据和实际设备行为进行验证。
有些产品结构密封,没有对外暴露物理接口,这时可以考虑提供无线终端,例如 BLE 透传、Wi-Fi 连接 telnet,或者实现一套自定义协议。设备出现问题时,通过手机或其他终端连接设备,就能查看现场状态。
3. 调试探针
J-Link、ST-Link 这类调试接口,是嵌入式系统中数据密度很高的入口。通过 RTT、SWO、寄存器、内存和变量等调试能力,可以获取更加完整、实时、侵入性较低的现场信息。
开发阶段能够接入调试器,相当于给 AI 增加了一套深入观察系统状态的工具。它不仅可以辅助分析日志和终端输出,还能在任意位置设置断点,并通过条件断点或条件监控暂停程序。
HardFault 排查就是典型场景。将 PC、LR、PSR、SP、反汇编输出,以及通过 addr2line 或 objdump 得到的信息,再配合 map 符号表交给 AI,它可以协助完成以下工作:
- 判断 PC 当前落在哪个函数;
- 分析 LR 可能对应的调用者;
- 梳理栈的大致状态;
- 还原可能的调用链;
- 对照代码寻找越界写、野指针等可疑位置;
- 给出下一步验证方法。
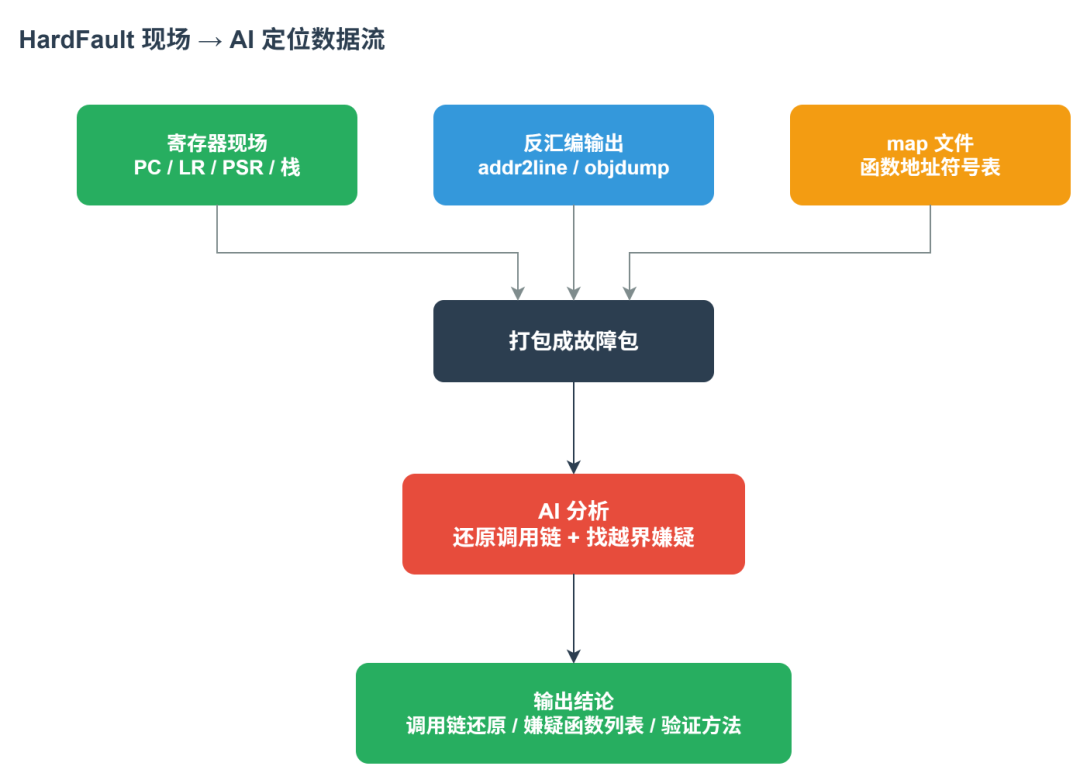
过去遇到这类问题,通常需要人工一步步查看函数调用栈。如果寄存器数据填写错误,后续推导可能全部失效。现在,AI 能够在整理现场数据、还原调用链和生成排查思路方面节省不少时间。一些“一键解析并定位异常代码”的工具,本质上也采用了类似的数据处理流程。
但需要注意,AI 找到的“嫌疑点”只是线索,不是最终结论。
实际使用中,AI 可能会判断错误,也可能在错误的假设上不断自洽。遇到这种情况,需要主动指出矛盾、补充新的现场信息,让它重新梳理问题。AI 分析完成后,仍然要由工程师结合实际硬件、代码和复现结果重新验证,避免把一个 bug 改成两个问题。
另外,产品级项目通常不会把调试接口长期暴露在外部。J-Link、ST-Link 这类调试方式更多适用于开发期和实验室阶段。
4. 如何把资料喂给 AI?
同一份材料,输入方式不同,AI 的输出质量也会有很大差异。下面几项可以作为嵌入式软件开发与调试时的基本方法。
4.1 上下文给全
至少应提供以下信息:
- 固件版本信息;
- 硬件平台信息;
- 故障现象;
- 复现条件;
- 已经排除的可能性;
- 相关代码;
- 必要的配置和编译信息。
输入信息的质量,通常会直接影响 AI 输出结果的质量。
4.2 日志先预处理
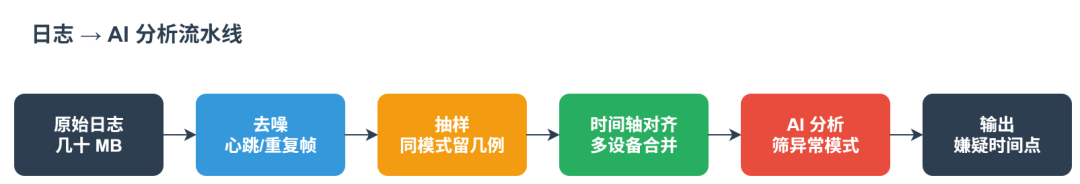
原始日志可能达到几十 MB,直接提交可能导致 token 超限,或者在长上下文中被截断。更合理的方式是先进行预处理:
- 删除周期性心跳;
- 同一种模式的日志只保留少量代表样本;
- 按时间戳对齐多设备日志;
- 保留异常发生前后的关键上下文;
- 对不同模块和设备进行标记;
- 将重复内容和无关输出去噪。
简单来说,就是喂“精饲料”,不要直接喂“粗饲料”。
4.3 分步引导
一次让 AI 完成一件事,通常比一次提交一个巨大的任务更稳定。可以按照下面的顺序推进:
- 先分类:这属于什么类型的问题?
- 再定位:最可疑的位置在哪里?
- 后验证:如何设计验证步骤?
目前在实际使用中,大任务并不总能得到理想结果。可以使用类似下面的模板,将故障信息拆开提交:
【故障排查请求】

硬件平台:
固件版本:
故障现象:
复现条件:
已排除:

请分析:
1.
2.
3.

【日志】
(已去噪,心跳帧已删除)
<粘贴日志>

【相关代码】
<粘贴可疑模块代码>
这种方式可以让 AI 先建立问题边界,再逐步深入,不容易在一开始就陷入无关细节。
4.4 警惕幻觉
使用过 AI 的人都知道,AI 出现错误判断并不罕见。长上下文被压缩后,部分关键信息可能无法继续保持一致。如果不及时确认中间结果,也没有设置纠偏机制,后续分析可能会越来越偏离真实情况,同时持续消耗 token。
因此,比较稳妥的做法是:
- 对 AI 提取出的事实逐项确认;
- 区分“原始数据”和“AI 推断”;
- 要求 AI 明确说明判断依据;
- 对关键结论设计实际验证步骤;
- 发现前提错误时,及时让 AI 重新分析;
- 不要直接把 AI 生成的修复代码合入产品。
AI 可以帮助工程师缩短信息整理和初步定位的时间,但不能替代硬件验证、代码审查和回归测试。
最后
有了 AI 之后,开发和调试效率确实提高了。但效率提升并不意味着工程师可以完全放手。日志、终端和调试探针提供的是更完整的现场,结构化的输入则决定了 AI 能否正确理解现场。
真正有效的做法,是把 AI 接入已有的调试流程:
- 用结构化日志记录完整上下文;
- 用终端提供运行时状态;
- 用调试探针获取寄存器、内存和调用链;
- 用预处理后的数据降低噪声;
- 用分步任务控制分析过程;
- 用工程验证确认最终结论。
AI 能够帮助你更快发现问题,但最终是否修复正确,仍然取决于对系统、硬件和代码的理解。
 发表于 8 小时前
|
查看: 2|
回复: 0
 /1


