做嵌入式单片机开发,基本绕不开通信交互和数据存储。设备要跟上位机、服务器交换数据,数据格式怎么定,就成了很多人反复纠结的问题。这里要同时考虑通用性、兼容性和可靠性。
JSON 调试确实方便,但通信压力一大,它的体积和解析开销就显得吃力。有没有更高效的格式?
不少人早期的做法是自己设计一套二进制协议。这样省资源,但一旦要和别的终端互通,字段定义、字节序、版本兼容都得重新考虑一遍,维护起来很麻烦。
我的经验是,通用的技术方案要往上层看。上位机、后端的同事平时怎么解决这类问题?把他们方案里你需要的部分留下,不需要的部分弱化,让它适配嵌入式场景,这就是一个不错的方案。
应用层用得最多的是 protobuf,业内常简称为 "pb"。它由 Google 出品,跨语言、编码紧凑、性能好,是业界标准,与 gRPC 也是绝配。问题在于它偏重,官方也不直接支持 C,只能用 C 去调用 C++ 实现。既然有需求,就有人给出了解法,这就是 Nanopb。现在的 MCU 性能已经很强,跑 Nanopb 完全没有压力。
1. 官方 protobuf 为什么在 MCU 上跑不动
protobuf 本质上是一套结构化数据的二进制序列化方案。.proto 文件是通信协议规范,protoc 编译器根据它生成代码。业务层只需要提供相应的数据结构并处理接口,序列化和反序列化由底层自动完成。
syntax = "proto3";

message Person {
  string name = 1;
  int32  age  = 2;
}
pb 体积小、速度快,靠的是用字段编号代替字段名。传输的数据里不存 "name"、"age" 这些字符串,只存编号,所以自然紧凑。
这套机制本身没有问题。只是官方库的主要使用场景是服务器和 PC,在资源受限的平台上用得少,也就没有投入去适配。它在 MCU 上的障碍主要有两个。
内存靠堆。 C++、Java 等语言标准库里的消息对象、字符串、数组,都在堆上通过 new / malloc 分配,生命周期还要靠 RAII、智能指针管理。裸机 MCU 要么没有堆,要么堆小得可怜,对堆碎片又敏感,这条路直接走不通。
体积太大。 C++ 版会生成一堆类、虚函数、反射和调试字符串,合计几百 KB,MCU 的 Flash 根本装不下。
所以 protobuf 本身是好东西,但官方库是为服务器和 PC 准备的。
2. 为嵌入式而生的 Nanopb
Nanopb 是 Petteri Aimonen 发起的开源项目,采用 zlib 许可。官方定位很明确:面向微控制器和内存受限系统的轻量级 ANSI C 实现。它从 2011 年开始发展,维护至今,是嵌入式领域最常用的 protobuf 实现之一。源码和生成器都在 GitHub 上:https://github.com/nanopb/nanopb 。
Nanopb 保证 wire format 与标准 protobuf 完全一致。被砍掉的都是实现层面的东西,协议层面没有变化。
默认零 malloc。 Nanopb 生成的消息结构体就是普通的 C struct,字符串和数组都是固定大小的数组,内存占用在编译期就已确定。消息对象可以放在栈上、全局区或静态内存池里,没有运行时碎片,也没有内存泄漏。真需要动态分配时,可以打开 PB_ENABLE_MALLOC 开关,但它默认是关闭的。
极简 C。 生成的内容是简单结构体加几个编解码函数,没有类、虚函数、RTTI 和异常。除了 stdint.h、stdbool.h 这类基础头文件,它不依赖标准库。整个运行时库编译后,大约在几 KB 到十几 KB 的量级。
如果觉得还是大,还可以在编译时用宏裁剪功能:
PB_NO_ERRMSG:去掉错误字符串,节省 Flash。PB_BUFFER_ONLY:禁用自定义流式回调,只使用内存缓冲,能省一点代码。PB_FIELD_16BIT:为字段数量特别多的消息预留,普通消息用默认配置就够了。
具体怎么选,按你的 MCU 资源来定。
3. 用 max_size 和 max_count 控制内存
我觉得这是 Nanopb 最有意思的地方。标准库里的 repeated 字段和字符串可以无限长,因为用的是动态内存,编译期并不知道会占多大。
而 Nanopb 作为嵌入式场景下的利器,资源有限,不能这么放任。它要求你在 .proto 里明确指定上限,这就是 max_size 和 max_count 选项:
syntax = "proto3";

message SensorData {
  uint32 timestamp        = 1;
  float  temperature      = 2;
  string device_id        = 3 [(nanopb).max_size  = 16];
  repeated uint32 samples = 4 [(nanopb).max_count = 10];
}
生成出来的结构体大致如下:
/******************************************
 * Function: SensorData (nanopb 生成)
 ******************************************/
typedef struct _SensorData {
    uint32_t  timestamp;       /* 字段1 */
    float     temperature;     /* 字段2 */
    char      device_id[16];   /* 字段3,固定16字节 */
    pb_size_t samples_count;   /* 字段4,当前有效元素个数 */
    uint32_t  samples[10];     /* 字段4,固定10个元素 */
} SensorData;
device_id 就是 char[16],samples 就是 uint32_t[10]。板上 RAM 有多大、每个字段占多少,编译期一清二楚。如果多个消息共用同一套限制,还可以用 .options 文件统一配置,不必每个字段都写一遍。
那遇到特别大的字段怎么办?比如要下发一个几 MB 的固件镜像,总不能开一个几 MB 的数组。这时可以用回调,把字段类型设成 FT_CALLBACK,编解码时分块处理:从 Flash 读一块发一块,边收边写,内存始终只占一小块。这就是 Nanopb 的流式处理能力。pb_encode_delimited / pb_decode_delimited 配合串口、TCP 这类流式传输,可以一条接一条地连续发送消息。这部分属于进阶内容,篇幅有限,这里不展开。
4. pb 的兼容性为什么好
pb 的兼容性值得专门讲讲。兼容性好,协议变更就方便,这也是很多工程师宁可牺牲一点资源也要用它的原因。它的基础是字段编号加上同构的 wire format。
字段编号机制带来向前、向后兼容。
这里的字段编号,其实就是我之前聊过的 TLV 中的 tag 字段,可以参考这篇:嵌入式自定义协议都按 TLV 格式封装吧~
- 新增字段时,旧代码读到不认识的新字段会直接跳过。
- 删除字段时,新代码读到旧数据,缺失的字段用默认值顶上。
所以字段编号对兼容性极其重要:已经部署过的编号,千万不要改。 废弃的字段,用 reserved 把编号占住。有了这套机制,固件升级后消息格式变了,老设备照样能和新设备通信。
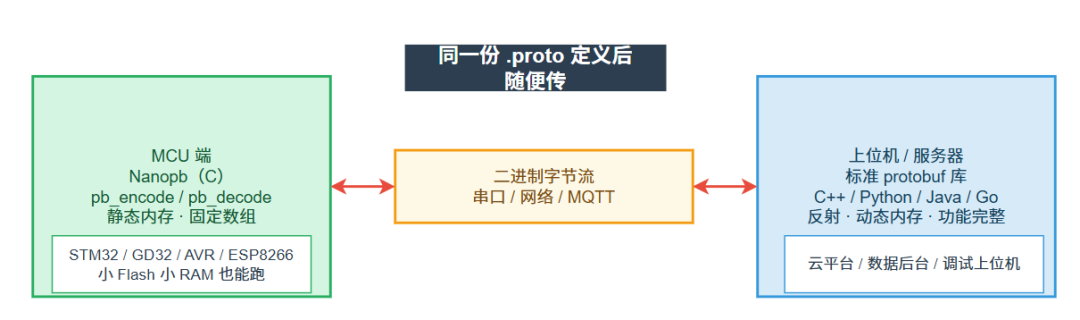
与标准库的字节流完全互通。 Nanopb 编出来的二进制,与 C++、Java、Python、Go 官方库编出来的完全一样。MCU 端用 Nanopb 编码的数据,服务器端用标准库就能解码,反过来也一样。两边共享同一份 .proto,各用各的实现,字节流一碰就通。
5. 使用流程与编解码示例
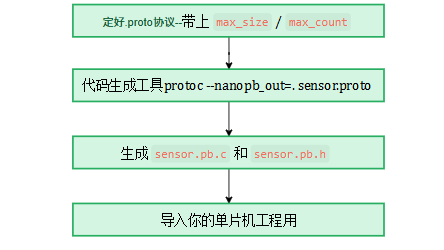
Nanopb 用起来很简单,整体流程如下:先写好 .proto 并带上 max_size / max_count,再用 protoc --nanopb_out=. sensor.proto 生成 sensor.pb.c 和 sensor.pb.h,最后把这两个文件导入单片机工程即可。熟悉之后,你大概不会再想手写二进制解析了。
最终的编解码只需要两个函数,下面是示例:
/******************************************
 * Function: SendSensorData / ParseSensorData
 ******************************************/
static uint8_t tx_buffer[64];

/* 编码:填充结构体 -> pb_encode -> 发出去 */
bool SendSensorData(void)
{
    SensorData msg;

    msg.timestamp   = 1723680000U;
    msg.temperature = 25.6f;
    strncpy(msg.device_id, "sensor-01", sizeof(msg.device_id) - 1);
    msg.samples_count = 5;
    for (pb_size_t i = 0; i < msg.samples_count; i++)
    {
        msg.samples[i] = i * 10;
    }

    pb_ostream_t stream = pb_ostream_from_buffer(tx_buffer, sizeof(tx_buffer));
    if (!pb_encode(&stream, SensorData_fields, &msg))
    {
        /* 编码失败,stream.errmsg 里有原因 */
        return false;
    }
    /* stream.bytes_written 是实际编码长度 */
    return UartSend(tx_buffer, stream.bytes_written);
}

/* 解码:收到字节流 -> pb_decode -> 直接用结构体 */
bool ParseSensorData(const uint8_t *rx_buffer, size_t rx_len)
{
    SensorData msg;

    /* 注意:解码前务必清零,否则残留数据会误判 */
    memset(&msg, 0, sizeof(msg));

    pb_istream_t stream = pb_istream_from_buffer(rx_buffer, rx_len);
    if (!pb_decode(&stream, SensorData_fields, &msg))
    {
        /* 解码失败,多半是数据损坏或协议不一致 */
        return false;
    }
    /* 到这里 msg.temperature、msg.samples 就能直接用了 */
    return true;
}
就这两个函数,一进一出,剩下的全是结构体。回想一下你以前手写协议的过程:字节序、长度字段、校验、版本号,一堆边界条件要处理。Nanopb 把这些都替你扛了,你只需要关心业务字段。
如果想继续了解嵌入式开发和网络通信相关内容,可以到云栈社区找更多资料。
来源:作者 bug菌
 发表于 8 小时前
|
查看: 2|
回复: 0
 /1


