前两天还在为宕机道歉、给用户补偿的 DeepSeek,今天又悄悄更新了新模型 DeepSeek-V4.1-Flash-1017。
编程、推理和 Agent 能力全面升级,同时模型权重开源。
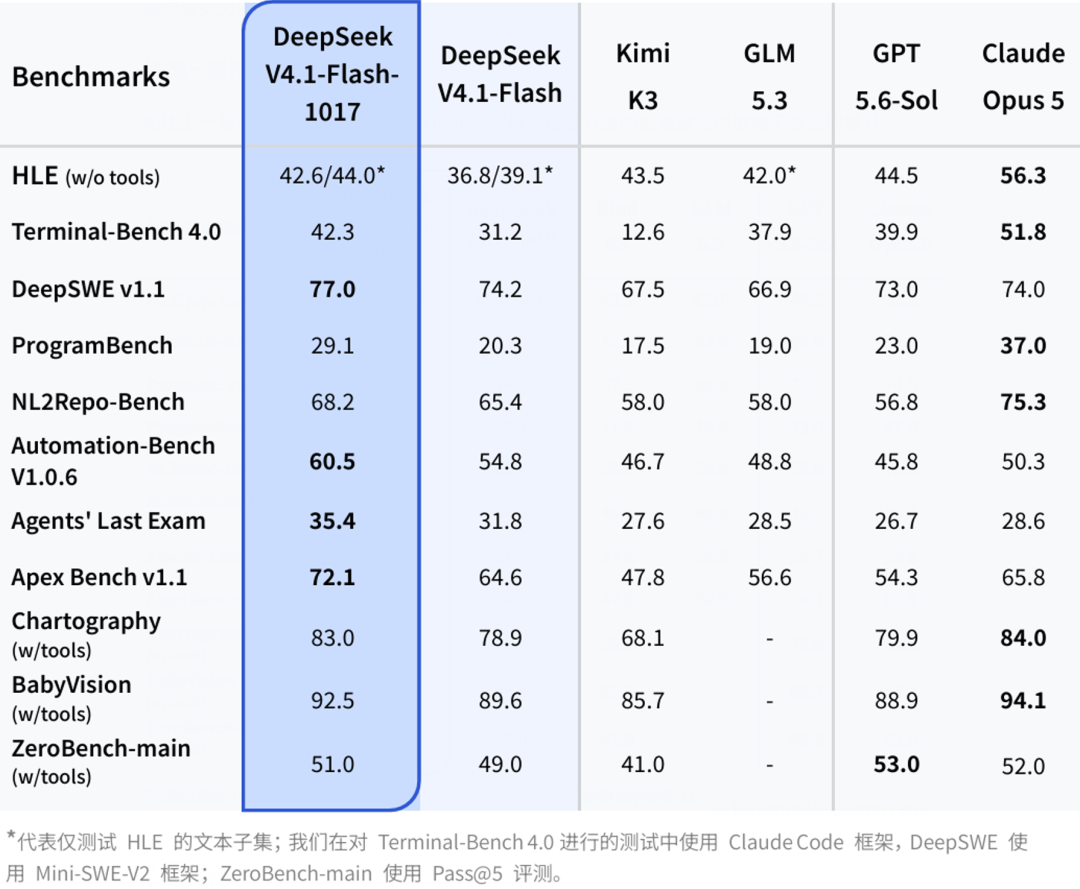
崔添翼第一时间转发官方推文,并提醒大家 DeepSeek Harness 也做了升级:为了充分发挥新模型的能力,请尽快升级到 DeepSeek Harness 0.2.1-rc.1 及以上版本。
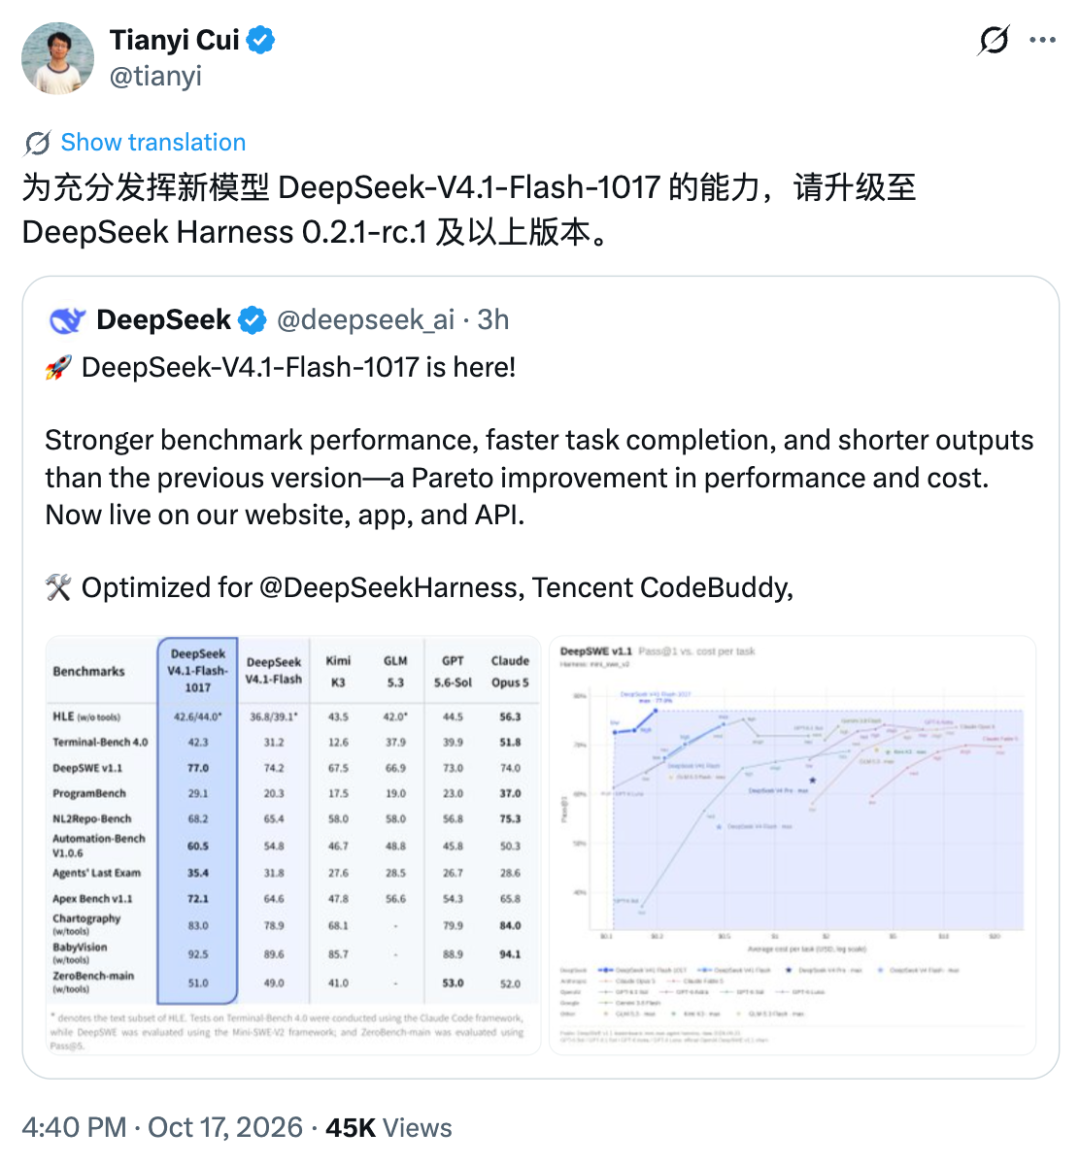
这次新模型针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等做了专门优化,升级后体验会更完整。
官方公众号推文一发出,评论区瞬间被感动刷屏。
有网友留言:“我就是知道,你那天挂机就是背着我们偷偷进步。太上进了。”另一条高赞评论直接说:“进步还返钱,真是受不了。”点赞都破了千。
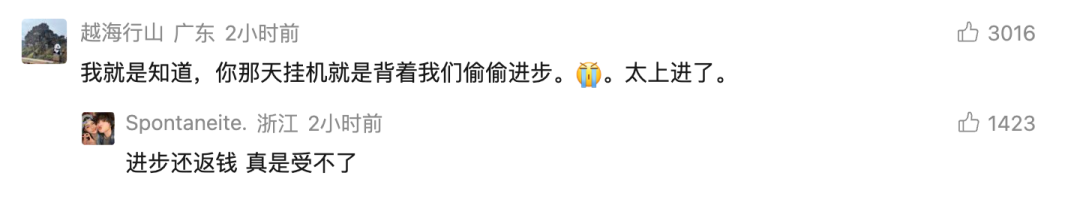
大家一边调侃“偷进步”,一边觉得这种操作太有诚意了。
有海外用户实测,DeepSeek-V4.1-Flash-1017 能跑到 244 tokens per second,个别测试接近 300 tokens/s。这个速度甚至超过了 GPT 6.1 Sol 的 Ultrafast 模式,同时智能水平能对标 GPT 5.6 Sol。用户直言:“搞不懂他们怎么能在这么低的价格下提供这种质量和速度。”
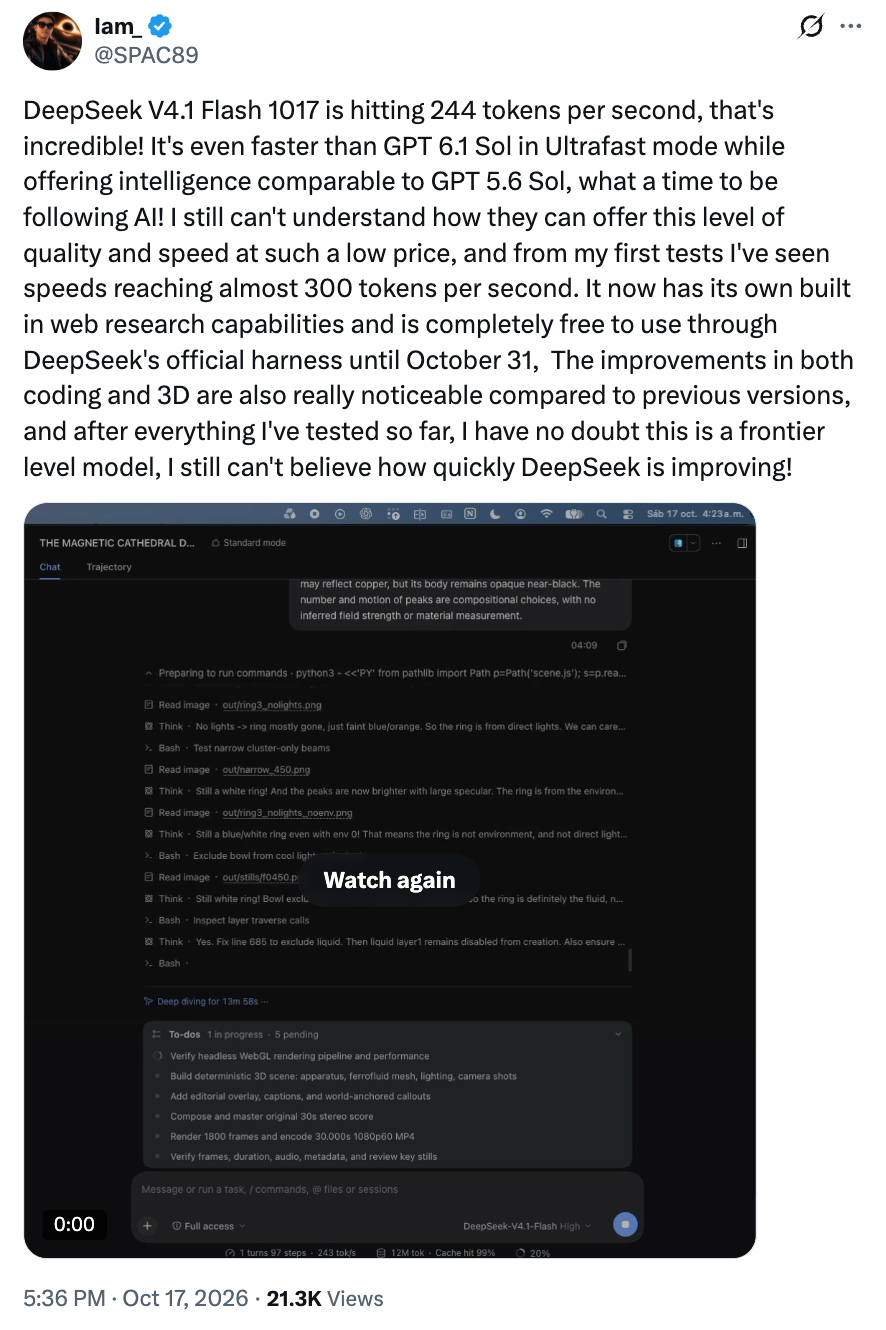
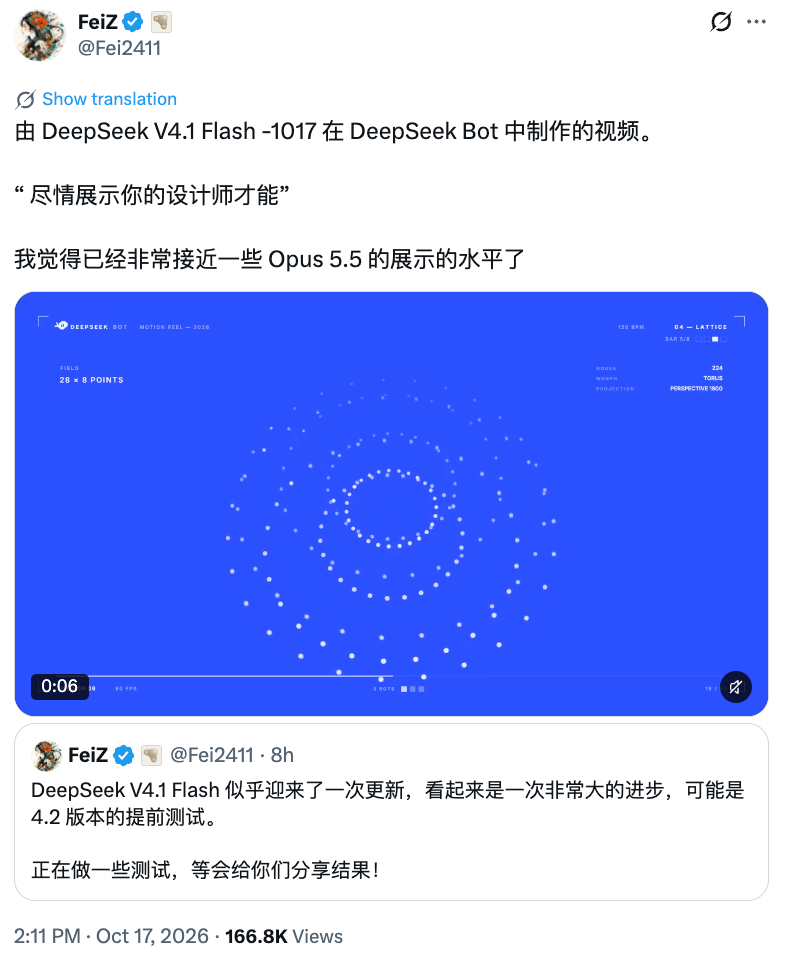
有开发者用它做视频觉得已经非常接近 Opus 5.5 的展示水平,尤其在 3D 制作、前端设计这些方向进步明显。
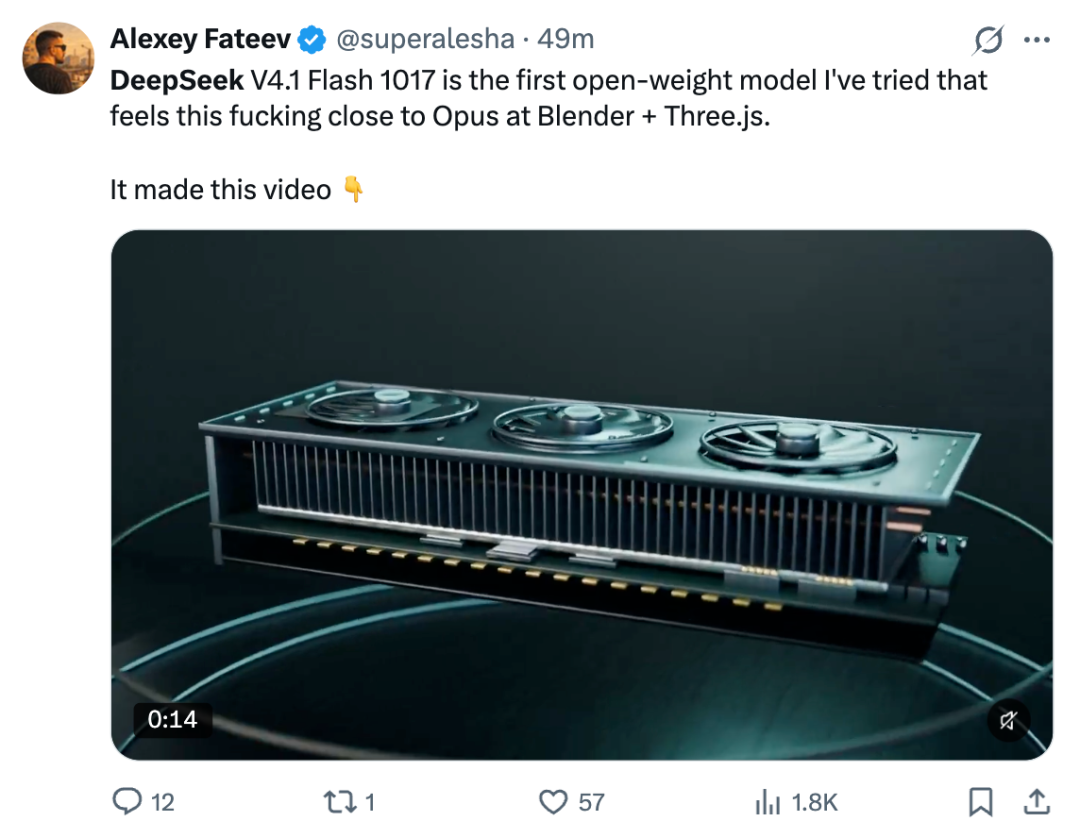
另一位用户测试 Blender + Three.js 场景后表示,这是他用过的第一个开源权重模型,感觉已经这么接近 Opus 了,生成的视频效果让人直接惊叹。
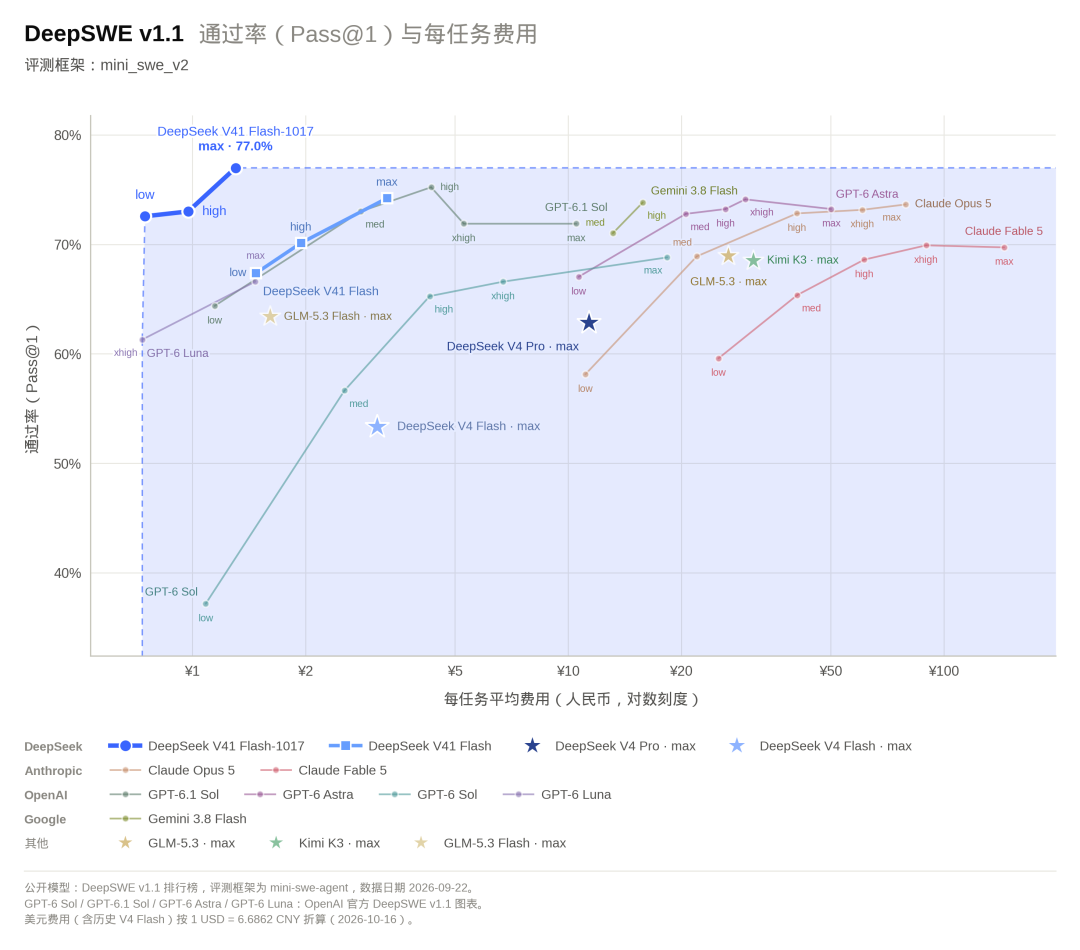
这次更新不是单纯的跑分提升。它用了基于自反馈的强化学习训练技术,强化了从零搭建完整项目的能力。游戏开发、3D 建模这些端到端场景,交互轮次更少,结果更完整。输出更短、速度更快,直接把单次任务的综合成本压了下来。对按 token 付费的人来说,这比单纯刷榜更实在。
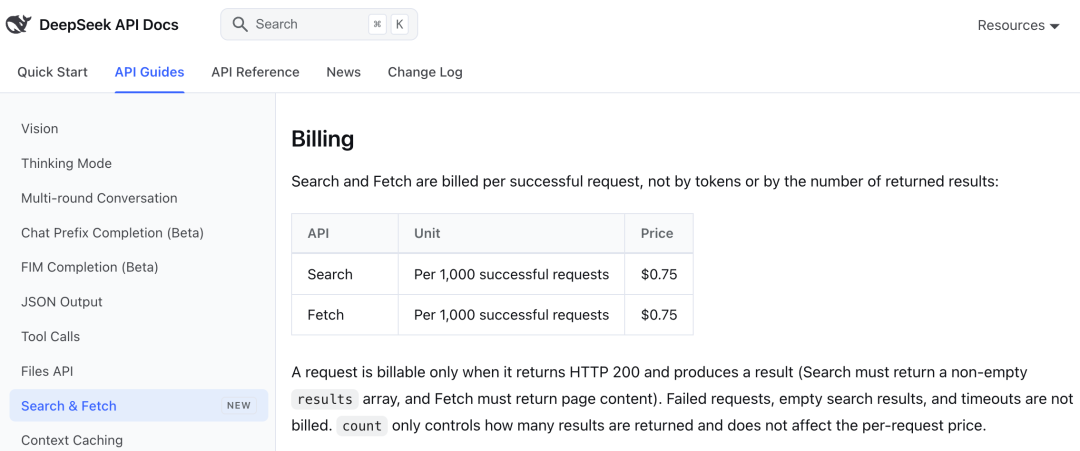
同时,DeepSeek 还把自研的 Search 和 Fetch 接口正式向所有人开放。底层是自家搜索引擎,每天服务数亿次请求。每个接口 0.75 美元/1000 次调用。通过 DeepSeek Harness、Claude Code、Codex 等服务端工具调用的话,对 DeepSeek API 用户暂时免费,10 月 31 日之后才计费。
从宕机到补偿,再到两天后上新模型并同步开源、适配 Harness,整个节奏紧凑得像在打一场组合拳。
很多人会觉得,这才是真正有长期主义的样子。
出问题不回避,用实际行动补信任,补完信任之后,立刻把产品往前推一截。不光靠嘴说自己很重视用户体验,而是用补偿、新模型、开源、工具适配四个动作,把态度落地。 |  发表于 17 小时前
|
查看: 4|
回复: 0


