“沿楼梯上去,经过正在打电话的人,再穿过卧室。”这类指令放在有人活动的环境里并不简单:打电话的人可能来回踱步,椅子旁的人需要留出空间,原本畅通的门口也可能被临时交谈的人群占据。机器人既要理解路线,还要根据眼前的变化决定怎样通过。
来自华盛顿大学、CMU、NUS 和微软研究院的研究者提出了 HA-VLN 2.0,论文已收录于 IROS 2026。这项工作将人类感知视觉语言导航(Human-Aware Vision-and-Language Navigation, HA-VLN)扩展为覆盖离散与连续环境的开放基准,把动态人物、多人互动和社会约束纳入同一研究体系。
01 一条导航指令,可以包含哪些人与事?
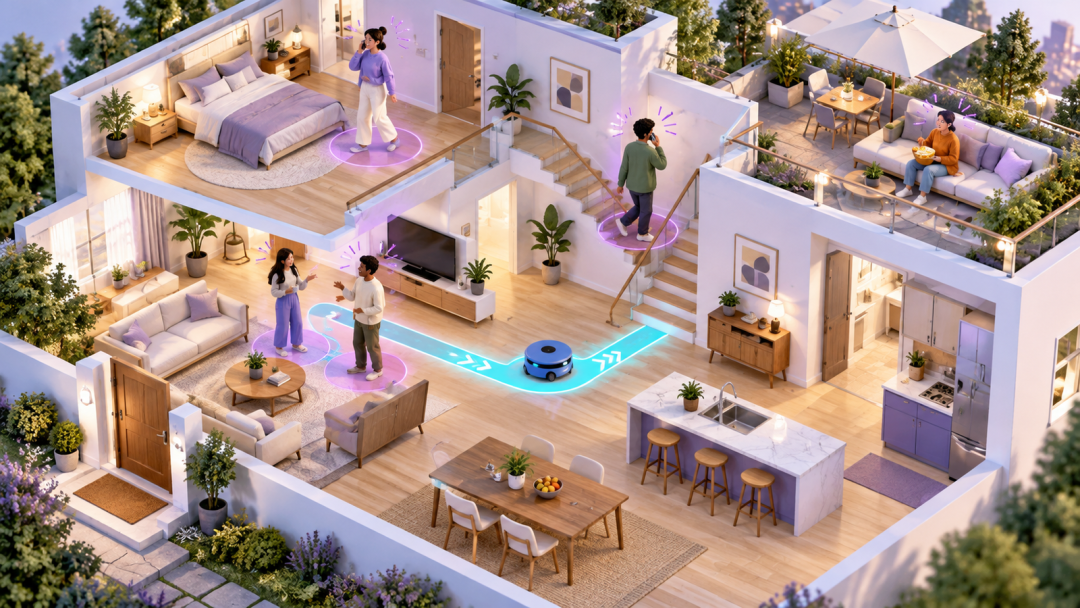
下图给出了从楼梯、卧室到屋顶的完整任务。途中既有边走边打电话的人,也有坐在椅子上吃零食的人;目的地附近还有正在交谈的两个人。人物的活动帮助机器人确认位置,同时也会改变可通行区域。对应的 RGB 与深度观测展示了机器人在几个关键位置能看到的局部信息。
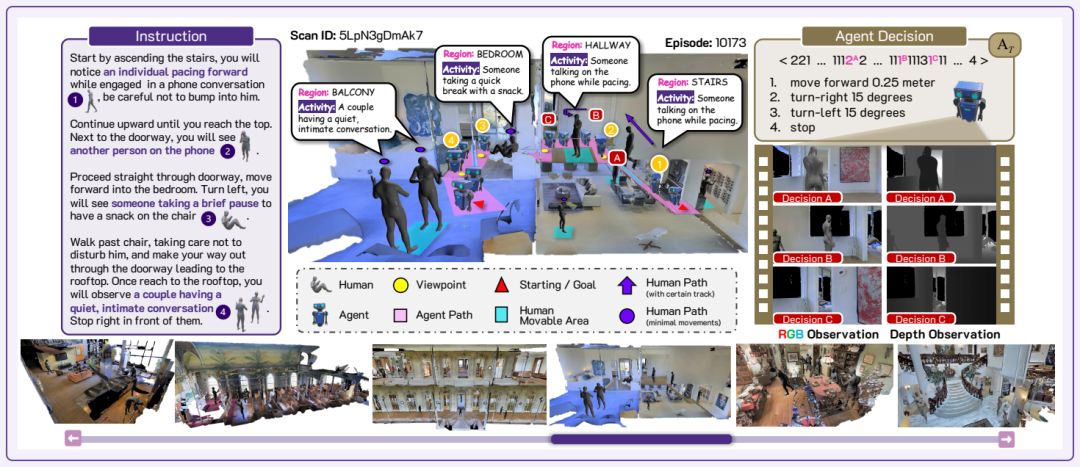
这里的语言理解涉及两层信息:“在打电话的人旁边”提供定位线索,“不要撞到他”则约束动作。人的位置还会随时间变化,因此一次识别无法替代持续观察。导航策略需要在执行过程中修正判断,而不是始终沿着最初选定的路线前进。
02 离散与连续环境,分别考察什么?
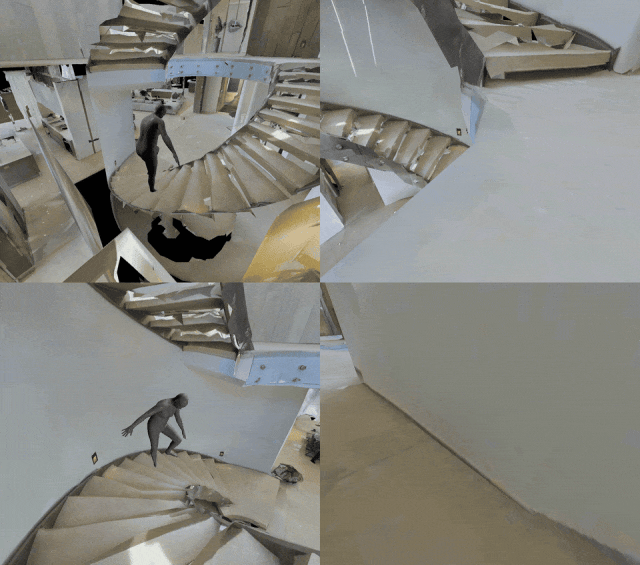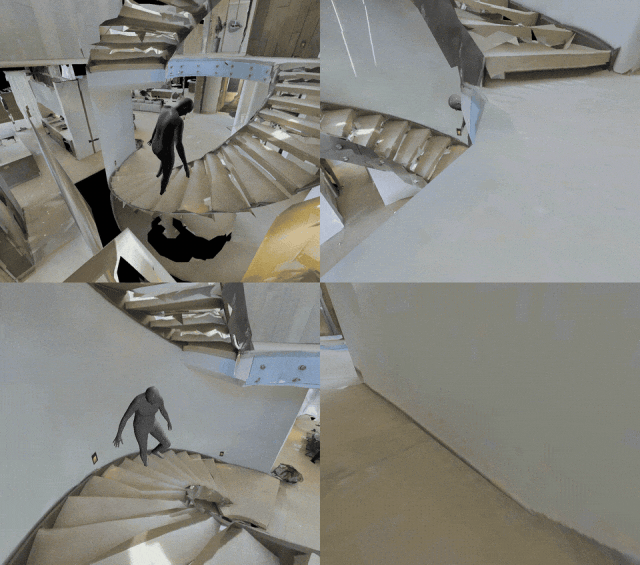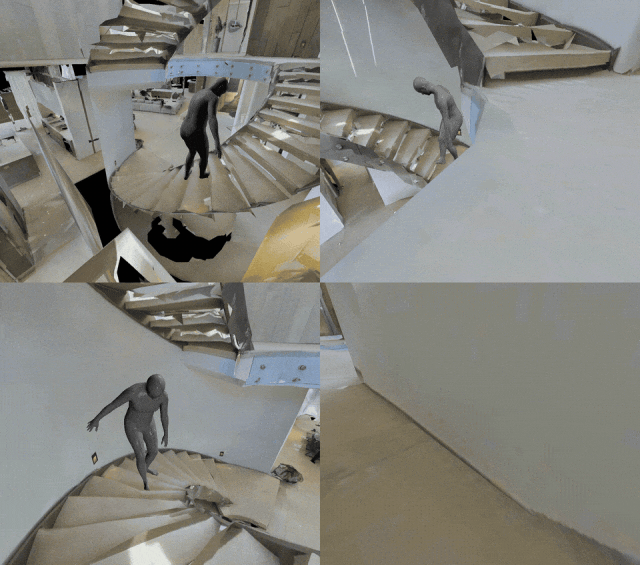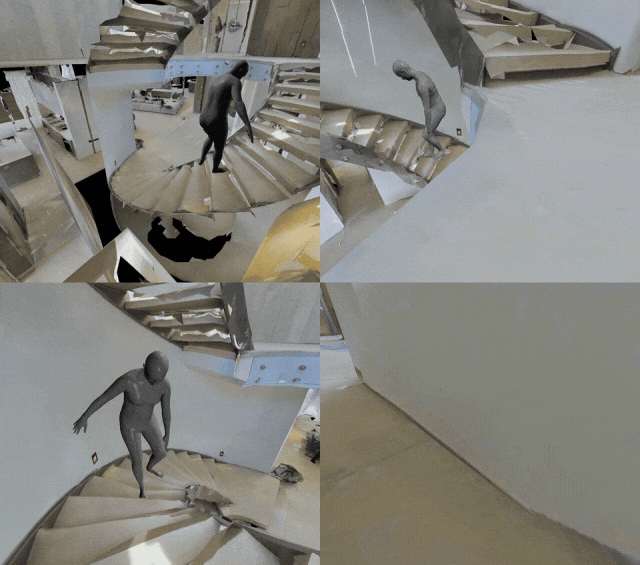
HA-VLN 2.0 同时支持离散环境(Discrete Environment, DE)和连续环境(Continuous Environment, CE)。前者在全景视点之间选择下一步,适合大规模测试;后者通过较细的前进和转向动作控制移动,更直接地暴露机器人绕行、转弯和接近行人的过程。
两种模式共享人类感知任务、数据资源和接口,但动作执行及碰撞检查仍有各自的设置。研究者需要在比较结果时说明所在环境与协议。论文也专门分析了步长和检查频率的影响,避免把更粗的视点移动带来的表面优势误读为更强的避让能力。
03 HAPS 2.0:让动作与场景相互匹配
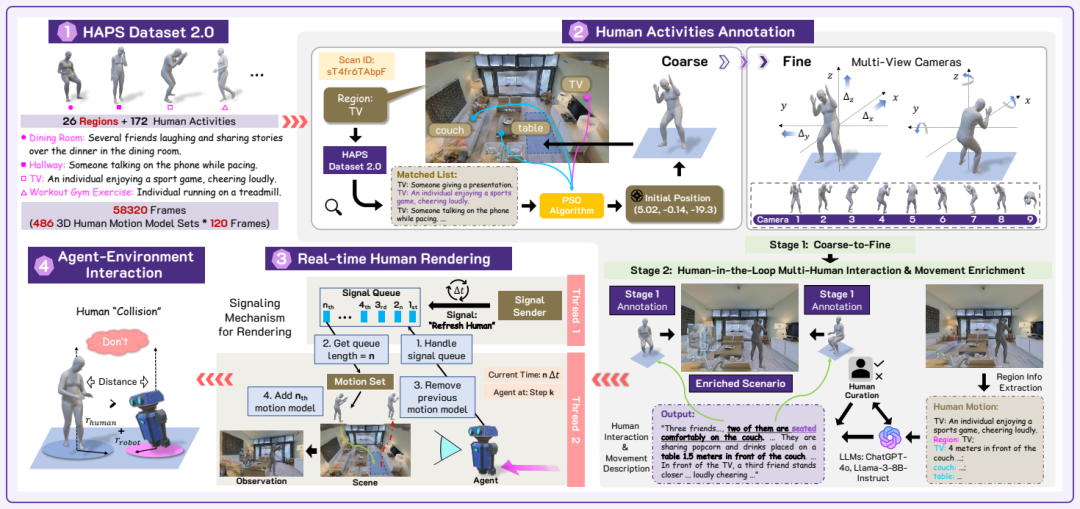
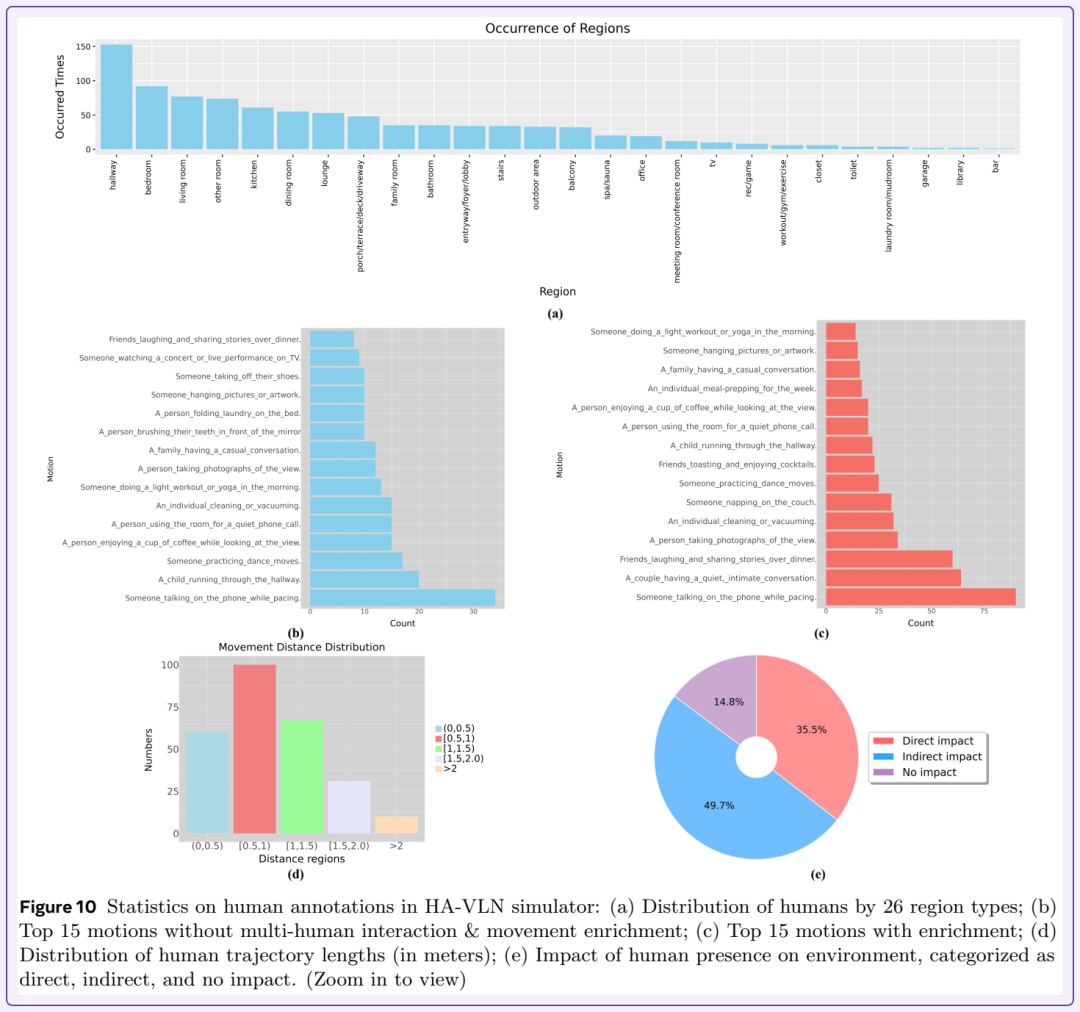
基准背后是升级后的 HAPS 2.0 人体活动资源。论文给出的核心规模为 172 类活动、486 段人体运动序列和 58,320 帧运动数据,覆盖 26 类区域。经过放置与互动扩充,场景中共形成 910 个人物标注实例,分布于 90 个建筑扫描场景的 428 个区域。
这些数字分别描述动作类别、运动序列和场景实例,不能互相替代。一个动作可以在多个地方被使用,但其与家具、地面和其他人物的关系需要重新核对。论文先通过粒子群优化(Particle Swarm Optimization, PSO)寻找粗位置,再以九个视角检查穿模、姿态和空间关系,并引入人工复核完善多人的互动。
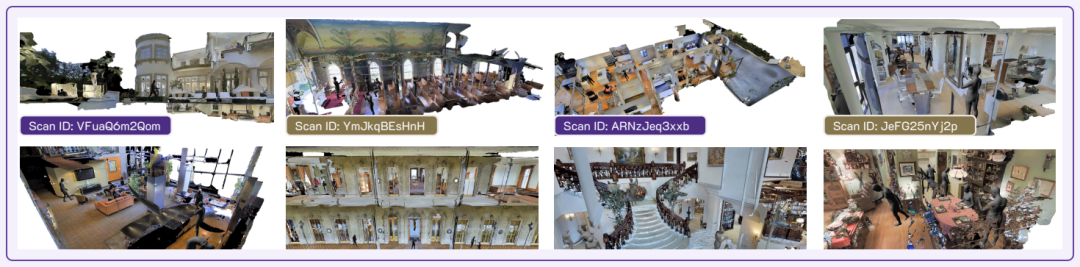
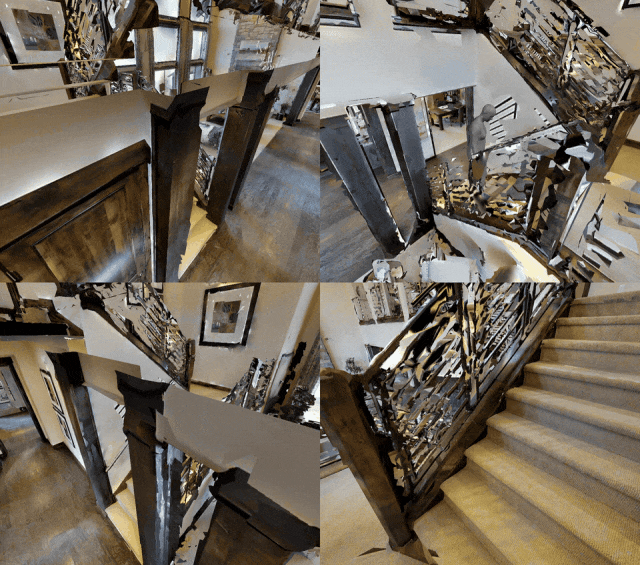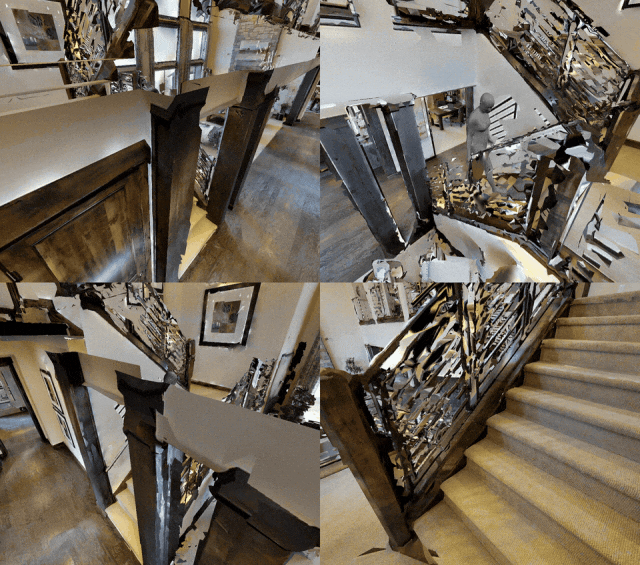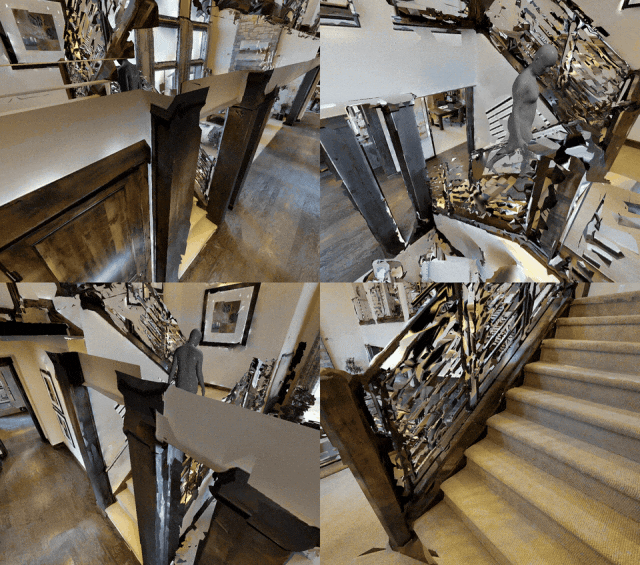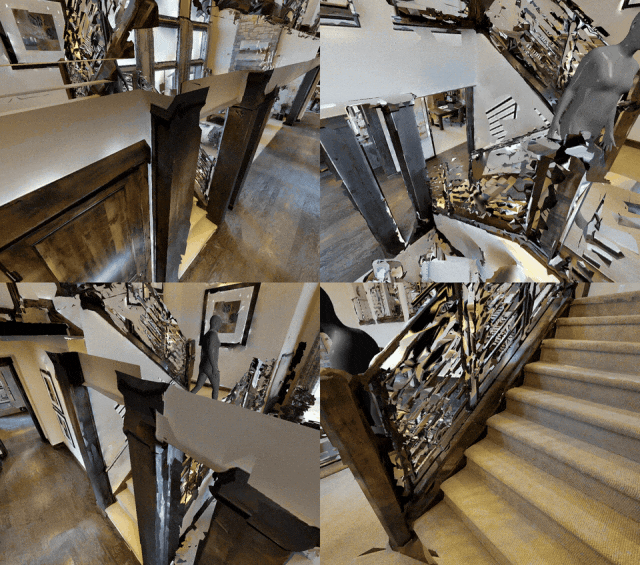
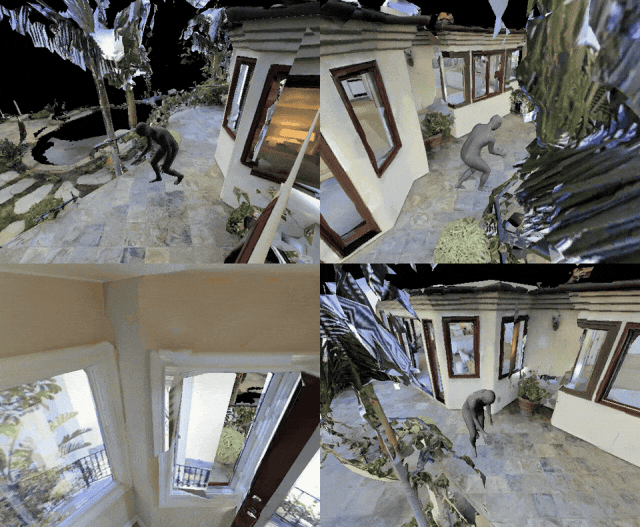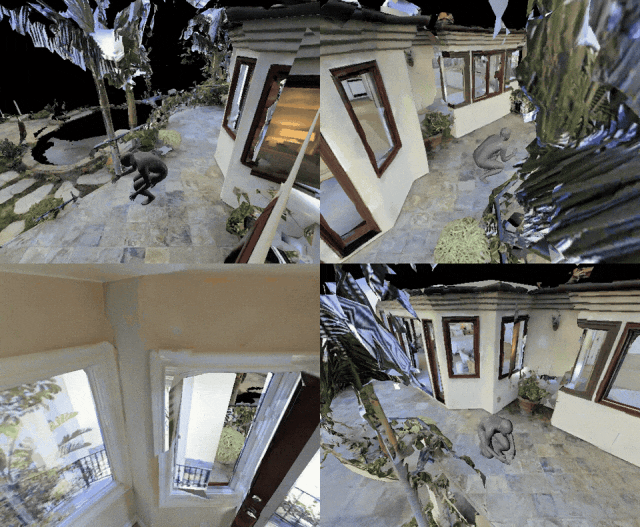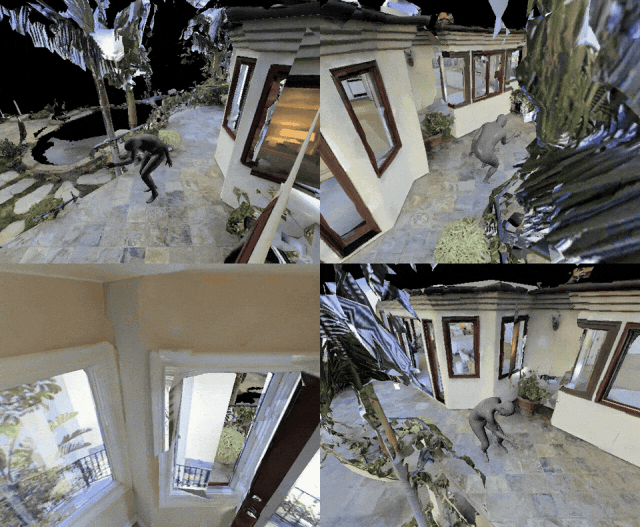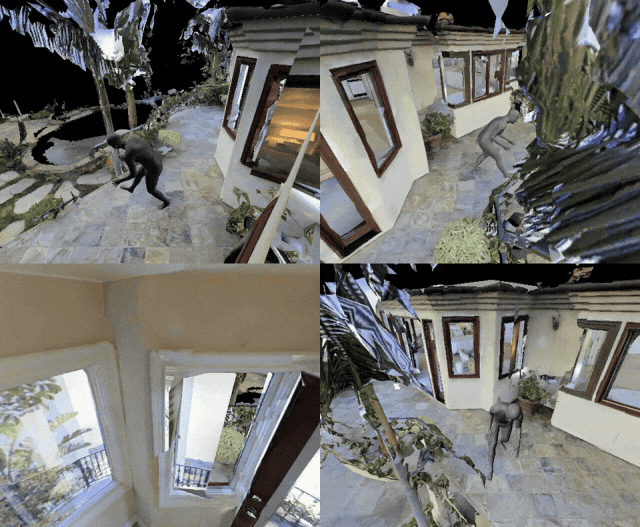
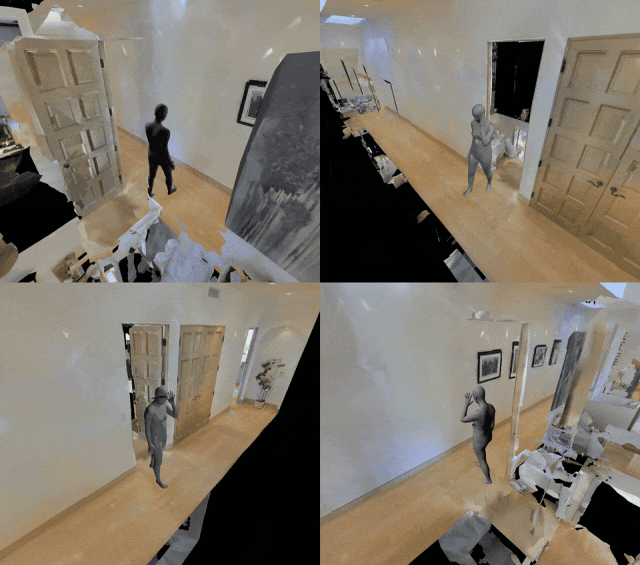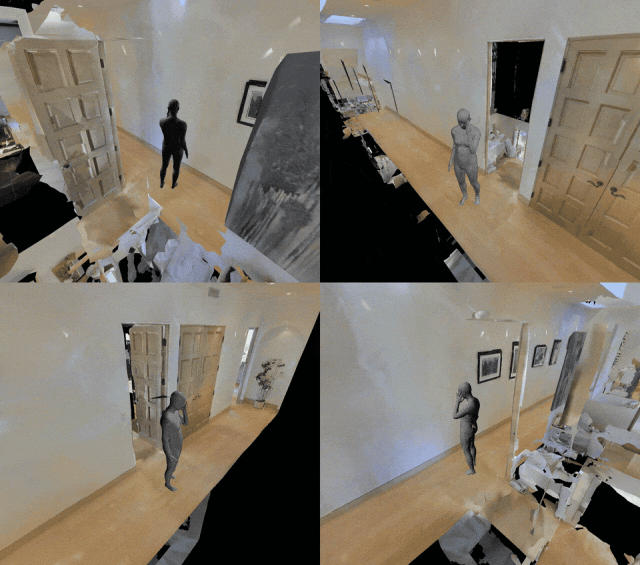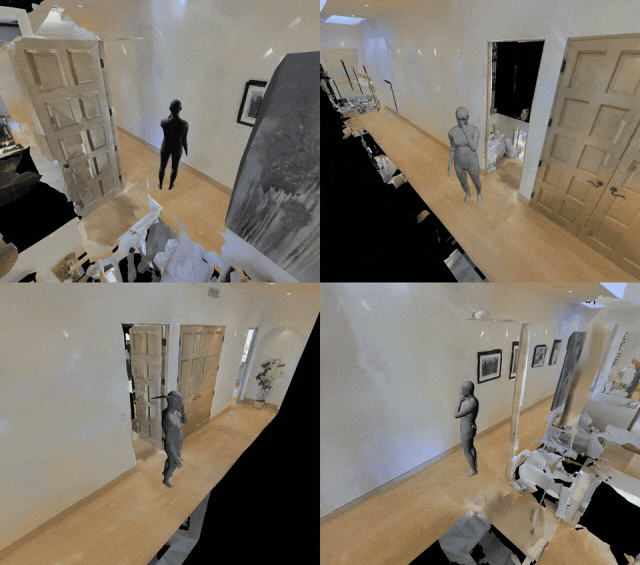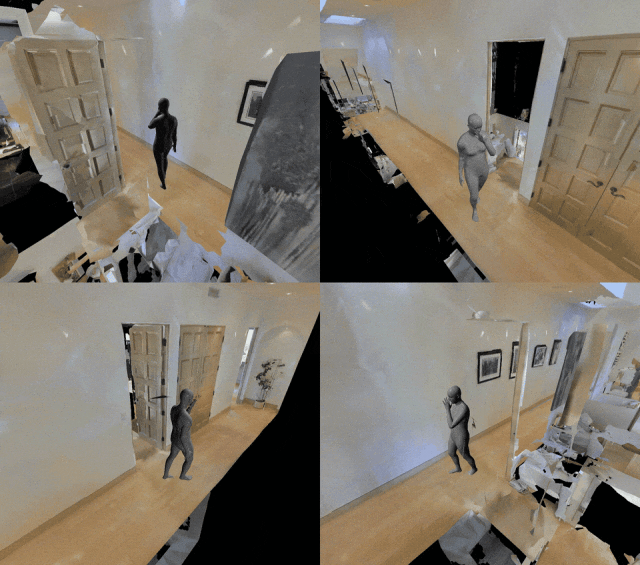
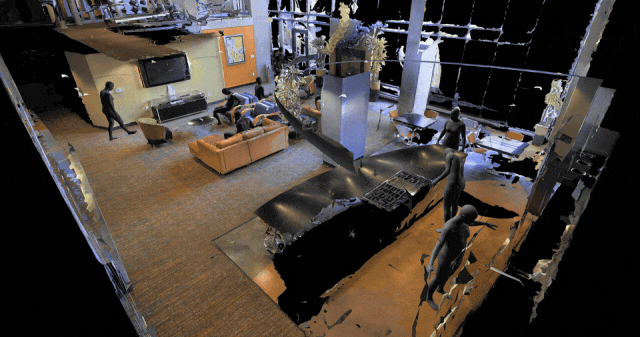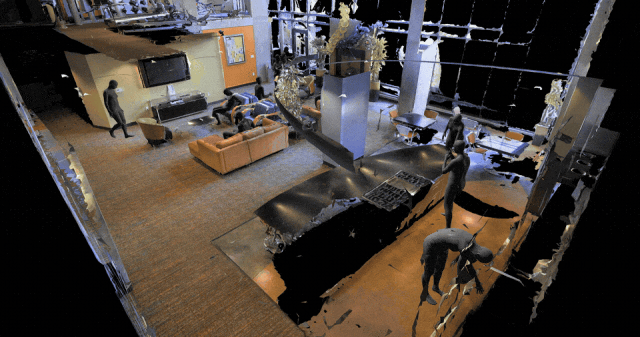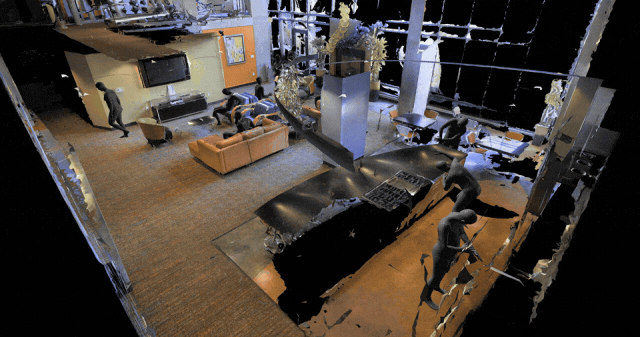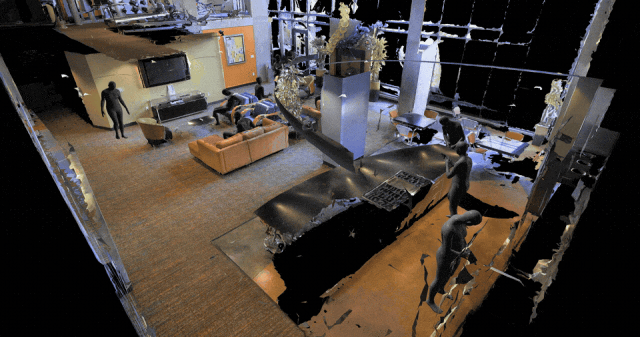
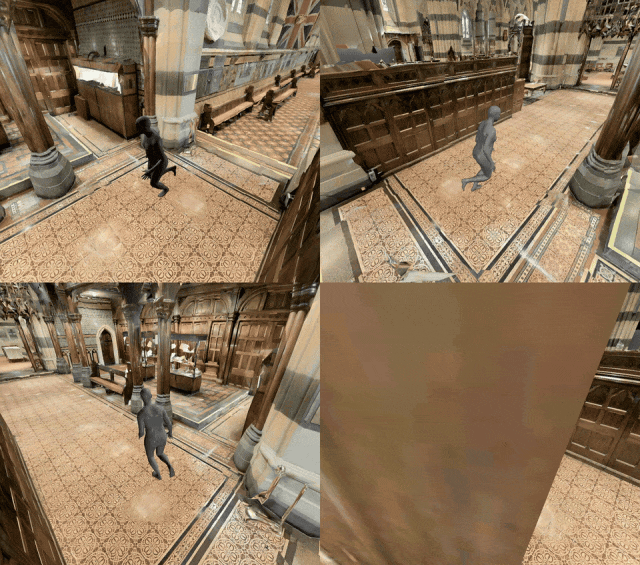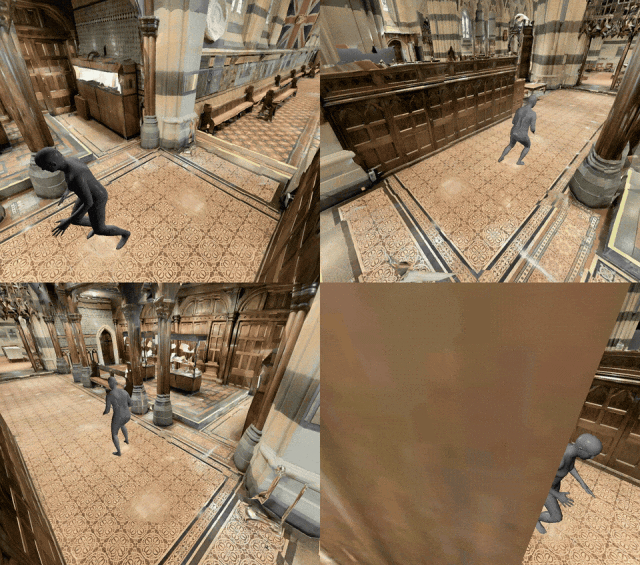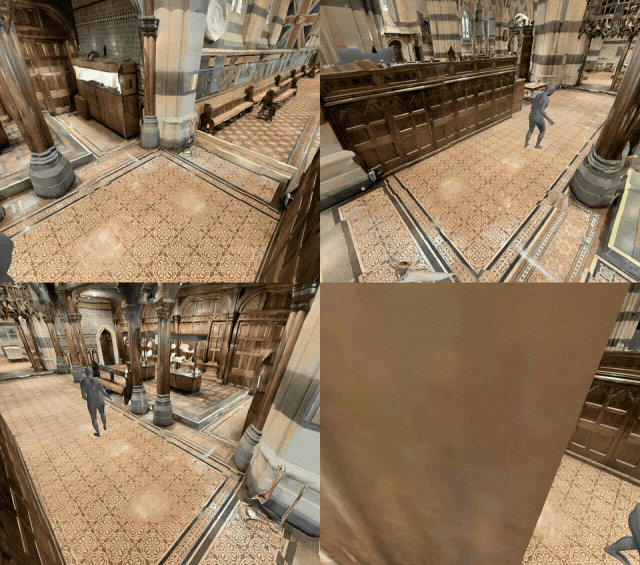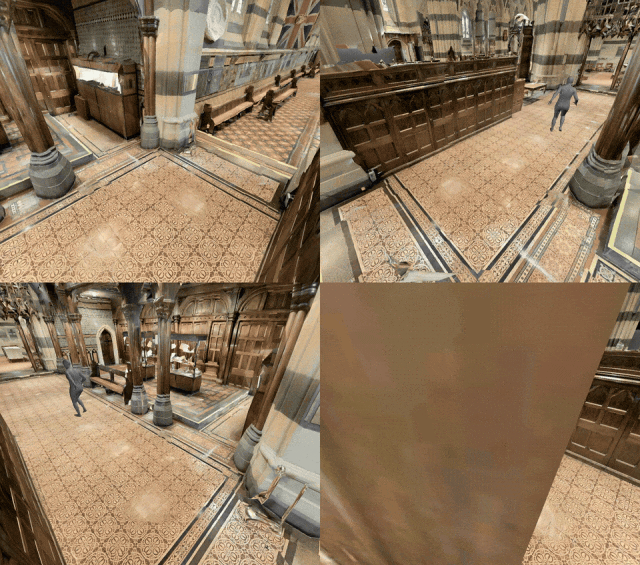
这些演示展示了室内外场景中不同的活动形态。对导航而言,正在走动、突然停下和俯身的人会造成不同的遮挡与路径变化;只给场景加入一个不会移动的障碍物,很难覆盖这些情况。
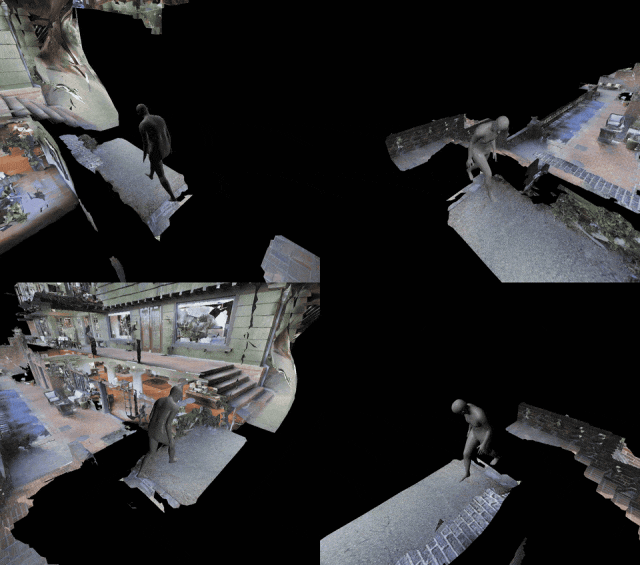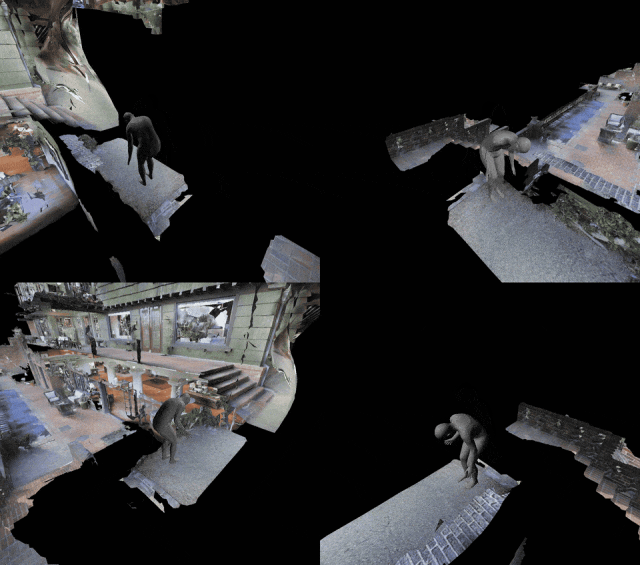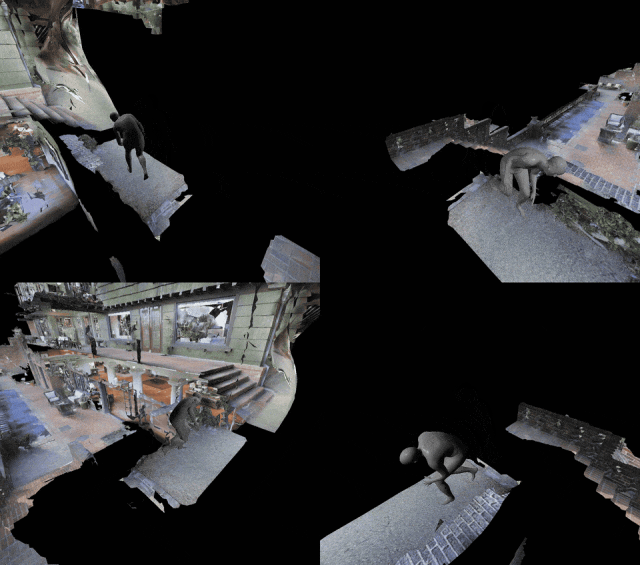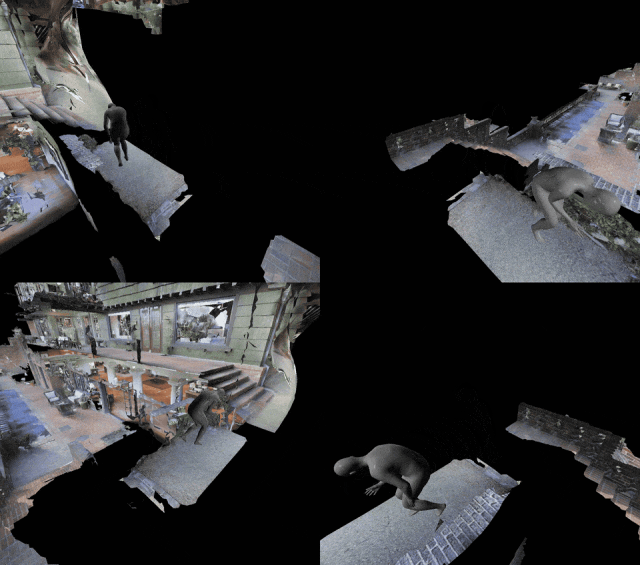
04 HA-R2R:把社会情境写进路线描述
HA-R2R 在原有路线数据基础上提供了 16,844 条经过整理的导航指令。指令通过模型辅助生成和人工迭代修订,将人的动作、群体活动和通过时的注意事项融入路线。平均指令长度从 27 个英文单词增加到 112 个,词表从 2,616 扩展到 5,032。
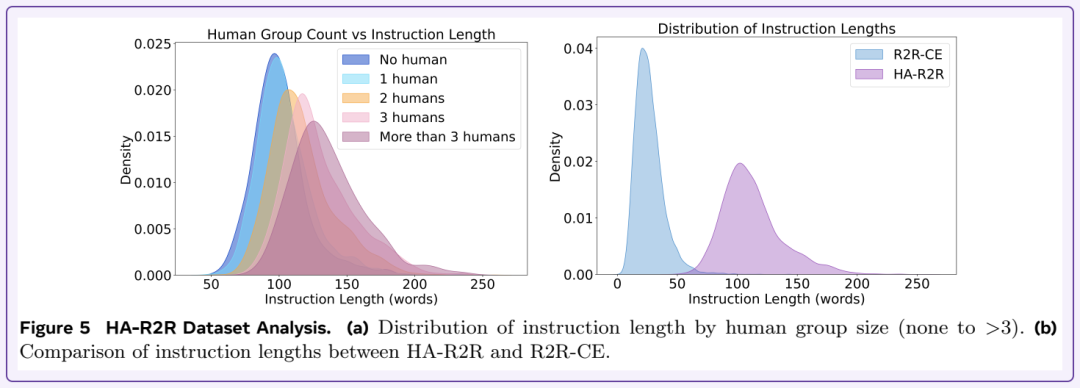
增加篇幅的作用在于补足情境。例如,客厅路线可能要求避开来回走动的通话者,不打扰聚会的人群,并在门边停下而不堵住入口。另一条路线则串联了熨衣、阅读等活动。人物描述提供了可观察的路标,也让“经过”“停下”有了更明确的行为边界。
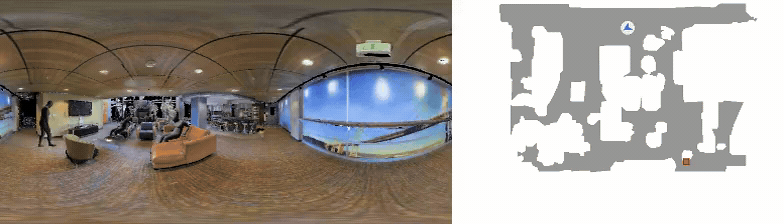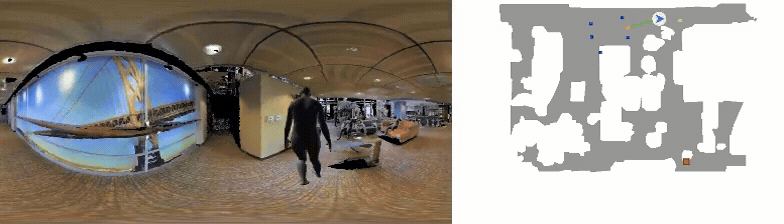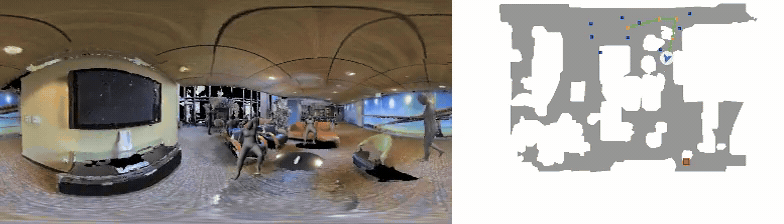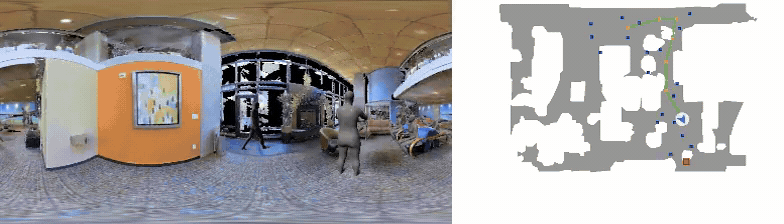
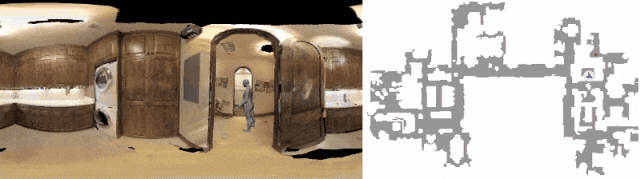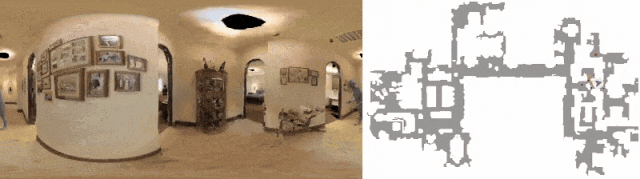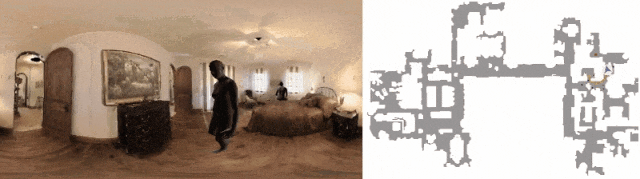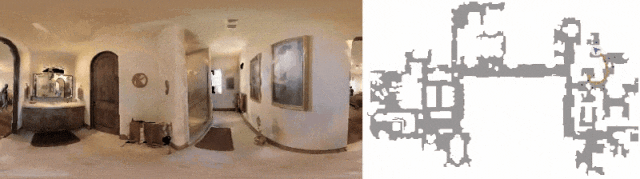
测试集包含 3,408 条指令,来自 18 个保留建筑,并强调多人路线。将建筑留出作为测试条件,有助于检查方法在新布局中的表现,而不只是对训练房间的熟悉程度。长指令中的人物线索还可能在不同阶段出现,因此模型需要保留已经执行到哪里、接下来关注谁等上下文。
导航接口提供附近人物状态查询、动态场景更新和碰撞检查。这样,研究者可以围绕相同场景开发不同策略,并单独分析语言理解、视觉感知或动作控制带来的变化。统一接口有助于复用工具,但真实执行中的视野、步长与碰撞规则仍需随实验明确报告。
05 基线、评测与真实机器人验证
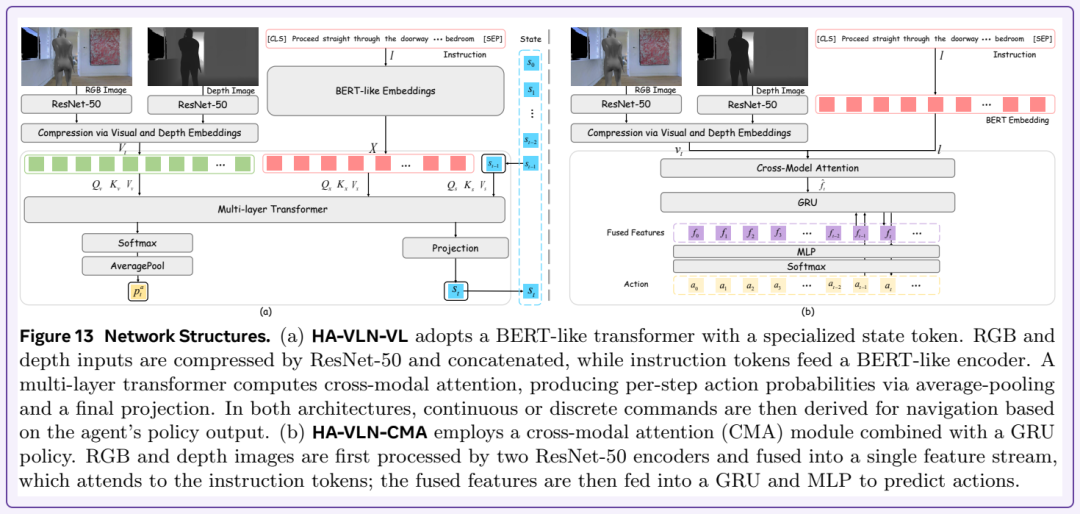
论文提供 HA-VLN-VL 与 HA-VLN-CMA 两种参考智能体:前者侧重视觉语言对齐,后者以跨模态注意力(Cross-Modal Attention, CMA)结合视觉、语言与动作历史,并通过训练策略提升对遮挡和执行偏差的适应能力。这些基线为方法比较提供起点。
在连续环境的未见场景验证集上,BEVBert 在 HA-VLN 数据上重新训练后的成功率为 0.21,直接迁移的对应结果为 0.15。这个差异表明,在训练阶段接触人物活动和社会化指令有实际价值,但也说明动态导航距离稳定完成仍有提升空间。
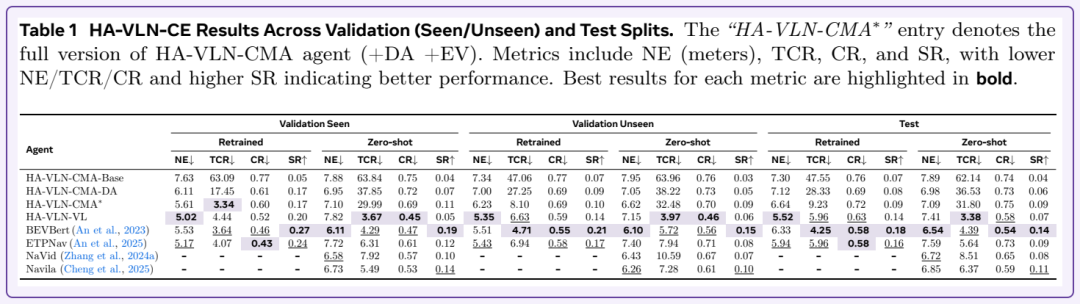
另一项重要安排是同时报告目标距离与碰撞相关指标。机器人最后离终点更近,并不一定意味着途中对人更安全。论文将导航误差、成功率与两类碰撞统计放在同一张结果表中,给读者提供了从目标完成和执行过程两方面检查方法的依据。
参考智能体的设置也便于后续研究做针对性的比较:视觉语言对齐能否更准确地定位指令中的人,加入动作历史后能否更早发现风险,遮挡增强和迭代纠错是否能改善拥挤路口的行为,都可以通过轨迹和数据切分逐项检验。这里涉及的语言理解与上下文建模问题,也正是 NLP 技术在具体机器人任务中的一次应用延伸。长指令中的人物线索分散在不同阶段,模型需要同时处理视觉、语言和时序信息,这类多模态融合策略与自然语言处理全栈体系课中讲授的预训练模型、注意力机制和上下文建模思路一脉相承。
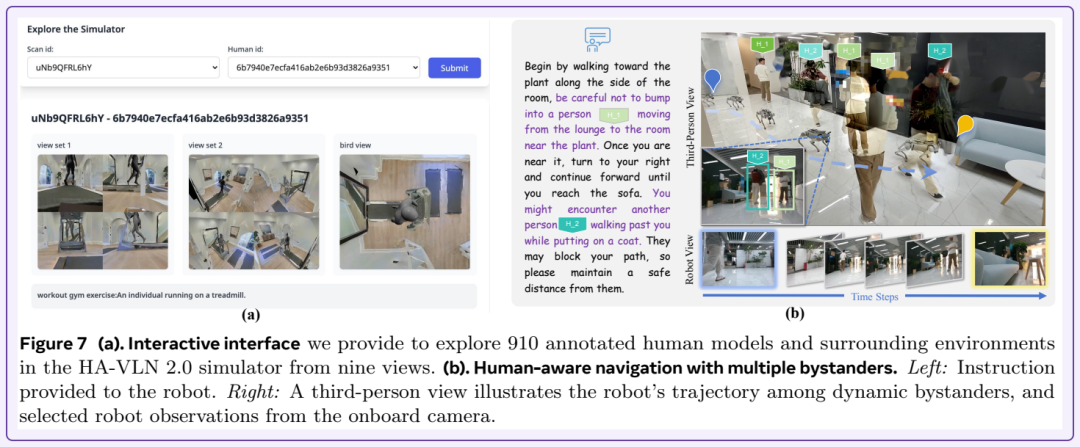
研究者还将方法放到 Unitree Go2-EDU 四足机器人上,在办公室、客厅、走廊和大厅中验证。下图同时呈现了用于检查场景的交互界面和真实机器人绕过行人的过程。公开的数据、模拟器、基线与评测接口,使后续工作能够围绕同一问题逐项改进:听懂带有人类活动的指令,在动态场景中选择合适路线,并在到达目标时尽量减少对人的干扰。
HA-VLN 2.0 把“人”放回了视觉语言导航的评估核心。后续研究者不需要从零搭建环境就能展开对比实验,无论是离散还是连续设置,都能在统一接口下观察模型如何应对动态人物与社会约束。这类把学术基准与真实机器人验证结合的工作,在云栈社区也常被讨论——如果你关注多模态与机器人学习方向,不妨持续留意后续的开源工具与评测动态。
 发表于 半小时前
|
查看: 5|
回复: 0


