过去一段时间,RSI(Recursive Self-Improvement,递归自我改进)正在从一个遥远的设想变成现实。
市面上出现了一大批可以动手实验的论文和方法。这些论文有的修改自己的 Skill,有的整理自己的记忆,有的改自己的 Harness,还有的生成训练数据来微调模型的权重。
如果你做过深度学习,读这些论文时大概会有一种强烈的既视感。它们遇到的问题,很多是以往深度学习就遇到过的。而它们给出的解法,也常常能在深度学习里找到原型。
一些方法更是从方法命名上就体现了对深度学习的借鉴:SkillAdam 借鉴 Adam 原理更新 Skill,TextGrad 把反向传播的思路搬到了文本上,RRSI 则把正则化用到了 Agent Harness 的修改过程中。
这种相似性并不停留在表面。我们可以举一个具体的例子来理解。假设我们想让一个 Agent 更加擅长某类任务,一个常见做法是让它写一个 Skill。
每做完一批任务,就根据任务结果更新一次自己的 Skill,把失败的教训和经验写进 Skill 里。多轮更新之后,Agent 的效果就会越来越好。
但实际上,Agent 前几轮更新效果可能立竿见影,到了第 20 轮,问题就开始冒了出来:
- 换一批没见过的新任务,表现明显下滑。这是因为 Skill 里写的只是针对见过的那几个任务的特殊处理。
- 早期能做好的任务,更新后反而做错了。这是因为某一轮更新改掉了 Skill 里的老规则,新任务能做对,却让旧任务做错了。
- Skill 文档从一页涨到了十几页。这是因为很多条目是一次失败后加进去的,之后再没起过作用,却也没有删。
这些问题其实并不新鲜。换个角度看,不断更新 Skill 就像不断调整神经网络参数,它们都是深度学习里的老问题。
在新任务上表现下滑是过拟合,旧任务反而做错是灾难性遗忘,文档越写越长是模型冗余。
深度学习已经花了很多年,发展出正则化、回放、剪枝等一系列机制来应对它们。
而且不只是这几个问题。如果总览深度学习和 RSI 的整体流程,会发现它们有某种相通之处。
深度学习是根据学习信号算一个 Loss,根据 Loss 调整神经网络的参数。而 RSI 则是在 Agent 执行完任务后,根据任务结果及外部反馈,让 Agent 修改自己的 Skill、Harness。
在这篇文章中,我们参考综述 From Existing Methods to New Research Ideas: Two Perspectives on Recursive Self-Improvement 第 4 章的内容,讨论现在的 RSI 方法和深度学习的联系。
http://arxiv.org/abs/2610.14625
综述中列举了 RSI 方法从深度学习借鉴的十一种机制:优化、反向传播、强化学习、元学习、蒸馏、正则化、数据增强、持续学习、剪枝、集成学习和对抗学习。
下图列出了这些机制及其代表方法:
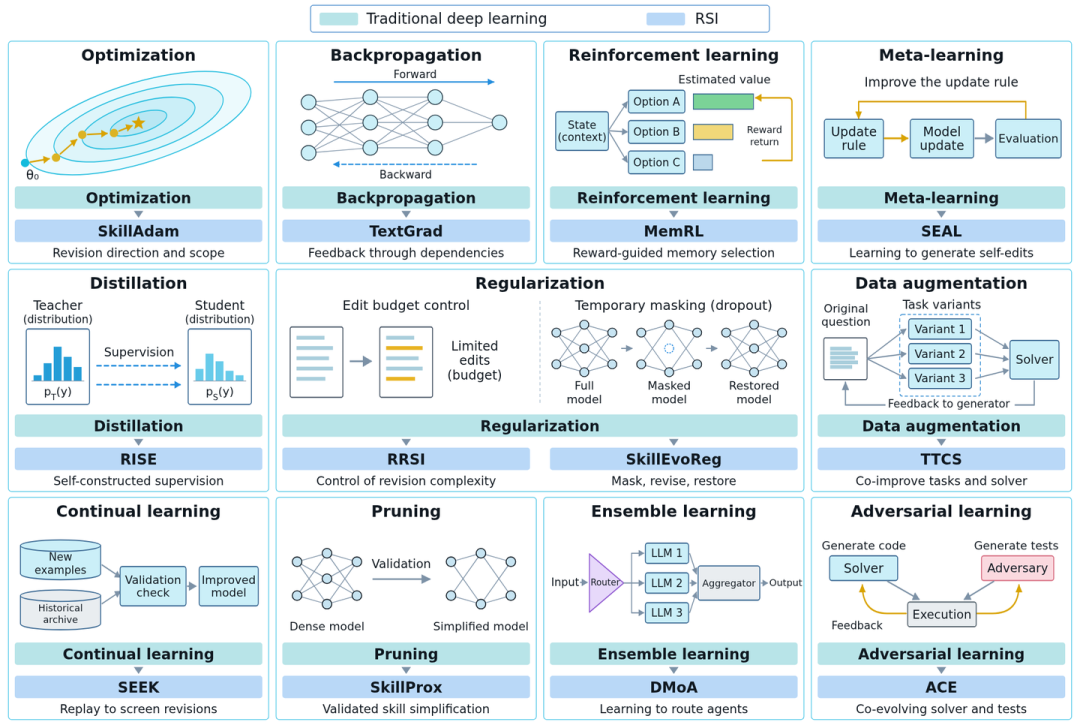
传统深度学习的机制与借鉴它们的 RSI 方法
在之后的章节中,我们将从四个角度讨论现有 RSI 对深度学习的借鉴:
- 每一轮该怎么改?改什么、改多少,失败该归因到哪个组件。对应优化器和反向传播。
- 学习信号从哪里来?没有现成的标签时,Agent 如何从奖励、学习效果、自身的训练轨迹、对手和同伴那里获得信号。对应强化学习、元学习、蒸馏、对抗学习和集成学习。
- 怎么不学偏?如何避免 Skill 只适用于见过的任务,也就是开头的第一个问题。对应正则化和数据增强。
- 怎么长期改下去?如何在持续更新中,既不丢掉旧能力,也不越改越臃肿,也就是开头的后两个问题。对应持续学习和剪枝。
在最后,我们还将探索性地讨论顺着这条路还能挖出哪些新方向。
01 每一轮该怎么改?
优化器:改什么,改多少
深度学习里的优化器决定参数更新的方向和幅度。最基本的梯度下降,每次沿着梯度的反方向走一小步。
后来的优化器会利用历史信息做两件事:
- 一是把过去几步的梯度平均一下,让更新方向更稳定,不被某一次的噪声带偏;
- 二是根据每个参数梯度的波动大小调整它的步长,波动大的参数走得谨慎一些。
现在最常用的 Adam 就同时做了这两件事。Skill 的迭代修订面临同样的问题:每一轮应该改哪些内容,改动多大?
以往的方法往往按预设的规则决定改什么,每一轮又常常把整份 Skill 重写一遍,前面已经改对的地方,可能下一轮又被改掉(下图左)。
SkillAdam 借鉴了 Adam 的设计来解决这两个问题。它记录发现过的问题、尝试过的修改及其结果,让后续修订可以利用此前的尝试,这相当于 Adam 利用历史梯度的那部分。
它还比较修订前后的任务表现,据此决定下一轮允许改多少:如果一次修改在不同评估案例上的收益差异很大,下一轮就缩小改动范围;如果收益比较一致,就允许更大范围的修改。这和 Adam 在梯度波动大时缩小步长的思路一脉相承。
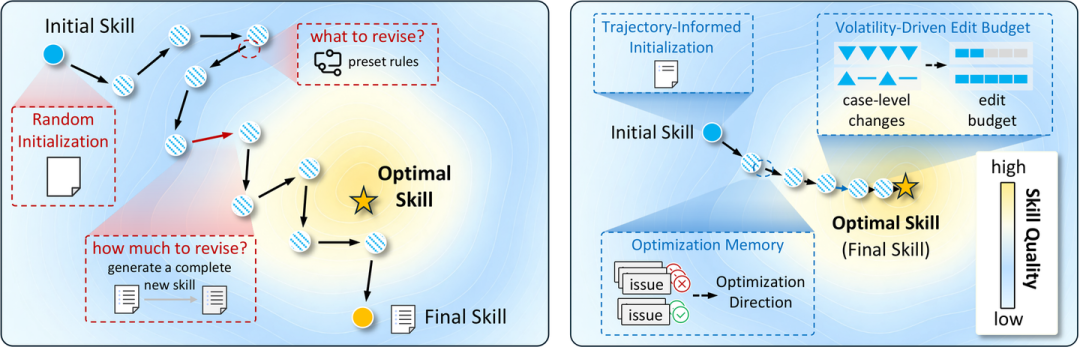
左:以往的方法按预设规则修改,每轮重写整份 Skill;右:SkillAdam 用优化记忆和编辑预算决定改什么、改多少
反向传播:该怪哪个组件
训练神经网络时,需要知道最终的误差该由哪一层、哪个参数负责。反向传播分两步来做。
前向时,输入一层层往后算,得到输出和损失;反向时,从损失开始一层层往回走,每一层根据后面传回来的梯度和本层自己的计算,用链式法则算出本层参数的梯度,再把梯度继续传给前一层。这样只要往回走一遍,就能知道每个参数该往哪个方向调。
Agent 系统也有同样的归因问题:一次任务失败了,问题出在检索指令、提取代码,还是最后的汇总提示?TextGrad 把反向传播的思路搬到了文本上。
以下图右边的系统为例:几段提示词分别交给语言模型、搜索引擎和工具调用,它们的输出再汇总给后面的语言模型,得到最终答案。
TextGrad 先让一个语言模型按评估要求,给最终答案写一段文字评价,这相当于损失。
然后沿着系统往回走:每一步都由语言模型结合这一步的输入、输出和后面传回来的评价,写出上游的输入该怎么改。
这些文字意见就相当于梯度。最后,优化器根据这些意见,改写提示词、代码等变量。这样,任务层面的一句评价,就被逐步转化成了对具体组件的修改。
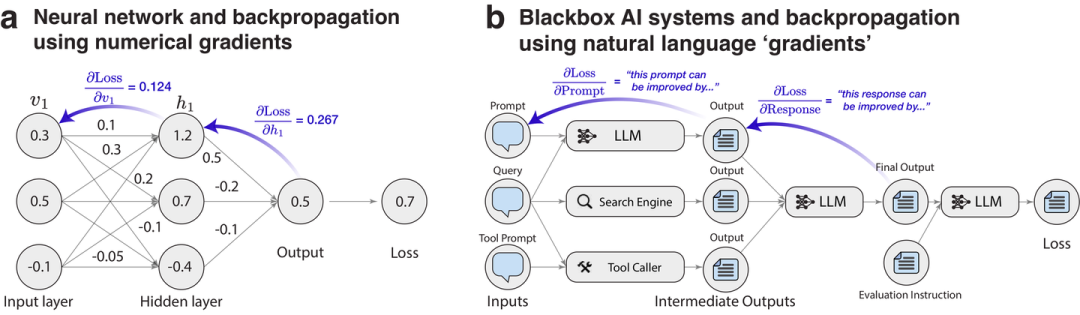
左:神经网络用数值梯度做反向传播;右:TextGrad 在 Agent 系统里反向传递文字形式的修改意见
02 学习信号从哪里来?
深度学习的大部分场景都有现成的标签和损失函数。Agent 在自我改进时,往往没有人提前备好监督信号,系统得自己想办法获得:从环境奖励中学,从学习效果中学,从自己的训练轨迹中学,从对手那里学,从同伴那里学。这一组的五种机制,正好对应这五种来源。
强化学习:从奖励中学会挑记忆
强化学习:从奖励中学会挑记忆让学习者在和环境的交互中改进决策:做出一个选择,环境给出奖励,再根据奖励调整之后的选择。其中一类常见的思路,是给每个选择估计一个价值,也就是选它预计能拿到多少回报。
每拿到一次奖励,就用它修正对应的估计;估计越来越准,也就越来越清楚该选哪个。
这一原理可以用在记忆检索上。很多 Agent 会把做过的任务记下来,遇到新任务时,按语义相似度找出相近的旧记录作为参考。问题是,看起来相似的记录不一定真的有用,有时反而会带来干扰。
MemRL 给每条记忆额外记了一个效用值,表示用上它之后任务通常完成得好不好。
MemRL 的检索分为两步:先按相似度召回一批候选,再综合相似度和效用值,从中挑出真正给 Agent 用的几条。
如果任务成功了,这次用到的记忆效用值就往上调;反之则往下调(更新公式见下图右下角)。
这样,经常对任务有帮助的记忆,之后就更容易被选中。在整个过程中,语言模型的参数始终不变,被改进的只是从已有记录里挑选记忆的方式。
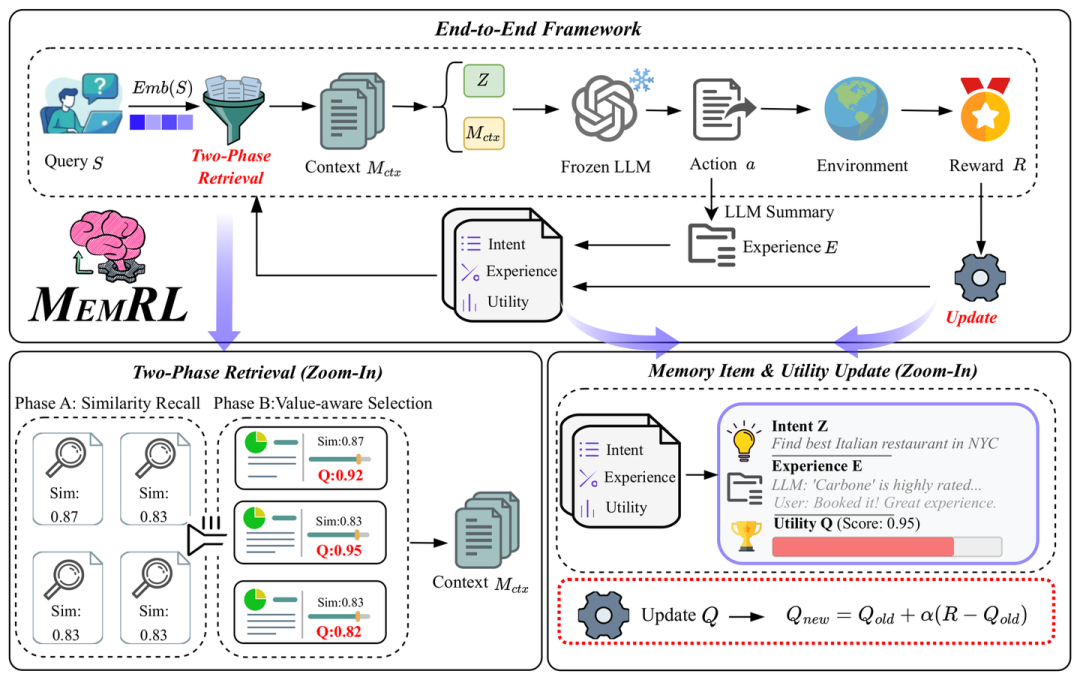
MemRL:先按相似度召回记忆,再按效用值 Q 挑选,任务结束后更新 Q
元学习:从学习效果中学会如何学习
元学习的目标是学会如何学习。普通的训练是在一个任务上把模型训练好;元学习则在许多任务上反复经历学习的过程,根据每次学完之后的效果,去改进学习方式本身,比如模型从什么初始参数出发、参数按什么规则更新、用什么样的数据来训练。这样,遇到新任务时,模型就能学得更快、更好。
SEAL 把这一思路用在了模型的自我更新上。它想解决的问题是,给模型一段新材料,怎样让模型真正把它学进参数里。直接拿原文去微调,效果很有限。
SEAL 是这样做的:读完一段材料,模型先自己写一份训练材料,比如从这段材料推出的若干推论,论文把它叫作“自编辑”(self-edit,即下图中的 SE)。
然后模型用这份训练材料微调自己,之后在不看原文的情况下回答相关问题。
关键在于,训练材料写得好不好,要看学完之后答得怎么样。SEAL 每次让模型写出几份不同的训练材料,分别拿去微调、测试,把让模型答得更好的那几份留下来,再训练模型以后多写这样的训练材料(见下图)。
这样就有了两层学习:里面一层用训练材料更新参数,外面一层改进写训练材料的能力。这正是元学习说的,根据学完之后的效果,改进学习方式本身。
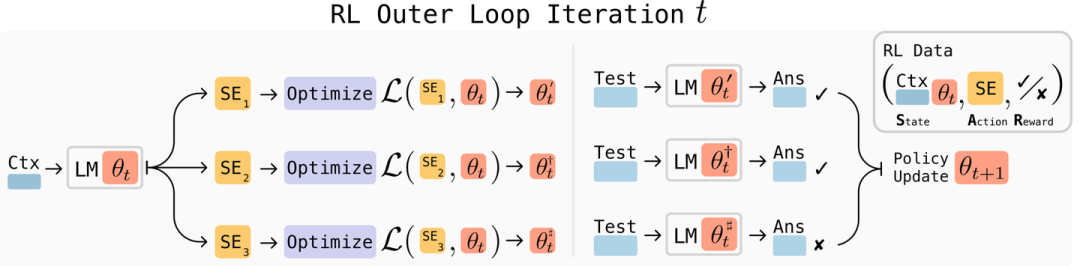
SEAL:写出多份训练材料(SE),分别微调、测试,用效果好的那几份训练模型
蒸馏:从自己的训练轨迹中构造老师
知识蒸馏最初是为了把大模型压缩成小模型:先训练一个又大又强的教师模型,再让一个小的学生模型去模仿它。
学生模仿的不是标注好的正确答案,而是教师对每个候选输出给出的概率。
和只给出一个正确答案的标签相比,这些概率还包含了不同输出之间的相对偏好,比如哪些错误答案和正确答案更接近。这样训练出来的学生,往往比直接用标签训练的同等规模模型效果更好。
RISE 把蒸馏用在了强化学习里。它针对的是用强化学习训练模型做数学题的场景,这种训练只看最终答案对不对,信号很粗:模型不知道一段解答里哪几步写得好、哪几步写得差。
相比之下,蒸馏的信号要细得多,教师会在每个位置告诉学生下一个词该怎么写。但这需要一个比学生强、且输出风格和学生相近的教师模型。
为此,RISE 的做法是:模型做完一次强化学习更新后,把参数沿着这次更新的方向再外推一段(也可以对模型的输出做外推),得到一个预计更强的模型,用它当教师来蒸馏学生(见下图)。
这个教师由学生自己外推而来,输出分布和学生很接近,学生学得来。每一轮都是这样:先做强化学习,再外推出教师,再蒸馏。
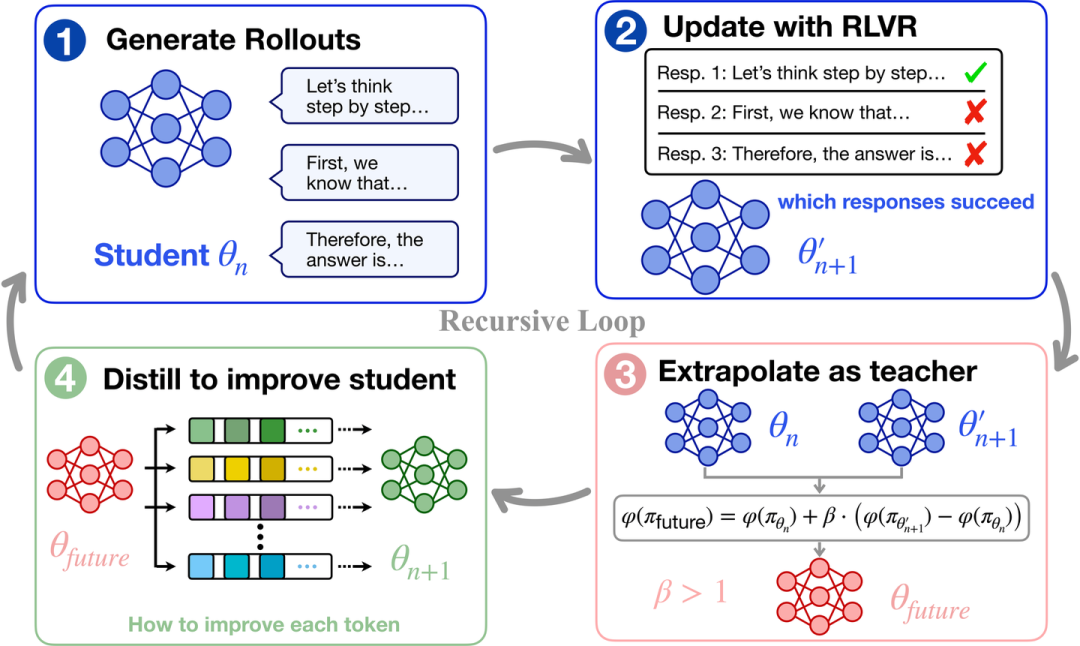
RISE:强化学习更新,外推出教师,再蒸馏给学生
对抗学习:从对手那里发现漏洞
对抗学习让两个模型在相互对抗中一起进步。一方负责完成任务,比如生成以假乱真的样本;另一方专门找它的破绽,比如把生成的样本从真实数据里挑出来。
双方轮流更新:一方每进步一点,另一方就得找出新的破绽;另一方每找到一个破绽,前者也就知道了下一步该往哪里改。这样,对手本身就成了一个不断更新的训练信号,不需要人来指出哪里做得不好。
写代码的 Agent 同样需要一个会挑错的对手。以往让模型自我改进写代码的做法,通常是一个求解器写代码,再由一个验证器写测试来检查。
但验证器写的测试往往只是确认代码在常见输入上能跑对,求解器稍微变强之后,这些测试就很难再发现剩下的错误。
代码生成框架 ACE 换了个思路,让同一个模型轮流扮演求解器和对抗者,复现了对抗学习的这种交互(见下图)。
求解器生成候选程序,对抗者生成专门用来触发执行失败的测试输入,比如让程序报错、崩溃或者跑不完。
系统用已有的正确性测试和生成的输入一起评估这些程序,再用筛选出的程序微调求解器。
执行结果也为对抗者提供偏好信号:系统更偏好那些能让一部分候选程序失败、而另一部分仍能成功执行的测试。
更新后的求解器和对抗者进入下一轮,缺陷发现和代码生成就这样在交互中持续改进。
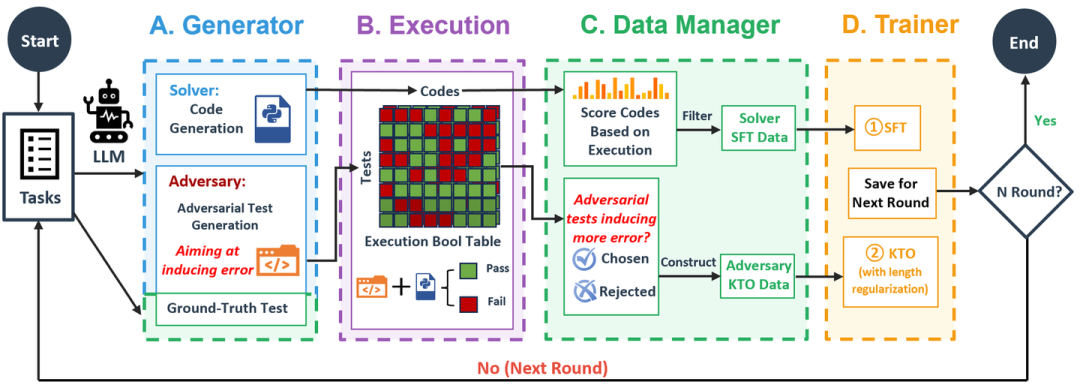
ACE:同一个模型轮流扮演求解器和对抗者,用代码的执行结果训练两者
集成学习:从同伴那里取长补短
集成学习把多个学习者的预测结合起来,利用它们互补的长处。具体做法是训练好几个模型,让它们对同一个输入各自给出预测,再通过投票、取平均或者加权的方式得到最终结果。
它之所以有效,是因为不同模型犯的错往往不一样,合在一起时能互相抵消一部分。所以集成里的成员既要各自够好,彼此之间又要有差异。
至于怎么合,可以用固定的规则,也可以再训练一个模块,根据输入决定更相信哪个成员。
在 Agent 系统中,对应的问题是:多个 Agent 怎样一起求解,以及系统怎样学会安排它们参与任务。
很多多 Agent 系统事先固定好协作结构(下图的 (a)(b)(c)),比如谁先做、谁后做、谁把结果交给谁,这相当于用固定的规则来合并各个成员的结果。
DMoA 则让系统自己学会怎么合。它有一个 Agent 池,每个 Agent 由不同的语言模型、角色和工具组合而成,相当于集成里各有所长的成员。
推理的每一步,由一个路由器根据当前的问题和已有的上下文,从池里挑出少数几个 Agent 参与(下图的 (d)),它们的回答汇入下一步的上下文,最后由一个总结器给出答案。
这个路由器,就是集成学习里那个根据输入决定更相信哪个成员的模块。路由器的训练不需要标注答案,底层语言模型也全程保持不变,被学习的只是 Agent 之间的协作方式。
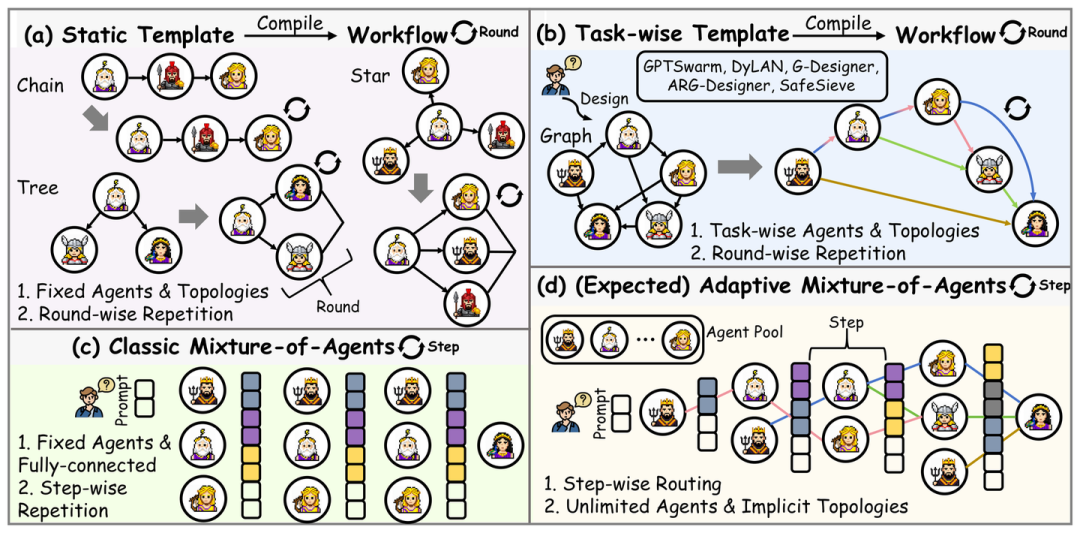
(a)(b)(c):事先固定协作结构的多 Agent 系统;(d):DMoA 每一步从 Agent 池里挑选 Agent
03 怎么不学偏?
正则化:控制复杂度,加入扰动
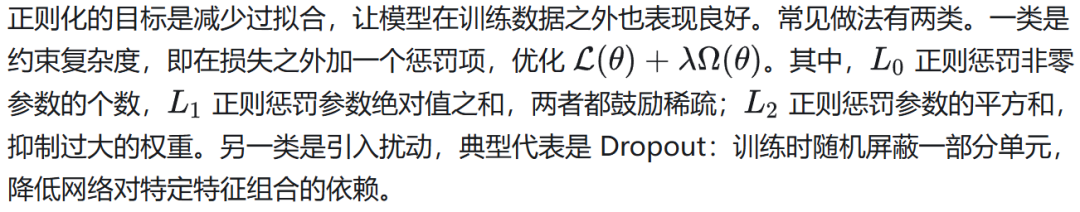
RSI 面临同样的风险:Harness 或 Skill 经过反复修订,可能非常适合改进时用过的任务,却难以迁移到新任务上。
RRSI 的论文就观察到了这一点:以往自动修改 Harness 的方法,在用于改进的那组任务上涨得不少,换到没见过的任务上,提升却大多保不住,有的甚至不如改进前。
针对这个问题,RRSI 把正则化里控制复杂度的思路用到了 Harness 的演化上。
它逐步减少每次提案允许包含的独立修改数量,限制系统根据一轮反馈能引入多少变化;多次没有带来收益的组件,会被列为待删除对象;
筛选候选版本时,执行成本的增加也必须有任务表现的提升来支撑,只针对某个基准写的修改也会被筛掉(见下图)。
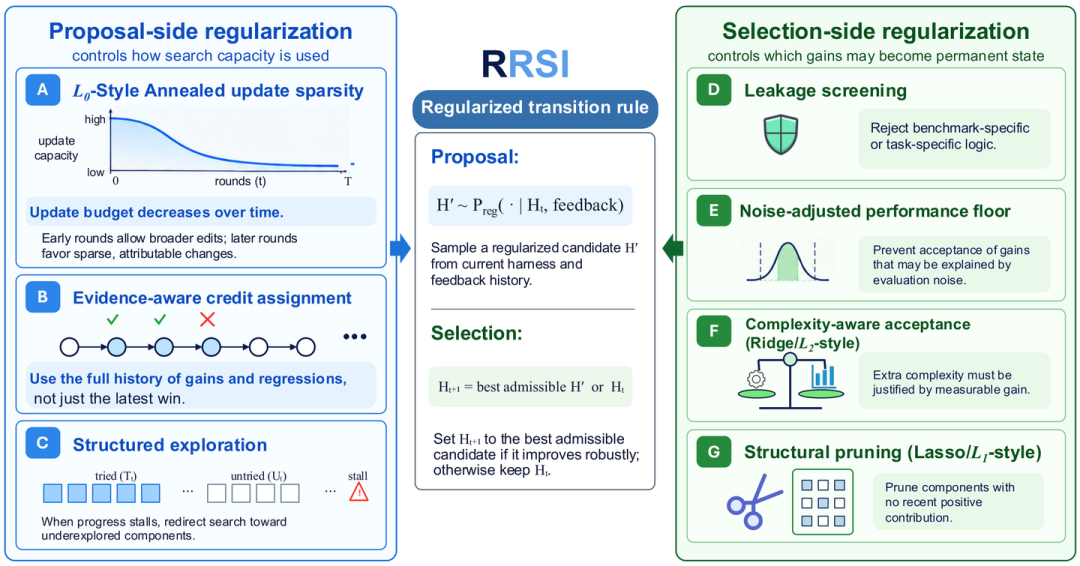
RRSI:左边约束每轮怎么提出修改,右边约束哪些修改能留下来
SkillEvoReg 则把 Dropout 的思路用到了 Skill 修订上。它随机屏蔽当前 Skill 中的一部分指令或操作步骤,让 Agent 带着这份不完整的 Skill 执行训练任务,再由更新器根据执行记录提出修订。
之后,系统恢复被屏蔽的内容,把提出的修改整合回完整的 Skill(见下图)。
这样做是为了减少修改 Skill 时对某些原有指令的过度依赖。此外,它也会像 RRSI 那样,限制 Skill 不必要的增长。
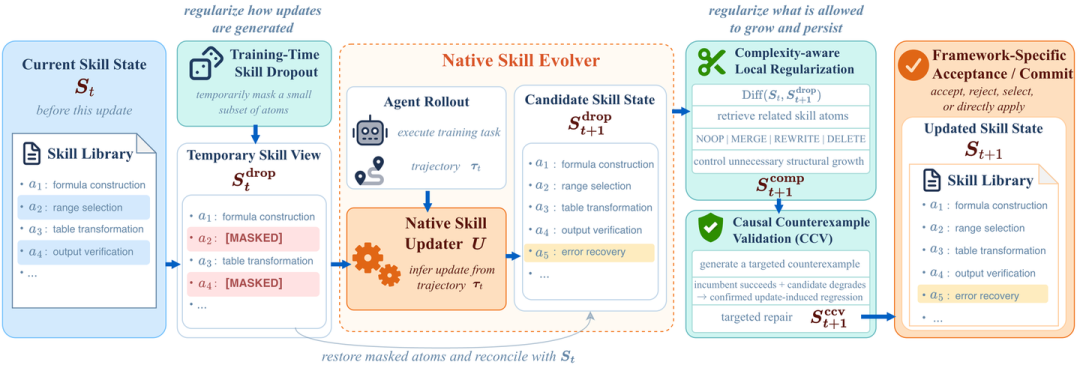
SkillEvoReg:修订时随机屏蔽部分 Skill,并限制 Skill 不必要的增长
数据增强:为难题造变体
数据增强通过构造已有样例的变体来扩充训练数据。在图像分类中,把一张已标注的图片随机裁剪、水平翻转,或者调整一下颜色,图片里的物体还是那个物体,标签不用变,模型却多见到了几种不同的样子。
这样模型就不容易死记训练图片里的细节,而是学会抓住真正决定类别的特征。另外,对样例的变换不能改掉样例的本质,否则原来的标签就不再成立了。
TTCS 把数据增强用在了模型的自我提升上。它面对的情况是:模型手里只有一批难题,没有标准答案,要靠自己在这些题上练习来提高。
没有标准答案,模型只能对同一道题回答多次,把出现次数最多的答案当作正确答案来学习。
但题目太难时,模型大多数时候都会答错,出现最多的答案往往也是错的,模型就会跟着错误答案学。
为了解决这个问题,TTCS 借鉴数据增强,围绕这些题目生成一些变体题。它用一个问题合成器,在保留原题解题思路的前提下,改变题目中的对象、情境或条件,生成难度合适的新题。
所谓难度合适,是指模型既不会每次都做对,也不会每次都做错:如果模型对一道新题回答多次,大约一半的回答与出现最多的答案一致,合成器就会得到较高的奖励;太简单或太难的题,奖励都低。
模型则同时在原题和这些新题上训练。新题难度合适,出现最多的答案也更可靠,模型就能学到正确的东西。这样,模型在练习中变强,合成器也在训练中越来越会出题。
04 怎么长期改下去?
持续学习:用回放守住旧能力
持续学习关注模型在接触后续任务或数据时,怎样继续学习并保留已有的能力。
难点在于,网络在新数据上训练时,参数会朝新任务的方向调整,旧任务上学到的知识很容易被覆盖,这就是灾难性遗忘。
一种经典的应对办法是回放:保存一部分旧样例,学新东西时把它们混进来一起训练,让模型在适应新任务的同时,也不断被提醒旧任务该怎么做。
Agent 反复更新 Skill 时也会遇到这个问题:新任务改好了,旧任务却可能被改坏。
SEEK 是快手做的一个搜索评估系统。用户在快手上搜一个词,会得到一页短视频结果,SEEK 用语言模型来判断这页结果好不好;如果不好,还要指出问题出在哪里。
判断的标准有很多条,而且经常变化,SEEK 就把这些标准写成一条条 Skill 存进 Skill 库,每次评估时只取出和这次搜索相关的几条来用。
用的时间长了,人工复核会发现 SEEK 在某类情况上总是判错,这时系统就会修改相应的 Skill。
但改了一条标准,可能会让原来判对的情况变成判错。所以 SEEK 准备了一组固定的历史案例,这些案例的正确判断都经过人工确认。
每次修改 Skill 后,既要看它在新发现的那类情况上有没有判得更准,也要把这组历史案例重新判一遍:只有新情况判得更准了,历史案例上的表现也基本没有变差,这次修改才会被保留(见下图)。这组历史案例,起的就是回放的作用。
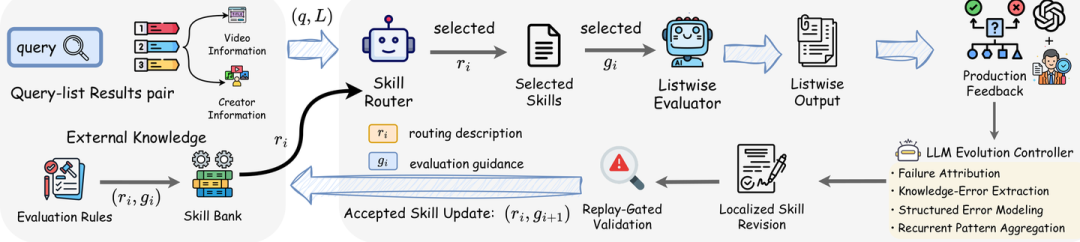
SEEK:路由器挑出相关 Skill 交给评估器;修改后的 Skill 要通过回放检查才写回 Skill 库
剪枝:给 Skill 瘦身
剪枝会移除对目标行为贡献较小的网络权重或结构,之后通常还要继续训练。训练好的网络里,往往有不少权重几乎不起作用。
剪枝先给每个权重或结构估计一个重要性,比如看它的绝对值大小,或者看去掉它之后损失变化多少;
然后把最不重要的那部分删掉,再继续训练剩下的部分,把损失的准确率补回来。这个过程可以反复进行,最后得到一个小得多、效果却差不多的网络。
Agent 反复修订 Skill 时,也会积累一些作用很小、已经不值得保留的内容。
SkillProx 在修订完成之后,会专门做一次简化。它先把 Skill 拆成一个个单元,比如某一节指令或某一份参考资料;然后每次去掉其中一个单元,在验证任务上重新跑一遍,看效果变化有多大。
去掉之后效果几乎不受影响的单元,说明贡献不大,就成了简化的对象:可以直接删掉,可以把其中有用的部分并到别的章节,也可以把过于详细的内容压缩成简短的步骤。
每次简化之后,Skill 必须确实变短、结构没有被破坏,而且在验证任务上的表现没有明显下降,这次简化才会保留,否则就撤回。
05 再往前一步:还能挖出哪些新方向?
前面四章讲的,都是现有方法已经用上的机制。顺着这些联系再往前走,还有哪些机制可以借鉴?
下面我们列出五个方向。前三个来自深度学习,第四个来自更广的机器学习,第五个来自进化算法。
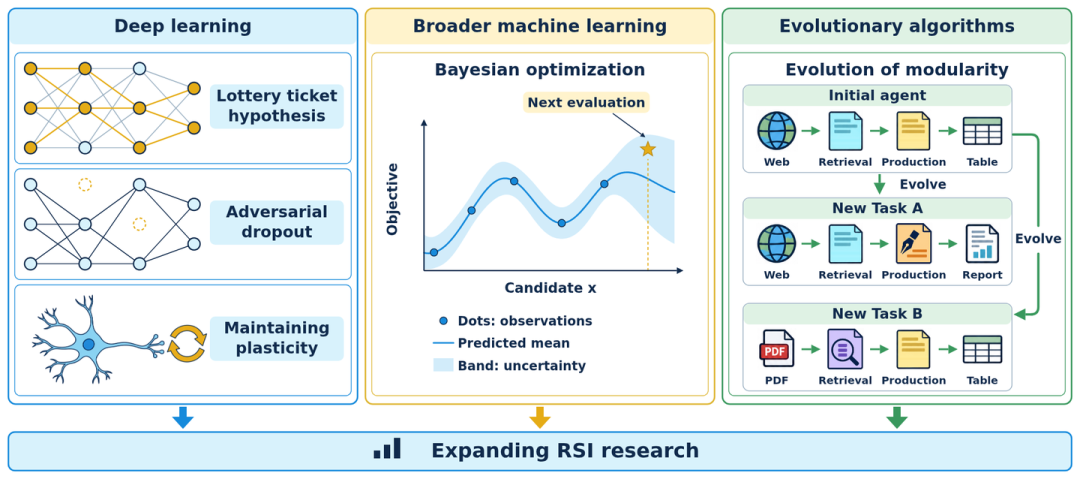
新方向的几类来源:深度学习(彩票假说、对抗式 Dropout、可塑性)、贝叶斯优化、模块化演化
彩票假说:Agent 起步需要多少资源?
彩票假说说的是:一个大网络里,可能藏着一个小的子网络。把它单独拿出来,用原来的初始权重训练,也能在差不多的训练轮数里,达到差不多的准确率。
那么对 Agent 来说,开始自我改进的时候,真的需要那么多 Skill 和代码吗?如果其中一小部分就够了,我们就有可能找到一个更精简、但同样能持续改进的起点。
对抗式 Dropout:扰动能不能更有针对性?
Dropout 是在训练时随机屏蔽一部分神经元。对抗式 Dropout 更进一步,在允许的范围内,专门去找最能让模型出错的屏蔽方式,再让网络学着应对。
前面讲过,SkillEvoReg 已经把随机屏蔽用到了 Skill 修订上。那能不能不随机屏蔽,而是专门去屏蔽 Agent 最依赖的那部分 Skill,逼它去找别的办法完成任务?
可塑性:Agent 会不会越改越学不动?
持续学习除了要记住旧东西,还要能学会新东西,这种能力叫可塑性。研究发现,网络连续学了很多任务之后,可塑性会慢慢下降。
持续反向传播就是为此提出的:它在训练过程中不断把少量贡献很低的神经元重新初始化,让它们重新学习新的特征。
如果一个 Agent 一直用自己生成的数据训练自己,时间长了,会不会也越来越学不会新方法?这个问题值得去测一测。
Freeze-Thaw 贝叶斯优化:哪条分支值得继续?
Freeze-Thaw 贝叶斯优化会根据已经看到的学习曲线,预测一次训练接下来的表现,再决定是继续训练、先暂停,还是把之前暂停的训练捡回来。
很多 RSI 系统会同时跑好几条改进分支。比如 DGM 会维护一个 Agent 档案,不断从里面挑出版本接着改。
那能不能也根据每条分支前几轮的表现,预测它接下来还能进步多少,再决定哪条继续、哪条先停下?
模块化演化:Skill 能自己学会拆分吗?
有一个进化实验很有意思:如果让演化目标在几个子目标的不同组合之间来回切换,网络会自己长出可以复用的模块。
而现在的 RSI 方法,比如 ModularRSI,是先把模块划分好,再分别改进。
那 Agent 能不能也这样,在任务不断变化的过程中,自己把 Skill 拆成可以复用的模块,而不用人提前设计好?
这几个方向在原综述里有更具体的讨论,感兴趣的话可以去看原文。
06 结语
总的来看,Agent 的自我改进正在一个个碰到深度学习遇到过的老问题:每一轮该怎么改,学习信号从哪里来,怎么不学偏,怎么长期改下去。
现有的方法也已经从优化器、反向传播、强化学习、元学习、蒸馏、正则化、数据增强、持续学习、剪枝、集成学习和对抗学习里,借来了不少办法。
但 RSI 也有深度学习里没有的东西:提出修改的那个系统本身,也可能被修改。
在深度学习里,Adam 不会在训练过程中修改自己;而在 SEAL 里,模型既用自己写的训练材料更新自己,又学习怎么把这些材料写得更好。改进者自己也在被改进,递归说的就是这个。
当然,能借鉴的远不止这些。学习率预热、早停、课程学习……还有许多深度学习的方法值得搬到 RSI 里来。如果你平时会逛云栈社区的话,大概率已经见过不少围绕 Agent 自我改进和 Skill 演化的讨论了。
 发表于 5 小时前
|
查看: 2|
回复: 0


