让所有 AI 编程助手共用同一个脑子,而且这脑子还会自己忘掉不用的记忆。
要说最让我头疼的事,换 AI 工具绝对排得上号。
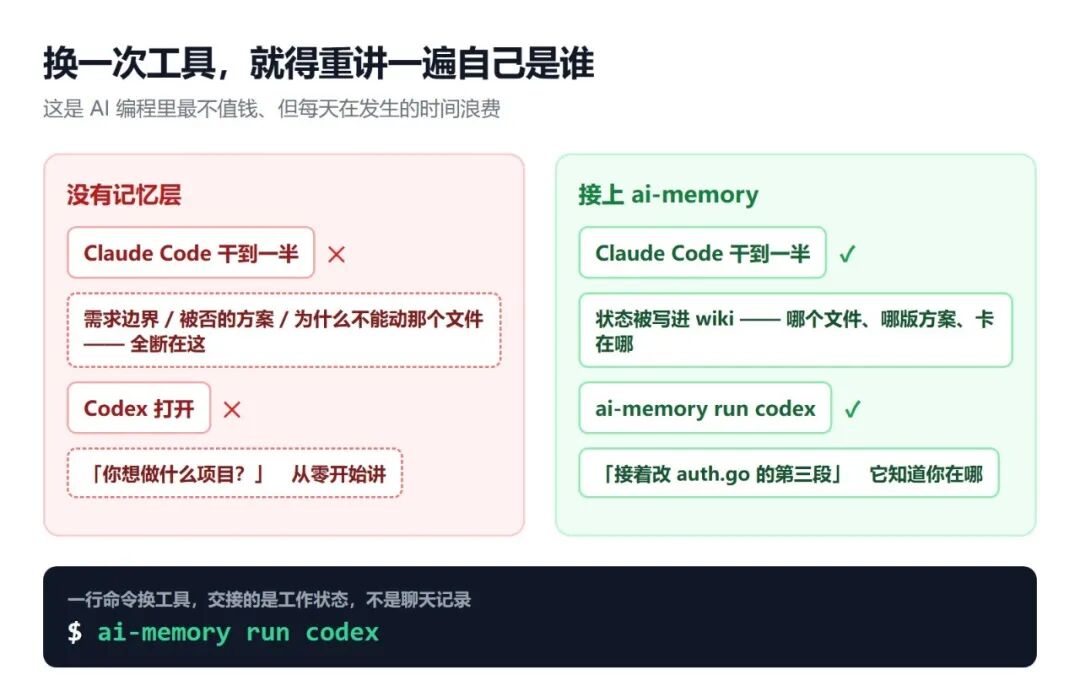
在 Claude Code 里跟它来回拉扯四十多分钟,需求边界总算摸清了,哪个文件为什么不能动、上个方案为什么被否,全聊明白了。可额度用完,或者它开始胡言乱语,我就寻思换个 Codex 试试。结果打开 Codex,第一句话是:你想做什么项目。那感觉就像换了个新大夫,得从头讲病史。而且你还讲不全,因为自己都可能忘了当时为什么否掉那个方案。
AI 编程最费劲的地方,不是它写错代码,而是你每换一次工具,就得重新交代一遍自己是谁。
日本有位老哥 Fabio Akita,写 Ruby 出名的,今年五月开了一个仓库叫 ai-memory,现在已经 13,895 星。一句话说清楚它干什么:给所有 AI 编程助手接一个共用的记忆层。
它不是又一个 RAG
先得说它不干什么,这块最容易误会。
它默认不调用任何大模型。整理记忆这活儿,同类项目大多扔给 GPT 做摘要,它不,它走规则、走压缩,全程在本地跑,所以你不会有额外的 token 账单。它也没有向量库,没有 embedding,没有 ANN 索引,没有那套“先切片再检索”的重活。
最反常识的是这个:你的记忆就是硬盘上一个文件夹,里头全是 Markdown,用 git 管着。
我第一反应是,这不就是个笔记文件夹吗,凭什么 13.8k 星?用完我改口了。真正值钱的不是“存”,是它怎么决定该忘什么。
四个动作
它的流水线是一条线:
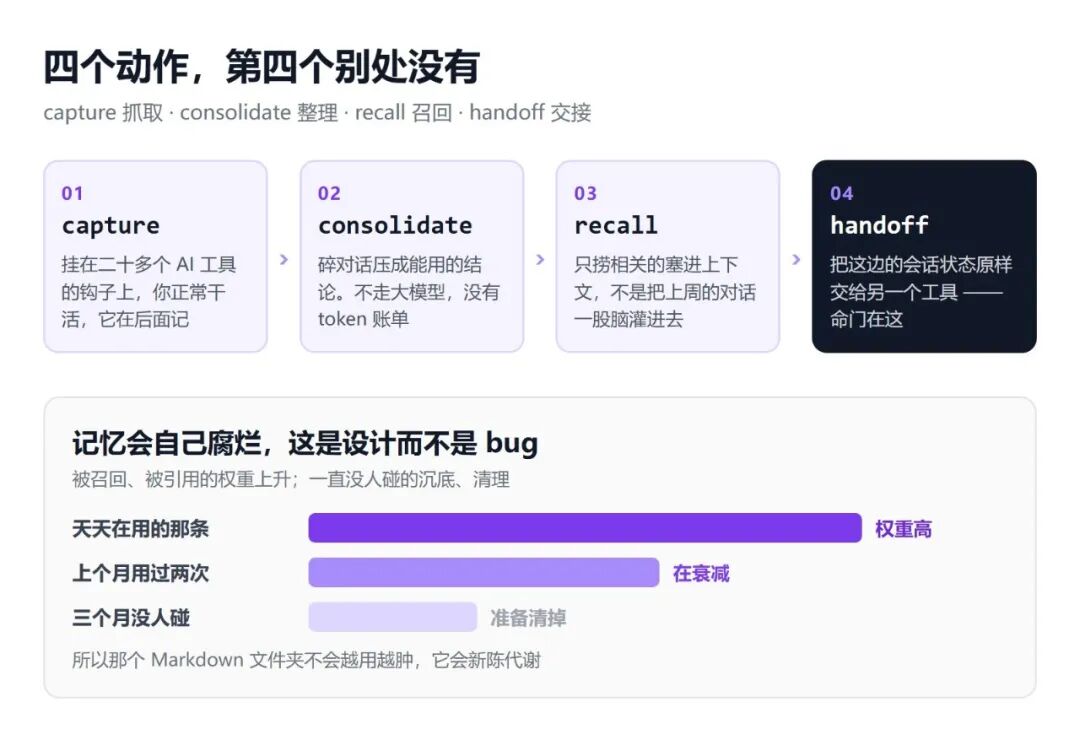
capture → consolidate → recall → handoff
抓取、整理、召回、交接。前三个词你大概都见过,第四个才是命门。
capture 是把你跟 AI 的对话捞出来。二十多个 harness 上都有它的钩子,Claude Code、Codex、Cursor、Gemini CLI 都在支持矩阵里。你正常干活,它在后面闷头记。
consolidate 是把一堆碎对话压成能用的东西。这步不需要模型,所以便宜、快,也不会有模型瞎编的风险。
recall 是下次开工时把相关的捞出来塞进上下文。捞的是相关的内容,不是把上周所有对话一股脑灌进去,那样上下文当场就爆了。
handoff 才是真正解决问题的那个动作:把这边的会话状态,原样交给另一个工具。招牌用法就一行:
ai-memory run codex
你在 Claude Code 里干到一半,敲这一行,Codex 起来了接着干。它知道刚才在改哪个文件,知道哪个方案已经被否了。
这不是复制粘贴上下文。复制粘贴带过去的是“我们聊了什么”,它带过去的是“我们现在在哪”。前者是聊天记录,后者是工作状态。
记忆会烂掉
这是我最喜欢的设计,也是我觉得它配得上这么多星的原因。
大部分记忆类工具的思路是记得越多越好。结果用上三个月,记忆库成了一坨谁也不敢删的垃圾场,召回质量一路往下掉。
ai-memory 反过来:记忆是有权重的,你不用的记忆会慢慢衰减。
一条记忆被召回、被引用、被证明还有用,权重就往上走;一直没人碰的,权重往下掉,沉底,最后清掉。跟人脑一个道理:昨天中午吃了什么你记不住,因为没用;三年前某个 bug 为什么那么难查,你记得死死的,因为疼过。它把这套机制写成了代码,所以那个 wiki 文件夹不会越用越肿,它自己会新陈代谢。
还有个可选的 dream 阶段,名字起得挺中二,在你不用的时候跑一遍,把零散记忆重新关联、合并、去重。跟睡觉时大脑整理白天的事情是一回事。
装起来有多麻烦
本来我做好了大折腾的准备,毕竟要跨二十多个工具的钩子,听着就头大。结果是这样:
curl -fsSL .../install.sh | sh
ai-memory setup
setup 自己去认你机器上装了哪些 AI 工具,挨个把钩子接上。接完你在任何一个里面正常干活就行,它自己记。
数据落在哪,它写得很直白:
<data_dir>/wiki      # 就是那堆 Markdown,git 管着
<data_dir>/db        # 索引
<data_dir>/models    # 本地模型
<data_dir>/raw       # 原始对话
<data_dir>/logs
wiki 是唯一的真相来源,而且本身是个 git 仓库。这带来两件事。你能用 git log 看自己的记忆是怎么长出来的,哪条记忆哪天加的、被谁改过,一条不落。还有一件更实在的:你可以把它推到自己的私有仓库,换台电脑 clone 下来,记忆跟着人走。
用过的都懂。那些把数据锁在自家云端的记忆工具,等你哪天不想用了,东西一样都带不走。
该说的坑
不吹过头,说几个实际问题。
它认工具。你要是只用 Claude Code 一个,收益没那么大,它的价值全在“跨”这个字上。单工具用户装它,属于给自己找事。
Markdown 当记忆库,对中文长文本的检索质量我没做严格测试。它默认那套不走 embedding,纯靠结构化召回,好处是可控,坏处是语义相近但用词不同的情况可能捞不出来。
这项目今年五月才开,迭代很快,接口和目录结构都在变。打算长期用的话,最好盯一眼 release。
最后,它解决的是“跨工具”的问题,不解决“AI 记性差”这回事。上下文窗口就那么大,它只是让你把那点窗口用在刀刃上。
写在最后
我一直觉得 AI 工具这块现在有点怪。大家都在比谁的模型强、谁的上下文长、谁的 agent 更能自己跑,但没人管一件事:你换了工具,之前攒下的那点默契全没了。
ai-memory 干的是脏活。不炫技,不调大模型,不搞向量库,就是老老实实把你的工作状态存成文件,下次原样还给你。13.8k 星不是给它的技术,是给这个痛点的。
项目在 GitHub 上搜 akitaonrails/ai-memory,MIT 协议。装之前先看一眼它支持的工具清单,确认里头有你常用的那个。
 发表于 昨天 22:15
|
查看: 8|
回复: 0
 /1


