从抠出文字,到接好跨页内容
让 AI 读一本扫描书,难点并不只在“认字”。上一页断开的句子、下一页接续的表格、正文和图注的先后关系,都可能在单页识别时被拆散。百度这次开源的 Unlimited OCR 2,瞄准的正是连续多页文档的解析问题。
OCR 就是从图片里认文字。这款模型还会标出文字块、坐标、标题等结构,再由后处理程序把这些信息转成 Markdown 纯文本排版格式,并合并跨页内容。如果只是把每页各认一遍,后续往往还要额外处理前后页之间的衔接。
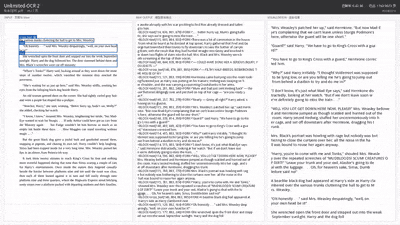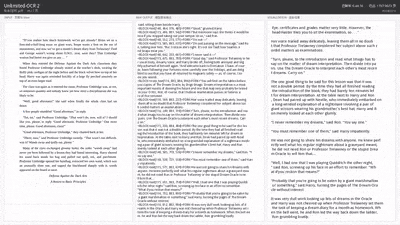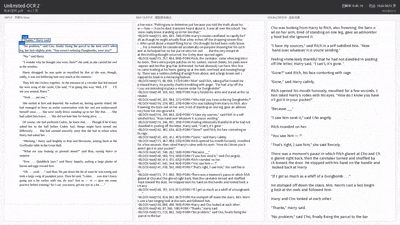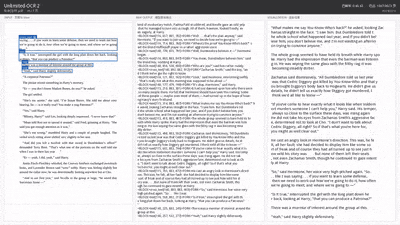
官方回放节选,播放速度不代表真实解析速度。
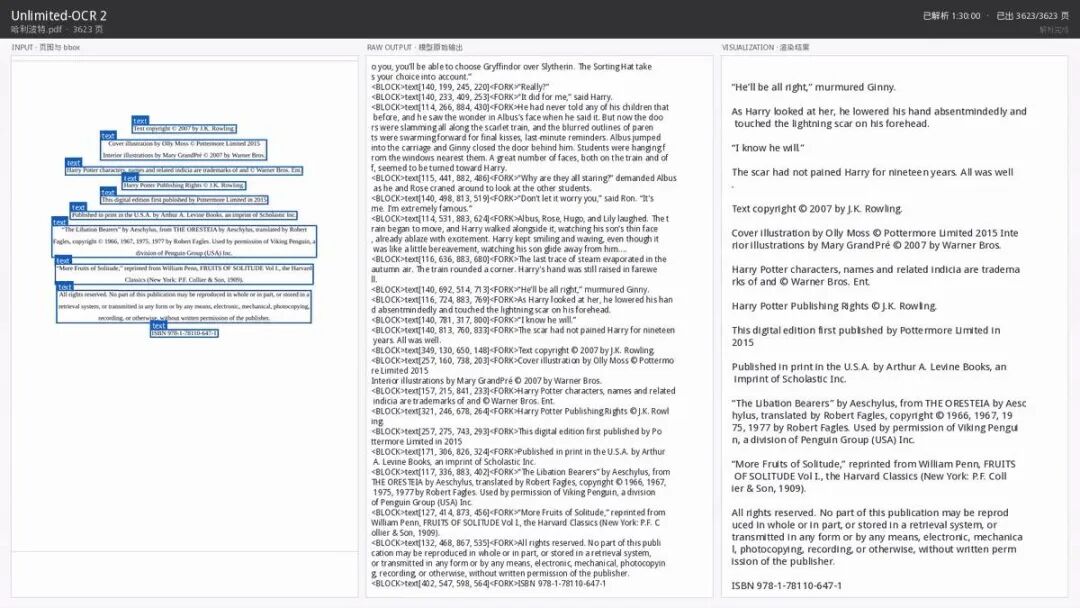
回放末帧报告 3623 页、1 小时 30 分。不过,“完成计数”并不能等同于逐页识别无误。
- 输入是按顺序排列的页面图片,可以由 PDF 转换而来。
- 官方整书演示属于回放,本文未对模型做独立实测。
只看相关页面,分窗口接力
长文档处理的主要变化,是“按页筛选、分窗口接力”。这样做的好处是速度、显存和识别分数都能保留在可控范围内,但三项指标要拆开看适用条件。
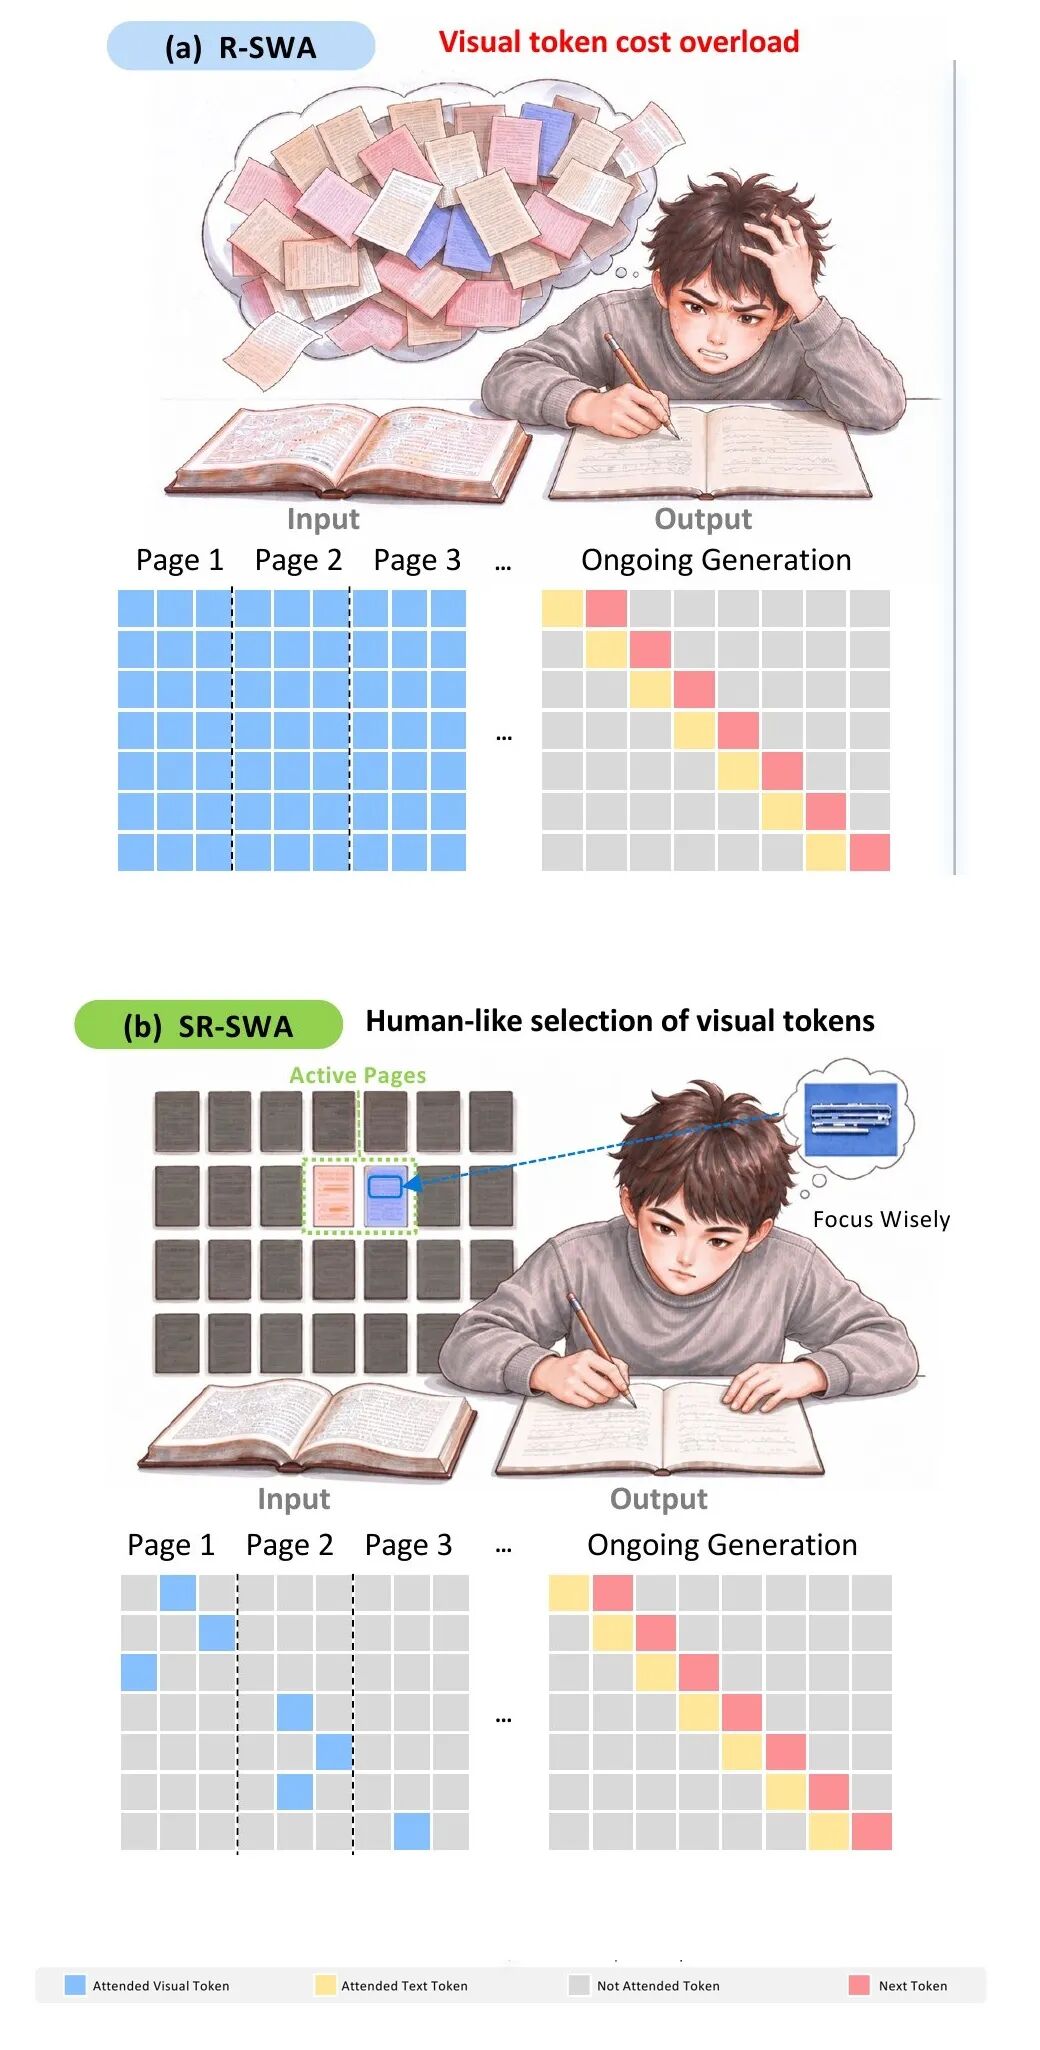
上图展示广泛关注视觉内容,下图则选择相关部分;原左右面板在这里改为上下排列。
新机制叫 SR-SWA,可以理解为“带筛选的滑动阅读窗口”:它先圈定相关页面,再挑出最相关的内容块。每一步只参考有限内容,工作台不会随着整本书越堆越大。这里固定的是“引用预算”,而不是永远只读固定的几页。
但只做注意力筛选还不够。论文同时把超长文档切成相互重叠的窗口,依次处理,并保留边界页和一小段已经生成的文字,释放旧窗口缓存。因此,“一次请求读整书”也包含内部接力,并非所有页面同时常驻显存。
- 项目说明举例的 512 个 token 是引用预算,也就是模型处理的内容片段数量,不是整本书字数上限。
- 窗口缩小能节省内存,但可能损害跨窗口内容衔接。
单步不越读越慢,全文仍需时间
AI 读扫描书时,常常第一页认得不错,翻到后面却越来越慢,还会把跨页表格拆散。Unlimited OCR 2 的目标之一,就是让模型读长文档时只盯相关内容,把工作台控制在有限大小。
在百页测试中,作者报告每步生成比全量查看内容快 7 倍,比上一代机制快 5.6 倍。这里比较的是“生成下一小段要多久”,并且限定在图像切块模式、同时处理 3 条序列、每页固定输出 1024 个内容片段的前提下。
书越长,要读的图、要输出的字仍然会增加,总耗时不会固定。另一项测试把峰值 KV缓存 从 47GB 降到 1.77GB。KV 缓存是模型暂存的中间信息,但这并不等于整套模型只占 1.77GB 显存。
- 速度倍数是作者在指定设置下测得,不能推广到所有文档。
- 预处理、读图、输出和并发调度,都要计入实际成本。
百页测试亮眼,单页并非全胜
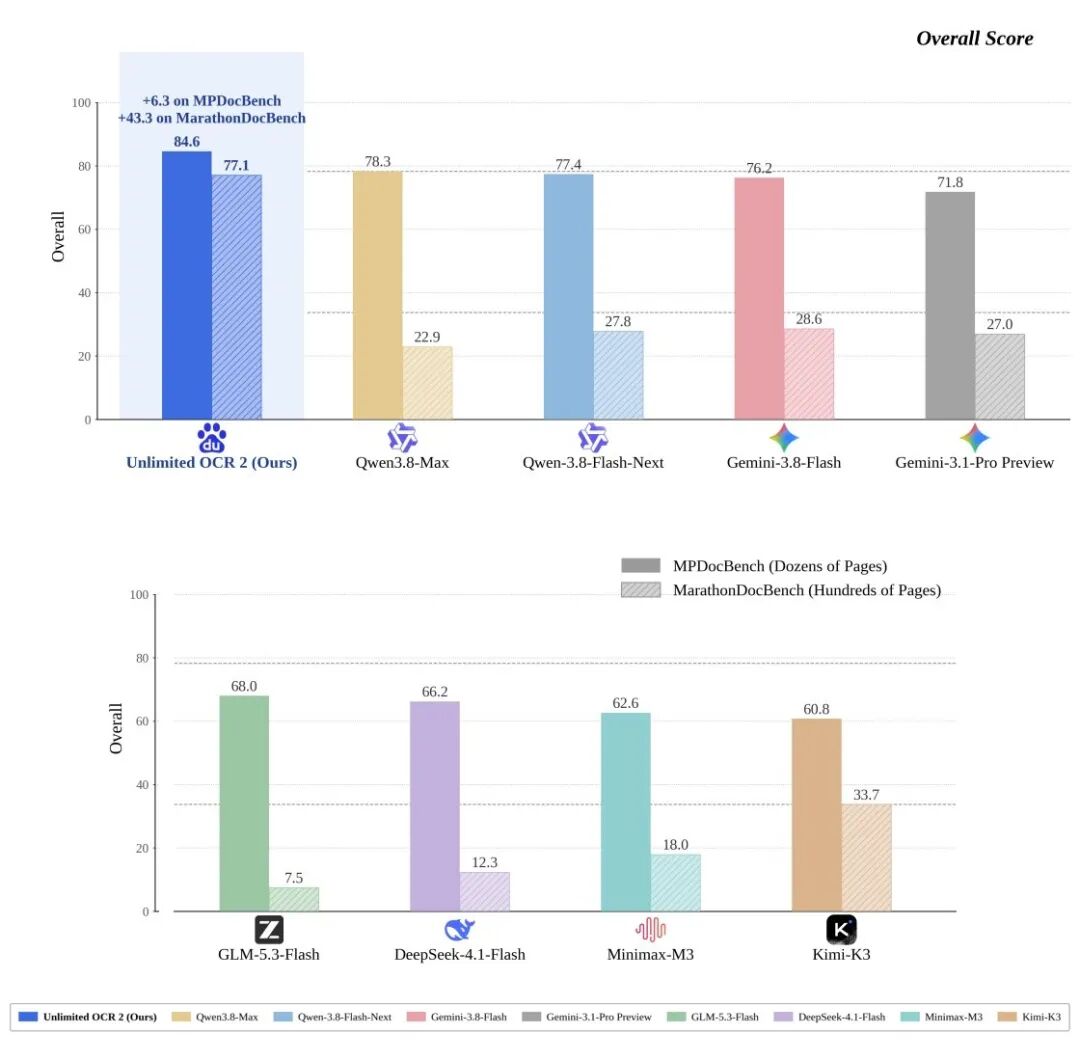
官方综合分数图,模型分组上下排;实心为数十页,斜线为数百页。分数不等于整书无错概率。
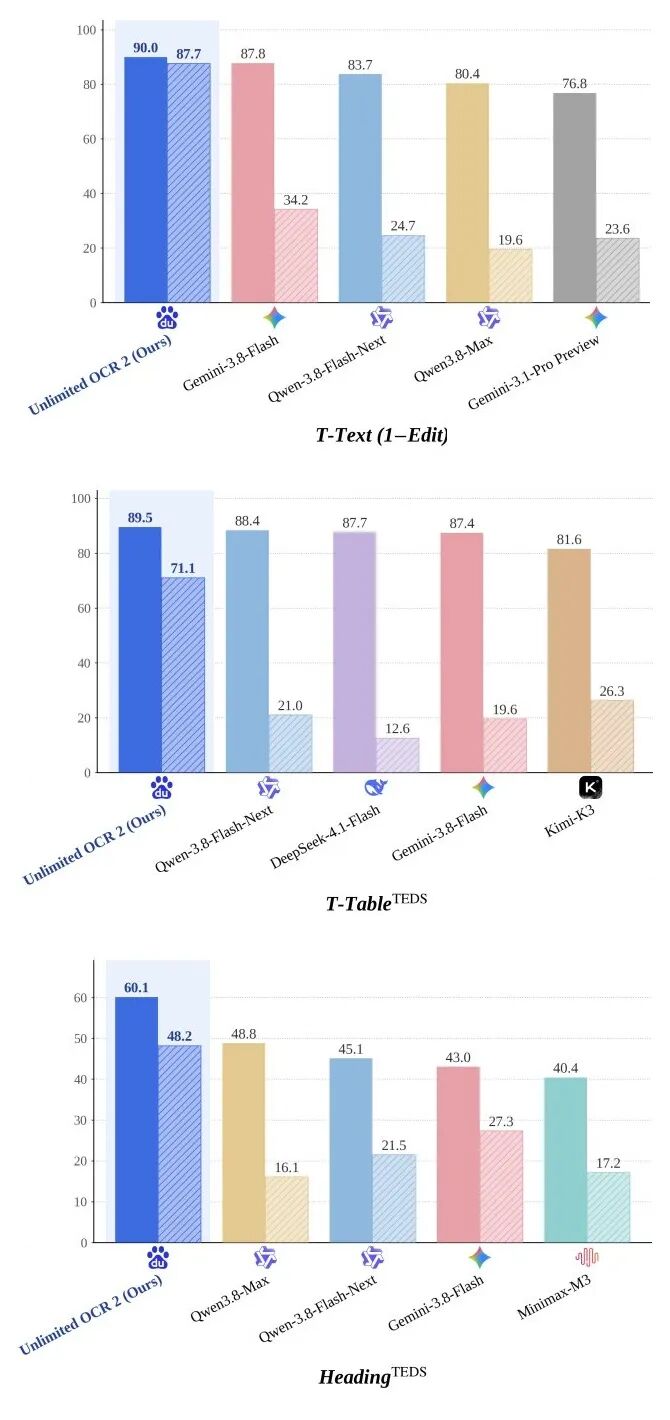
跨页文本、跨页表格与标题层级分项;实心和斜线对应同一组两套测试。
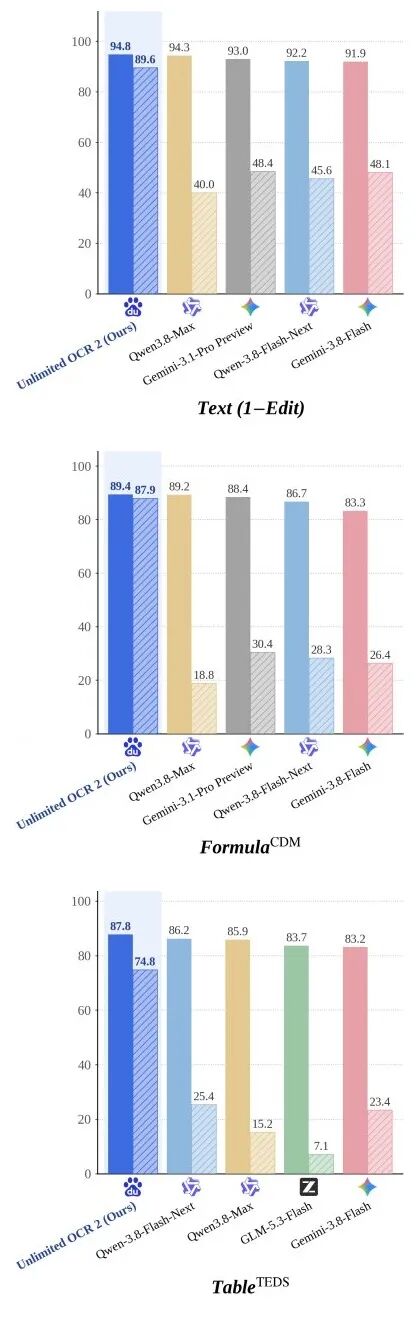
文字、公式和表格分项,按完整面板上下重排,数值越高越好。
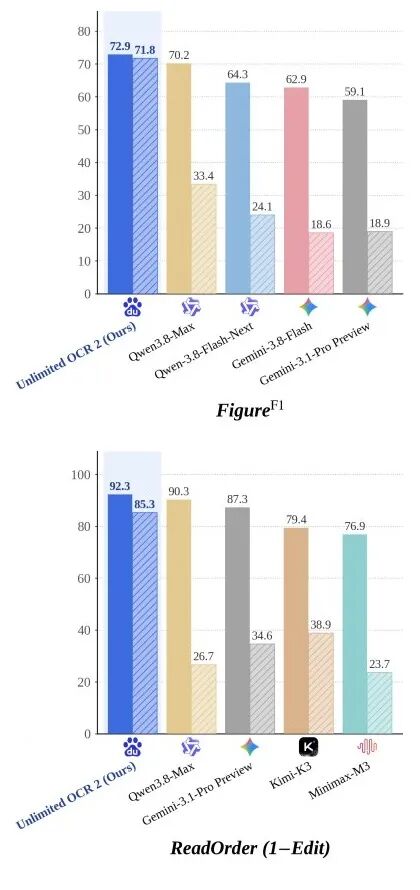
图区域与阅读顺序分项;实心为数十页,斜线为数百页测试。
在两套多页测试中,模型分别得到 84.59 和 77.06 分。前者 MPDocBench 测数十页,后者 MarathonDocBench 测百页。MarathonDocBench 是团队自建,包含 100 份文档、每份 103 至 300 页,成绩来自作者测试。
换到单页测试 OmniDocBench v1.6,它得到 94.02 分,低于 TeleOCR 的 96.91 分。作者也承认:稀疏读取没能完整保留全局信息,会影响标题层级。百页测试中的标题分项只有 48.20 分。
- 长文档解析领先,不代表单页识别或整书理解全面领先。
- 原图是分项得分展示,不可直接当成实际文档准确率。
开源能试,先核硬件与输出
代码和模型权重已经公开,标注 MIT 开源许可。二代支持开发框架 Transformers,以及面向部署的定制 SGLang。作者在配有 80GB 显存的 NVIDIA A800 上测试。这是测试环境,不等于最低要求,也不证明普通电脑一定能跑。
试用时,建议先拿有权处理的脱敏材料,重点检查漏页、跨页表格和标题层级。还要留意输出预算与窗口设置。模型原始输出带结构标记,并不是直接生成完整 Markdown。加载时会执行仓库自定义代码,部署前应先审阅。
- 仓库 6 月已有初代,这次是二代更新,不是项目首次开源。
- 旧版运行工具的支持记录,不能直接套在二代上。
主要来源:
- @Baidu_Inc 推文《Unlimited OCR 2发布》
- @Baidu_Inc 推文《代码与模型入口》
- 百度开源仓库《Unlimited OCR Works 2》
- 百度模型卡《Unlimited OCR 2》
- 百度文心团队论文《Unlimited OCR Works 2》
- 百度开源仓库《Post-processing》
 发表于 昨天 22:24
|
查看: 2|
回复: 0
 /1


