Datalab 团队(marker 与 surya 的作者)最近开源了 Indra OCR,一款主打“纯 CPU 高吞吐”的轻量 OCR 工具。仅凭约 18MB 的权重,它就能把 PDF 和图片快速转换为 Markdown、纯文本或带坐标边界的结构化 JSON。无论单核还是多核,推理速度都比同配置下的 Tesseract 和 PaddleOCR 快一个数量级。
要点
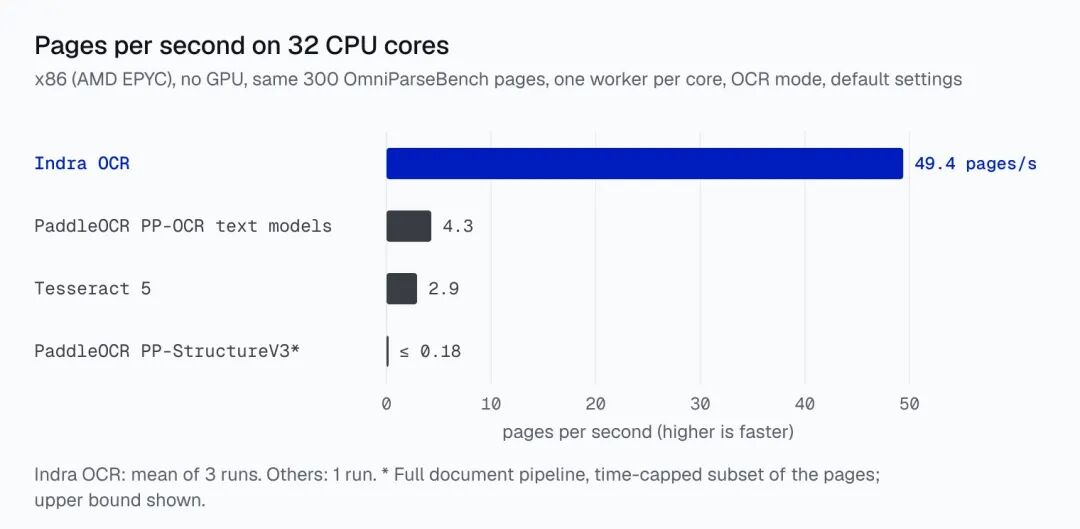
- 速度是核心王牌:在 32 核 x86 CPU 上吞吐量可达 49 页/秒;在 4 核虚拟 CPU 上,单页处理的中位延迟约为 230 毫秒。官方实测显示,同样机器、同样核数下,它比 Tesseract 和 PaddleOCR 快 11–24 倍。
- 模型极小且免装 PyTorch:识别主模型
rec.onnx 只有约 100 万参数,检测、识别和阅读顺序三个模型合计约 18MB。运行时仅依赖 ONNX Runtime、OpenCV 和 pypdfium2,不需要笨重的深度学习框架。
- 准确率有取有舍:在 OmniParseBench 上综合得分 62.1,略高于 PaddleOCR 完整流水线(PP-StructureV3 为 58.4);但基础纯文本识别只有 41.3,低于后者的 55.6。只有开启
--math 切换双模型流水线后,文本分数才会反超到 57.5。
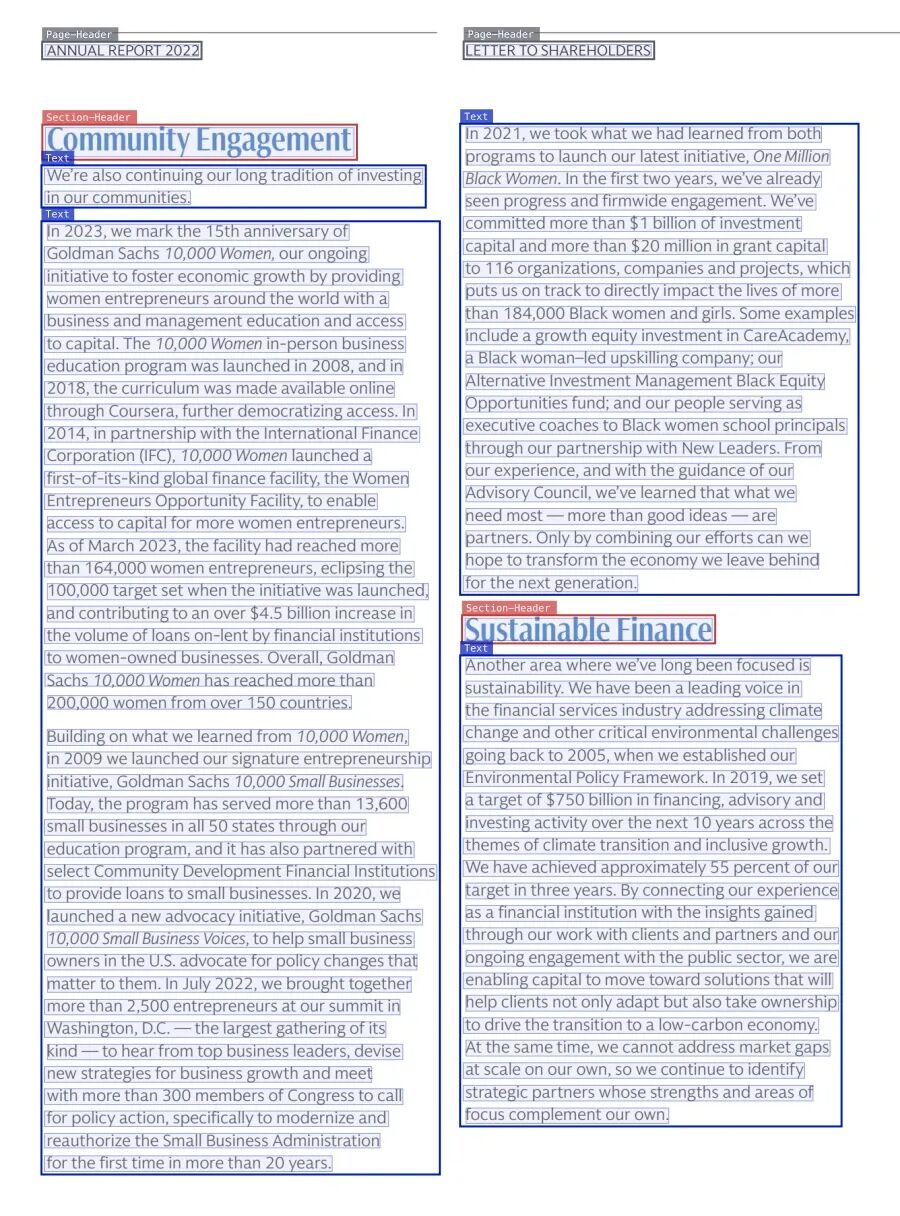
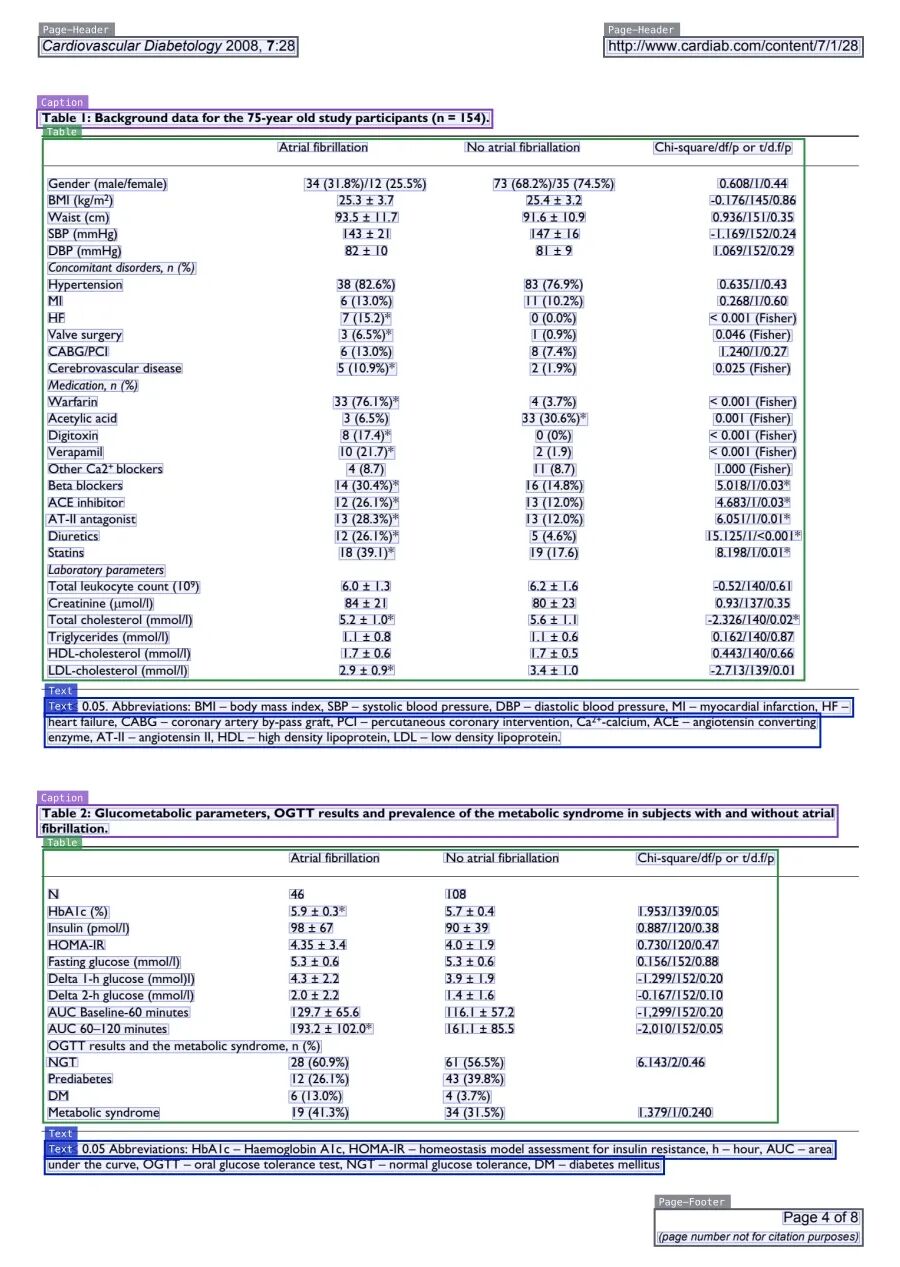
- 输出不只是文字:行级检测支持精确定位,每个版面区块都带有边界框、语义标签(正文、标题、列表、表格、图注、脚注、页眉页脚)和阅读顺序,可以直接作为 下游大模型 与知识库(RAG)的结构化输入。
- 数字版 PDF 走混合捷径:优先读取 PDF 原生文字层,只对扫描图或缺失部分执行 OCR。因此阿拉伯文、希伯来文、日文、韩文等语种在电子版 PDF 上都能完整保留原生字符,而且处理速度最快。
- 附赠本地可视化工具:自带轻量看板工具
indra-ocr-viewer,在本地启动后访问 localhost:8765,拖入 PDF 即可直观查看边框标注、版面分析块、阅读流向、Markdown 产物及分阶段耗时,文件全程不出本机。
- 定位非常明确:官方表示,主要场景是“干净印刷体 + 追求极致吞吐”。手写体(实测准确率约 8%)、无框或跨行复杂表格、老旧泛黄扫描件(准确率约 20%)以及竖排文字都不是它的主战场。复杂场景下,官方建议改用云端商业模型 Chandra。
上手
- 系统环境:需要 Python 3.10 及以上版本。官方目前主要在 Linux(x86_64、aarch64)和 macOS(Apple 芯片)上完成测试,Windows 未作充分验证;纯 CPU 就能跑满性能,无需独立 GPU 显卡。
- 安装形态:支持
pip install indra-ocr 一键安装。初次运行会自动从 Hugging Face 拉取约 18MB 基础模型并缓存;离线或内网环境需要预先下载模型目录,再通过环境变量 INDRA_OCR_MODEL_DIR 或命令行参数 --model-dir 指定路径。目前暂无独立打包的便携可执行文件。
项目代码采用 Apache-2.0 协议(模型权重为修改版 OpenRAIL-M),目前在 GitHub 上约有 600 Stars。
项目地址:https://github.com/datalab-to/indra
如果你也在关注轻量级 OCR 或文档解析实践,欢迎到 云栈社区 一起交流。 |  发表于 11 小时前
|
查看: 1|
回复: 0


