这次我们在 8 张 AMD MI308X 上对 GLM-5.3-Flash 做了一轮实测,主要想弄清楚三件事:单机实际能扛多少请求、打开 MTP 后推理是否更快,以及长上下文能不能稳定出结果。
结论先放在前面:短输入在 8.0 req/s 的到达率下,首字延迟 p95 为 594 ms。MTP 对低并发很有效,单请求生成速度提升约 47%,不过并发到 32 之后反而会拖慢一点。长文本这边问题更突出:vLLM 输入超过约 2K 就可能直接让推理进程退出;SGLang 测试版虽然能从 1M 长文本中找回信息,但速度还远达不到线上服务的要求。
一 · 测试环境
| 项目 |
配置 |
| GPU |
AMD Instinct MI308X × 8,单卡 192 GB |
| 运行时 |
ROCm 6.4.1 |
| 模型 |
GLM-5.3-Flash,原生 FP8 |
| 推理框架 |
vLLM,8 卡张量并行 |
| 压测工具 |
vllm bench serve |
| 生成设置 |
temperature=0 |
镜像和代码版本在整轮测试中保持不变。文本、图片和工具调用先做了冒烟测试,再跑固定并发与固定到达率两类压测。不同测试档使用不同随机输入,避免前缀缓存影响结果。
这里用到的几个指标:TTFT 是首字等待时间,TPOT 是首字之后平均生成一个 token 的时间,E2E 是整条请求的完成时间。
先看几组常见负载,延迟取中位数:
| 场景 |
并发 |
请求/s |
输出 tok/s |
TTFT |
TPOT |
| 单请求,128 in / 128 out |
1 |
0.55 |
70.5 |
171 ms |
13.0 ms |
| 长输出,128 in / 2,048 out |
16 |
0.36 |
732.1 |
367 ms |
21.7 ms |
| 512 in / 256 out |
32 |
4.26 |
1,090.0 |
1,448 ms |
23.7 ms |
| ShareGPT |
32 |
3.19 |
618.9 |
212 ms |
48.1 ms |
| 512 in / 256 out,全部同时提交 |
不限 |
12.19 |
3,120.8 |
11,695 ms |
117.5 ms |
| 工具调用 |
8 |
2.34 |
245.7 |
193 ms |
28.1 ms |
这几档共 1,312 条请求,全部成功。最后一档吞吐最高,但首字要等近 12 秒,只能看作压力上限,不能当作实际服务能力。
图片请求在并发 1 时 32 条全部成功,首字延迟中位数为 379 毫秒。并发升到 8 后,第 26 条请求触发了与长输入相同的故障,推理进程退出。
二 · 8 卡能跑到什么程度
固定并发只能测出“忙起来有多快”,不能判断请求队列会不会越积越多。因此我们又按固定速率持续发请求,负载为 512 in / 256 out。
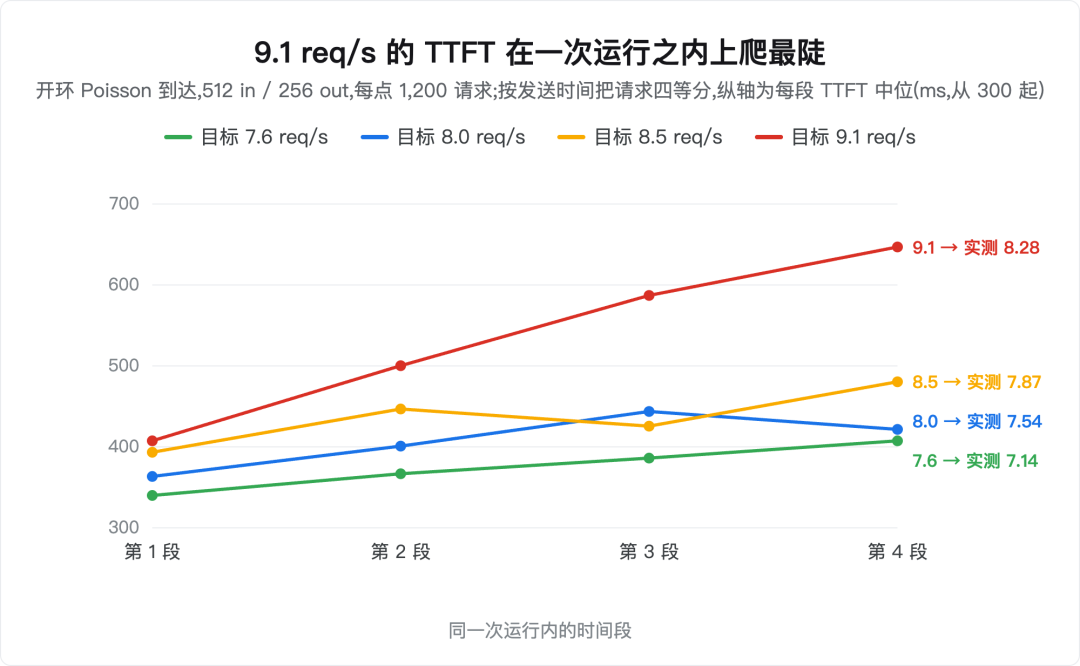
9.1 req/s 开始出现明显排队:同一轮测试后段的首字延迟中位数是前段的 1.59 倍。10.7 req/s 时排队趋势更明显,12.2 req/s 的首字延迟 p95 已升到 5.5 秒。
本轮把 8.0 req/s 作为较稳妥的工作点。这个点连续发送 1,200 条请求,结果如下:
| TTFT p50 / p95 |
TPOT p50 / p95 |
E2E p50 / p95 |
输出吞吐 |
| 410 / 594 ms |
117 / 132 ms |
30.35 / 34.09 s |
1,930 tok/s |
这里的 8.0 req/s 只代表这轮约 150 秒测试中的选择,不是长期容量承诺。它的首字延迟不错,但一条请求平均仍要约 29 秒完成,更适合后台任务,不算流畅的实时对话体验。
三 · MTP 不是并发越高越有用
MTP 会先猜几个 token,再由主模型一起确认。猜得准时可以少跑几轮解码,猜错的部分则是额外计算。
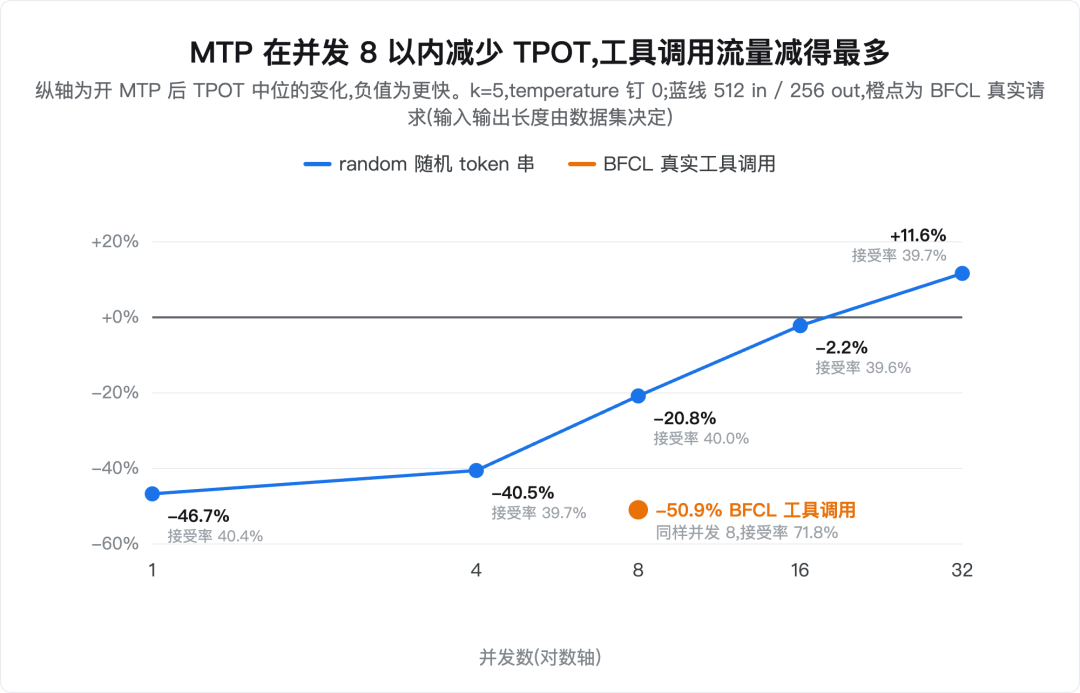
| 并发 |
TPOT:关闭 → 开启 |
E2E 中位数:关闭 → 开启 |
ITL p95:关闭 → 开启 |
| 1 |
13.94 → 7.43 ms |
3.72 → 2.09 s |
14.2 → 22.3 ms |
| 8 |
18.55 → 14.69 ms |
5.17 → 4.00 s |
19.1 → 182.4 ms |
| 16 |
19.90 → 19.46 ms |
5.80 → 5.36 s |
20.8 → 184.3 ms |
| 32 |
23.71 → 26.47 ms |
7.49 → 7.22 s |
25.0 → 187.9 ms |
单请求时,TPOT 降低 46.7%;并发 8 时仍有收益。到并发 16,收益已很小;并发 32 时 TPOT 反而增加 11.6%。
另一个现象是,开启 MTP 后 token 会成批返回。总完成时间可能更短,但流式输出的停顿更明显,所以 ITL p95 上升很多。面向聊天界面时,不能只看平均生成速度。
我们还跑了 GSM8K 全量 1,319 题。关闭 MTP 的正确率为 92.04%,开启后为 92.57%,这轮测试没有看到精度下降。
四 · vLLM 目前只能接短输入
在 vLLM 上做长文本测试时,1,900 和 2,040 token 能正常返回;2,100、3,000 和 4,096 token 都会让推理进程退出。同机正在处理的其他请求也会一起失败。
故障出在 gfx942 使用的稀疏注意力内核。输入不超过 2,048 token 时不会走到这段代码,超过后才触发,因此边界与模型配置中的 2,048 基本吻合。
我们尝试修正了内核中的类型转换问题。修完后 8K 输入可以返回,但长文本信息召回仍不可靠:7K 内的测试全部答对,到了 14K 和 31K,放在文本中部或后部的信息会漏掉或答错。相关的 block table 修复目前还没有合入 vLLM。
所以这版 vLLM 只适合在入口限制短输入。
RAG、多轮对话和文档问答很容易超过 2K,不应直接开放。
五 · SGLang 能读 1M,但还跑不动
我们也试了 SGLang。现有发布镜像和 nightly 都无法直接运行 GLM-5.3-Flash:一个在启动预热时失败,另一个在第一条请求时失败。最终能正常计算的是社区 PR 使用过的测试代码,并非正式发布版。
在这版代码上,我们把六位数口令分别放在长文本的前部、中部和后部,再让模型找出口令:
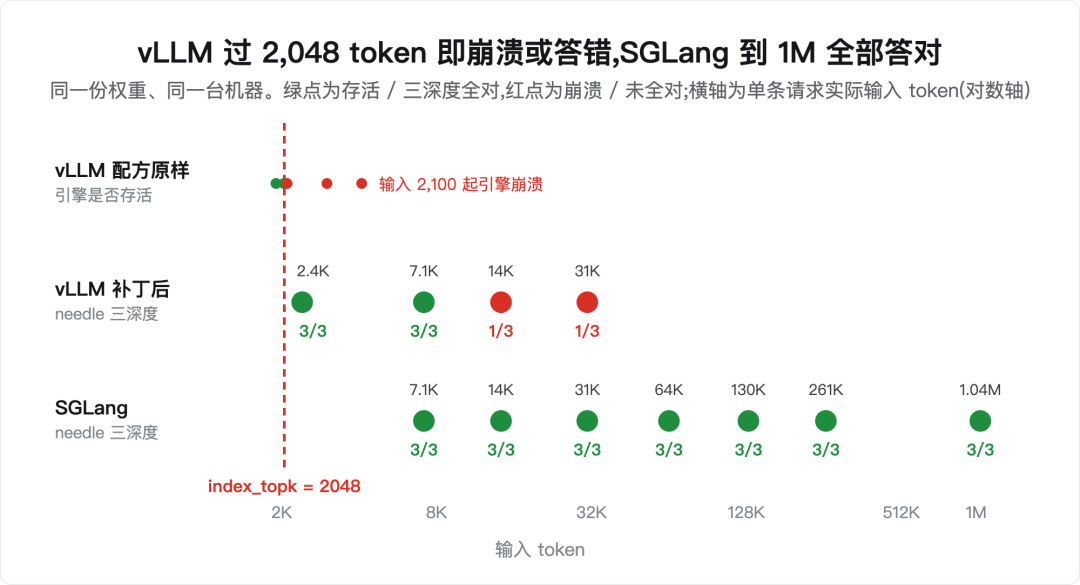
7K、14K、31K、64K 和 261K 的测试全部答对。1M 输入在减小分块大小后也全部答对,说明模型和硬件本身具备长文本召回能力。
问题在速度。单请求 128 in / 128 out 时,SGLang 的首字延迟中位数为 560 毫秒,TPOT 为 272 毫秒,只有 3.64 tok/s;同一台机器上的 vLLM 分别是 171 毫秒、13 毫秒和 70.5 tok/s。
长文本的结果也类似:
| 输入长度 |
TTFT 中位数 |
TPOT 中位数 |
输出 tok/s |
| 4K |
4.5 s |
271 ms |
8.80 |
| 16K |
17.2 s |
277 ms |
8.51 |
| 64K |
57.1 s |
455 ms |
4.50 |
| 256K |
294.4 s |
1,567 ms |
1.04 |
1M 的单条请求需要约 18 到 19 分钟。它证明了“能算对”,但离线上服务还有很大距离。
参考链接
本文数据来自单机测量,结果只对应文中硬件和软件版本。
 发表于 昨天 21:25
|
查看: 3|
回复: 0


