要点速览
- 优化对象:在 AMD Instinct MI355X 上,使用 InferenceX 的 AgentX 基准测试 GLM-5.2-MXFP4 服务。根据负载分段启用 ROCm HiCache,并将 DSA indexer 的多次启动合并为融合 kernel。
- 关键数字:从 8 月 11 日基线扫描到 10 月 6 日最终扫描,峰值每 GPU 吞吐从 10,625 提升至 18,327 tokens/s,达到原来的 1.72 倍;并发为 1 时,峰值 P90 交互性从 110.25 提升至 271.00 tokens/s/user,达到原来的 2.46 倍。
- 主要机制:高并发下,将 FP8 MLA 的 KV 数据卸载到主机 DRAM,扩大有效缓存容量并减少重复 prefill;工作集仍能放入 GPU 时,将 DSA indexer 的十二次启动收敛为四个 HIP kernel,更快结束一轮并释放 KV 页。
两次扫描的峰值每 GPU 吞吐分别出现在并发 10 和并发 16,数值从 10,625 提升到 18,327 tokens/s。两次的最高 P90 交互性均出现在并发 1,从 110.25 提升到 271.00 tokens/s/user。
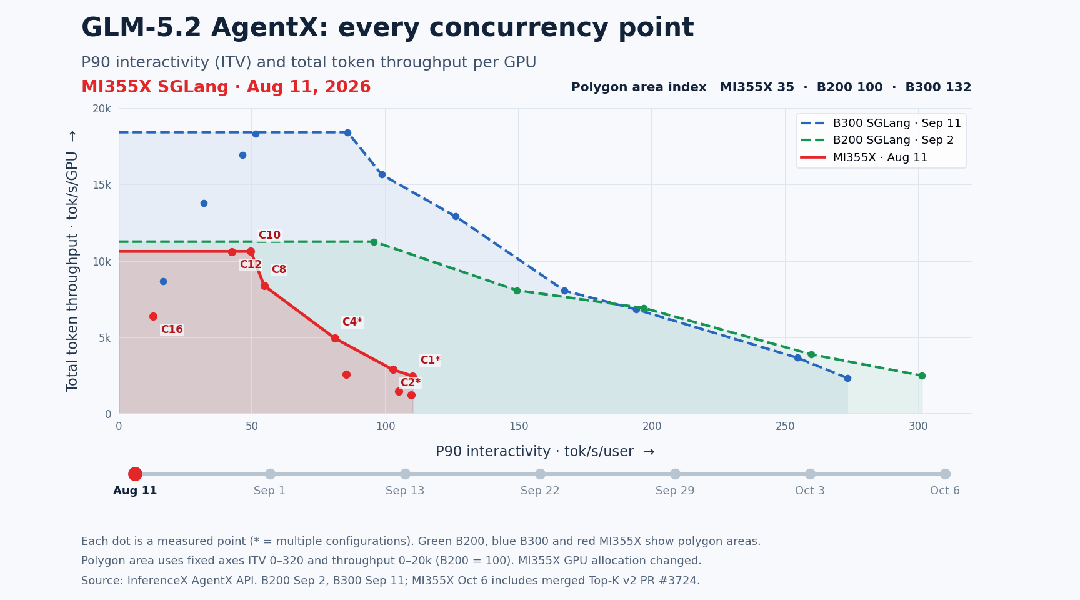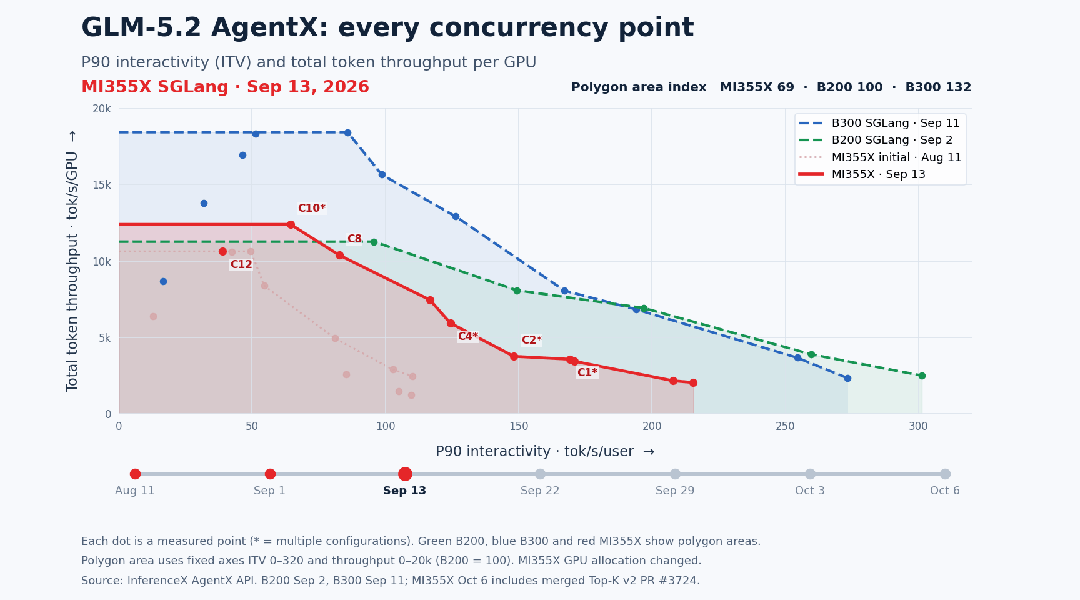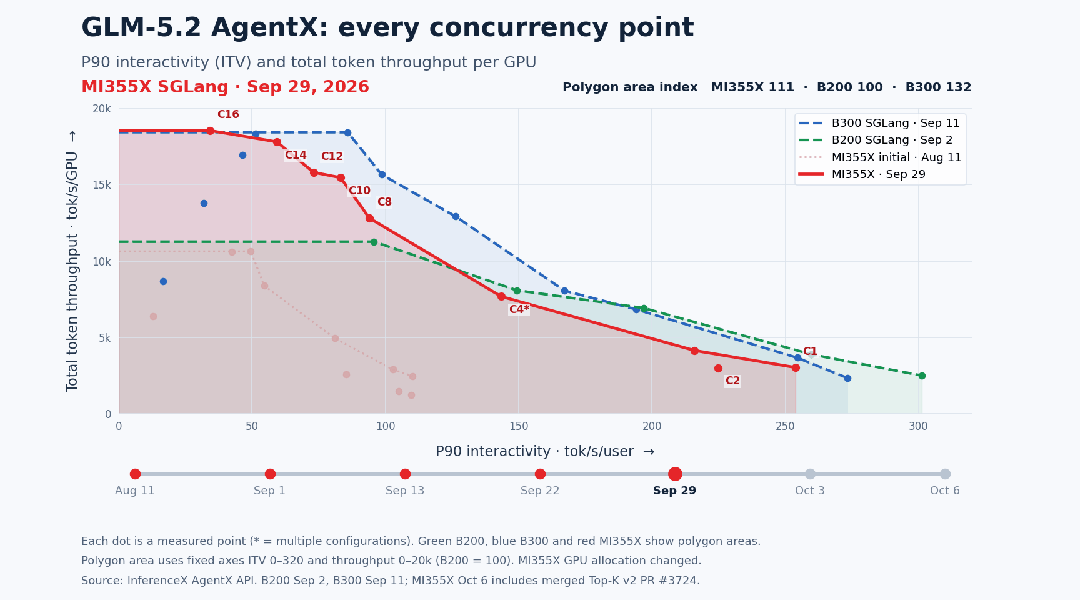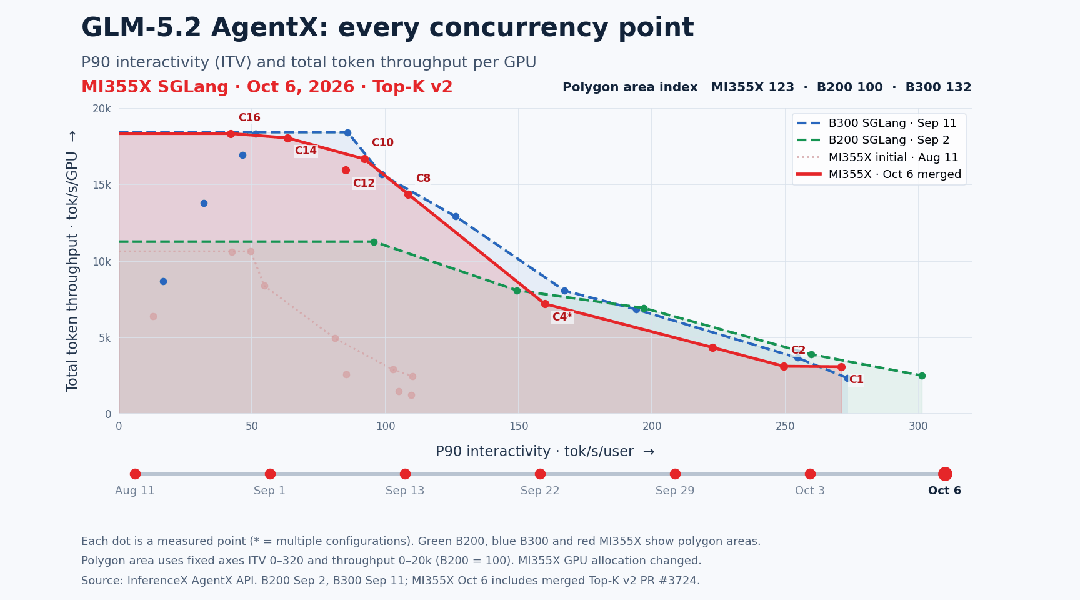
图 1:每个标记都是实测并发点。绿色为选定的 B200 参照,蓝色为 B300,红色跟踪 MI355X 随时间的变化。标记之间的连线仅作视觉插值,不代表额外测点。MI355X 的 GPU 分配在不同时间点有所变化。
AgentX 评测
AgentX 重建用户选择分享的 Claude Code 会话,不包含原始提示、代码或工具载荷。其 v1.0 语料包含 393 个会话;中位请求约有 142,000 个输入 token 和 444 个输出 token,44% 的会话包含子代理。共享前缀与长上下文会同时考验 KV 容量和复用效率。
AgentX 以闭环方式回放完整对话:每个客户端只有在上一轮响应结束后才会发出下一请求。并发数统计的是活跃的 agent 客户端,公开的分析窗口为缓存预热后的 3,600 秒。服务越快,一小时内就能将对话推进得越远。回放使用合成载荷,衡量的是服务过程,而不是回答质量。
定位瓶颈
在本次配置中,并发超过 12 时,活跃 KV 工作集接近 GPU 缓存容量。SGLang 的分层 KV缓存 HiCache 会在数据无法全部留在 GPU 时,将 KV 卸载到主机 DRAM。其 ROCm 拷贝路径打通了本次所用 FP8 MLA 缓存行的主机内存传输,扩大有效缓存容量,并减少重复 prefill。
当工作集仍能放进 GPU 缓存时,更快的 decode 可以让一轮请求更早结束,释放 KV 页供后续请求使用。这一边界取决于模型和具体服务配置,并非 MI355X 的普适阈值。
分析 P90 ITV 时,需要查找耗时较长的 prefill 算子、decode 算子和调度停顿。先分别统计输入与输出 token 吞吐,再核对 KV 占用、缓存命中率、提示 token 来源、队列深度、首 token 时延,以及 P90 token 间隔时延 ITL。ITV 的单位是 tokens/s/user,越高越好;ITL 是相邻 token 的间隔时间,越低越好。
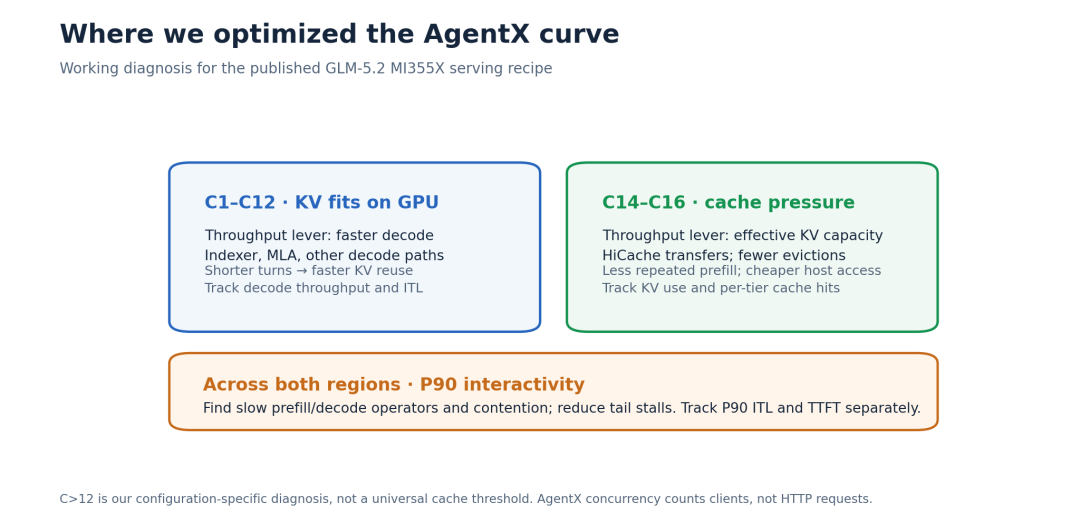
图 2:该 GLM-5.2 MI355X 配方的工作诊断。并发 12 以下也可以启用 HiCache;图中的边界表示在本次测量中,缓存压力开始成为吞吐主导约束的位置。
对可疑机制,先在固定 shape 上验证,再通过受控的 AgentX A/B 测试筛选,最后用完整的一小时扫描确认服务结果。每次对照都记录基线镜像、模型、并发、缓存模式和推测接受设置。
服务与缓存改进
公开的 InferenceX 配方在三个较低负载点使用 TP8/EP1 且 KV 驻留 GPU,在六个较高负载点使用 TP4/EP4 并启用 HiCache 的 DRAM 卸载。配方采用 FP8 KV 缓存,以及五步 EAGLE MTP、每次六个 draft token;随模型发布的 GLM-5.2 NextN draft head 仍保持 BF16。独立的 SGLang GLM-5.2 cookbook 记录了对应的服务镜像。
ROCm HiCache 的改动修正了已注册主机指针的处理,为 576 字节的 FP8 多头潜在注意力 MLA 行以及仅含 K 的主机池启用了即时编译拷贝路径,并提高了映射主机传输的 HIP JIT block 配额。这些改动使缓存搬运得以启用并得到改进,但不能单独给出每项改动在 AgentX 中的百分比收益。
在记录 GPU 工作以便回放的 HIP graph 捕获中,相关改动启用了 prefill 阶段用到的 DeepSeek Sparse Attention(DSA)head-gate 辅助路径,以及融合的 DSA 元数据 kernel,从 DSA decode 路径中去掉了重复的 query 拼接与权重运算。
合入的融合 indexer 在受控 AgentX A/B 测试中,将 P90 ITL 从 3.81 ms 降至 3.56 ms,降幅为 6.7%。编码代理缩短了从性能剖析发现瓶颈到获得可测试候选方案的过程。Indexer 与 MLA 相关工作使用了 HyperLoom;工程师负责选定改动、检查数值行为,并在 SGLang 和 AgentX 中完成验证。
HyperLoom 辅助的算子优化
从实测 AgentX 瓶颈到上游合入,流程如下。
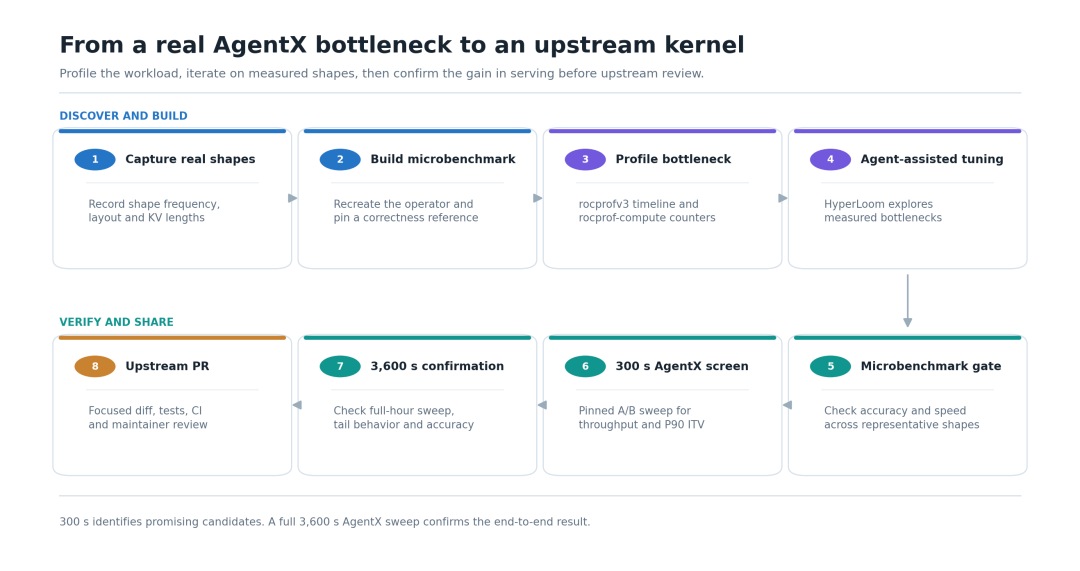
图 3:300 秒扫描用于筛选已集成的候选方案,3,600 秒扫描用于确认端到端结果。
- 采集真实 shape:记录 prefill 与 decode 的 shape、布局、KV 长度和出现频率。
- 搭建微基准:使用固定基线和正确性参照,复现有代表性的 shape。
- 进行性能剖析:用 rocprofv3 查看时序,用 rocprof-compute 查看计算与访存行为。
- 与代理一起迭代:HyperLoom 针对测得的瓶颈探索候选方案。
- 再次核对微基准:在有代表性的 shape 上重复正确性和速度测试。
- 在 AgentX 中筛选:使用固定配置进行 300 秒 A/B 扫描,比较吞吐和 P90 ITV。
- 完成一小时确认:运行 3,600 秒扫描,检查尾部行为与精度。
- 向上游合入:提交聚焦的补丁,附带测试、速度证据、消融结果和持续集成审查。
融合 indexer 展示了这一流程背后的算子级搜索。内部 HyperLoom 记录跟踪了约 16 个有效 kernel 工作小时内的 11 个候选阶段,对象是一个有代表性的 AgentX decode shape,如下图所示。有效时间只统计 kernel 优化本身,不包括无关工作。
该 shape 的 kernel 时延从 91.24 µs 降至 35.56 µs,加快 2.57 倍;相对内部工程屋顶线的达成率从 33.1% 升至 85.0%。这条屋顶线是对该 kernel 可达性能的工程估计。分阶段微基准测量与服务侧 A/B 结果相互独立。
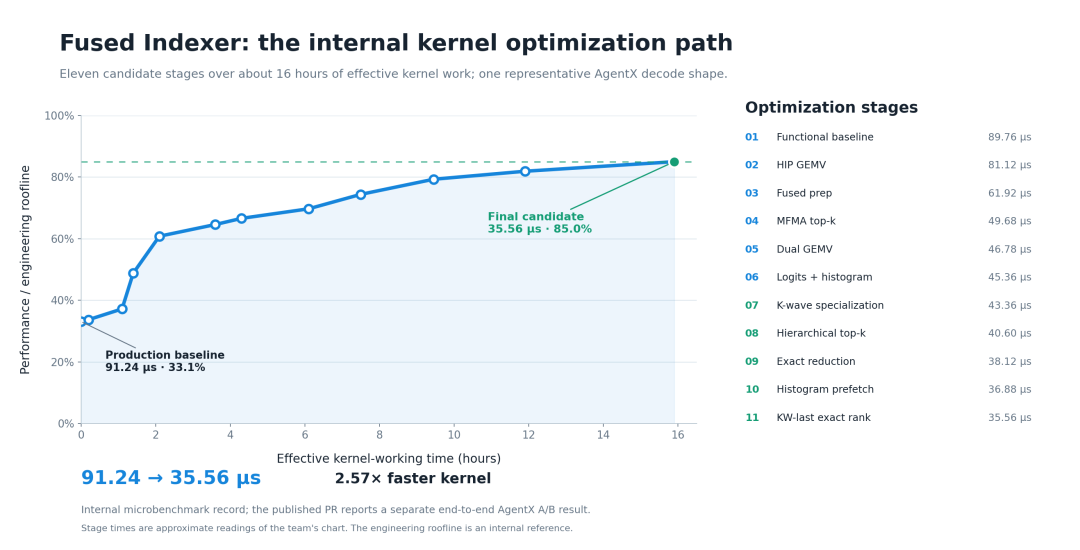
图 4:内部微基准记录。各阶段位置近似对应团队优化记录中的有效 kernel 工作时间。屋顶线是工程参照,不是 AgentX 基准指标。
合入后的实现在满足 gfx950、AITER preshuffle 以及 GLM-5.2 indexer shape 等条件时,将原先需要十二次启动的 DSA indexer decode 链路收敛为四个 HIP kernel;其他路径仍使用原有实现。GLM-5.2 在每一步 decode 中,会在 78 层以及 MTP draft 层上调用 indexer。
单臂运行 1,200 秒、并发为 1 的 AgentX A/B 测试显示,P90 ITL 下降 6.7%,P50 与 P99 分别下降 4.7% 和 6.6%。另有上游工作将 MLA 的 query 吸收与 RoPE、KV 写入融合,并在 gfx950 上调优稀疏 MLA。这些改动的收益基于不同基线,不能简单相加。
从本地结果到上游合入
内部集成工作使不同组合能够较快完成测试,编码代理也加快了 kernel 方案探索。要进入公开的 AgentX 结果,改动还需要经过 SGLang 代码审查,以及 InferenceX 对带版本服务镜像的审查。实践中形成了以下做法:
- 界定瓶颈并保持改动聚焦:写明受益的操作和工作负载 shape。限制对共享路径的改动;当优化绑定特定硬件时,加上硬件守卫。
- 选择值得审查的改动:提交带有实测性能收益的改动,同时包含使该配置能够运行所需的正确性或缓存能力;探索性变体不放进最终补丁。
- 让证据与主张匹配:使用相关的正确性或模型质量测试、kernel 微基准和受控 AgentX 对照。改动相互影响时,用消融隔离各自作用,而不是将组合收益归于单个补丁。
- 对照基线处理持续集成失败:遵循各项目的审查规则,在补丁和上游主线上复现失败,检查测试是否覆盖被改路径,并修复由补丁引入的失败。
- 在 SGLang 与 InferenceX 之间协同:SGLang 的 AMD 团队与维护者审查框架和 kernel 改动。InferenceX 团队要求每次扫描都使用已公开发布的镜像,例如每日构建,并将运行时使用的全部服务参数和环境变量写进公开配方。
按优化方向合入的改动
这些已合入改动同时包含性能、正确性和使能工作,单项效果不能加总。10 月 6 日的曲线使用 9 月 30 日的服务镜像,因此更晚合入的代码不包含在这条曲线中。
- 算子:DSA top-k、MoE 路由、MLA 融合、融合 indexer、稀疏 MLA、draft MoE、grouped top-k、FP8 indexer writer,以及 decode tile 与路由。
- Graph:HIP DSA graph 辅助路径,以及 DSA 元数据与 absorb 路径。
- HiCache:主机指针处理、即时编译拷贝与仅含 K 的主机池、HIP block 配额。
- 其他:路由偏置、EAGLE 采样、模型加载、跨 GPU AllReduce 融合。
InferenceX 配方还合入了带版本服务镜像的更新,并启用了 top-k v2 kernel。
结语
后续工作将降低高并发下的 HiCache 传输开销,继续调优最慢的 prefill 与 decode kernel,再通过完整的 AgentX 扫描给出可独立核对的影响。
端到端部署结果来自多处改动的组合,不能将整条曲线归因于某一个融合算子或一次扫描。只有受控 A/B 才能隔离单次算子改动;公布结果时,仍需写明对照基线与镜像版本。
来源
参考: https://rocm.blogs.amd.com/software-tools-optimization/glm52-agentx-mi355x/README.html
相关阅读
 发表于 2 小时前
|
查看: 9|
回复: 0
 /1


