要点速览
- 隐藏变量:压测推理引擎时,影响结果的不只是内核速度,还有 KV Cache 分到了多少显存。缓存满后,并发继续增加,请求可能只能排队,首 token 延迟也随之上升。
- 同样设置 90%,容量差约两倍:本次测试中,vLLM、SGLang 和 TensorRT-LLM 分给 KV Cache 的容量分别为 35,328、60,954 和 71,552 个 token。若不对齐预算,基准结果也会受到显存分配差异的影响。
- 长上下文排名翻转:在等 KV 预算测试中,TensorRT-LLM 的吞吐为 25.1 tok/s;只将其缓存从 35,328 提高到 71,552 个 token 后,吞吐升至 81.8 tok/s。下文给出三种引擎的设置方法和对比清单。
压测推理引擎时,一个容易被忽略的数字是 KV Cache 分到了多少显存。它影响能有多少请求同时生成:缓存一满,多余请求可能需要排队,吞吐不再增长,首 token 延迟也会增加。
不同引擎默认给 KV Cache 预留的空间并不一样。即使使用看似相同的显存设置启动,实际能同时处理的请求数也可能相差一倍。下面用 Qwen3-32B 在一块 48 GB NVIDIA L40S 上的测试,说明这种影响,并介绍各引擎如何设置和核对 KV Cache。
三引擎对比采用 FP8 KV Cache、35,328 个 token 的统一上限,以及相同的序列与调度限制。长上下文测试还单独调整 TensorRT-LLM 的 KV 预算,观察预算变化如何影响结果。
KV Cache 到底有多大
请求中的每个 token,都需要在每个注意力层为每个 KV 头保存一个键向量和一个值向量。单个 token 的缓存大小计算如下:
每个 token 的字节数 = 2(K 与 V)× 层数 × KV 头数 × 头维度 × 每个元素的字节数
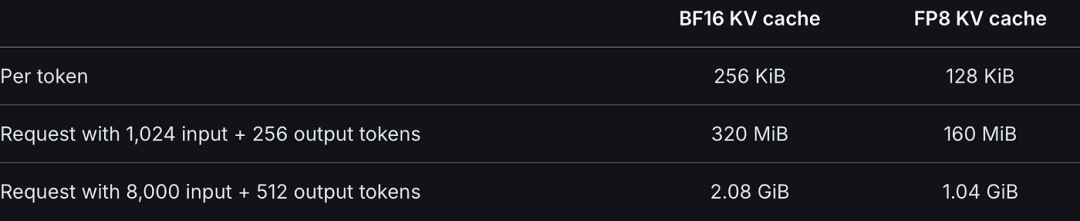
图 1:BF16 和 FP8 KV Cache 分别占用 256 KiB 和 128 KiB 每 token。1,024 输入加 256 输出的请求分别占 320 MiB 和 160 MiB;8,000 输入加 512 输出的请求分别占约 2.08 GiB 和 1.04 GiB。
Qwen3-32B 有 64 层、8 个 KV 头,头维度为 128,因此每个 token 需要存储 131,072 个值。
一个长请求即使用 FP8 存储 KV Cache,也需要超过 1 GiB。与 BF16 相比,FP8 的每 token 缓存占用减半,相同显存理论上可以容纳两倍的 token。vLLM 和 SGLang 如果没有指定 KV Cache 的数据类型,会按模型计算数据类型存储缓存;Qwen3-32B 的计算类型是 BF16,即使权重已经量化为 FP8 也是如此。
def kv_bytes_per_token(layers=64, kv_heads=8, head_dim=128, bytes_per_element=1):
    return 2 * layers * kv_heads * head_dim * bytes_per_element

gib = 35_328 * kv_bytes_per_token() / 2**30
print(f"{gib:.2f} GiB")  # 4.31 GiB,TensorRT-LLM 对应的日志值
权重剩多少,KV Cache 就拿多少
在这组测试中,KV Cache 使用权重、激活和 CUDA 图等占用之后剩余的显存。对于一块 48 GB 显卡,权重格式本身就会显著影响缓存容量。下图对比了 vLLM 加载三种 Qwen3-32B 检查点时的显存分配,三者均设置 --gpu-memory-utilization 0.90 并使用 FP8 KV Cache。
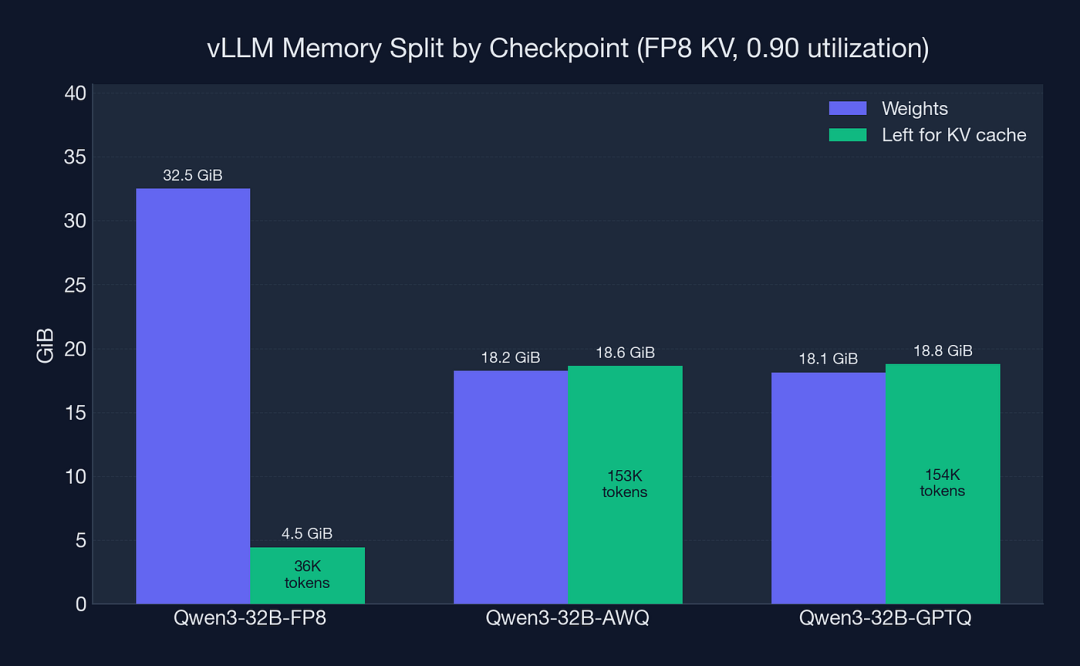
图 2:FP8 权重占约 32.5 GiB,KV Cache 剩约 4.5 GiB,容量约 36,000 个 token;AWQ 和 GPTQ 权重各占约 18 GiB,KV Cache 分别剩 18.6 GiB 和 18.8 GiB,容量约为 153,000 和 154,000 个 token。
FP8 检查点的权重占用 32.5 GiB,只给 KV Cache 留下约 4.45 GiB,即约 36,000 个 token,大致能容纳 28 个短请求。4 位 AWQ 和 GPTQ 检查点的权重只占约 18 GiB,留给缓存的空间是前者的四倍多。
不设缓存上限时,拿这些检查点做基准,结果不仅反映量化格式,也反映可用批量大小。将 KV Cache 都限制到 35,328 个 token 后,AWQ 和 GPTQ 仍比 FP8 快 1.44 至 1.49 倍:格式本身确实有影响,但需要与缓存容量的影响分开看。
每个引擎预留的容量不同
三个引擎都有类似“使用 90% 显存”的设置,但参数含义不同:
- vLLM:
--gpu-memory-utilization 指整个实例可使用的 GPU 显存比例。权重、激活和 CUDA 图先从中扣除,KV Cache 使用剩余部分。
- SGLang:
--mem-fraction-static 指权重和 KV Cache 池可使用的 GPU 显存比例;激活和 CUDA 图使用这一比例之外的显存。
- TensorRT-LLM:
free_gpu_memory_fraction 指引擎加载后,从剩余空闲显存中分给 KV Cache 的比例。
使用相同的 Qwen3-32B FP8 权重和 FP8 KV Cache,三个参数都设为 0.90,结果如下:
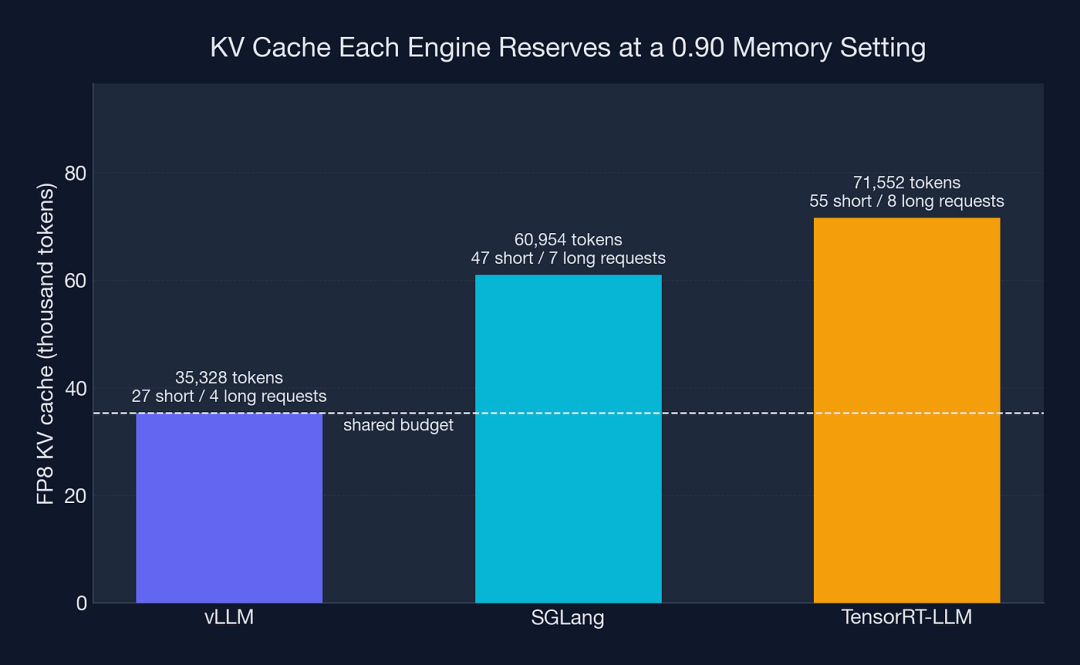
图 3:vLLM 预留 35,328 个 token,可容纳约 27 个短请求或 4 个长请求;SGLang 预留 60,954 个 token,可容纳约 47 个短请求或 7 个长请求;TensorRT-LLM 预留 71,552 个 token,可容纳约 55 个短请求或 8 个长请求。虚线表示等预算对比采用的共享预算。
在这组名义设置下,TensorRT-LLM 给 KV Cache 留出的容量约为 vLLM 的两倍。高并发测试中,这会直接影响同时运行的请求数。
为了比较引擎,下面将三者都限制到 35,328 个 token。使用各自默认设置做测试也有意义,但结果反映的是整个配置下的表现,其中包含各引擎预留缓存容量的差异,不能只归因于引擎执行速度。
如何设置和核对 KV Cache
下面是等预算测试使用的设置。各引擎会在日志中报告最终分配的容量,核对时应查看实际日志,而不是只看参数字面值。
vLLM
vllm serve Qwen/Qwen3-32B-FP8 \
  --gpu-memory-utilization 0.90 \
  --max-model-len 9216 \
  --max-num-batched-tokens 8192 \
  --kv-cache-dtype fp8 \
  --num-gpu-blocks-override 2208  # 2,208 blocks × 16 tokens = 35,328 tokens
本次测试中,vLLM 按每块 16 个 token 分配 KV Cache,因此通过块数设置上限。日志会报告可用显存、覆盖前的块数和最终容量:
Available KV cache memory: 4.45 GiB
Overriding num_gpu_blocks=2278 with num_gpu_blocks_override=2208
GPU KV cache size: 35,328 tokens
由于 vLLM 启动时会先进行显存 profiling,自然块数在不同启动间可能小幅浮动,本次测试中为 2,208 至 2,278 块。这也是显式设置容量的另一个理由。/metrics 上的 vllm:cache_config_info 指标会报告 num_gpu_blocks 和 cache_dtype。
SGLang
python -m sglang.launch_server \
  --model-path Qwen/Qwen3-32B-FP8 \
  --mem-fraction-static 0.90 \
  --context-length 9216 \
  --chunked-prefill-size 8192 \
  --kv-cache-dtype fp8_e4m3 \
  --max-total-tokens 35328 \
  --enable-metrics
SGLang 会在日志中记录分配的缓存池,以及 K、V 各自占用的空间:
KV Cache is allocated. #tokens: 35328, K size: 2.16 GB, V size: 2.16 GB
max_total_num_tokens=35328, chunked_prefill_size=8192, ...
启用 --enable-metrics 后,可以通过 sglang:max_total_num_tokens 和 sglang:token_usage 查看容量与占用情况。
TensorRT-LLM
在 TensorRT 后端中,KV Cache 的数据类型是引擎的一部分,需要在量化检查点时确定:
python examples/quantization/quantize.py \
  --model_dir Qwen3-32B --output_dir Qwen3-32B-FP8-checkpoint \
  --qformat fp8 --kv_cache_dtype fp8 --dtype bfloat16 --tp_size 1 \
  --calib_size 128 --calib_max_seq_length 512 --batch_size 1

trtllm-build --checkpoint_dir Qwen3-32B-FP8-checkpoint --output_dir Qwen3-32B-FP8-engine \
  --max_batch_size 64 --max_seq_len 9216 --max_num_tokens 8192 --opt_num_tokens 4096 \
  --gemm_plugin auto --gpt_attention_plugin auto
启动时,通过 --extra_llm_api_options 指定缓存配置。kv_cache.yaml 的内容如下:
kv_cache_config:
  free_gpu_memory_fraction: 0.9
  max_tokens: 35328
trtllm-serve serve Qwen3-32B-FP8-engine --backend tensorrt \
  --tokenizer Qwen/Qwen3-32B-FP8 --max_batch_size 64 \
  --extra_llm_api_options kv_cache.yaml
max_tokens 为缓存设置上限;同时给出两个设置时,容量取较小的限制值。启动日志会确认最终分配结果:
[MemUsageChange] Allocated 4.31 GiB for max tokens in paged KV cache (35328).
KV 预算如何影响测试结果
以下三引擎测试均使用 FP8 KV Cache、35,328 个 token 的上限,以及相同的序列与调度限制。除特别注明外,每个请求包含 1,024 个输入 token 和 256 个输出 token。
并发达到缓存上限后不再起作用
35,328 个 token 理论上能容纳约 27.6 个长度为 1,280 token 的请求。观察同时处于生成阶段的请求数可以发现:无论客户端并发为 32 还是 64,各引擎都在略低于这个数量的位置趋于平稳。
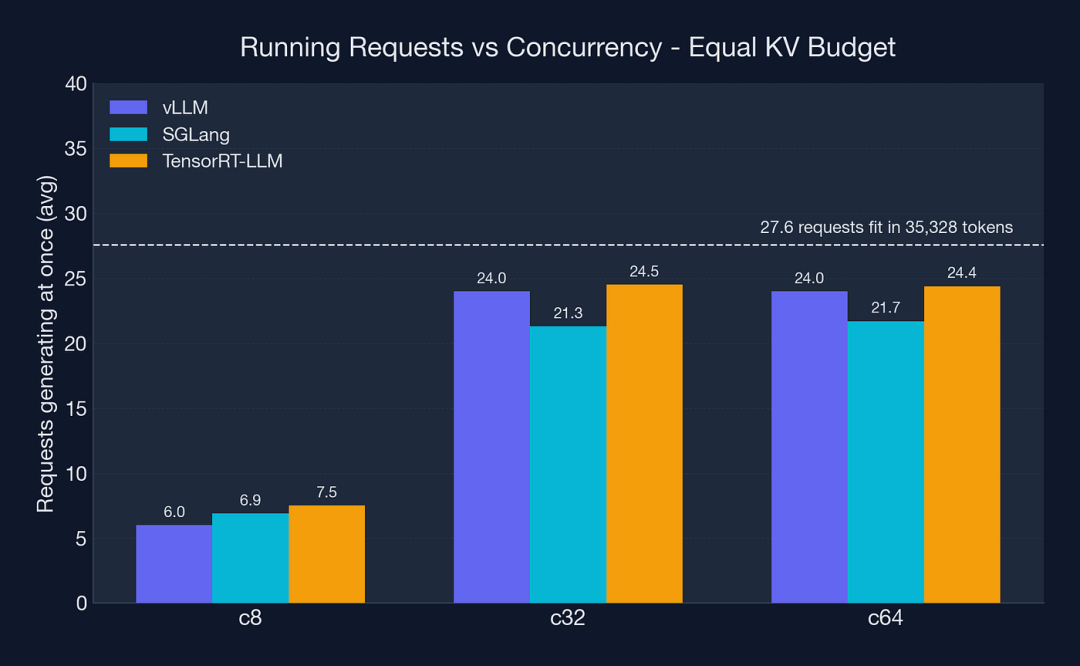
图 4:并发为 8 时,vLLM、SGLang 和 TensorRT-LLM 平均分别有约 6.0、6.9 和 7.5 个请求同时生成;并发为 32 和 64 时,三者约为 21 至 25 个,均低于理论容量线 27.6。
三个引擎平均同时运行的请求数都没有超过约 25 个。并发从 32 增加到 64 时,三者吞吐均只增加不到 1.5%,平均首 token 延迟却增加了 3.7 至 4.8 倍。额外的客户端主要拉长了队列。
首 token 延迟中的排队时间
vLLM 和 SGLang 会导出每个请求首次被调度前的等待时间。并发为 64 时,等待空闲槽位占据了首 token 延迟的大部分:
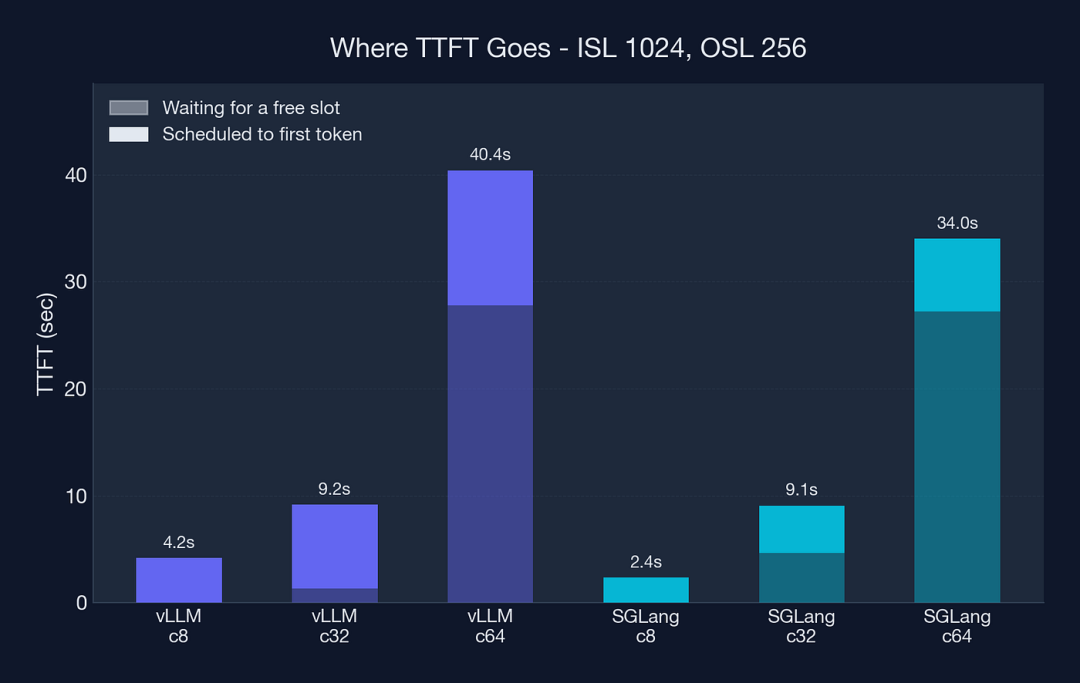
图 5:输入 1,024、输出 256 个 token 时,并发 64 下 vLLM 的平均首 token 延迟为 40.4 秒,其中 27.8 秒用于排队;SGLang 为 34.0 秒,其中 27.2 秒用于排队。
在这个负载下,首 token 延迟不仅反映提示词处理速度,也反映缓存能容纳多少请求,以及调度器如何排队。如果只报告负载下的首 token 延迟,而不报告排队占比,就容易忽略这一差异。
长上下文:预算变化能翻转排名
长请求会放大缓存容量的影响。8,000 个输入 token 加 512 个输出 token 的请求,需要约 8,520 个 token 的缓存;35,328 个 token 的预算只够容纳约 4 个此类请求。8 个客户端同时发起请求时,其余请求就需要等待。
这一预算下,SGLang 吞吐为 48.9 tok/s,vLLM 为 46.0 tok/s,TensorRT-LLM 最慢,为 25.1 tok/s。接着只将 TensorRT-LLM 的 KV Cache 提高到其默认分配的 71,552 个 token,其他条件不变,再运行一次:
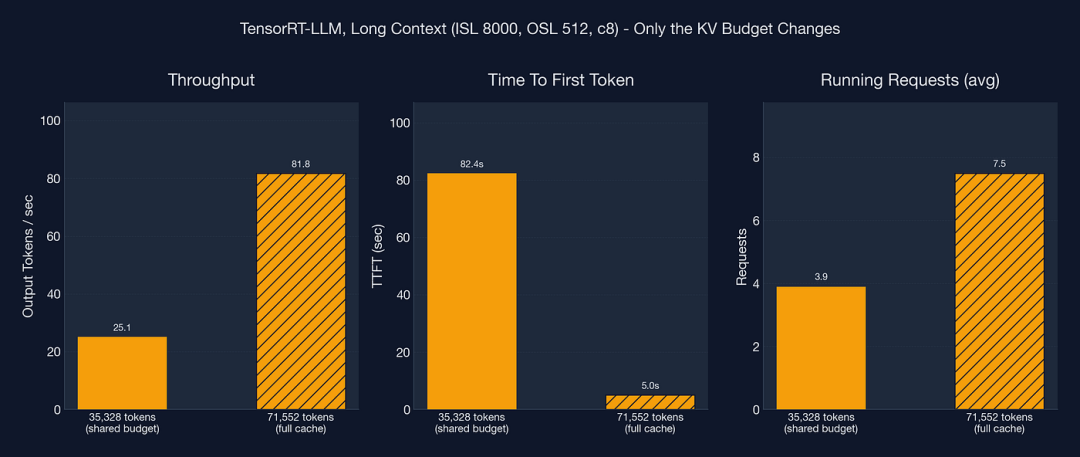
图 6:输入 8,000、输出 512、并发 8 时,35,328 token 预算下的吞吐为 25.1 tok/s、首 token 延迟为 82.4 秒,平均约 3.9 个请求同时运行;71,552 token 预算下分别为 81.8 tok/s、5.0 秒和约 7.5 个请求。
缓存有空间容纳全部 8 个请求后,同一引擎的吞吐从 25.1 升至 81.8 tok/s,平均首 token 延迟从 82.4 秒降至 5.0 秒,在这组测试中从最慢变成最快。
这一跳变的一部分与 TensorRT-LLM 在只运行少数长序列时解码异常缓慢有关:4 条序列时每步约 145 毫秒,8 条时约 69 毫秒,原因尚未解释清楚。两次运行中调整的变量只有 KV 预算;完整缓存那次只测试了 24 个请求,因此结果应视为近似值。
推理引擎基准测试清单
- 在每个引擎上显式设置 KV Cache 的数据类型。 BF16 与 FP8 的每 token 缓存占用相差两倍,默认值也可能不同。
- 记录每个引擎实际分到的 KV 容量。 从日志或指标中获取,并与测试结果一起保存。
- 先确定比较的是引擎还是部署。 比较引擎时,使用相同的 token 预算;比较开箱即用的部署时,可以使用默认值,但要报告各引擎实际选择的容量。
- 除了吞吐和首 token 延迟,还应报告同时运行的请求数和排队时间。 AIPerf 按请求导出的数据可以用于计算同时运行的请求数。
- 关注驱逐和重算。 缓存满时,vLLM 可能抢占运行中的请求并在稍后重算,可查看
vllm:num_preemptions_total;SGLang 可能收回请求,可查看 sglang:num_retracted_requests_total。在同样的 35,328 token 上限下,vLLM 在并发 32 和 64 时每轮抢占 56 至 67 个请求,SGLang 收回 7 个。
- 比较量化检查点时也要控制预算。 否则,更小的权重可能因允许更大的批量而获得部分优势。
下面的代码根据 AIPerf 导出的请求记录,计算测试期间平均同时生成的请求数:
import json

def running_requests(path="profile_export.jsonl"):
    """Average number of requests generating tokens at once over an AIPerf run."""
    spans = []
    for line in open(path):
        record = json.loads(line)
        meta, metrics = record["metadata"], record["metrics"]
        if meta.get("benchmark_phase") != "profiling" or "time_to_first_token" not in metrics:
            continue
        first_token_ns = (
            meta["request_start_ns"]
            + metrics["time_to_first_token"]["value"] * 1e6
        )
        spans.append((first_token_ns, meta["request_end_ns"]))
    start, end = min(s for s, _ in spans), max(e for _, e in spans)
    return sum(e - s for s, e in spans) / (end - start)
测试脚本位于基准测试仓库的 equal-kv-budget 目录,其中包括以相同 KV 预算启动各引擎,以及随结果保存日志和指标的驱动脚本。
结语
KV Cache 预算不会直接出现在吞吐或首 token 延迟的数字里,却会影响同时运行的请求数、排队时间,以及长上下文测试中的排名。在本文测试条件下,同样的 0.90 设置让三个引擎分到的缓存容量相差约两倍。
做等预算对比时,应显式设置数据类型,从日志核对容量,将引擎限制到相同的 token 上限,同时报告运行请求数和排队时间,并关注抢占与收回。这样才能更清楚地分析调度和内核带来的差异。
阅读推理基准时,值得先问一句:每个引擎分到了多少 KV Cache?缺少这个信息,吞吐和首 token 延迟的排名就不能直接归因于引擎本身。
参考
KV Cache: The Hidden Variable in LLM Inference Benchmarks
 发表于 2 小时前
|
查看: 0|
回复: 0
 /1


