大模型推理越来越依赖异构计算。NPU 负责高密度矩阵运算,PIM(存内计算)则把部分计算放到存储器内部或附近,减少数据往返搬运。为了让两者协同工作,一个直观的设计思路是统一内存,让 NPU 和 PIM 共享同一份模型权重与中间数据。
但共享内存并不意味着能同时兼顾两者的访问效率。NPU 希望数据分散到多个内存通道,PIM 却希望数据尽可能留在适合本地计算的 Bank 中。当同一份数据需要交替交给两种计算单元处理时,原本优化好的内存布局可能反而成为带宽瓶颈。
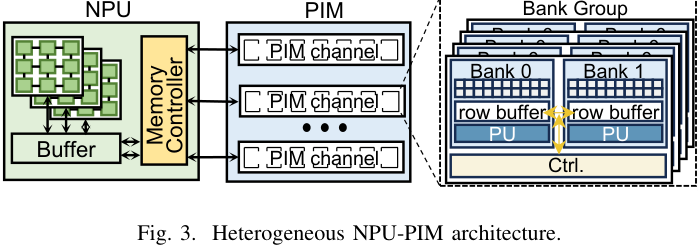
01|共享一份内存,为什么仍然跑不满带宽?
先看 NPU 和 PIM 各自如何访问内存。
NPU 执行矩阵计算时,往往需要连续读取大量数据。为了提高带宽利用率,内存控制器通常会把访问分散到不同的 Channel,让多个通道并行工作。
PIM 的访问特点则不同。由于计算发生在存储器内部或附近,数据在 Bank 中的位置会直接影响计算效率。理想情况下,参与同一计算的数据能够保持较好的 Bank 局部性,同时利用多个 Bank 并行执行。
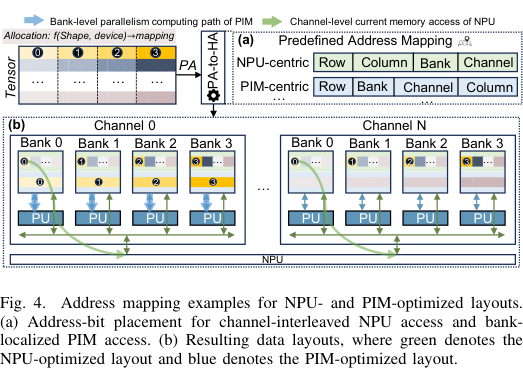
问题在于,同一种物理地址映射很难同时满足两种访问方式。
例如,一组连续的模型权重如果按 NPU 偏好的方式分散到多个 Channel,NPU 可以并行读取,但 PIM 执行时可能需要频繁切换 Bank 或 Row。反过来,如果数据按照 PIM 偏好的方式组织,NPU 又可能无法充分利用跨通道带宽。
过去,一种常见思路是给不同计算单元分配相对固定的任务,并据此提前确定数据布局。但在 MoE 模型中,不同 Expert 接收到的 Token 数量会随请求变化,同一个算子的计算密度也可能改变。
这意味着,某个算子原本适合 NPU 执行,换一批 Token 后可能更适合 PIM。执行设备变了,物理数据却仍按照原来的方式存放。
如果重新排列数据,就会产生额外搬运;如果保持原布局,另一种计算单元又可能跑不满带宽。
PFM 要解决的正是这个问题:能不能不复制、不重新排列整份数据,就让 NPU 和 PIM 都获得适合自己的访问方式?
02|不改 NPU 和 DRAM,内存控制器如何满足两种访问方式?
PFM 没有要求重新设计 NPU 核心,也没有改变 DRAM 存储阵列和时序协议,而是把优化集中到内存分配、地址映射和请求调度三个环节。
首先,软件分配 Tensor 时,不再只考虑 NPU 或 PIM 其中一方,而是根据 Tensor 形状、访问模式和两类计算单元的需求,提前搜索一个双方都能接受的物理地址布局。
这个布局以 2 MB 大页为管理粒度,决定地址中的哪些位对应 Channel、Bank、Row 和 Column,并把映射配置记录在内存控制器的 Mapping Descriptor Table(MDT)中。这样,同一份数据只需要存储一次。
真正发生变化的是访问阶段。PFM 在控制器中增加两个模块:ARU(地址重映射单元)和 FAS(灵活访问调度器)。
ARU 根据请求携带的 MapID,查找对应映射配置,把物理地址转换成实际 DRAM 硬件地址。FAS 则根据请求来自 NPU 还是 PIM,选择不同的命令组织方式:NPU 侧尽量保持跨通道并行和连续访问,PIM 侧协调多个 Bank 的计算与访问。
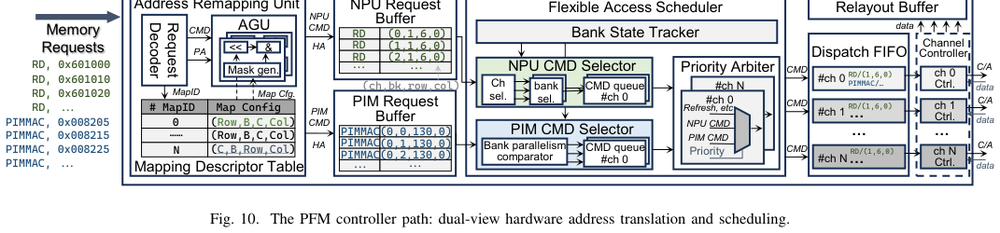
这意味着,同一份物理数据可以通过不同的访问组织方式服务两种计算单元,而不必在切换执行设备时重新搬运整个 Tensor。
这里的双视图并非简单建立两套虚拟地址,也不意味着每次访问都能直接获得两种设备各自的理论最优布局。它依赖预先优化的物理映射,再由控制器进行请求组织;必要时,仍会有小粒度数据重组。
更进一步,PFM 把运行时算子调度也纳入设计。面对 MoE 模型,系统可以根据 Expert 的实际激活情况和计算密度,在 NPU 与 PIM 之间选择执行位置,而不必让数据跟着算子反复迁移。
这给架构设计带来一个变化:过去内存控制器主要负责把请求转换为 DRAM 命令,现在还需要理解访问者的特点,配合上层调度维持不同计算单元的带宽效率。
03|2.32 倍吞吐提升,究竟来自哪里?
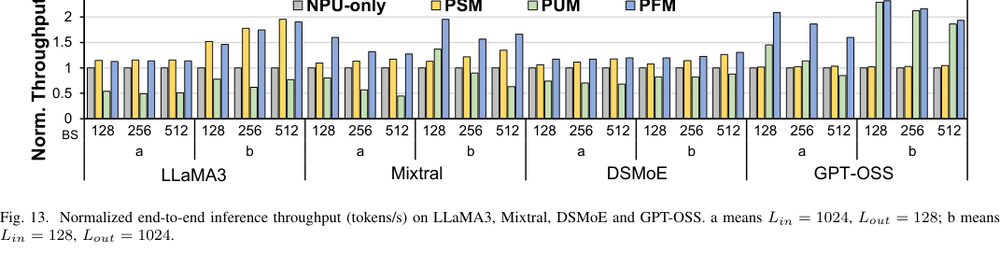
研究团队使用 GPGPU-Sim 和 Ramulator 构建 NPU-PIM 系统模型,测试 LLaMA3-8B、DeepSeekMoE-16B、Mixtral 8×7B 和 GPT-OSS-120B,比较 NPU 独立执行、分离内存、传统统一内存以及 PFM 四种方案。
结果显示,在大 Batch 测试中,PFM 相对传统统一内存方案 PUM,平均吞吐达到其 1.55 倍,最高达到 2.32 倍。
从带宽数据更容易理解收益来源。在 Mixtral 测试中,传统 PUM 采用偏向 PIM 的内存布局,PIM 侧平均带宽利用率达到 95.33%,但 NPU 侧只有约 14%–24%。采用 PFM 后,NPU 侧平均达到 92.10%,PIM 侧仍保持 94.85%。
研究还发现,直接在运行时重新排列数据并不一定划算。在 GPT-OSS 测试中,数据重新布局的搬运开销平均占执行时间的 46.32%。PFM 通过预先联合优化映射,减少了频繁进行大规模数据重排的需求。
这些结果来自系统级模拟,而非真实 NPU-PIM 芯片的流片测试。团队对新增控制器模块进行了 RTL 综合评估,报告面积约为 2.82 mm²,但这一数字基于预测工艺模型,不能直接视为量产硅片面积。
这项研究提供的工程思路很明确:当多个计算单元共享内存时,架构师不能只检查地址是否统一、数据是否复制,还要进一步检查物理地址映射是否适合不同访问者,以及控制器能否在执行设备变化时保持带宽利用率。
随着 NPU、PIM 和其他异构计算单元越来越紧密地协同,内存控制器的职责也在扩展。从传统的数据访问调度,到同时管理地址布局、访问行为与计算位置之间的关系,PFM 展示了一种值得关注的设计方向。
来源:2608.06989,MICRO 2026
 发表于 11 小时前
|
查看: 2|
回复: 0
 /1


