要缩小一颗NPU的面积,最直接的办法是砍掉一部分MAC阵列。Intel在Panther Lake上换了一种做法:INT8 MAC总数保持在约1.2万个,神经计算引擎(NCE)从6个减到3个,整个NPU的面积依然明显变小了。
SemiAnalysis在2026年9月公布了Panther Lake的裸片拆解。数据显示,和Lunar Lake的NPU 4相比,新一代NPU 5的面积减少了36.9%。对照两代裸片的区域划分可以看到,变化不止于计算引擎变少。原本和引擎配套的局部存储、辅助执行资源也一起做了重新安排。
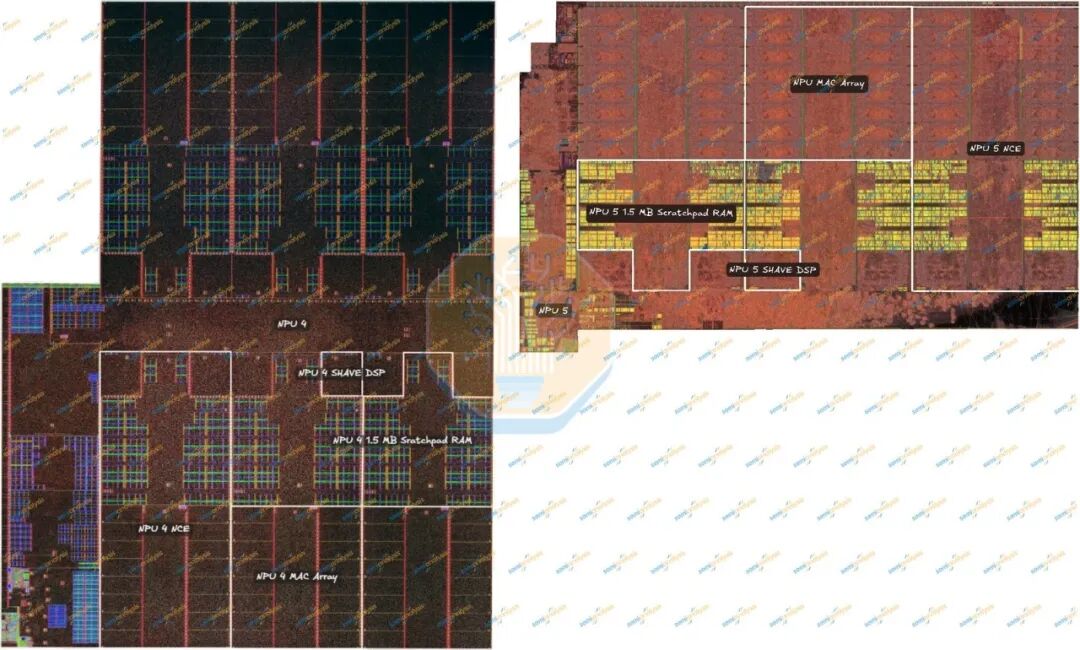
Lunar Lake NPU 4与Panther Lake NPU 5的裸片区域对照,后者实测面积减少36.9%。来源:SemiAnalysis。
这就引出一个具体的架构问题:MAC数量定下来以后,NPU该配多少片上存储、DSP和控制逻辑,才能在面积和实际吞吐之间找到平衡点?
01 六个小引擎变成三个大引擎,省掉了什么?
NCE不只是一组乘加器。它里面还有计算流水线、数据加载与转换模块、辅助运算单元,以及相应的控制逻辑。
Lunar Lake的NPU 4有6个NCE,每个NCE约有2K个INT8 MAC。Panther Lake的NPU 5改成3个NCE,每个NCE扩大到约4K个INT8 MAC。
这样一来,整个NPU的MAC总数还是12K,但计算资源的组织粒度变了。
| 硬件资源 |
NPU 4 |
NPU 5 |
| NCE数量 |
6 |
3 |
| 每个NCE的INT8 MAC |
2K |
4K |
| INT8 MAC总数 |
12K |
12K |
| SHAVE DSP |
12 |
6 |
| Scratchpad RAM |
9MB |
4.5MB |
每个NCE仍然配有2个SHAVE DSP,所以NCE数量减半后,DSP总数也从12个降到6个。
和计算引擎配套的Scratchpad存储区域也从12组减到6组,总容量从9MB降到4.5MB。
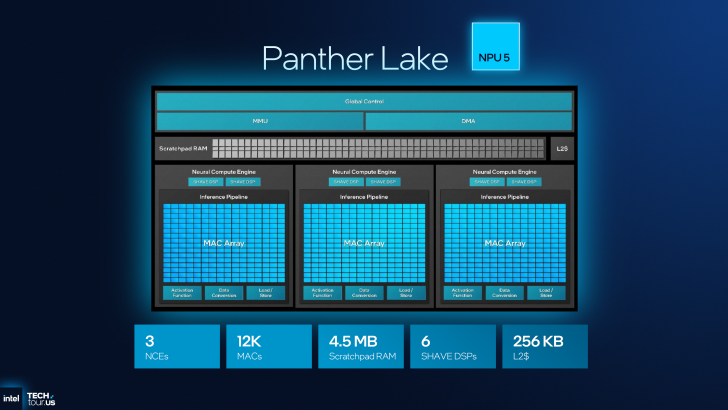
Panther Lake NPU 5架构,包括3个NCE、Scratchpad RAM和SHAVE DSP等模块。来源:Intel。
需要说明的是,这里的Scratchpad不能简单理解为每个NCE独占一块SRAM。Intel官方框图把Scratchpad RAM画在NCE阵列上方,裸片拆解则能进一步识别出实际的存储区域。至于它们具体怎么访问、怎么共享,还要结合内部数据通路来判断。
SemiAnalysis的测量结果是,NPU 5单个NCE的面积比上一代大约增加了22.6%。不过NCE总数减半,重复配置的存储和辅助资源随之减少,整个NPU仍然缩小了不少。
可见,同样数量的MAC分散到更多小引擎里,往往要配更多组配套资源。把MAC集中到少数几个大引擎,能省掉一部分重复开销,代价是数据供给和任务调度的方式也会跟着改变。
02 Scratchpad容量减半,MAC会不会更容易等数据?
NPU 5最值得关注的变化之一,是Scratchpad总容量从9MB降到了4.5MB。
Scratchpad用来存放计算过程中要反复使用的权重、激活值和中间结果。普通Cache由硬件自动管理,Scratchpad则不同,数据放在哪里通常可以由编译器或专门的数据搬运机制明确安排。
举个例子,执行卷积时,NPU可以提前把一部分输入和权重搬进片上存储,让MAC阵列反复使用,不必每次运算都去外部内存取数。
现在的情况是,MAC总数没变,Scratchpad容量却减了一半。
换算下来,每个MAC对应的片上Scratchpad容量从约750字节降到了375字节。 这个比例不能直接代表实际的带宽需求,但它清楚地反映出计算资源和局部存储资源之间的配比变了。
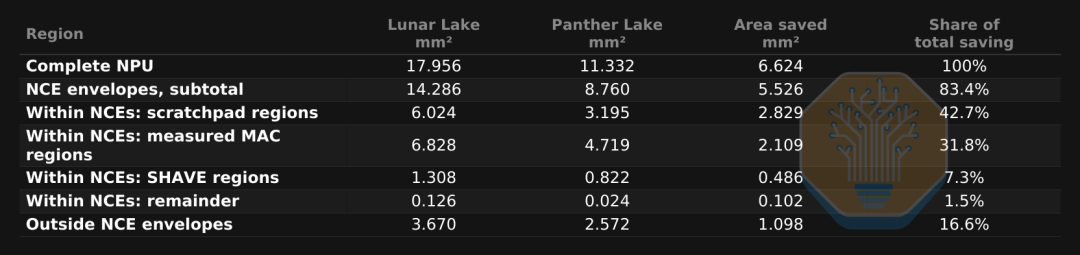
SemiAnalysis实测的两代NPU区域面积对照。Scratchpad区域由6.024mm²减至3.195mm²,对应总容量由9MB减至4.5MB。来源:SemiAnalysis。
假设模型的某一层需要同时保存输入Tile、权重Tile和部分输出。如果这个工作集能放进Scratchpad,计算阵列就能充分利用片上数据复用。
如果放不下呢?编译器可能要把Tile切得更小,或者调整权重、激活值和中间结果的搬运顺序。有些情况下,数据传输次数还会增加。
不过,这只是容量缩减可能带来的架构风险,不能据此断定Panther Lake的DDR访问量一定会增加。实际结果还要看模型规模、数据格式、调度策略、片上其他存储资源,以及DMA能否把传输延迟隐藏掉。
对架构师来说,判断Scratchpad能不能减,不能只看容量利用率。更关键的是,容量减少后,计算阵列会不会因为数据供应跟不上而空转。
03 DSP数量减半,为什么不等于辅助计算能力减半?
NPU里的MAC阵列擅长矩阵乘法和卷积,但神经网络里还有数据转换、激活函数和各种不规则算子。
这些任务有的可以交给专用硬件,有的需要SHAVE DSP这类可编程单元来完成。
NPU 5的DSP数量从12个降到6个,说明Intel减少了可编程辅助计算资源。但这并不意味着所有辅助运算的执行能力都降了一半。
Intel在NPU 5中加强了部分专用处理能力,比如可编程激活函数和数据转换路径。相关技术介绍显示,NPU 5能让更多常见激活函数直接由专用单元处理,减少对DSP的依赖。
要注意,激活函数和数据转换单元并不是NPU 5才有的。NPU 4已经具备这些功能,新一代的变化主要是支持能力和处理范围扩大了。
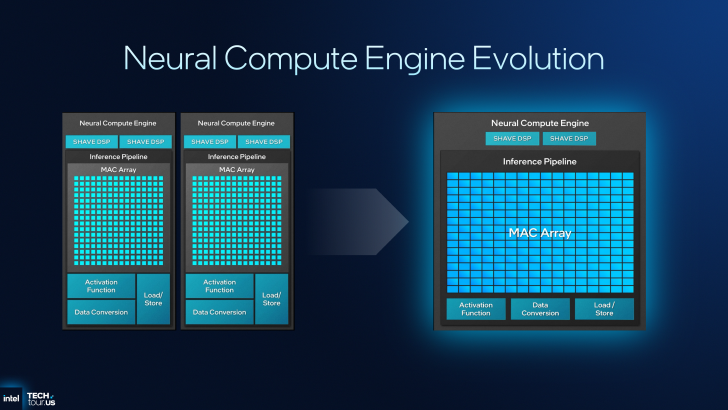
NPU 5中计算阵列、DSP与专用处理模块的组织方式:NPU 4的两个MAC阵列切片合并为NPU 5的单一大阵列,SHAVE DSP、激活函数与数据转换单元保留。来源:Intel。
这背后是一组典型的取舍。
DSP灵活,能处理多种算子,但需要配套的执行、控制和数据通路资源。专用硬件更适合高频、规则的操作,却没法覆盖所有自定义计算。
如果目标模型的大部分辅助运算都能交给专用单元,减少DSP就有机会省下面积。但如果工作负载里有大量不规则算子,DSP变少也可能成为瓶颈。
所以,DSP配得多不多,要看真实模型里的算子分布,以及哪些操作实际跑在MAC、DSP和专用单元上,单比DSP数量说明不了问题。
04 Scratchpad减半后,FP8能缓解多少数据压力?
NPU 5还新增了原生FP8支持。
FP8用8位表示浮点数据。和16位的FP16相比,在元素数量相同时,原始存储需求可以减少一半。
比如一组用FP16表示的权重占2MB,如果能换成合适的FP8格式,原始权重数据就可能缩到约1MB(不计额外的缩放参数和管理开销)。
对Scratchpad容量更紧张的NPU来说,这种数据格式有望让片上存储装下更多有效数据。
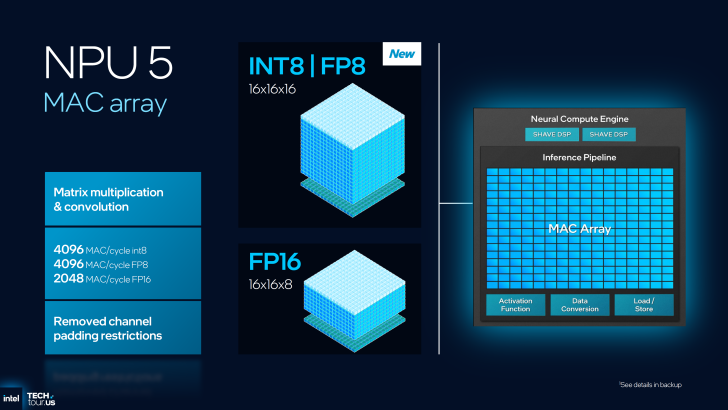
NPU 5支持FP8等数据格式(INT8/FP8按16×16×16计算,FP16按16×16×8计算),为降低部分模型的数据存储需求提供了条件。来源:Intel。
但FP8并不能自动抵消Scratchpad减半带来的全部影响。
首先,不是所有模型都适合直接用FP8。不同网络层对数值精度和动态范围的要求不一样,可能需要混合精度处理。
其次,实际执行中还可能涉及格式转换、缩放参数和其他中间数据。FP8减少了部分数据的字节数,但整个模型的片上工作集不一定就减半。
最后,模型能不能充分用好更大的MAC阵列,还取决于算子形状、Tile划分和数据供给速度。
因此,FP8和Scratchpad缩减之间确实存在合理的协同空间,但目前没有证据表明Intel加入FP8就是为了弥补Scratchpad容量减半。
更准确的理解是:NPU 5同时调整了计算引擎组织、片上存储预算和数据格式支持,最终收益要靠具体模型来验证。
05 面积缩小36.9%,架构师应该怎样验证这套设计?
SemiAnalysis测得NPU 5的面积比NPU 4小36.9%。这个结果很亮眼,但还得考虑制程差异。
Lunar Lake的计算Tile用的是台积电N3B,Panther Lake的计算Tile用的是Intel 18A。所以36.9%是两代NPU实际裸片面积的差距,里面混合了架构调整、制程和物理实现等多种因素,不能全部算在NCE合并头上。
从公开配置看,两代NPU的峰值INT8性能分别约为48 TOPS和50 TOPS,相差不大。也就是说,Intel在保持相近峰值算力的同时,把NPU的实际占用面积压缩了一大截。
但峰值TOPS回答不了所有问题。
对这种从6个小NCE改为3个大NCE的设计,至少还要检查以下三项指标:
- MAC利用率。更大的单引擎阵列,处理小矩阵、不规则算子和不同Batch规模时,效率还能保持吗?
- 数据搬运开销。Scratchpad容量减半后,模型是否要更频繁地分块、重新加载权重或搬运中间结果?
- 辅助计算瓶颈。DSP变少后,哪些算子仍由DSP执行,哪些已经转给专用单元?会不会出现新的排队和等待?
| 硬件资源 |
NPU 4 |
NPU 5 |
| NCE数量 |
6 |
3 |
| 每个NCE的INT8 MAC |
2K |
4K |
| INT8 MAC总数 |
12K |
12K |
| SHAVE DSP |
12 |
6 |
| Scratchpad RAM |
9MB |
4.5MB |
NPU 4与NPU 5的计算、存储及辅助执行资源配置对照。来源:Intel、SemiAnalysis。
这三个问题共同决定了NPU 5省下的面积,能否在真实模型上换来更高的单位面积性能。
Panther Lake给出了一个很具体的架构案例:同样是12K INT8 MAC,可以组织成6个较小的计算引擎,也可以组织成3个更大的计算引擎,两种方案需要的Scratchpad、DSP和控制资源各不相同。
这种设计思路对NPU架构师同样适用。确定计算阵列规模之后,还要根据目标工作负载重新分配局部存储、辅助执行和数据搬运资源。 MAC数量相同,最终的面积、利用率和模型性能仍可能差别很大。
 发表于 11 小时前
|
查看: 3|
回复: 0
 /1


