这周,如果把“进度快了一倍”“80% 是 AI 造成的”“2027 年研究员会被换掉”说成同一件事,就混淆了三个层次:第一层是拟合出来的斜率,第二层是看过内部材料后的判断,证据大半没有公开,第三层则是基于这些判断做出的预测。
第一层:只读 AECI
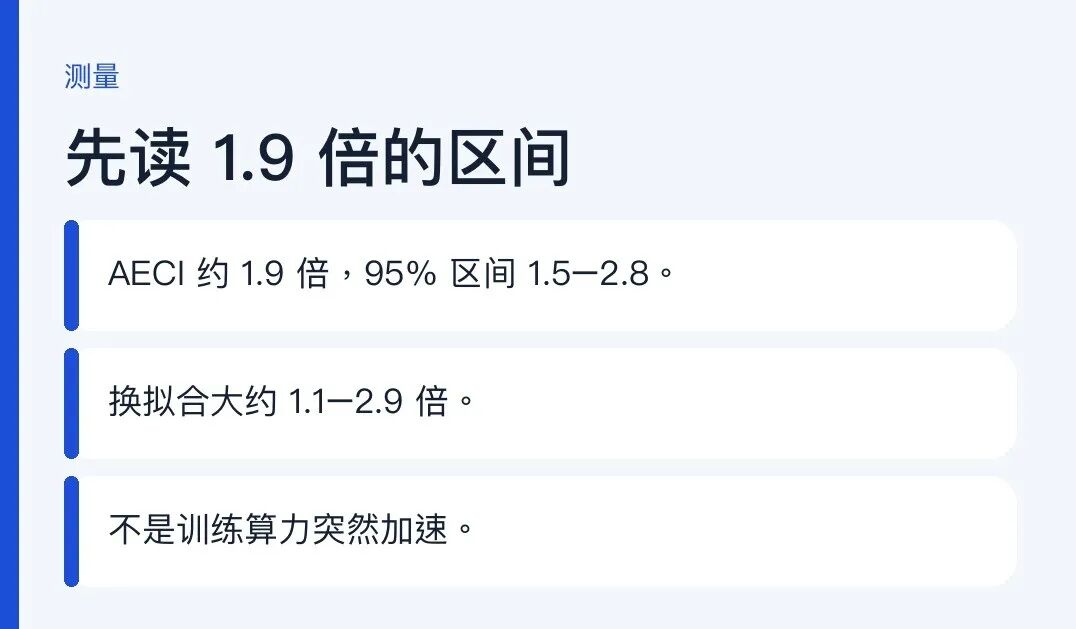
METR 在 2026 年 11 月 5 日写道,2025 年 10 月之后,Anthropic 内部能力指数 AECI 的增长速度大约是之前的 1.9 倍,95% 区间为 1.5 到 2.8 倍。年化增量大约从 15 分变成 29 分。更换基准、日期或饱和处理方式后,稳健性检查得到的结果约为 1.1 到 2.9 倍。他们认为,完全没有加速,或加速超过 3 倍,都会令人意外。
1.9 倍高于 Haiku 5.5 系统卡里的 1.7 倍,主要原因是加入了尚未发布的模型,包括被称为 Model 4 的数据点。METR 没有直接抽样这些模型,分数由 Anthropic 提供。
他们有把握排除的是训练算力增速变快。至于算力、数据和算法各自贡献了多少,更细的拆分被涂掉了。
AECI 覆盖的是比较容易指定、对错也比较清楚的任务。这些数据点滞后于研究本身的加速,分布也比较稀疏。
第二层:主观判断,关键证据被涂掉
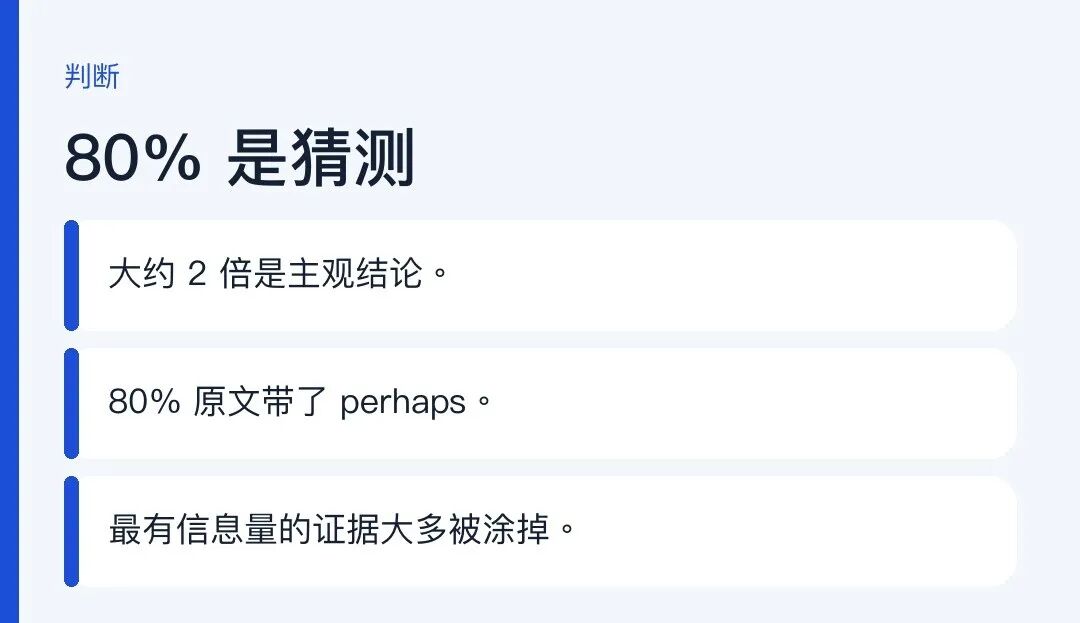
同一篇报告给出的主观结论是:到 2026 年 10 月,好指定任务上的能力进度,大约是 2024 年 3 月到 2025 年 10 月期间的 2 倍。他们表示,即便实际是 1.3 倍或 3 倍,也不会感到意外。
“当前加速大约 80% 来自 AI”是一个猜测,英文原文用了 perhaps。他们认为,2025 年末的加速很可能也掺入了非 AI 因素,AI 的贡献份额是后来才变得更重要的。
Anthropic 涂掉了 METR 认为最有信息量的大部分证据,给出的理由是避免帮助其他开发者。因此,公开部分更依赖评估人员的综合判断。评估从 8 月 12 日持续到 10 月 29 日,使用 Anthropic 的设备,未收取评估费。
员工在 Slack 上的投票显示,到 10 月的加速约为 12 倍。METR 特别注明,这是一项低投入投票。研究主要仍是人用 AI 帮忙,而不是模型独自交出关键结果。虽然出现了一些接近自主完成研究的迹象,但不同领域之间差别很大。
对于未来 12 个月,他们考察了算法、训练算力、实验算力和数据,没有找到会明确挡住进度的瓶颈。不过,这段判断经过多次修改,作者也写明对此没有信心。
第三层:预测不能写回测量结果
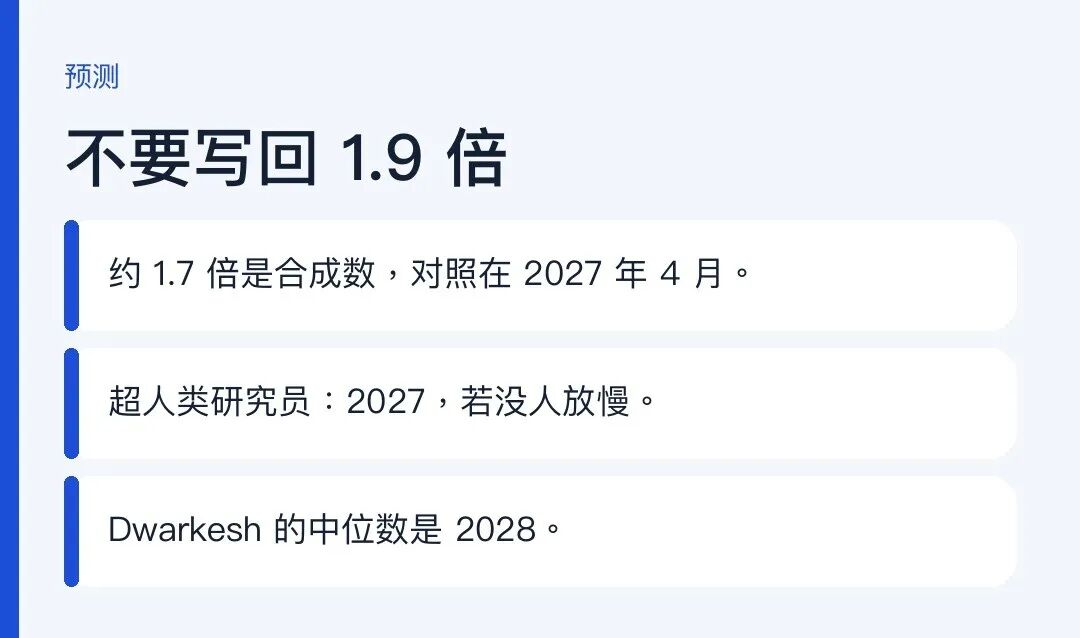
AI Futures Project 在 11 月 10 日将“大约 2 倍”和“大约 80%”合成为“大约 1.7 倍可归因于 AI”。他们认为,这比 AI 2027 情景快了大约 5 个月,对照点在 2027 年 4 月前后。
这组作者预测:如果没有明显的主动放慢,超人类 AI 研究员有相当大的可能在 2027 年某个时候出现。他们的大致定义是,研究品味达到项目中最强的人,同时编程可以完全自动化。对于 2028 年前全面超过顶尖专家,他们给出的概率是 35% 到 65%。Daniel Kokotajlo 此前给出的预测是,2029 年前有 50% 的概率发生。
这项预测最大的一条证据就是 METR 报告。作者也写明,他们的建模可能有错。
Dwarkesh Patel 在 11 月 13 日将“像最好的人类一样做 AI 研究”的预测中位数放在 2028 年,同时给出 25% 的概率认为时间会晚于 2032 年。前提同样是实验室不主动放慢。这仍然是预测。
Ryan Greenblatt 并非这篇 METR 报告的作者。他在公开评论中写道,自己原先预期 2026 年的加速幅度大约为 1.15 到 1.3 倍。
过线看的是预期
负责任扩展政策 3.4 从 2026 年 7 月 8 日生效。研发这条线目前只检查 AI 研究。公开转述中有两种触发条件:一种是模型能够以不超过原有 5 倍的成本替代全部研究科学家和工程师;另一种是观察到或预期到进度翻倍,并且这种翻倍有相当大的可能主要来自自动化。政策 PDF 我没有逐条核对。
11 月 2 日的招股书修订称,未来模型可能很快达到阈值,但当前模型尚未被指定为超过阈值。11 月 10 日的修订,据读过文件的备忘称,公司根据对未来模型的预期认定已经达到阈值。SEC 的 PDF 我没有打开。
Claude Mythos 5.2 的系统卡中,Anthropic 的判断是:考虑到该模型的短板,它并没有把内部研发总进度翻倍。AI Futures Project 引用的是这句话。“公司说阈值已经达到”和“这个已命名模型被测出把总进度翻倍”,是两句不同的话。
自己的仓库先填六行
我会建一个纯文本表,先填六行就停。每行记录以下项目:
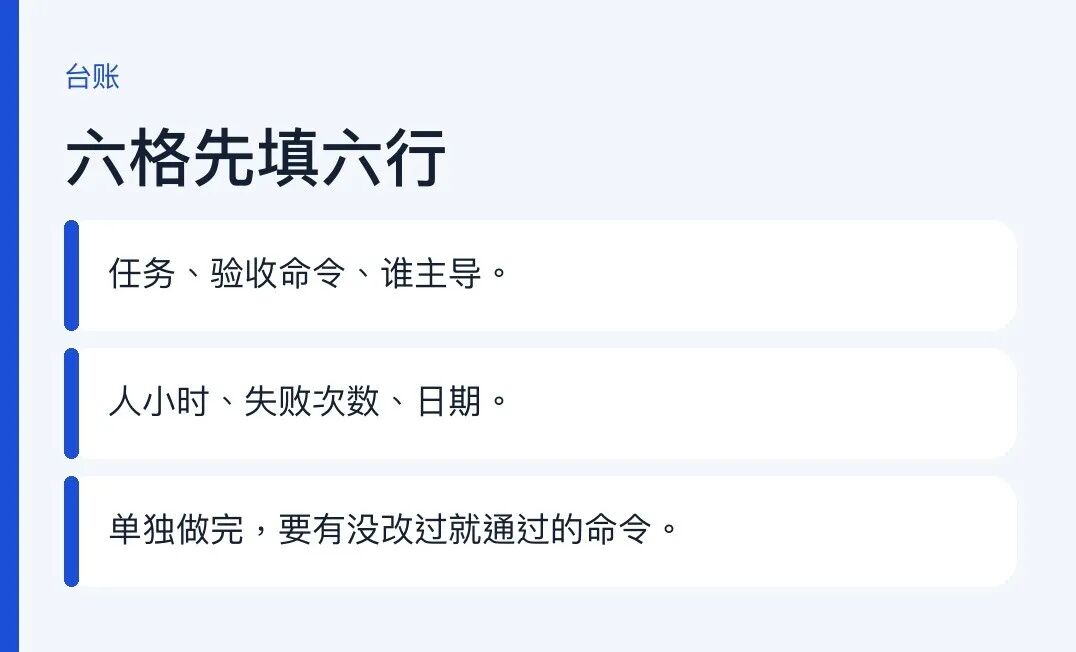
任务 | 验收命令 | 谁主导 | 人小时 | 失败次数 | 日期
“谁主导”只用三个选项:人做、人盯着模型做、模型单独做完。要记录为“模型单独做完”,就得有一条你没有改过、并且能够通过的验收命令;你也不能在旁边修改结果。没有这样的命令,这一格就留空。
OpenAI 9 月 6 日公布的账可以作为花费对照。8 月中,研究组织的用量中位数按 API 标价计算,一天超过 600 美元,第 90 百分位超过 7000 美元。全组织大约每 1 个人日对应 3.1 个代理人日。他们将自动化研究实习生定义为:在人的指导下完成定义清楚的任务,包括熟练研究员需要花几天完成的任务。花费和人日比都不是 AECI 的斜率。
最后只看三件事:表建起来了;每行都有验收命令;“模型单独做完”要么留空,要么对应的命令在没有修改的情况下通过。
来源
METR 报告作者:Tom Cunningham、Nate Rush、Parker Whitfill、Hjalmar Wijk。
 发表于 2 小时前
|
查看: 1|
回复: 0
 /1


