要点速览
-
核心观点:OpenRelay 把 Gemma 4 31B 从 NVIDIA B200 搬到 AMD MI355X,派两个智能体干了一晚上:研究智能体读内核源码排优先级,调优智能体在真卡上一次改一处,正确性门槛卡死 GSM8K 不低于 96.5%。
-
关键数据:4 秒 p95 TTFT 目标下单卡负载从 2.0 涨到 3.0 请求每秒,prefill 从 27.8K 涨到 41.9K token/s,每输出 token 从 40 到 43 毫秒降到 22 毫秒,GSM8K 保持 98.8% 不变。
-
方法创新:五个修法提成上游 PR:AITER 补 512 维头的 prefill tile、Triton 编译常量改运行参数、Gemma 形状的 GEMM 配置、推测解码的 split-KV 注意力、vLLM 的融合激活加 MXFP4 量化核。
参数表告诉你一块卡理论上能干什么,实际能干什么是另一回事:一堆内核、查找表和开关,多数是为别的模型调的。新卡上跑新模型,第一版往往是能跑、对,但卡在空等上。
OpenRelay 把 Gemma 4 31B 搬到 MI355X 只花了一天跑通,然后让智能体调了一晚上,单卡承载涨了 1.5 倍。下面把循环机制、四个优化和天花板分析逐一拆开。
从 B200 搬到 MI355X:跑通只花一天
Blackwell 的 NVFP4 权重在 MI355X 上跑不了,于是换成 AMD 的 Quark MXFP4 检查点,保留 Google 的推测解码小模型。权重加小模型约 20GB,芯片 288GB 的 HBM 大头留给 KV 缓存,内存这关好过。
计算是另一回事。第一版配置每卡 prefill 27.8K token/s,听着还行,算笔账就露馅:矩阵运算只跑到芯片 MXFP4 峰值的五分之一不到。卡着延迟目标,一块卡最多扛 2.0 请求每秒。
双智能体循环:研究与调优分工
研究智能体读内核库源码和公开PR,按对这个模型加这块卡的可能收益排序;调优智能体在真卡上一次只改一处,profiling、提假设、跑实验,更快且 GSM8K 不低于 96.5% 才保留。
正确性门是绝不跳过的一步:更快的内核如果改变模型答案,直接当 bug 处理。调优智能体把一切写进日志,错的也写。这次它就抓到自己一个乌龙:新引擎因旧引擎占着端口没起来,一轮 benchmark 悄悄测的是旧引擎,它扔掉那批数字,还把启动器改成拒绝占用的卡。
Gemma 4 这轮给了它四块 MI355X 和一个晚上。
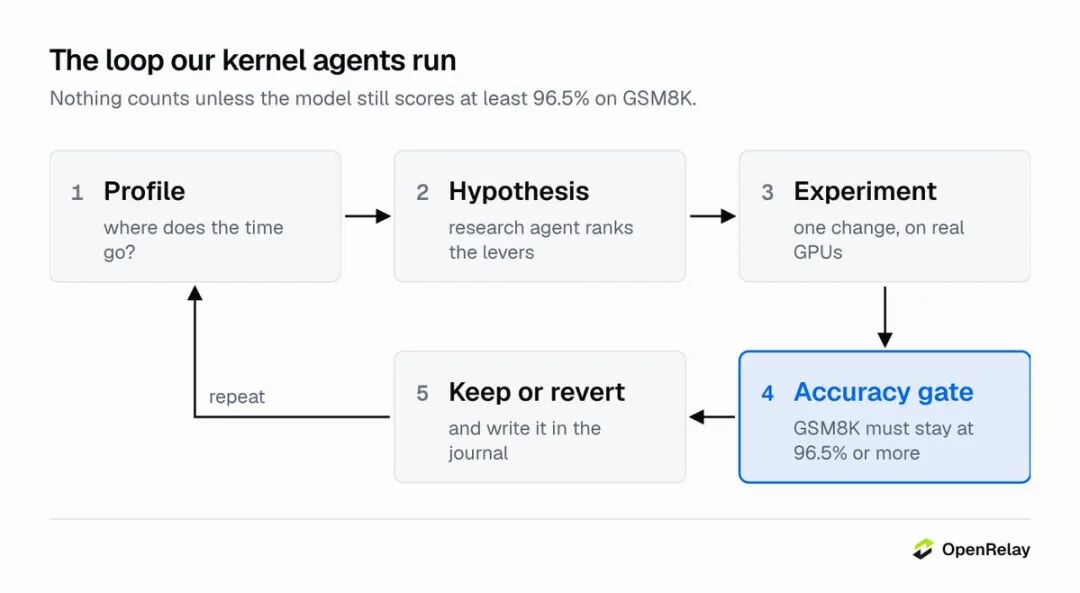
图1:内核智能体的循环。profiling 找时间花在哪,研究智能体排优先级,真卡上一次改一处,精度门要求 GSM8K 不低于 96.5%,保留或回滚并记入日志,然后重复。
战果:同延迟目标,1.5 倍负载
基线是自家第一版 MI355X 配置,跑 stock vllm/vllm-openai-rocm:v0.30.0,不跟 B200 比厂商。负载测试开环,每档 300 秒、两个种子,请求平均输入 9.5K token、输出 380 个。
4 秒 p95 TTFT 目标下,单卡从 2.0 涨到 3.0 请求每秒;16 个 10K token 提示并发下 prefill 从 27.8K 涨到 41.9K token/s;该负载下每输出 token 中位数从 40 到 43 毫秒降到 22 毫秒;GSM8K(250 题)98.8% 对 98.8%,纹丝不动。
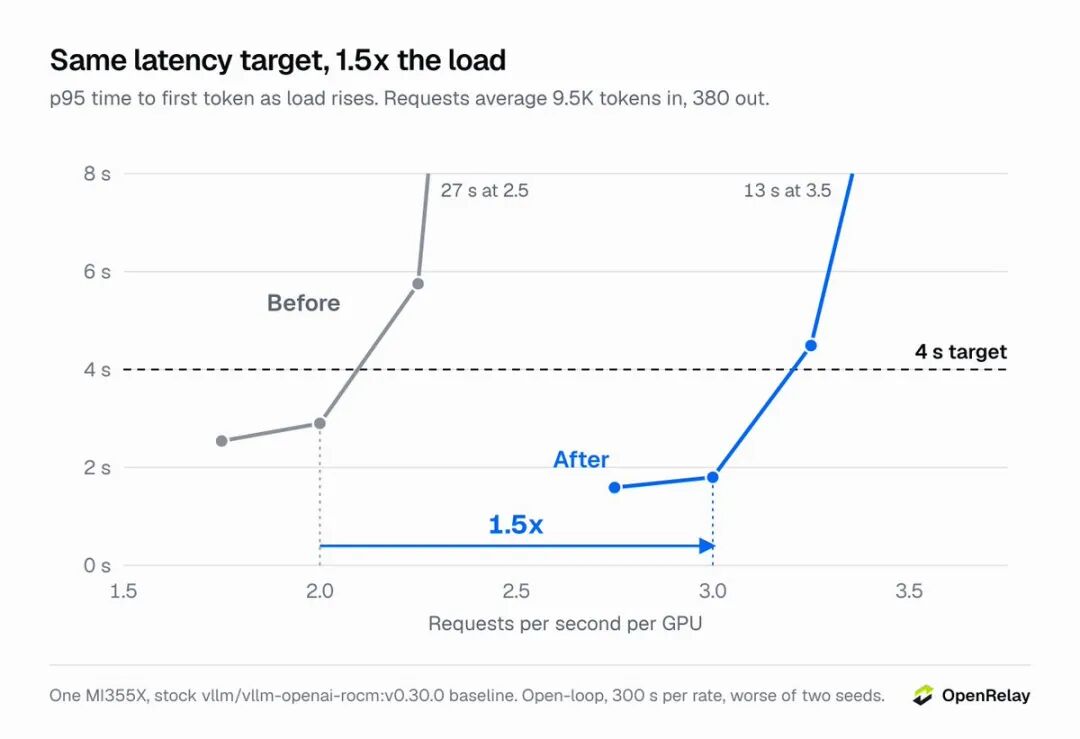
图2:同延迟目标,1.5 倍负载。p95 TTFT 随负载变化,请求平均输入 9.5K token、输出 380 个。优化前 2.0 请求每秒触 4 秒线,优化后 3.0 才触线。
prefill 涨幅的三分之二在前十分钟落地,剩下的是长尾小胜,每一处单独计量。
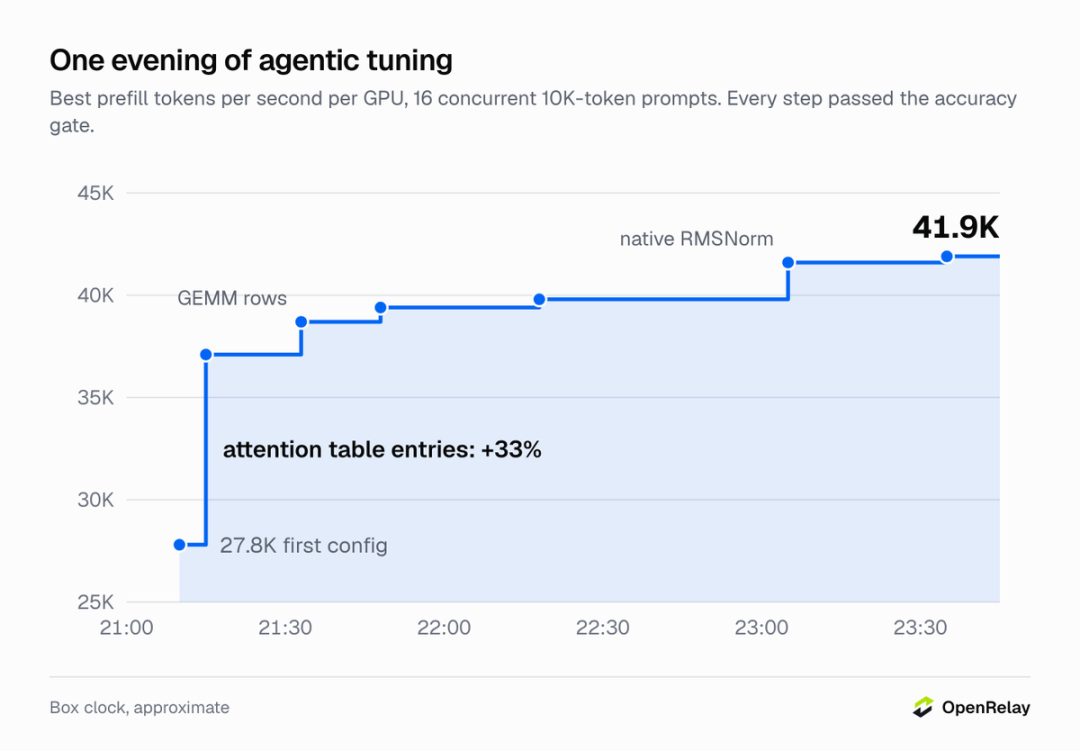
图3:一晚上的智能体调优。每卡 prefill token/s,16 个 10K token 提示并发,每步都过精度门。从 27.8K 涨到 41.9K,注意力表项贡献 33%,原生 RMSNorm 收尾。
优化 1:缺失的表项
开工七分钟,第一份 profile 回来:prefill 的 GPU 时间里注意力占 43%,对这个尺寸的模型来说太多了。
AITER 按 GPU 架构从 JSON 表里选注意力 tile 尺寸,MI355X(gfx950)的表里没有 256 维及以上头的 prefill 项,而 Gemma 4 两种都有:50 层滑动窗口层是 256 维头,10 层全局层是 512 维头。于是 prefill 回退到给 decode 准备的 tile,每 program 只算 16 个 query 行;全局层 8 个 query 头共享一个 KV 头,16 行就是 2 个 token,每个 K/V tile 每 2 个 token 被重读一遍。
研究智能体读 AITER 源码时已把这条排在最前。修法就是加一条表项,按长 query 键控,decode 继续用它的 tile:
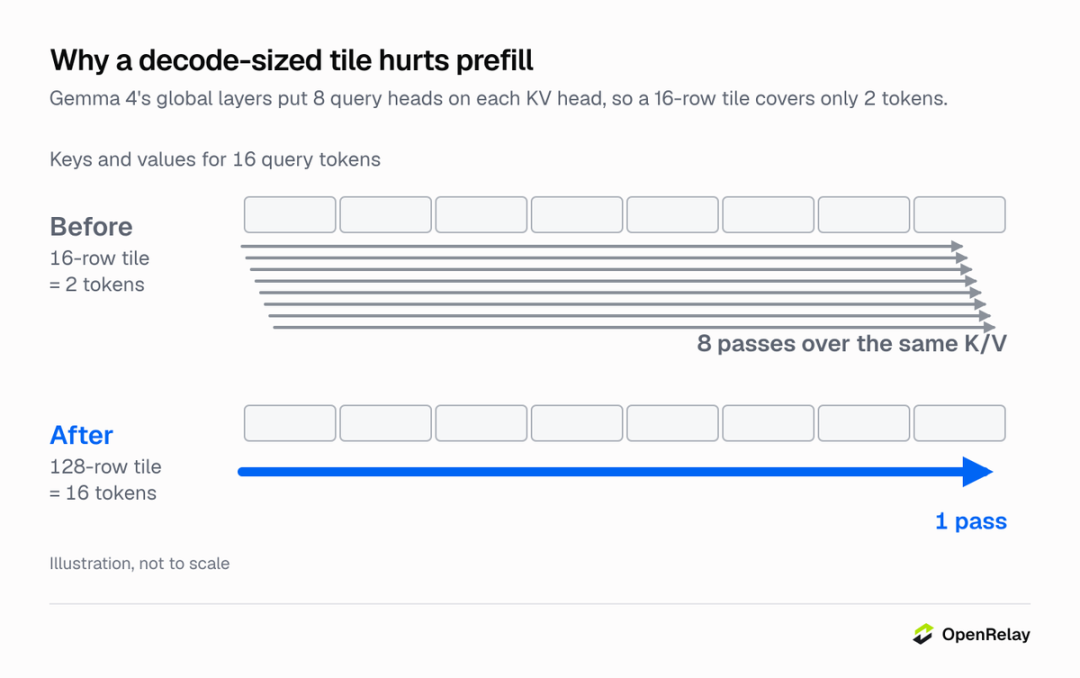
图4:decode 尺寸的 tile 为什么伤 prefill。Gemma 4 全局层 8 个 query 头共享一个 KV 头,16 行 tile 只覆盖 2 个 token,同一份 K/V 被扫 8 遍;换 128 行 tile 后 16 个 token 一遍过。
"D_GEQ_512.Q_GEQ_256.DT_fp8_fp8": {
    "BLOCK_M": 128,
    "TILE_SIZE_MIN": 64,
    "TILE_SIZE_MAX": 64,
    "num_warps": 4,
    "num_stages": 1,
    "waves_per_eu": 1
}
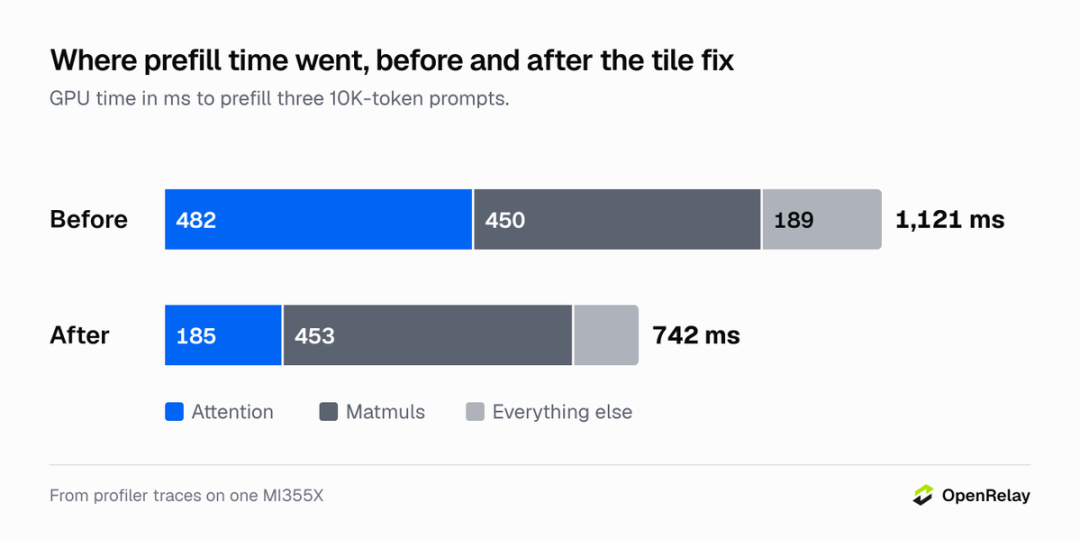
图5:prefill 时间花在哪,tile 修复前后。三个 10K token 提示的 GPU 毫秒数:注意力从 482 降到 185,总时间从 1121 毫秒降到 742 毫秒。
全局层内核从每步 10.6 毫秒降到 3.9 毫秒,滑动窗口内核从 1.37 毫秒降到 0.59 毫秒,prefill 涨三分之一,GSM8K 不动。修完矩阵乘法占 prefill 的 61%,GPU 的时间就该花在这。
优化 2:GPU 在等 CPU
有负载时,一个约 30 请求的 decode 步要 57.7 毫秒,其中内核只占 21.3 毫秒,GPU 忙碌率 37%。
引擎的 CUDA graph(ROCm 上叫 HIP graph)只 capture 到 64 个 token。加 2 个 draft token 后每个请求每 decode 步 3 个 token,batch 超过 21 个请求就 miss graph,每个内核都由 CPU 逐个发射。
capture 到 256 个 token 就是一个开关的事,代价是 7 秒启动时间和 3.1GiB 内存,decode 步缩到原来的 2.7 分之一。32 用户下每秒请求从 2.42 涨到 2.88。
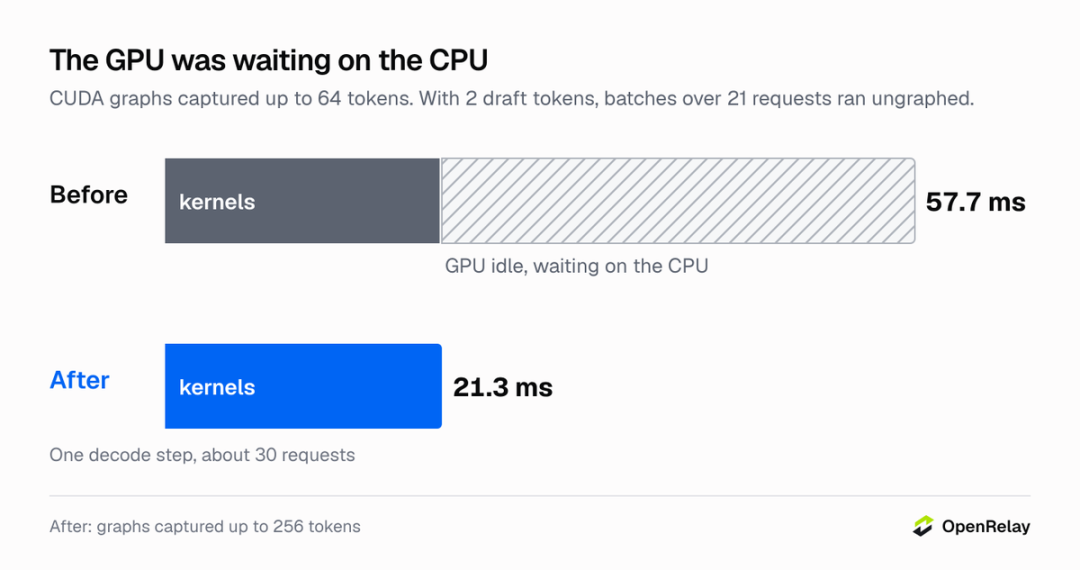
图6:GPU 在等 CPU。约 30 个请求的一个 decode 步:优化前 57.7 毫秒里内核只占 21.3 毫秒,其余 GPU 空转等 CPU;graph capture 到 256 个 token 后内核独占 21.3 毫秒。
优化 3:编译风暴
一个融合 GELU 加 MXFP4 量化的内核初看像 regression,trace 解释了一切:服务中段七个约 190 毫秒的空转间隙。
AITER 把填充行数 scaleM_pad 声明成 Triton 编译期常量,每个新 batch 大小(按 256 向上取整)都编译一个内核变体。改成运行期参数就好。在 AITER 主分支上,14 种 batch 大小现在只要编译 4 次而不是 12 次,输出逐比特一致。
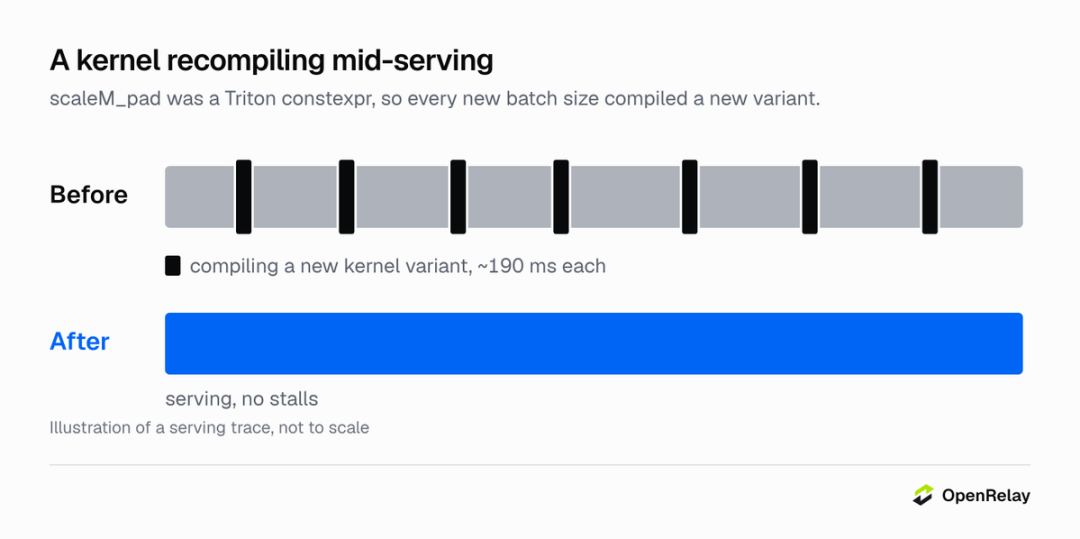
图7:服务中途的内核重编译。scaleM_pad 是 Triton 编译期常量,每个新 batch 大小编译一个变体,每次约 190 毫秒;改运行期参数后服务不再卡顿。
优化 4:小优化们
- 按 Gemma 4 精确形状调的 MXFP4 GEMM 配置:prefill 加 4%。
- 融合 GELU、上投影和 MXFP4 量化内核:加 1.5%。
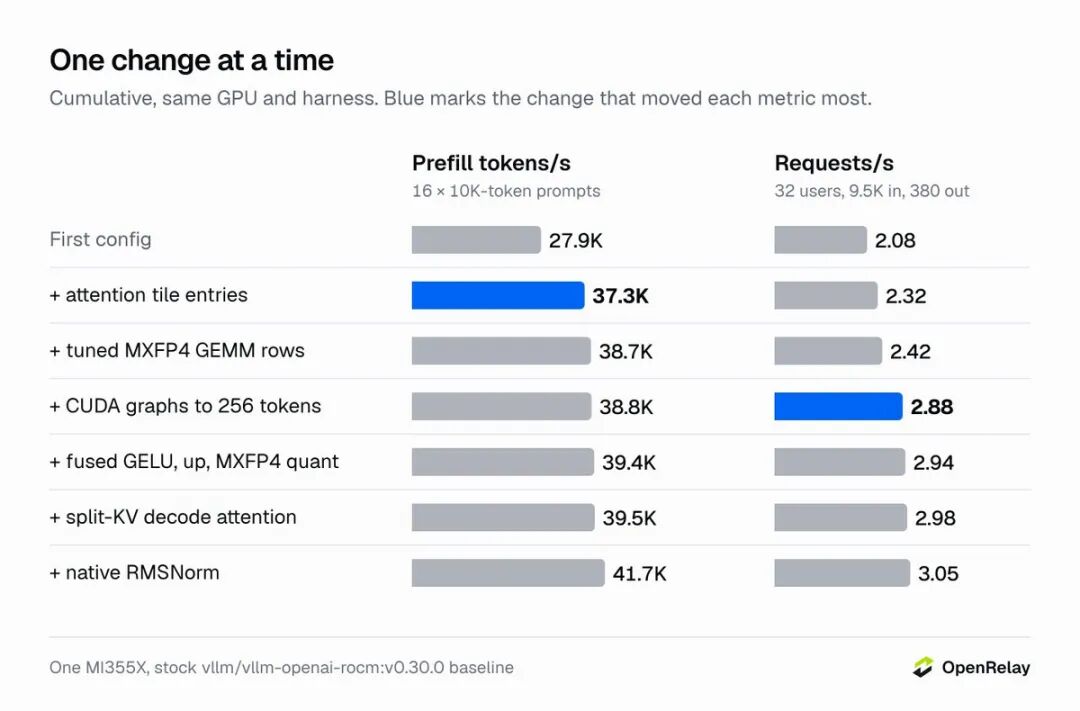
图8:一次只改一处。累积收益,同卡同 harness,蓝色标出对该指标贡献最大的一项:注意力表项把 prefill 推到 37.3K,graph 到 256 个 token 把请求每秒推到 2.88。
- 推测解码步上 512 维层的 split-KV 注意力。
- 原生 RMSNorm,让 torch.compile 把周围的切分、norm、RoPE 融起来:加 6%。
- 8192 个 token 的 prefill 分块,每输出 token 时间下降,prefill 不涨。
没起作用的:Triton 和 hipBLASLt 的 MXFP4 GEMM 比 AITER 汇编内核慢 2.5 倍;vLLM 的 QK-norm 和 RoPE 融合 pass 对不上 Gemma 4 的布局;CUDA graph capture 到 16K token,白花 14GiB 没收益;128 并发序列,吞吐多 1 到 3%,每 token 时间翻倍;第三个 draft token,每 token 时间降 7% 到 10%,但容量不涨。
离天花板多远
现在矩阵运算占 prefill 的 61%,这些内核在负载时钟下跑到 MXFP4 峰值的 55% 到 61%。更好的内核也许再买 1.2 到 1.3 倍;注意力加小算子如果免费,prefill 到 68K token/s;matmul 也跑满峰值,到 125K。第一版的 10 倍需要线性层 alone 约 17 PFLOP/s,远超芯片约 10 PFLOP/s 的 MXFP4 峰值,不可能。
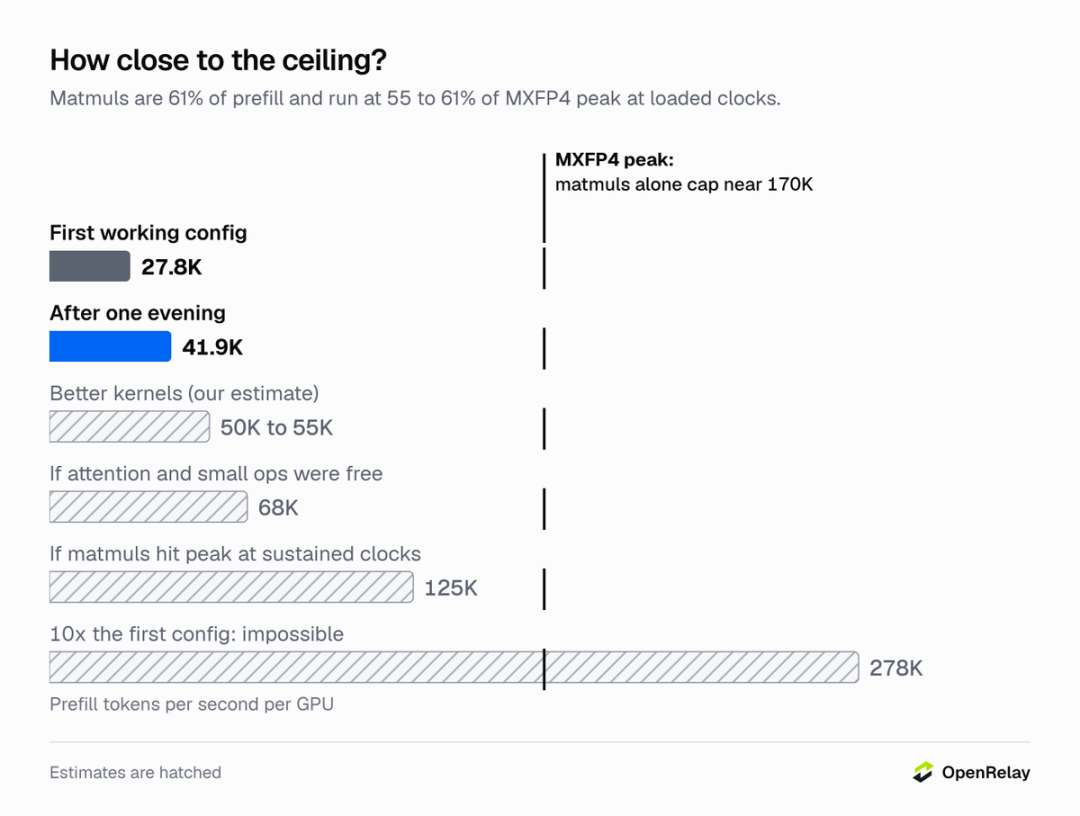
图9:离天花板多远。首版 27.8K,一晚上 41.9K;更好内核估计 50K 到 55K;注意力和小算子免费则 68K;matmul 跑满峰值 125K;首版 10 倍的 278K 不可能,远超芯片峰值。
全部开源,外加五个上游 PR
智能体改的所有东西都在 OpenRelayInc/inference-recipes:Dockerfile、调好的表、补丁、每个数字背后的 benchmark harness。该进上游的修法都提成 PR,在项目主分支的 MI355X 上重测:ROCm/aiter #5926(512 维头的 prefill tile)、#5927(batch 大小不再重编译)、#5928(Gemma 4 形状的 GEMM 配置)、#5929(推测解码的 split-KV 注意力)、vllm-project/vllm #59153(融合激活加 MXFP4 量化)。
有一个修法没进:AITER 主分支的新 MI355X 注意力内核跑 Gemma 4 滑动窗口层比调好的 tile 还快(0.55 毫秒对 0.61),就让它留在上游了。
升级注意:vLLM v0.30.0 之后 AITER 汇编 MXFP4 GEMM 改成 opt-in,不开 VLLM_ROCM_USE_AITER_FP4_ASM_GEMM=1 的话,新 nightly 上 Gemma 4 prefill 从 27.7K 掉到 18.9K token/s。
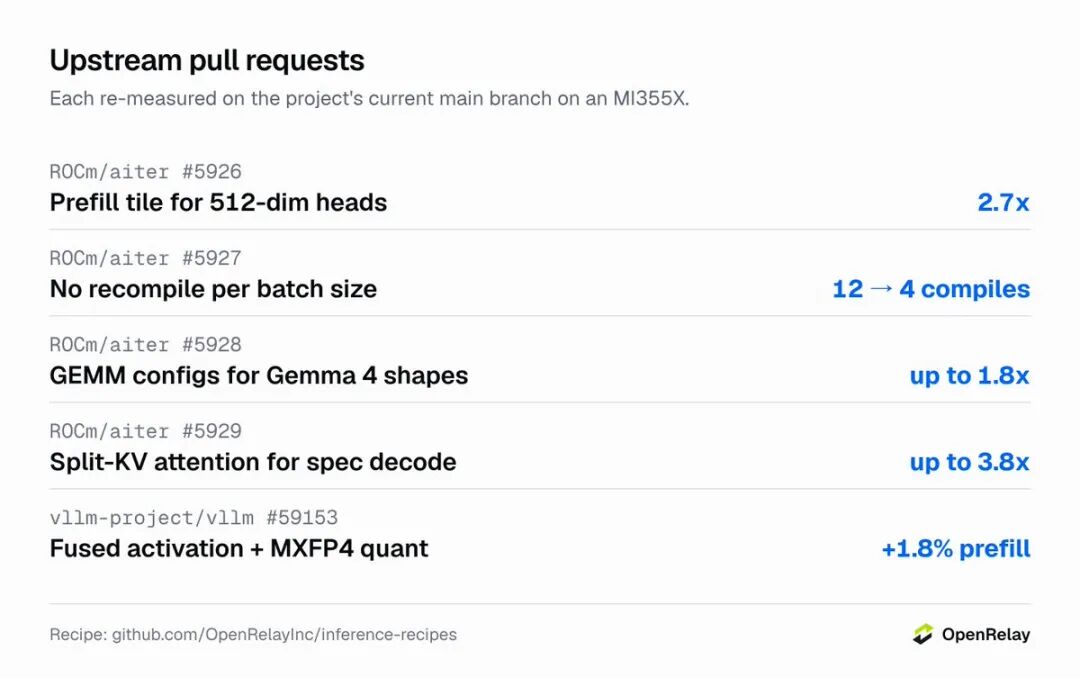
图10:上游 PR。每个都在项目主分支的 MI355X 上重测:512 维头 prefill tile 快 2.7 倍,batch 大小不再重编译(12 次变 4 次),Gemma 形状 GEMM 配置最高 1.8 倍,推测解码 split-KV 注意力最高 3.8 倍,融合激活加 MXFP4 量化 prefill 加 1.8%。
三个改动是 stock 镜像上的纯开关:
--max-num-batched-tokens 8192
--compilation-config '{"cudagraph_capture_sizes":[1,2,4,8,16,24,32,48,64,80,96,112,128,144,160,176,192,224,256]}'
--kernel-config '{"ir_op_priority":{"rms_norm":["native"]}}'
结语
一个晚上的 1.5 倍,拆开看全是脏活:表里缺一项、graph 没 capture 够、编译期常量放错地方。智能体的价值不在想出奇招,而在于不知疲倦地 profiling、假设、实验、回滚,外加一个绝不妥协的精度门。
对用 AMD 卡跑推理的团队,这篇最值钱的是那张修法清单和五个 PR:tile 表、GEMM 配置、graph capture 尺寸,开箱即用。以及那个升级 gotcha:记得开 AITER 汇编 GEMM 的开关,不然 prefill 直接掉三成。
vLLM 双厂商通吃,模型上两家芯片是容易的部分;难的是每对模型加芯片组合都有一套没人为它调过的默认参数。这个 gap 值 1.5 倍,智能体一晚上填上了。
参考:https://x.com/OpenRelayInc/status/2105046346722058495
 发表于 6 小时前
|
查看: 0|
回复: 0
 /1


