10月20日,Google、Meta与SGLang团队联合发布了SGLang-TorchTPU,让基于PyTorch的大模型推理系统能够原生运行在Google TPU上。这套方案已经在Meta的大规模生产环境中得到应用。
相比软件框架支持TPU这件事,发布资料中有一个更具体的工程细节值得关注:当Prefill采用16路张量并行、Decode采用8路张量并行时,KV Cache如何从16份数据布局转换为8份,同时完成跨设备传输?
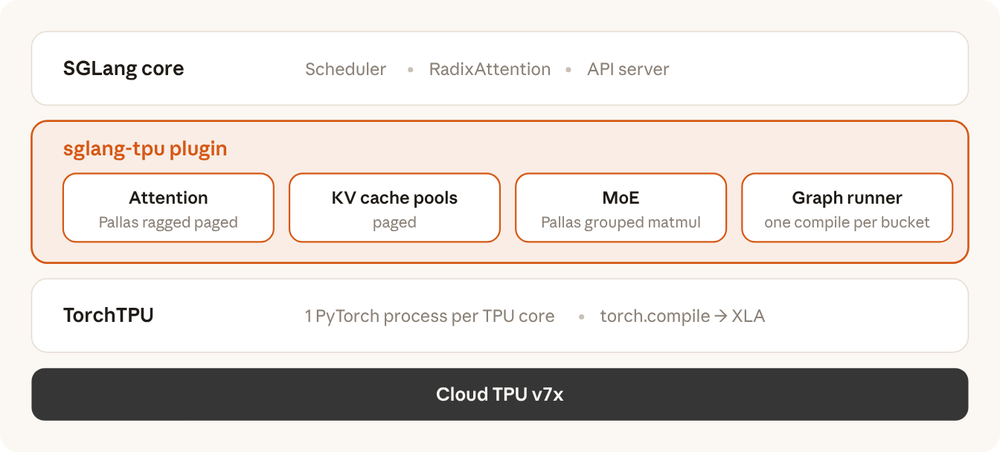
SGLang-TorchTPU 软件栈:SGLang 内核之上叠加 sglang-tpu 插件,向下落到 TorchTPU 与 Cloud TPU v7x(来源:LMSYS 官方博客,2026-10-20)。
Google给出的解决方案是TPU Sync。它能够在数据搬运过程中直接完成KV Cache重分片,并把传输与Prefill计算重叠。这涉及AI加速器的内存布局、DMA和跨设备数据路径,也关系到分离式推理架构能否真正发挥性能。
01|16路变8路,为什么不能直接复制?
在张量并行推理中,KV Cache通常按照注意力头等维度分布在不同设备上。Prefill与Decode如果采用相同的并行配置,缓存传输相对直接;一旦两侧的并行度不同,数据的归属关系也会发生变化。
以官方展示的TP16到TP8为例,Prefill端由16个并行执行单元持有KV数据,Decode端则需要将这些数据重新映射到8个执行单元的缓存页面中。对于可以按KV Head划分的数据,每个目标执行单元可能需要接收来自多个源执行单元的数据切片。
这些切片未必按照目标端需要的顺序连续存放。即使跨设备链路带宽足够高,接收端仍可能需要额外的数据整理,才能把缓存交给Attention内核使用。
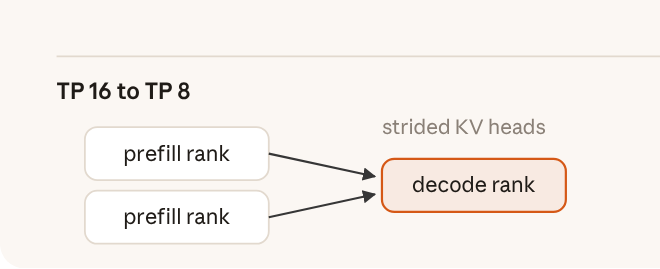
官方展示的 TP 16 to TP 8:多个 Prefill rank 将自己持有的 KV Head 切片按跨步方式(strided KV heads)写入同一个 Decode rank 的页面布局(来源:LMSYS 官方博客,2026-10-20)。
一种常见处理方式是先Gather,将分散的KV切片整理到临时缓冲区;随后通过网络传输,再Scatter到Decode端对应的缓存页面。这条路径便于组织批量传输,但也可能引入额外的读写、缓冲区占用与同步开销。
跨设备通信的成本,因此不只是传输了多少字节,还包括数据为了适配另一种并行布局,被额外搬动了多少次。
02|TPU Sync:在传输过程中完成重分片
SGLang-TorchTPU公开的方案采用TPU Sync,这是Google提供的开源TPU DMA传输组件。
它的一项关键能力,是支持不同张量并行规模之间的在线重分片(In-flight Resharding)。在TP16到TP8的示例中,每个Prefill执行单元将自己持有的KV Head切片,按照目标布局写入对应Decode执行单元的KV页面。
这里的数据写入可以带有跨步访问模式(Strided Access),因此不要求源端先把所有切片拼成完整、连续的大块缓存,再由目标端重新拆分。换句话说,原本独立的布局转换操作被融入了跨设备数据搬运过程。DMA传输不再只是把一段连续内存复制到另一段连续内存,而是需要配合目标设备的页面布局组织数据。
减少中间重排步骤,并不代表数据传输完全没有代价。跨步访问的效率、目标页面分布、并发传输数量和实际链路带宽,仍会影响最终吞吐。公开资料展示了这一机制,但没有给出TP16到TP8场景下,相比传统Gather/Scatter路径节省多少时间的独立量化结果。因此更准确的结论是:它减少了额外数据整理的需求,具体性能收益仍取决于部署配置。
03|Prefill还没结束,Decode已经开始取数据
TPU Sync还针对Prefill与Decode之间的等待时间做了优化。
传统的整批传输方式需要等待Prefill完成,再把生成的KV Cache交给Decode设备。对于长上下文请求,缓存量可能很大,集中传输会直接增加两个阶段之间的等待。
SGLang-TorchTPU采用分块Prefill。每完成一个计算块,Prefill端便公布已经写入的KV页面,Decode端主动拉取这些页面;与此同时,Prefill端继续计算下一个块。
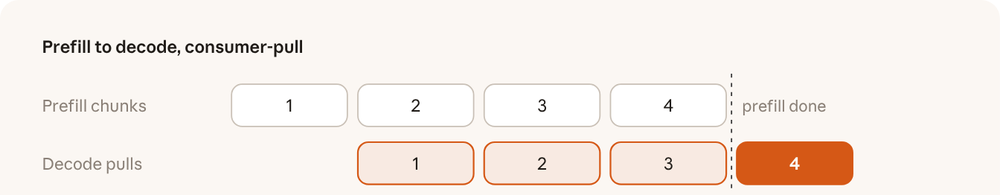
分块 Prefill 与消费端拉取(consumer-pull):Decode 在 Prefill 计算后续块的同时取走已写好的块,只有最后一个块需要等待(来源:LMSYS 官方博客,2026-10-20)。
这样,数据传输与后续Prefill计算可以重叠。当最后一个计算块结束时,前面多个块的KV Cache可能已经到达Decode端,只剩最后一部分需要等待。
这一设计还有两个细节。首先,Decode端已经通过前缀缓存持有的KV页面无需重复发送。其次,TPU Sync直接访问PyTorch张量背后的设备缓冲区,通过独立线程执行传输,避免额外的主机内存中转拷贝和Python调度开销。
这些优化针对的是同一个目标:尽量让计算单元继续工作,而不是等待缓存复制、数据重排或传输任务完成。
04|对AI加速器架构有什么启示?
TPU Sync并没有发明Prefill/Decode分离,也不是第一个处理异构张量并行布局的系统。SGLang在GPU平台上同样存在通过暂存缓冲区完成KV数据Gather、跨节点传输和Scatter的方案。
这次值得研究的,是Google如何把这些需求落实到TPU的数据传输机制中:设备缓冲区直接访问、跨步写入目标KV页面、传输过程中的重分片,以及计算和通信重叠。
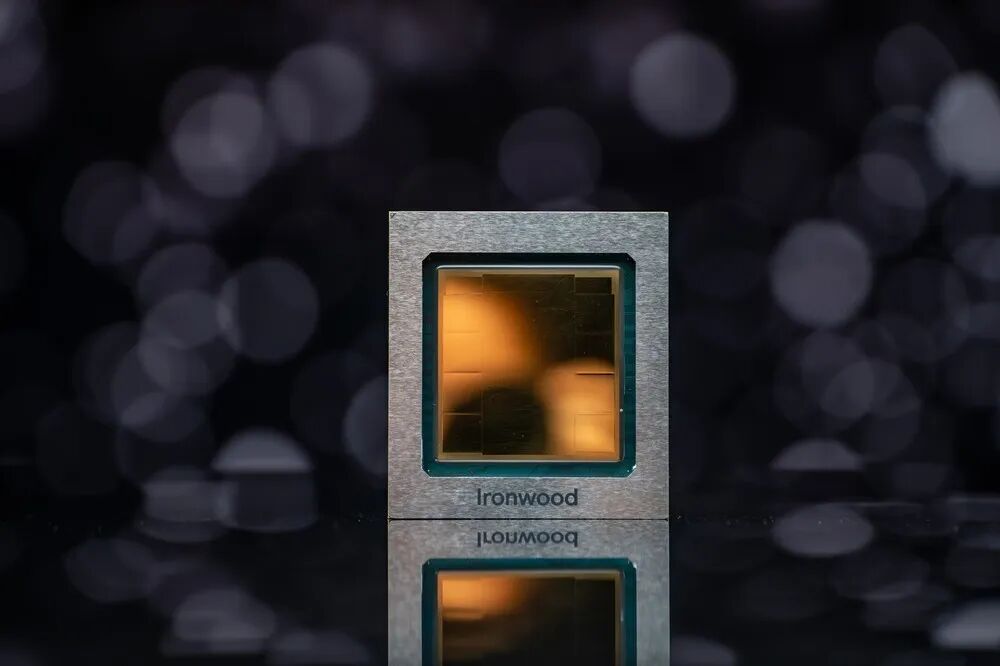
Ironwood TPU 实物,SGLang-TorchTPU 的开发与测试基于 TPU v7x(Ironwood)(来源:Google Cloud 官方博客)。
它反映了大模型推理系统对AI加速器提出的一项具体要求:当计算任务可以被灵活地拆分到不同数量的芯片上,底层数据路径也必须支持不同内存布局之间的高效转换。
这一能力会影响DMA接口、内存管理、运行时调度以及跨设备通信机制的设计。对未来的GPU、TPU和专用AI ASIC而言,单纯提高互连带宽还不够,如何减少传输前后的额外数据搬运,同样值得优化。
Meta生产环境采用SGLang-TorchTPU,说明这套软件栈已经具备实际部署基础。不过,官方展示的TP16到TP8是技术能力示例,并不代表Meta生产集群采用了这一特定配置。
从这个案例可以看到,AI推理的数据路径优化正在深入到缓存页面和DMA访问模式。当不同计算阶段使用不同的芯片并行拓扑时,数据如何重新分布,已经成为与计算性能同样重要的工程设计问题。对于正在探索大模型推理部署的开发者而言,关注这类底层数据路径的演进,也许比单纯追逐框架新特性更具长期价值。
 发表于 昨天 23:18
|
查看: 11|
回复: 0
 /1


