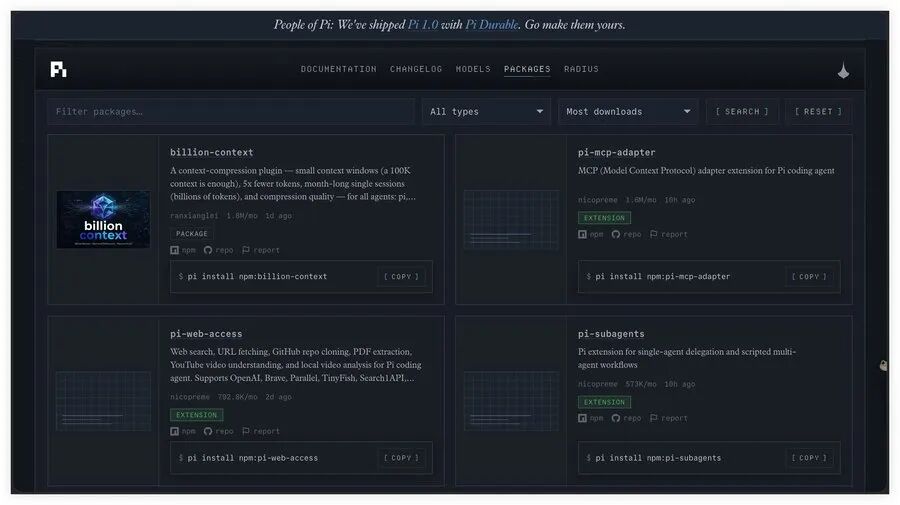
在 Pi 官方包目录按下载量排序,前几名稳定被 5 个插件占着。榜单本身有意思,但更值得看的是榜单后面的东西:为什么一个极简到「README 直接说不带子 Agent、不带计划模式」的终端 coding agent,会催生出 5,375 个第三方包(官方目录全站数,2026-10 查)。这篇把这 5 个插件逐个拆开,顺便把「怎么判断一个插件该不该装」的方法也讲清楚。
Pi 是什么,插件生态长什么样
Pi(pi.dev)是 Mario Zechner(badlogic)写的极简终端 coding agent,一行命令装好(npm install -g @earendil-works/pi-coding-agent 或官方安装脚本),自带 read / bash / edit / write 等基础工具,官方明确说跳过了 sub-agent 和计划模式这类功能——扩展靠 npm 包(extension / package)自己补。包目录在 pi.dev/packages,全站 5,375 个包,搜 subagent 一个词就出 390 个结果(官方目录,2026-10 查)。
装包一条命令:pi install npm:<包名>,临时试用不写进配置:pi -e npm:<包名>,只看装了什么:pi list。后面每个插件都会给安装命令。
装之前先看四件事
插件市场最大的坑不是质量,是同名和过时。验收固定走四步:
- 确认仓库和作者。npm 上存在同名包,照着名字装很可能装到别人家的。打开 GitHub 看最近提交、issue 活跃度、许可证。
- 先临时加载。
pi -e npm:包名 只带这一次启动,退出就没了,确认是你要的行为再 pi install 永久装。
- 只做一个可观察的任务。在空目录给单一任务验收,别一上来接生产账号。
- 看它吃多少 context。每加一个插件,先看它往系统提示和工具表里塞了多少。装太多省 token 的插件前先量,常常删掉某个占大头的比新装更有用。
pi-subagents:把活拆给多个子 Agent
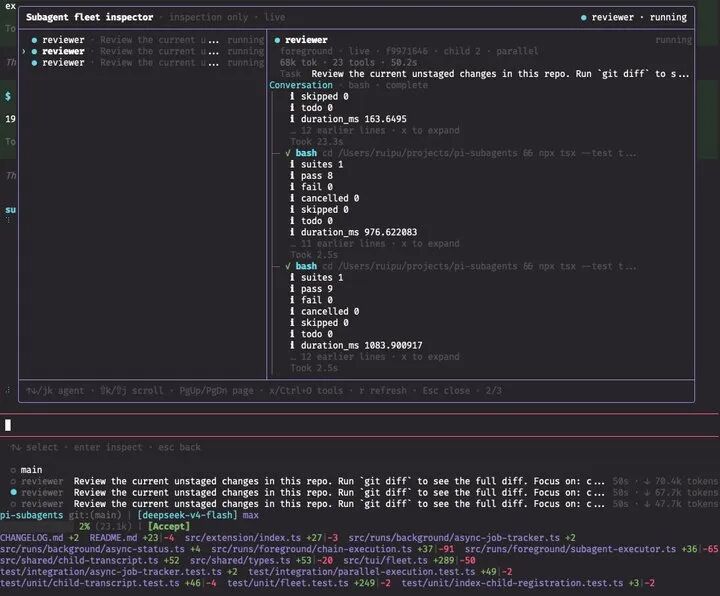
它解决的是「主会话上下文被各种支线污染」的问题。父 Pi 把任务派给聚焦的子会话(独立上下文、独立工具集),子会话干完把结果带回来。装完不用写配置,大白话驱动:Use reviewer to review this diff、Run parallel reviewers: one for correctness, one for tests, one for unnecessary complexity(仓库 README)。
内置 7 个角色(官方文档):scout(代码库侦察)、researcher(带引用的网络调研,依赖 pi-web-access)、evidence-auditor(核查调研结论有没有被来源支撑)、worker(实现,改完文件会自己验证)、reviewer(代码审查)、oracle(只挑战假设不改代码的第二意见)、delegate(接近父会话行为的轻量委托)。常用编排是「实现完跑一轮 reviewer」或「review loop 最多 3 轮到干净为止」。要 Pi 1.2.0+。
边界:子 Agent 是「局部最优」的编排——有第三方实测(brian-kimball.com)和讨论(YouTube 上「Pi to Pi」双向对等 Agent 流派)指出,多 Agent 的价值随角色清晰度递减,任务拆得越干净收益越大;范围模糊的「把整个项目做好」这种任务反而不该拆。
pi-web-access:给 Pi 补联网
不填任何 key 就能用:默认走 Exa MCP 的零配置搜索,登录了 ChatGPT 订阅还能复用 OpenAI 搜索(仓库 README)。能力面:网页搜索(30+ 后端,自动降级)、URL 抓正文、GitHub 链接直接本地克隆让 Pi 读真代码而不是抓渲染页、PDF 提取、YouTube 和本地视频理解。搜索自动降级链很长:Exa → OpenAI → Brave → Parallel → …,单条查询失败自动切下一个(README 完整列表)。
实测下来是「搜索基本都能用,但不是每个网页都能直接读下来」——遇到读不了的换来源或配浏览器插件。要 Pi 0.37.3+,视频抽帧需要 ffmpeg + yt-dlp。
billion-context:让一个会话连跑数天
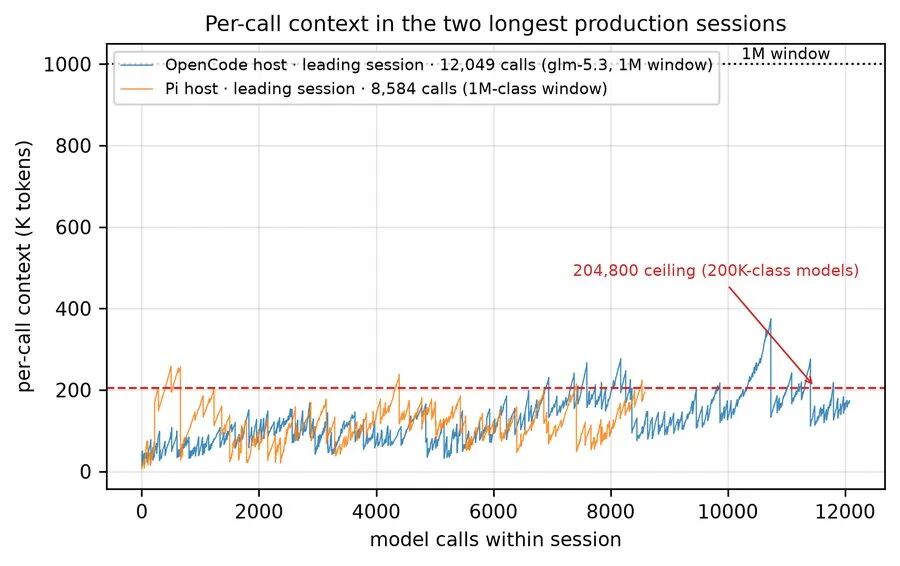
它不是 Pi 专属——架在任意 coding agent 和模型 API 之间的 proxy,重写 Anthropic/OpenAI 流,把已消耗的对话折成分层摘要,让十亿级 token 穿过同一个上下文窗口(仓库 README + 官方 npm 页)。压缩时机和内容由模型自己决定(注入 4 个工具:compress / decompress / search_context / acp_status),不是硬截断。Pi 上用法:pi install npm:billion-context(一体化包)。
官方自报的生产数据(四个半月纵向研究,仓库 paper 目录):3 个宿主、174,327 次调用、187.6 亿累计输入 token、204,800-token 窗口零违规;健康会话前缀缓存命中 95-97%,压缩本身代价 2% 以内。月下载 1.8M,官方榜第一(pi.dev/packages,2026-10 查)。边界:同一会话只装一个压缩插件,装两个会互相覆盖摘要(billion-context-pi README 明说)。
pi-mcp-adapter:把 MCP 装进 Pi 但不烧 context
MCP 服务器的工具定义又长又多,接一个就可能吃掉 1 万+ token,这个数官方文档直接写在 README 里。adapter 用一个 ~200 token 的 proxy 工具顶掉几百个工具定义,工具按需发现,服务器用到才启动、10 分钟空闲自动停(仓库 README)。官方实测(100 个本地 MCP server):Pi 内置 MCP 方案启动即跑 100 个、7.0GB 内存;adapter 方案启动 0 个、用 3 个、10 分钟后来 0 个。工具搜索语义排序 10/11 命中正确工具(词搜只有 5/11,官方 12 个日常请求基准)。
但要写清楚版本变化:Pi 1.0 起 MCP 已内置(pi mcp add + /mcp),社区里 10 月中旬的讨论已经明确说新手不用再装 pi-mcp-adapter 了——它 10 月初还是下载断层第一(月 140 万)。这就是为什么我反复强调看提交时间:榜单型推荐的半衰期以月计。
pi-mcp-extension:官方榜第 5,标准 MCP 客户端
前 4 名已拆完(图是 pi.dev 官方目录「按下载量」视图),第 5 名按官方榜是 pi-mcp-extension(390.3K/mo,irahardianto)。定位和 adapter 不同:它是「标准、稳」那一档——multi-transport(stdio / streamable-HTTP / legacy SSE)、OAuth 2.1 + PKCE + 动态客户端注册、自动重连退避、工具名防冲突、OpenSSF Scorecard 徽章(仓库 README,2026-10 拉仓)。装它之前把 Pi 内置 mcp 扩展关掉(README 第 2 步),否则两边都开会报警告。
和 adapter 二选一的判断标准就一条:你要的是省 context(adapter)还是连接稳 + 合规(extension)。
收尾:我现在的选择
常驻就 3 个:pi-cc-extensions(输出排版)、pi-web-access(联网)、pi-context-view(先看清 context 被谁占,再谈省不省)——这也是社区里反复出现的共识结论。子 Agent 和压缩按需加,别一次装满。
最后一个反直觉的事实:这套生态里变化最快的不是插件,是 Pi 本身。Mario 自己 10 月初就写过「你可能不需要 MCP」,一个月后 Pi 1.0 内置了 MCP,pi-mcp-adapter 的断层第一地位随之过时。装任何插件前花一分钟看最近提交,比看下载量有用。
 发表于 昨天 23:22
|
查看: 16|
回复: 0
 /1


