GPT-6 Luna 真的被扩散 LLM 抢饭碗了吗?
新发布的 Mercury 3 模型规模扩大了 40 多倍,生成速度却依然保持惊人水平,每百万输出 Token 的价格首发更是低至 0.35 美元。昔日主打速度优势的扩散模型,如今开始正面挑战主流大模型的能力边界。
10 月 19 日,由斯坦福大学教授 Stefano Ermon 联合创办的 Inception Labs 发布了一份颇具冲击力的成绩单:Mercury 3 在官方公布的多项基准测试中超越 GPT-6 Luna 和 Claude Haiku 5.5,输出速度达到每秒 1068 Token,最高比 GPT-6 Luna 快约 8 倍。
事实上,第一代 Mercury 就已经实现了每秒千 Token 级的生成速度。真正值得关注的是,当模型规模扩大 40 多倍、能力大幅提升之后,Mercury 3 依然守住了这一速度。扩散 LLM 需要证明的,已经从「我能跑得快」,变成了「我做大、做聪明之后,仍然能跑得快」。
扩散 LLM 开始与 GPT、Claude 拼能力
先看 Inception 官方给出的对比数据。
在同档位对比中,Mercury 3 在 GPQA Diamond 上取得 89.23 分,高于 GPT-6 Luna 的 86.36 分和 Claude Haiku 5.5 的 84.51 分。这个测试考查的是研究生水平的专业科学知识和推理能力。换到更贴近实际开发的任务,差距更加明显:SWE-Bench Atlas 上,Mercury 3 得分 51.08,而另外两款模型分别只有 33.33 和 32.26。指令遵循测试 IFBench 中,Mercury 3 也拿到了 76.84 分。
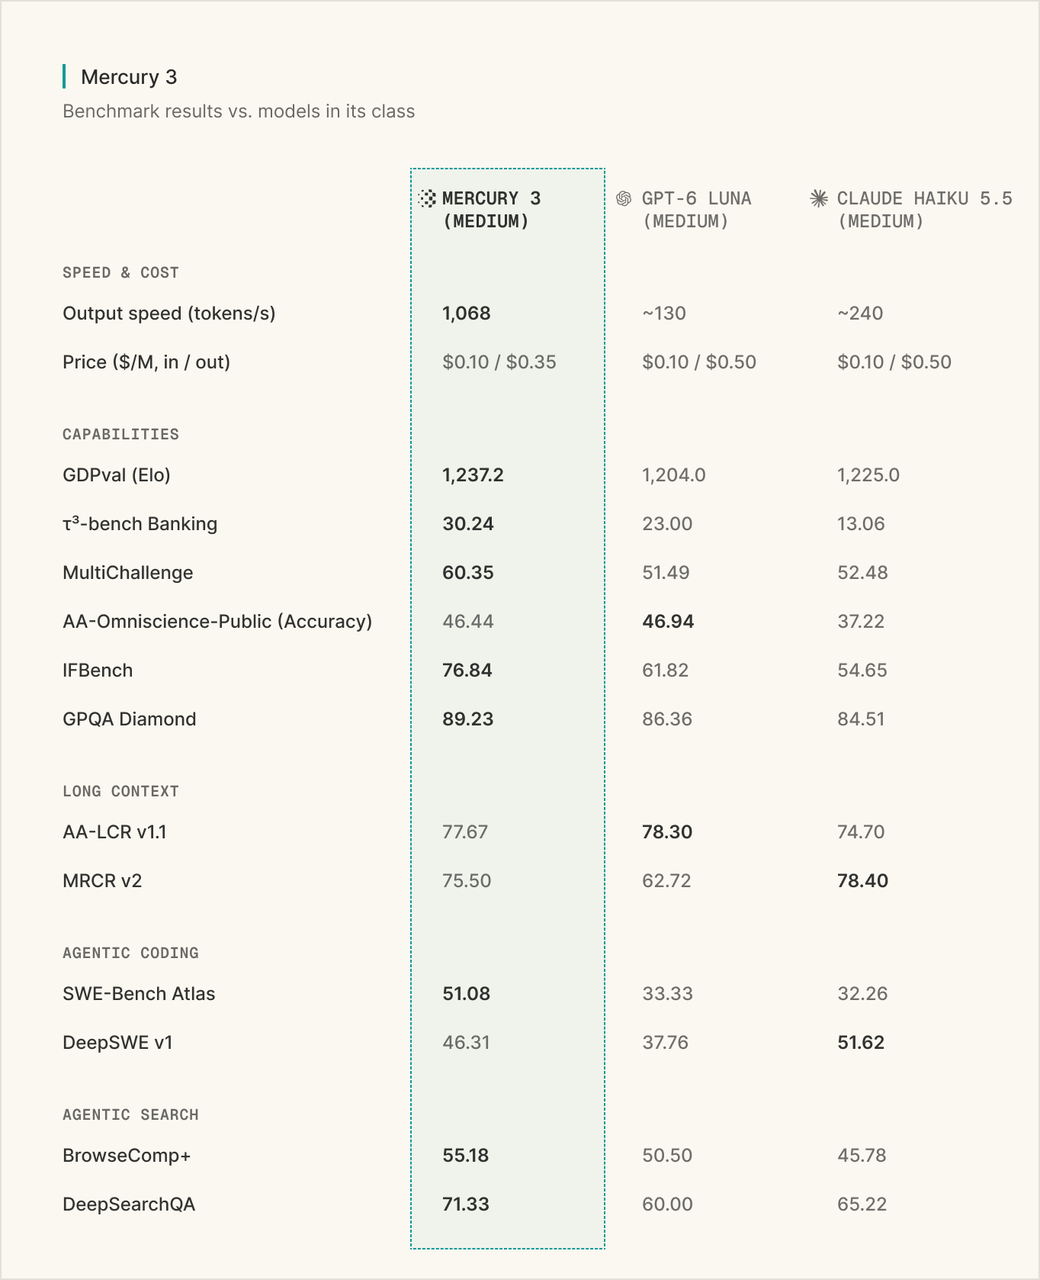
也就是说,Inception 这次并非拿一个只能快速输出简单答案的模型,去跟主流 LLM 拼速度。它展示的是,扩散路线同样可以胜任知识问答、复杂指令和真实软件工程任务。
再看速度:Mercury 3 在 NVIDIA GPU 上的输出吞吐达到 1068 Token/s。Inception 给出的 GPT-6 Luna 与 Haiku 5.5 对应速度分别约为每秒 130 和 240 Token。
能力和速度之外,还有两组数字值得留意。Mercury 3 的上下文窗口扩大到 100 万 Token,此前 Mercury 2.5 为 26 万。首发期间每百万输入 Token 收费 0.10 美元、输出 0.35 美元,正式标价则分别为 0.20 和 0.70 美元。
参数量暴涨 40 多倍,扩散 LLM 如何守住速度优势?
要理解这一点,得先看看主流大模型是如何生成文本的。
GPT、Claude 等主流自回归语言模型,通常沿着从左到右的顺序,一次预测下一个 Token。写出前面的内容,才能继续预测后面的内容。哪怕 GPU 擅长并行计算,这条逐步生成的链条本身也无法直接消失。
扩散语言模型则采用了不同的生成方式。它同时预测多个位置的内容,再通过多轮迭代不断调整,最终生成完整、连贯的文本。
可以把它想成两种写作方式:一种是一边想一边逐字落笔,另一种是先铺出整段草稿,再同时修改多处内容。后者同样需要反复推敲,但每一轮都能同时推进多个位置。这种并行处理能力正是扩散语言模型实现高速生成的关键:一次前向计算可以更新一批 Token,显著减少生成整段文本所需的串行步骤。因此,即使需要经过多轮迭代,整体生成速度仍有可能超过逐 Token 预测的方式。
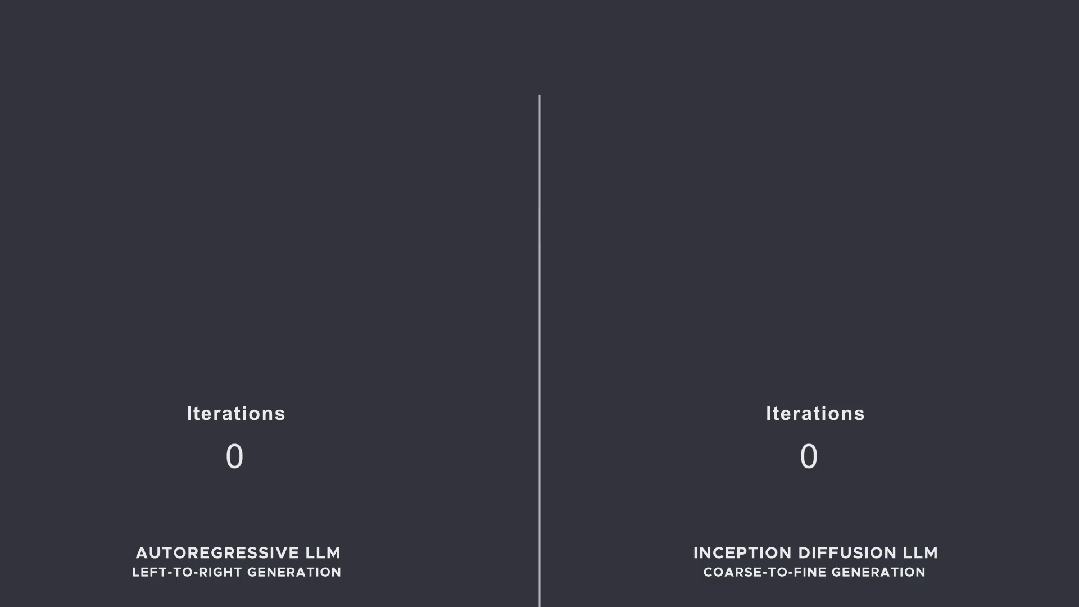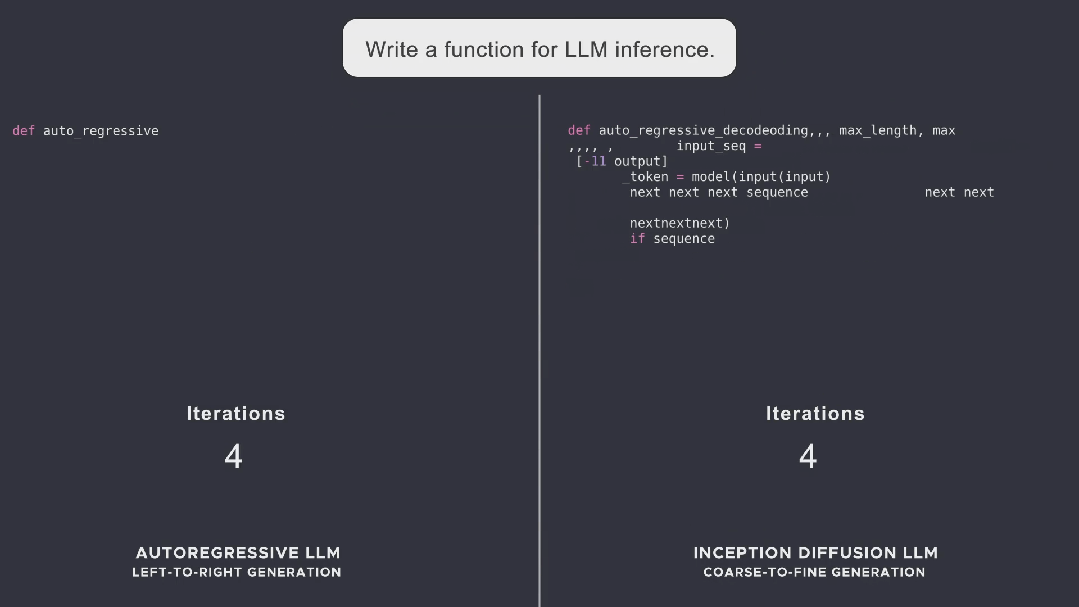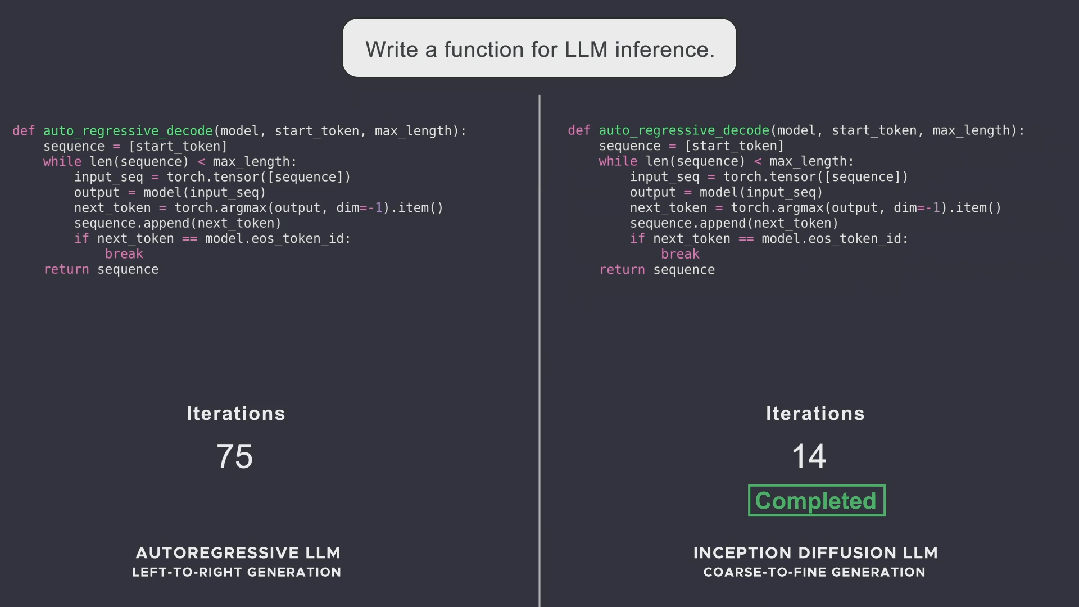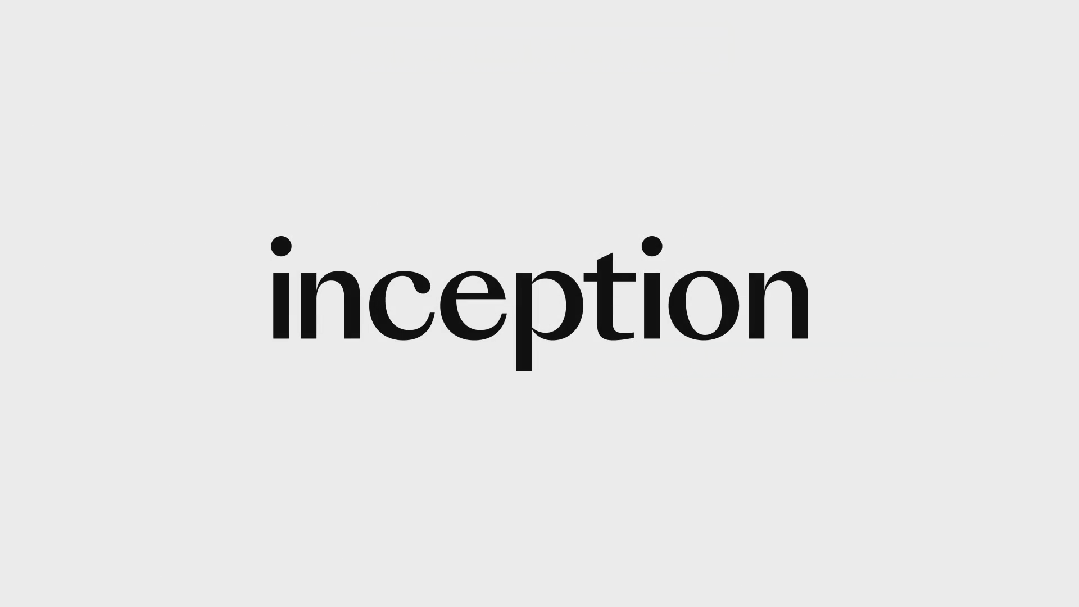
当然,把图像扩散的思路搬到文字上,并没有想象中那么简单。图像中的噪声可以逐渐变成清晰的像素,而语言却由一个个离散的 Token 组成,模型必须决定哪些位置先确定、哪些还要继续修改。一次并行得越多,生成就可能越快;但修改轮次不够,又容易让句子、代码和推理步骤互相打架。扩散 LLM 真正要解决的,是在并行程度与生成质量之间找到平衡。
早在第一代 Mercury 的技术报告中,团队就介绍了用 Transformer 在多个文本位置上并行预测、从粗到细完成生成的技术路线。2025 年发布的 Mercury Coder Mini,第三方测得的速度为 1109 Token/s;但那个阶段,扩散模型最让人记住的仍然是速度,复杂任务能力还不是它最硬的招牌。
此后,Mercury 系列持续迭代:从通用聊天到推理模型,再到 Mercury 2.5。Inception 此前介绍过一系列改进方向,包括扩大训练规模、优化去噪网络与训练目标、改进推理算法,以及底层算子和服务引擎的优化。
到了 Mercury 3,官方给出的变化相当直接:总参数量相对 Mercury 1 扩大 40 多倍,标准基准上的综合能力相对 Mercury 1 mini 提高约 3 倍,而生成速度依然维持在千 Token 每秒的量级。
这也让扩散 LLM 的规模化潜力得到了更直接的验证:随着模型规模扩大、复杂任务能力不断提升,并行生成带来的速度优势依然能够保留下来。
Agent 时代,扩散 LLM 找到了新角色
更快的回答当然受欢迎。但在 AI Agent 场景中,快意味着另一件事:谁先把任务做完,谁才是真的快。
假设让一个浏览器 Agent 帮你查找几家供应商的报价,并整理成表格。它需要打开网页、寻找信息、判断页面是否有用、进入下一层链接、提取数据,还可能发现资料不完整,再回头搜索。整个过程中,每一次观察页面、决定动作之后,都要等待模型给出下一步判断。十几次、几十次调用叠加起来,每一步的延迟就会变成用户真正感受到的等待。
Inception 这次拿出的合作案例,恰好展示了 Mercury 3 在多步骤网页操作和实时交互场景中的实际表现。
浏览器 Agent 公司 TinyFish 将 Mercury 3 接入自己的生产级网页代理系统,在 50 项真实网站上的 Mind2Web 导航任务中与前沿模型展开测试。联合创始人 Shuhao Zhang 透露,Mercury 3 成功完成了其中 25 项任务,完成率达到 50%,明显高于 GPT-6.1 Sol。而且,Mercury 3 消耗的 Token 数量和执行步骤与对比模型相当,每个 Token 的成本却低得多。
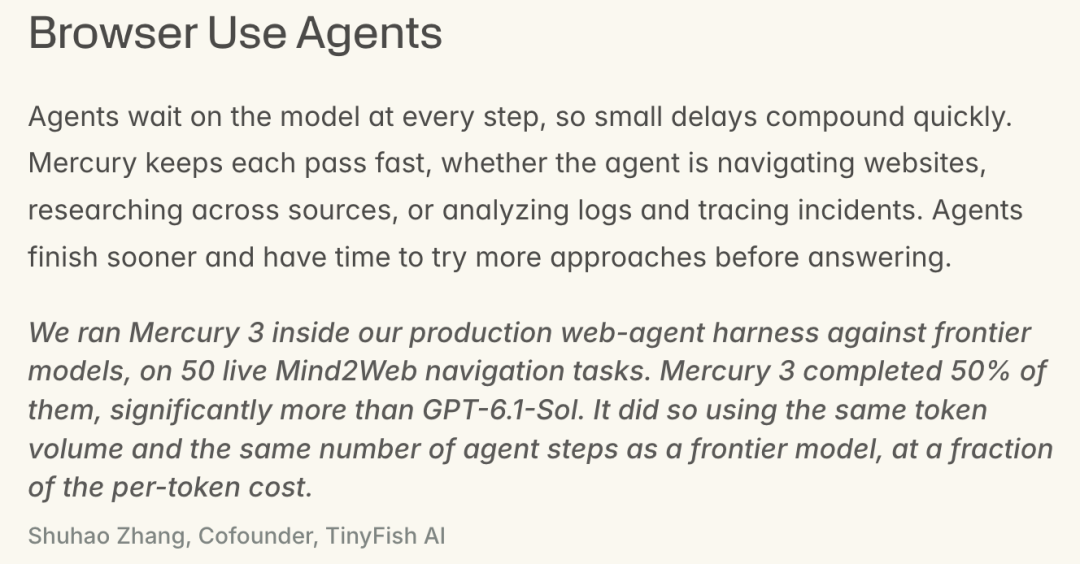
对于需要反复观察网页、判断下一步操作的浏览器 Agent 来说,更快的模型响应意味着可以在更短时间内推进任务,而较低的调用成本也让高频、多轮操作变得更加经济。在模型接入层面,RouteFast.ai 也提供了多款主流大模型的 API 中转服务,适合需要灵活调度模型的工程场景。
另一个案例来自实时搜索公司 Octen AI。它为智能眼镜等场景提供搜索能力。在其 Sense API 测试中,搜索环节大约只需要 80 毫秒,真正拖慢回答的是模型生成。换用 Mercury 3 后,模型生成耗时中位数降到了 0.9 秒,端到端响应中位数为 2.2 秒,在受测的高速模型中实现了最好的速度与质量平衡。
对着智能眼镜提一个问题,等五秒才听到回答,与两秒左右得到回应,是两种截然不同的体验。前者更像「提交请求」,后者才开始接近自然交谈。
看到这里,FlashAttention 作者 Tri Dao 的一条评论就很有意思了。
他在转发 Mercury 3 时写道,自己一直希望把一个足够聪明的「协调者/架构师」模型,与一个速度极快的「执行者」模型组合起来;扩散 LLM 或许正好能担任后者。
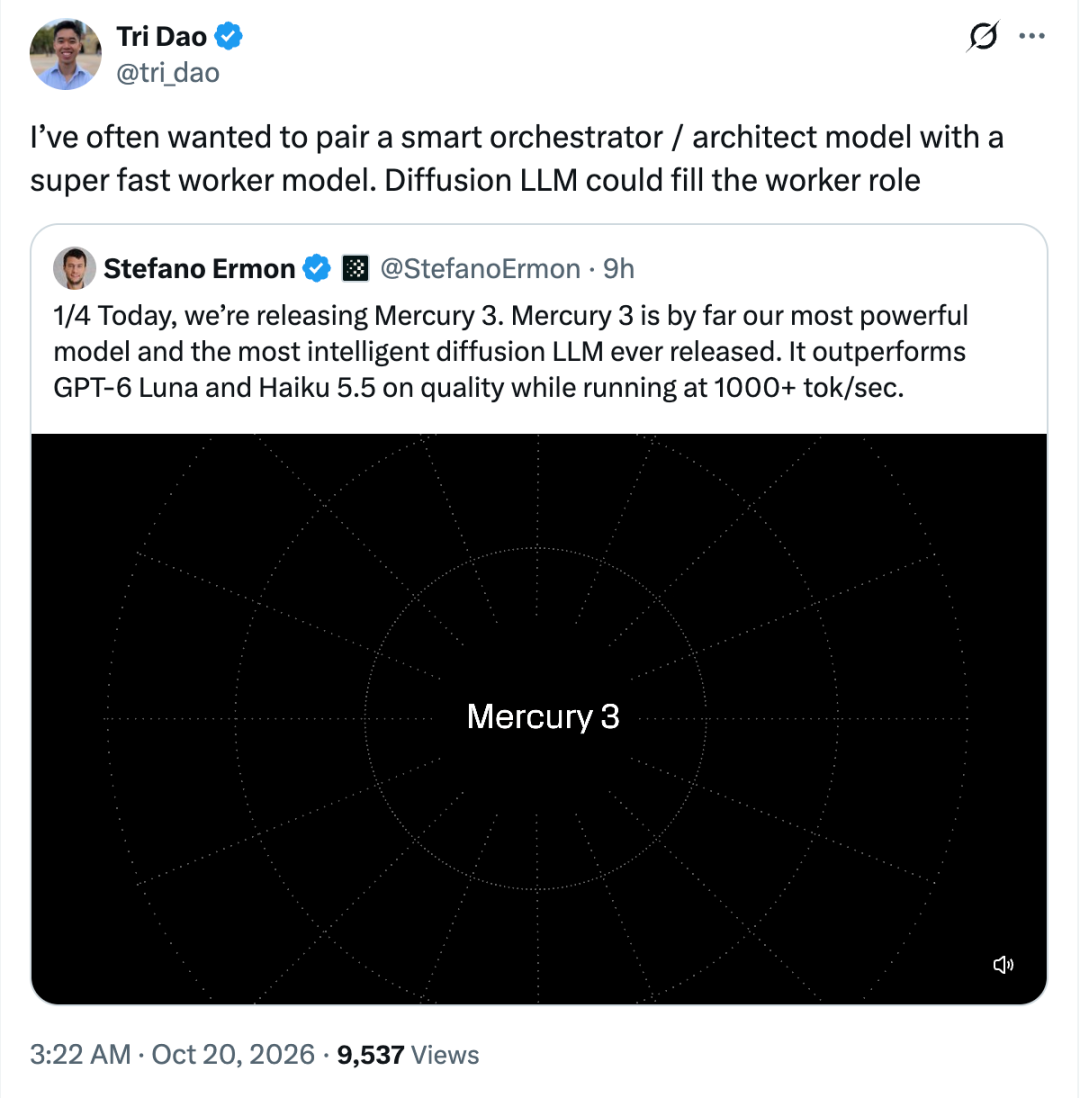
这句话提供了另一种看待大模型竞争的视角。
过去讨论新模型,人们总习惯问它能不能击败最聪明的模型,拿到更高的基准分数。但一个真正干活的 Agent,未必需要每一步都由最昂贵、最强的模型亲自完成。
负责理解目标、拆解难题、制定计划的模型,可以把能力放在第一位;而检索信息、检查页面、提取字段、反复执行操作的模型,则更在意响应速度、可靠性和成本。前者像项目负责人,后者像随时待命的执行团队。
这也改变了「快」的衡量方式。聊天时,一秒与三秒的差别或许只是感觉是否流畅;Agent 如果要连续进行二三十轮工具调用,每一步省下的时间,最终都可能变成完成整个任务所需的总时间。
在这样的分工里,Mercury 3 的定位也逐渐清晰:成为 Agent 系统中那个既足够聪明,又能快速响应、持续执行任务的角色。
参考链接
 发表于 1 小时前
|
查看: 8|
回复: 0


