我们刚刚见证了历史。
最近,「递归自我改进」(RSI)领域接连扔出两颗重磅炸弹。过去十年,预训练一个基座大模型一直被视为科技巨头的战备竞赛:开源社区需要几十名顶尖专家,硅谷 AI 实验室需要几百人,有人专攻架构与扩展定律,有人清洗数万亿 Token 的数据,还有人日夜盯着成千上万张 GPU 防止集群崩溃。
但就在今天,这道看似不可逾越的铁幕,被硬生生撕开了一道口子。两家初创公司几乎同时甩出王炸,把 RSI 从科幻概念直接砸进了现实。
消息一出,硅谷 AI 圈彻底沸腾,无数从业者后背发凉、连夜失眠。
1个人单挑百人军团:两款模型横空出世
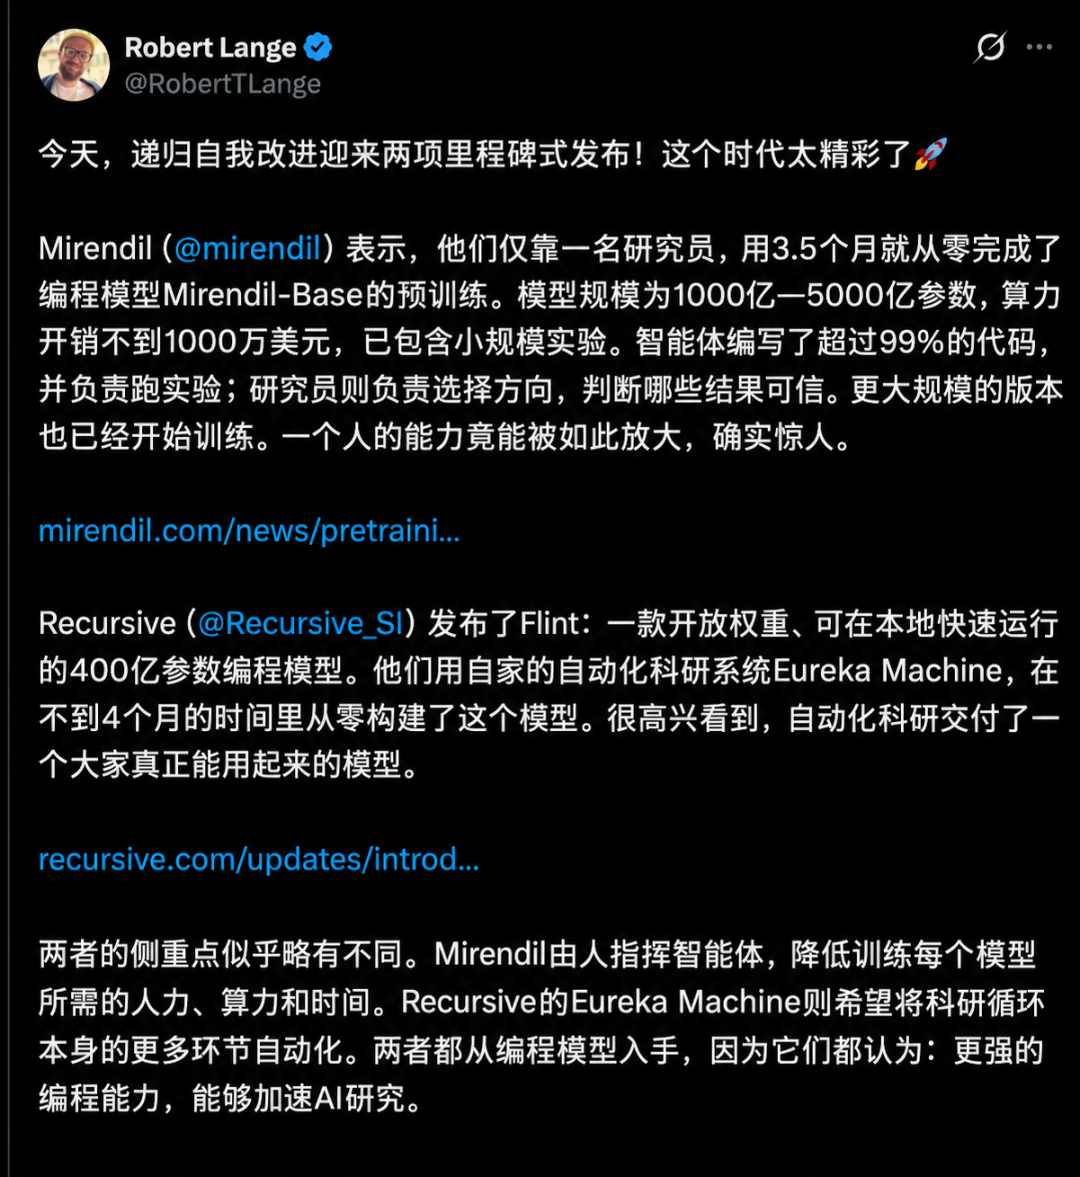
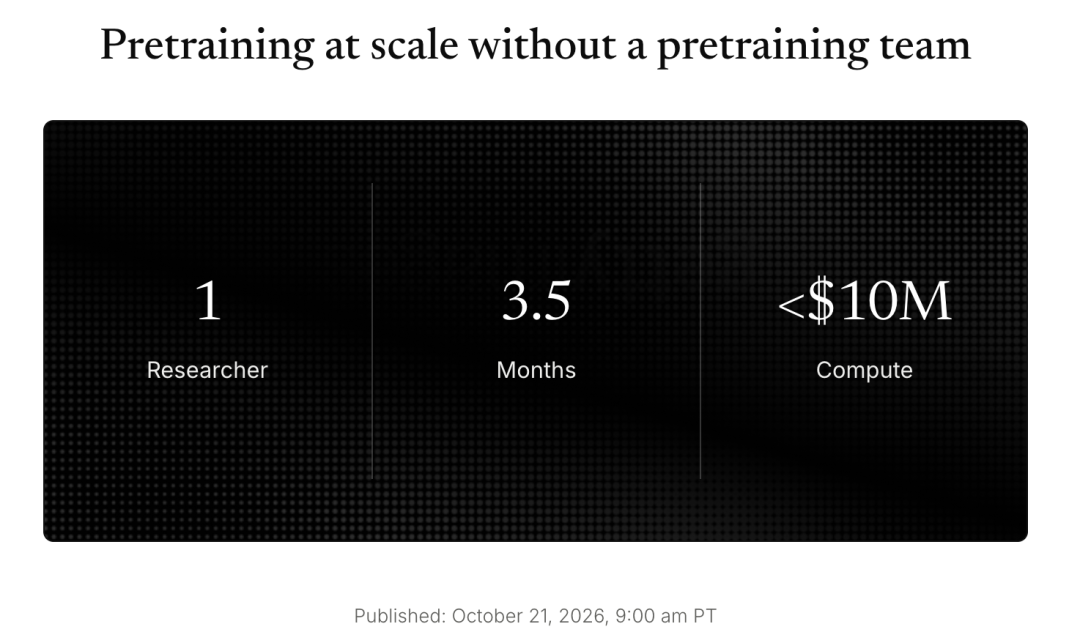
今天的第一颗核弹来自初创公司 Mirendil。他们宣布了一项把人效杠杆推向极致的疯狂实验:仅用 1 名研究员,从零手搓出参数量在 1000 亿到 5000 亿(100B–500B)之间的编程基座模型——Mirendil-Base。
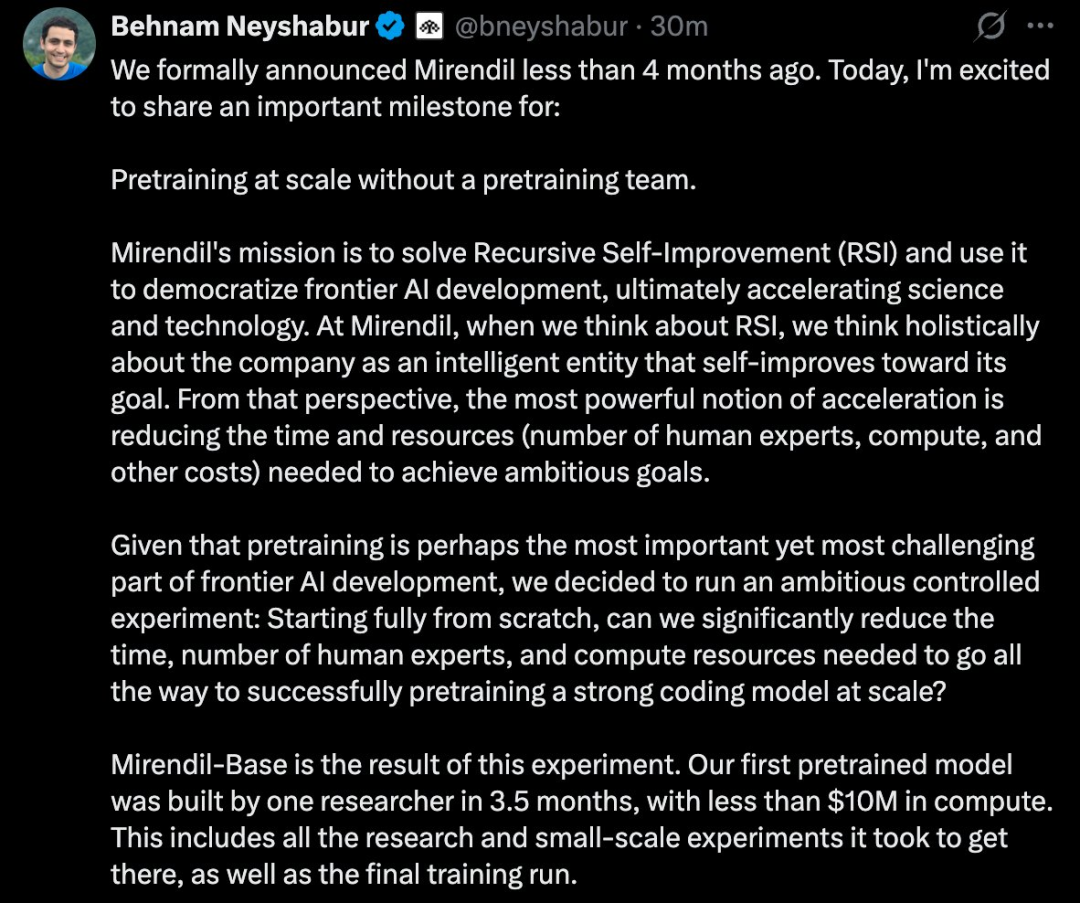
全程算力开销不到 1000 万美元(含所有前期探索实验和 Agent 的 Token 消耗),耗时仅 3.5 个月。
最让人头皮发麻的是细节。项目从一个空荡荡的代码库开始,没有买任何商业授权数据,没有用任何模型蒸馏或合成数据,纯粹基于 PyTorch、JAX 和公开的 GitHub 代码与网页数据。过去需要一个大厂团队分工协作才能搞定的训练基建、模型架构改进、数据配比调优、底层算子(Kernel)优化,都是谁干的?答案是:AI 智能体(Agents)编写了超过 99% 的代码,自己跑完了所有实验,甚至自己诊断训练故障。而那唯一的一名人类研究员,在 3.5 个月里只干了两件事:决定尝试什么研究方向,以及判断哪些实验结果值得相信。
你以为单人训出来的模型只是个玩具?看一眼评测结果,所有人都沉默了。在预测代码库任务中,Mirendil 团队直接拉出目前市面上最强的五个怪兽级编程模型同台竞技:
- Kimi-K3(总参数 2.8T / 激活 104B)
- DeepSeek-V4-Pro-Base(总参数 1.6T / 激活 49B)
- Inkling(总参数 975B / 激活 41B)
- GLM-5.3(总参数 753B / 激活 40B)
- Nemotron-550B-Base(总参数 550B / 激活 55B)
面对这些动辄上万亿参数、背后站着数百人顶尖团队的 MoE 巨头,100B–500B 规模的 Mirendil-Base 不仅打得有来有回,甚至在多个训练后新发布的外部代码库测试中拿下了惊人的高分。
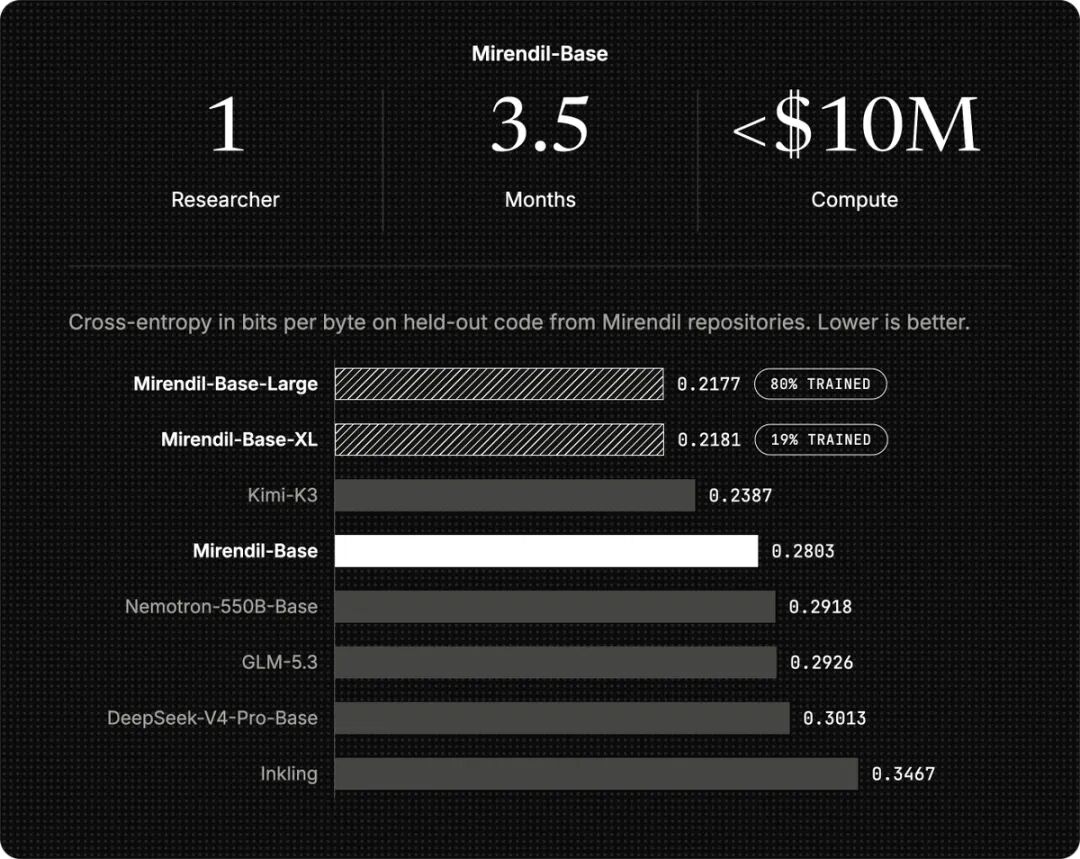
以跨分词器公平对比的 bits per byte 交叉熵衡量,越低越好。
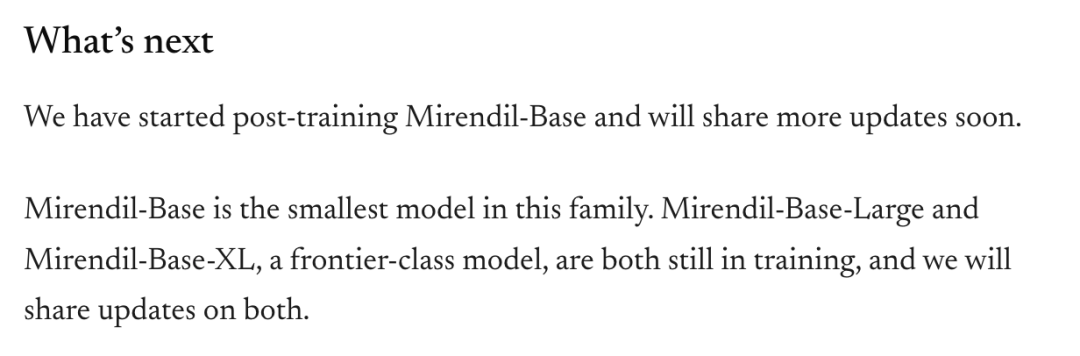
更恐怖的是,这只是个开始。Mirendil 透露,更大的 Mirendil-Base-Large(500B–2T 参数) 已经训练了 80%,而旗舰版 Mirendil-Base-XL(2T–10T 参数,真正的十万亿级巨兽) 训练进度刚到 19%,其表现就已经逼近了 Large 版本目前的得分。而且,他们的下一代模型将直接由 Mirendil-Base 自己参与构建。
另一家大牛田渊栋的初创企业 Recursive,正式发布了开放权重的 400 亿参数(40B)编程模型——Flint。在短上下文场景下,Flint 在搭载 M4 Pro 芯片的 MacBook Pro 上每秒可生成超过 125 个 Token;在 64GB 版 NVIDIA RTX Spark 上每秒可生成超过 150 个 Token,速度最高可达同类模型的两倍。
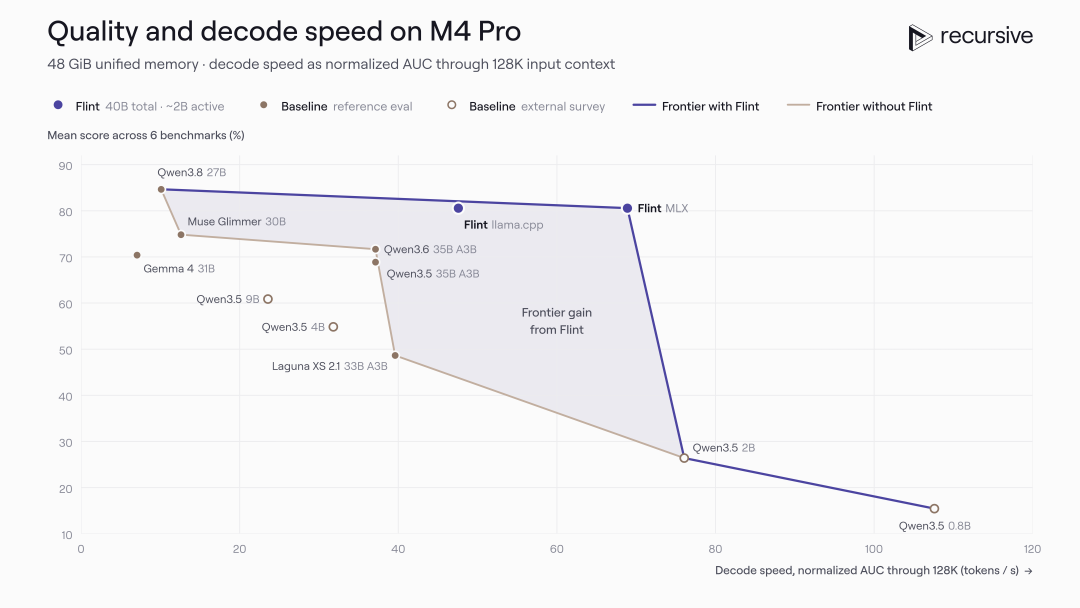
在智能体编程基准测试中,总参数量低于 500 亿的 MoE 模型里,Flint 勇夺鳌头。
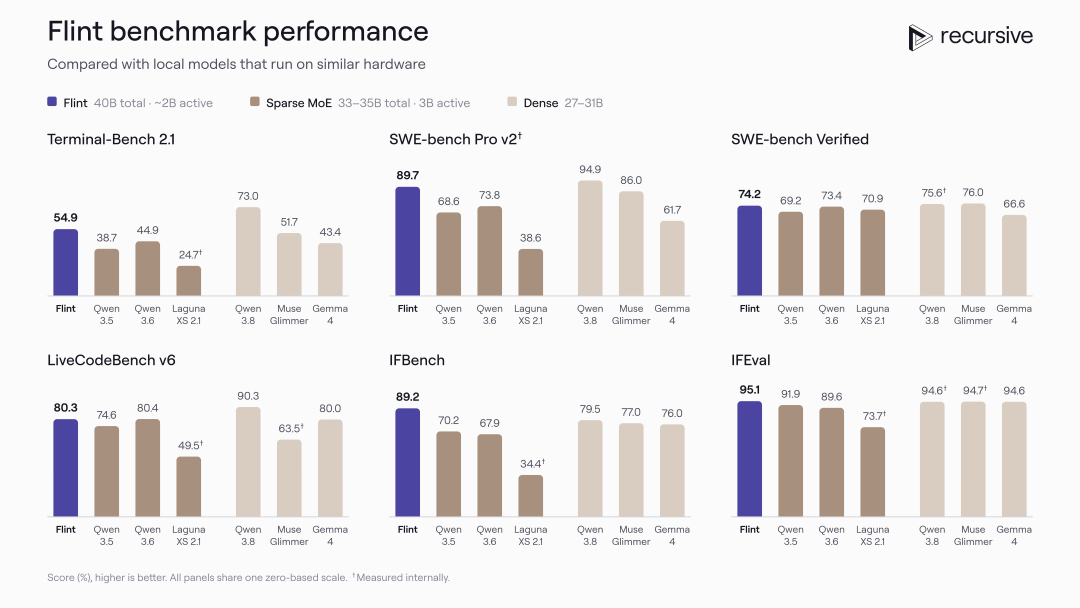
它的性能足以媲美总参数规模相近的最强稠密模型,运行速度却快得多。
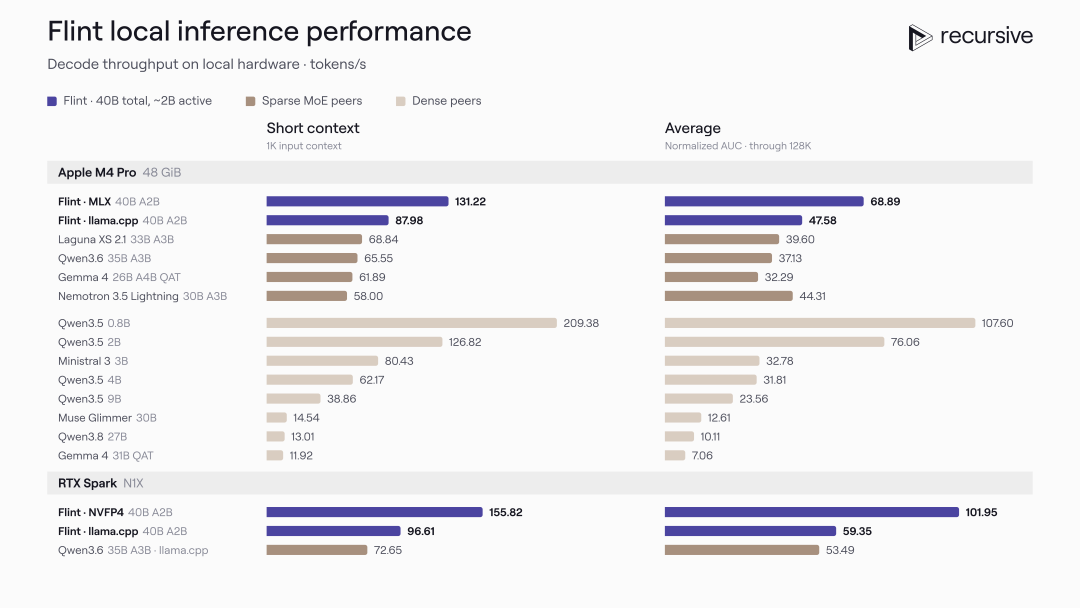
更让人吃惊的是,Flint 本身只是附赠品,真正的主角是背后的 Eureka Machine——一套自动完成「提想法→实现→测试→决定下一步」完整研究循环的系统。用 Flint 这个实际交付的模型,证明自动化研究确实能造出东西,而不只是跑玩具实验。
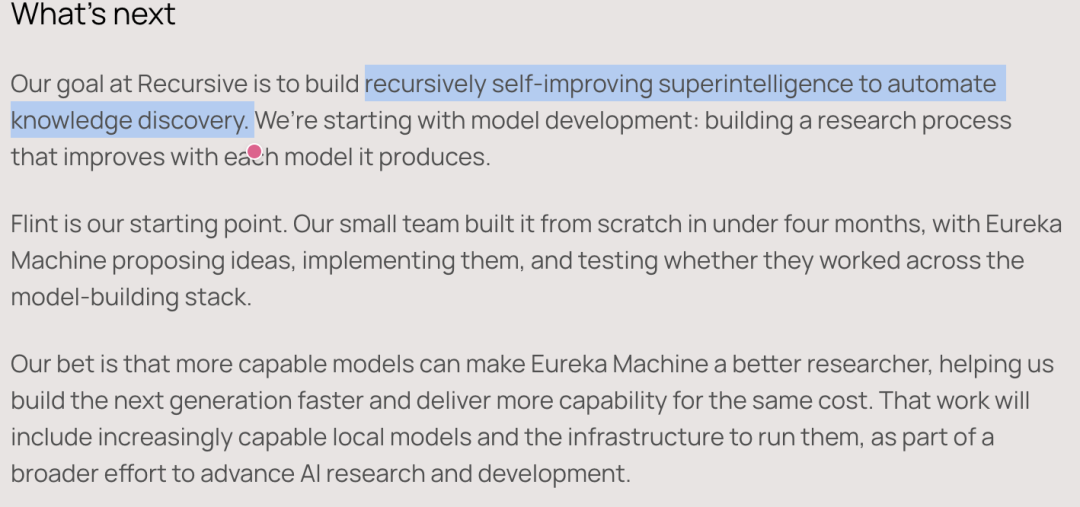
Recursive 的目标是打造能够递归自我改进的超级智能,用来自动化知识发现。Mirendil 是「由人指挥 AI,把人力和时间压缩到极致」;Recursive 则是「用 Eureka Machine 让研究过程本身高度自动化」。两家公司不约而同地瞄准了 RSI:
AI 编程能力越强 ➡️ AI 搞科研的速度就越快 ➡️ 造出更强的下一代 AI。
闭环,正在我们眼前合拢。加州大学伯克利分校教授、Databricks 联合创始人 Ion Stoica 等大佬纷纷转发惊叹。
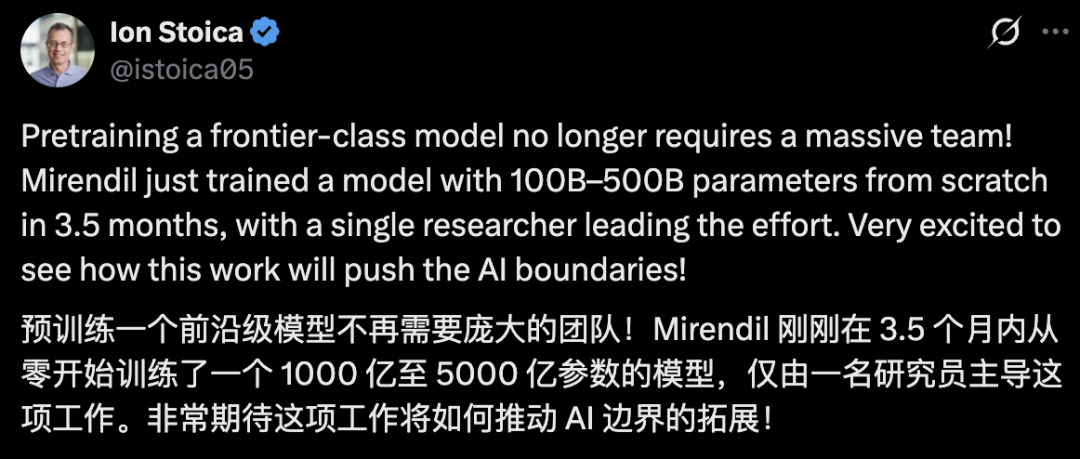
正如业内人士所言:「很快,一切就只取决于两件事:你有多少算力,以及你的『发现循环』做得有多好。」
初级研究员破防了,NVIDIA大佬紧急喊话
历史的车轮滚滚向前,但被碾过的人却感到了刺骨的寒意。看到 Mirendil 和 Recursive 的消息后,一位刚入行的初级研究员彻底破防了。他深夜给英伟达(NVIDIA)资深研究员 Ali Hatamizadeh 发去私信,字里行间全是沮丧和恐惧:
整个预训练过程就一个人,没有研发团队,什么都没有……如果一个人加一个计算集群,就能干完过去整个团队的活儿,那我花了这么多年苦心积累的专业能力,岂不是还没捂热就已经过时了?
这种焦虑,正在 AI 实验室和程序员群体中疯狂蔓延。面对年轻同事的恐慌,Ali 没有熬鸡汤,而是写下了一篇极其硬核、甚至有些扎心的长文紧急喊话:别被营销标题吓破了胆!你并没有过时,但你的饭碗确实已经换了!
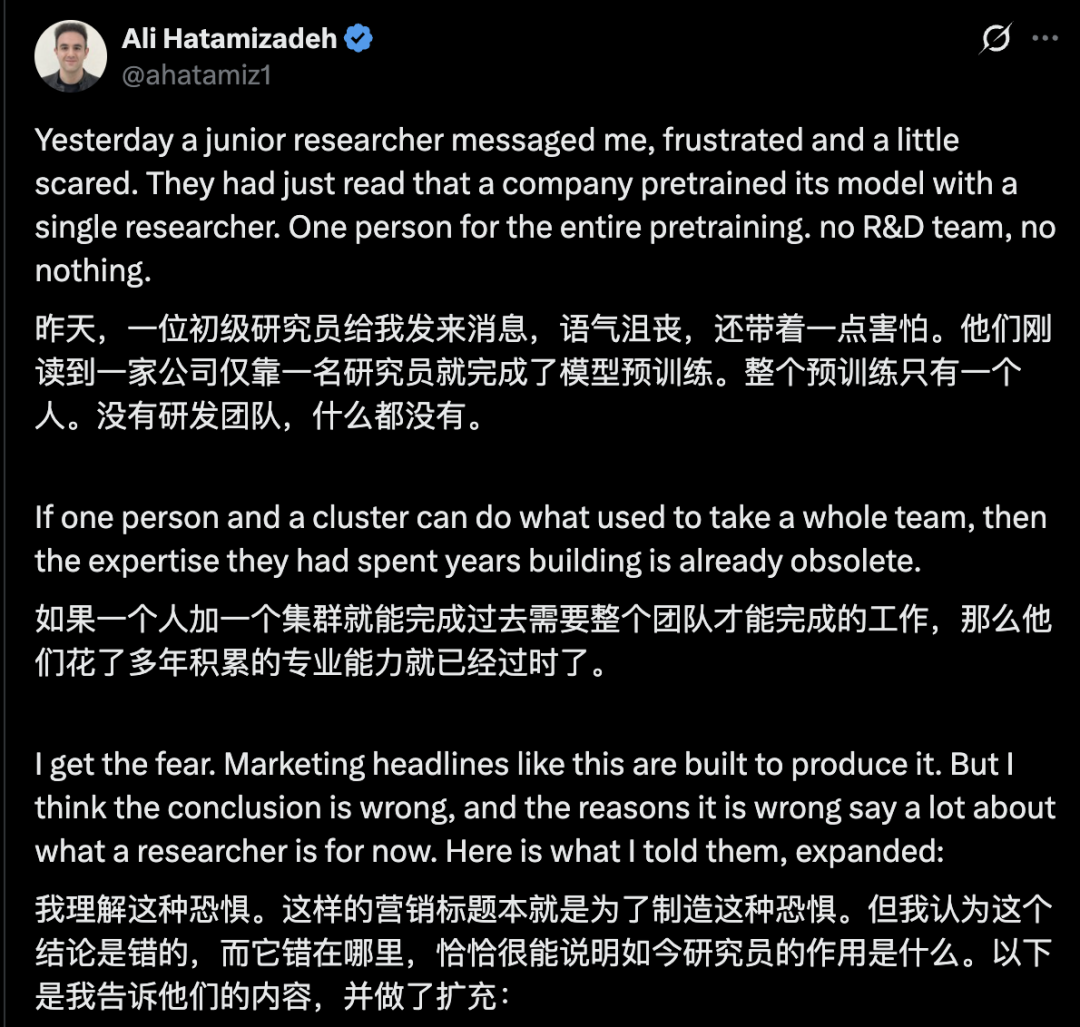
Ali 撕开了「单人训千亿模型」背后的底层逻辑,并指出了普通研究员在 RSI 时代的四大生存法则。
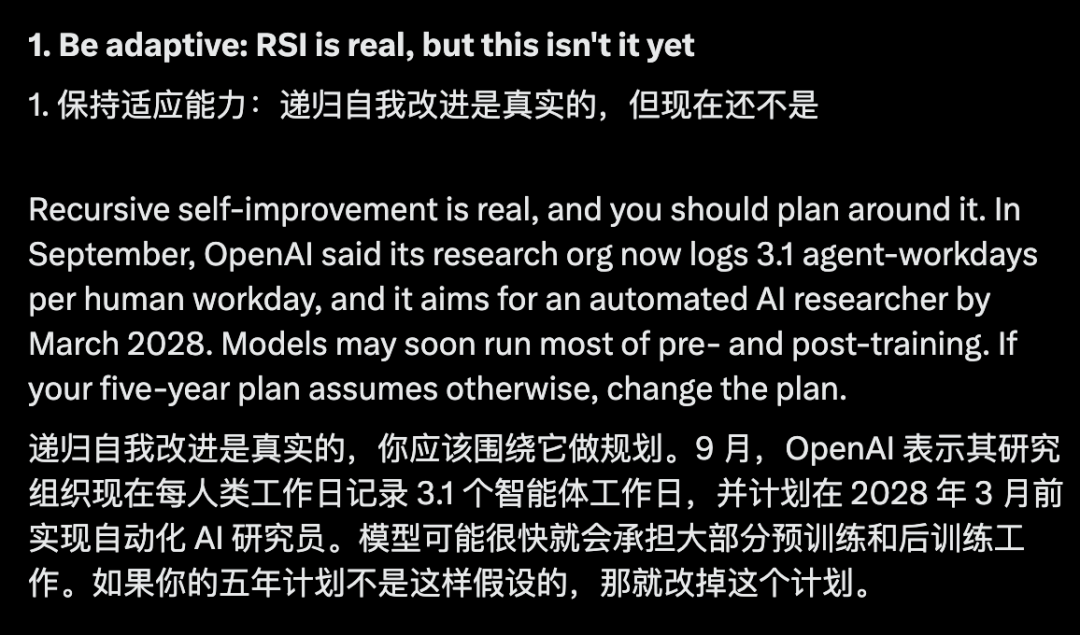
第一,认清现实,别再靠复读旧配方混日子了。 Ali 直言,递归自我改进确有其事。今年 9 月,OpenAI 就披露其研究部门记录的智能体工作量已经达到每个人类工作日对应 3.1 个智能体工作日,并计划在 2028 年 3 月前实现「自动化 AI 研究员」。如果你的五年规划还假设 AI 不会接管预训练,那趁早改规划吧。
但是,为什么 Mirendil 的 1 个人能训出模型?因为常规预训练的配方已经彻底成熟且公开了。各大厂早就把开源权重和详细技术报告喂到了嘴边。只要算力管够,照着公开的常规架构(比如加个滑动窗口注意力),让 AI 把代码写出来,训出个好模型根本不难。这时候解决的是执行和预算问题,而不是科研问题。
如果你的主要工作,只是把去年的训练方案稍作调整、换批数据再跑一遍,那么这类工作的空间正在迅速缩小。
这是最让人不舒服的真相:靠复现已有成果当炼丹童子的旧饭碗,已经被 AI 砸碎了。
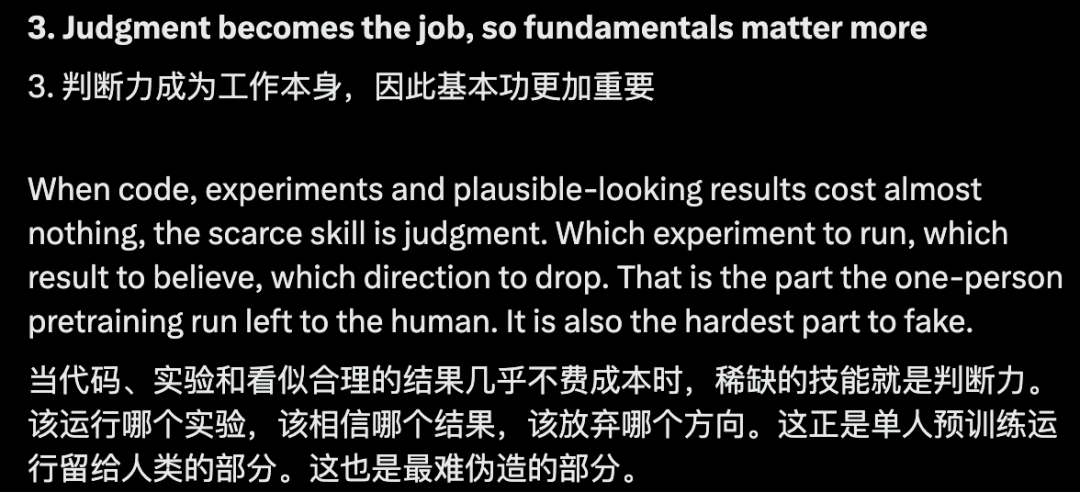
第二,AI 吃掉了执行力,判断力成了你的天价新饭碗。 既然 AI 写了 99% 的代码,那为什么还需要人类?因为自动化科研在最关键的环节上根本还没跑通。
比如在 EinsteinArena 平台上,AI 智能体确实刷新了 11 个未解数学问题的纪录,但前提是人类事先定义好了问题,并写好了自动评分代码。还有前阵子吹上天的「全 AI 生成论文通过同行评审」,扒开细节一看:它只通过了一个接收率高达 70% 的 Workshop 初审,非主会,而且后来还撤稿了。在 OpenAI 内部,那些人类需要花 4—8 小时完成、而智能体最终成功完成的任务中,超过一半仍然需要至少一次人工干预。
为什么?因为智能体给出答案极快,语气永远自信满满。它会兴冲冲地跑来告诉你「某项指标暴涨了 3 个点」,还贴心地附上了消融实验表格和一套自圆其说的解释。但实际上,这 3 个点可能完全是假象——它来自评测中的数据泄漏、数据加载器的底层 Bug、碰巧撞大运的随机种子,或者分词器不匹配。在执行成本归零的时代,决定该做哪个实验、该相信哪个结果、该放弃哪个方向的判断力,就是你最铁的新饭碗。把智能体的速度加上你自己的想法和判断力,哪怕你是刚入行的初级研究员,也能瞬间化身为十倍效率研究员。
第三,时代的悖论:越把活儿交给 AI,你的基本功越得硬。 很多新人会想:既然以后只拼判断力,那我是不是不用学底层代码了,直接学怎么指挥 AI 就行?
Ali 给出了一个振聋发聩的警告:这就是这个时代的悖论——交给智能体的工作越多,你的基本功就越重要。因为你永远无法监督自己不理解的东西。你能一眼看出 AI 跑出的结果有猫腻,靠的是对整个系统骨子里的理解:损失曲线为什么长成这种形状?多大的提升才符合物理规律?什么样的结果「好得令人起疑」?
怎么练就这种毒辣的眼光?Ali 给出了最实在的建议:
- 亲手造轮子:至少亲手从零实现一次注意力机制(Attention),再实现一种线性变体,比如 Gated DeltaNet。
- 搞破坏实验:从头到尾自己训练一个小模型,然后故意把它弄坏,亲眼观察崩溃时会发生什么。
- 带着质疑读论文:连附录也别放过,在看到作者的实验数字之前,先在脑子里对合理的结果建立预期。
有了这些硬核知识,你才能真正指挥机器,而不是它说什么你就信什么。
第四,大模型远未研究透,遍地都是黄金考题。 最后,别觉得大模型已经没啥可研究的了。一个人能训出基座模型,只是因为旧路已经被趟平了。Ali 直接列出了 7 个至今无人能完美解答的黄金课题,随便突破一个都够你吃一辈子:
- 少样本高效学习:怎样用更少的数据学到更多东西?
- 新架构探索:像 Gated DeltaNet 这样的线性注意力,能否在检索和长上下文任务中追上全注意力?混合架构中两者该如何配比?
- 持续学习:怎样让模型在训练结束后继续学习,同时不遗忘已经掌握的知识?
- 长程推理可靠性:为什么任务一长,推理就变得不那么可靠?该怎么解决?
- 消灭幻觉:模型为什么会编造内容?能不能让它们学会老老实实说「我不知道」?
- 新评测体系:当基准测试成绩趋于饱和,或测试内容混进了训练数据,我们该如何衡量模型是否真的进步了?
- 可解释性与控制:模型内部究竟发生了什么?面对自主性越来越强的模型,该如何确保它们按照人的意图行事?
你看,递归自我改进不仅没有让研究走到终点,反而让上述问题变得前所未有地迫切。如果以后真的由模型来训练模型,就必须有人来决定:它们应该优化什么?我们该怎样衡量?又该如何防止这个自我进化的循环越走越偏?
机器正变得越来越擅长沿着我们已经铺好的高速公路狂飙;但下一条路该通向哪里,方向盘依然死死握在你的手里。
参考资料:
 发表于 3 小时前
|
查看: 6|
回复: 0


