所属层:L3协议层 · 主流协议
《超节点专题》 L3协议层第1篇(共25讲)
核心问题:事实标准的域内互连协议,在规范层面如何定义?
归属域:域内 Scale-up
决定域内互连能力上限的,不只是峰值带宽,还有每次同步要付出的固定开销:事务模型决定这一开销的量级,物理实现决定带宽与时延的可达范围,交换结构决定域规模能扩到多大 [X01]。
一、为什么需要专用的域内互连协议
1.1 从通用 I/O 总线到加速器互连
超节点07讲给出域内带宽的量化目标:任意两颗加速卡之间的互连带宽约为机间互连的8倍 [10]。这一倍数是工程设计取向的表达,用于说明两级互连在带宽配置上的比例关系,不同的带宽口径之间不能直接相除。要达到这个量级,必须先回答一个问题:沿用通用总线,还是另建专用协议?
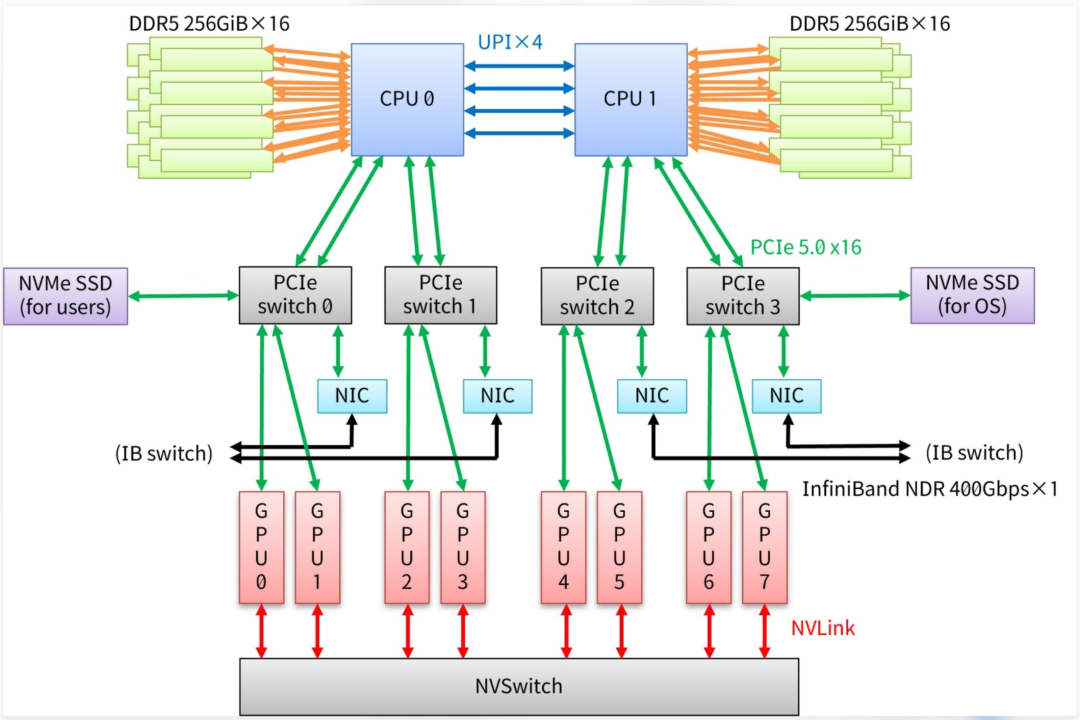
PCIe 是通用的 I/O 总线。规范本身支持端点之间的点对点(P2P)传输,所以问题并不在于 PCIe 不具备加速器间直连能力,而在于它的事务模型、排序规则与拓扑结构是为「主机—外设」的主从访问优化的。用于加速器之间的对等、细粒度、高频次访问时,单位有效数据的开销更高、时延更长 [X01]。
开销来自三个环节。第一是事务层数据包(TLP)的封装与地址转换,一次跨设备访存必须经历 TLP 封装、地址转换与完成包返回。第二是拓扑:GPU 服务器中 PCIe 交换机默认开启的访问控制服务(ACS)会把端点间流量重定向回 Root Complex 做 IOMMU 检查,增加跳数与延迟;关闭 ACS 可以消除这一次转发,代价是放弃 ACS 提供的隔离性。第三是定长封装的影响:PCIe 6.0 引入 PAM4 与 FLIT 定长封装后,同步原语与 doorbell 一类小消息的封装开销占比上升。
带宽量级构成另一重约束:PCIe 5.0 x16 双向带宽约128 GB/s,6.0 x16 约256 GB/s。同期单颗加速卡的 HBM 带宽处于数 TB/s 量级,两者相差一个数量级以上。
PCIe 被排除在加速器互连之外的说法并不成立。它仍然承担 GPU 与网卡、GPU 与存储的连接。真正的差别在于,把张量并行那种高频、小消息的同步压在 PCIe 上时,协议开销与跳数时延会成为主要项,而不是峰值带宽 [X01]。
1.2 张量并行为什么对域内互连特别敏感
张量并行把一层或一组算子沿隐藏维度切分到多颗加速卡上,每次前向与反向都必须同步切分后的中间结果。按超节点04讲的通信量矩阵,这类同步落在关键路径上,无法被计算掩盖,通信时延直接进入单次迭代时间。
这一通信形态有两个特征:频次高,每次前向与反向各发生若干次;单次消息小,单个消息的长度由切分后的激活尺寸决定。两个特征叠加的结果是,对协议开销与时延的敏感度高于对峰值带宽的敏感度——把带宽翻倍带来的收益,可能小于把每次同步的固定开销减半带来的收益。
专家并行与流水线并行的通信形态不同。专家并行的 All-to-All 单次消息更大但频次更低,流水线并行的点对点传输只在阶段边界发生。因此「域内互连要快」这一表述过于笼统,必须分解为带宽、每事务开销与可达域规模三项,分别对应不同的并行策略。
张量并行对域内互连的苛刻之处,在于它要求低固定开销与低时延,而不是单纯的高带宽;这决定了域内协议必须在事务层面向对等访问设计 [X08]。
1.3 NVLink 的设计取向
NVLink 的取向是:把跨卡访存做成内存语义的原生事务——load、store、atomic 与归约类操作。由硬件完成地址翻译与传输,软件侧看到的是一次访存,而不是一次消息收发 [X01]。
这与网络互连的消息语义形成对照。消息语义下,每次搬运必须经通信库组装描述符、提交到网卡、由对端接收并落盘,软件参与度高,单次开销大,但链路与协议可以开放、可跨厂商互通。内存语义下,搬运由处理器发出的访存指令触发,软件只在建立映射时介入,单次开销小。代价是整条通路——GPU、链路、交换芯片与驱动——必须由同一技术栈协同实现,天然形成封闭栈。
NVLink 的设计取向落在事务层:把远端显存访问纳入处理器可直接发起的一类操作,用原生内存语义换取每次同步固定开销的下降。提高链路速率无法降低这一固定开销,这是两者的区别所在;封闭性是这一取向的代价 [X01]。
二、带宽、时延与物理实现的共同约束
2.1 带宽量级:参照系是 HBM,不是机间网络
域内互连带宽的参照系有两项:单颗加速卡的 HBM 带宽,与并行策略产生的通信量。机间网络带宽不构成域内带宽的设计依据,它处在两级互连梯度的另一端(见超节点08讲)。
按2.1节给出的量级,PCIe 5.0 x16 的128 GB/s 与数 TB/s 的 HBM 带宽相差一个数量级以上,PCIe 6.0 x16 的256 GB/s 仍在同一落差区间内。如果域内互连停留在该量级,张量并行切分后的中间结果同步时间会超过计算时间,切分不再带来收益。
域内互连的带宽目标必须向 HBM 带宽靠拢,而不是向机间网络带宽靠拢;这也是域内与域间形成带宽梯度的根本原因。
2.2 时延口径:三类时延不能混用
域内互连承载内存语义访问,端到端时延必须进入纳秒级,否则远端访存会成为流水线停顿点。工程讨论中常见的三类时延必须分开:
- 链路时延:信号经 SerDes 与交换路径的传播与处理时间,不含软件栈开销。
- 通信完成时延:一次集合操作从发起到全部参与方可见的时间,含软件栈与同步开销。
- 远端内存访问时延:处理器发起一次远端 load/store 到数据返回的完整时间。
- 公开数据分属不同口径:NVLink-C2C 的 CPU-GPU 互连时延为纳秒级
[22],经网络的 RDMA 访问通常处于微秒级 [X05]。两者可用于说明量级分界,但口径不同——前者是互连级时延,后者是软件可见的访问级时延——不能直接相减或相除得出倍数关系。
纳秒级与微秒级的对比只能用于说明量级分界。把不同口径的时延数字直接相除得到的倍数,在技术论证中没有意义 [X05]。
2.3 SerDes 速率与封装引脚的双重约束
单链路速率受 SerDes 工艺约束,总带宽等于单链路速率乘以链路数,链路数又受封装可用引脚与芯片面积约束。两个约束同时作用,决定了互连带宽只能沿「提速率」与「增链路」两条路径提升,且两条路径共享同一份引脚预算。
NVLink 物理层的演进遵循一条清晰主线:不断减少每条链路的信号线数量,同时成倍提升单线速率,把节省下来的引脚预算转为链路数。2.0 为8对差分线/链路、单线25 Gbps NRZ,链路数6;3.0 改为4对、单线50 Gbps,链路数由6翻倍至12;4.0 改为2对、单线100 Gbps PAM4,链路数增至18;5.0 沿用2对结构并把 SerDes 速率翻倍至200 Gbps,单链路带宽实现翻倍。
2.4 PAM4 的信噪比代价
NVLink 4.0 起采用 PAM4 调制。PAM4 在一个时钟周期内传输 2 bit,相同波特率下带宽翻倍,代价是电平数由2增至4,眼图张开度下降,对信噪比的要求显著提高。工程上必须由时钟数据恢复(CDR)与自适应均衡配合维持链路裕量,并依赖链路层重传兜底残余误码——调制方式的选择由此向上影响可靠性设计,而不只是物理层参数。
2.5 域规模与介质的耦合
域规模决定互连距离,距离决定介质。GB200 NVL72 以铜缆背板实现机柜内全连接,规模继续上升时铜缆数量与插损均接近工程极限,必须改用 PCB 中板或光互连 [12](介质与距离的权衡见超节点23讲)。协议设计必须能在介质切换时保持事务层与链路层语义不变,否则每次介质换代都要重写软件栈。
物理介质的更换不应改变事务层语义,这是协议分层在工程上的直接收益:铜缆、PCB 中板与光互连可以逐代替换,而上层软件看到的事务集保持不变 [X01]。
三、NVLink 协议栈:从物理链路到内存访问
3.1 协议分层与职责
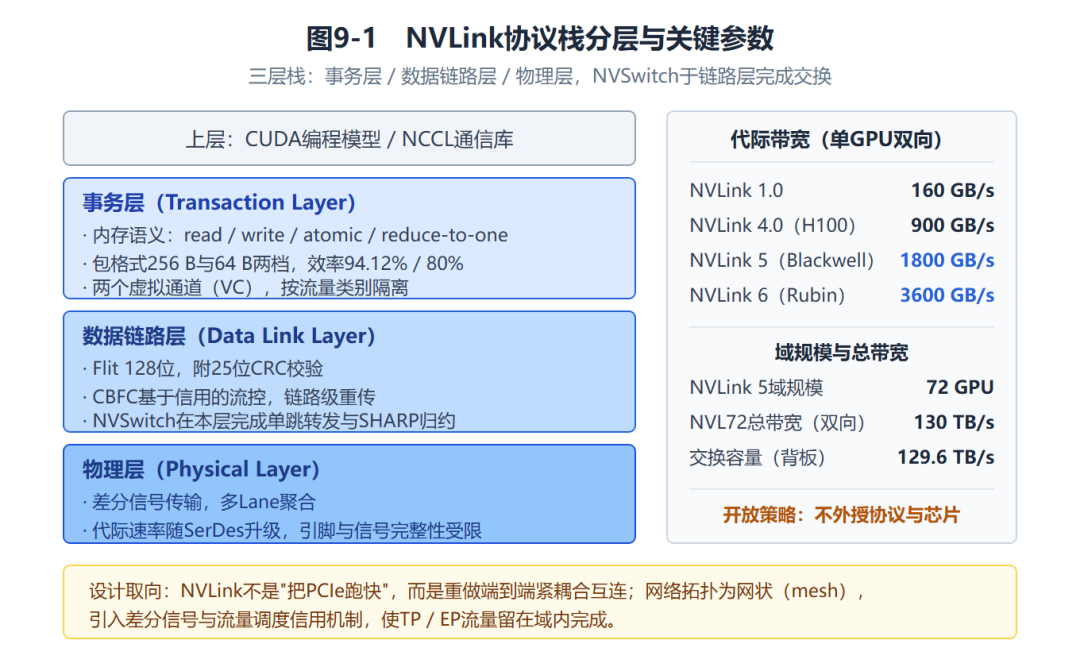
图9-1:NVLink 采用物理层、数据链路层与事务层三层结构,网内归约能力由 NVSwitch 在数据链路层与事务层的交界处承载。
NVLink 采用精简三层栈,自下而上为物理层(PHY)、数据链路层(DL)与事务层(TL) [X01]。三层职责如下:
- 物理层:基于高速 SerDes 的差分信号对传输,支持多速率自适应、通道反转与极性翻转以降低布线复杂度;基础单元为 sub-link(单向差分线组),多条堆叠形成双向 link;编码在1.0与2.0为 NRZ,4.0起为 PAM4;含 CDR 与自适应均衡。
- 数据链路层:负责可靠传输、流控与链路管理,以 flit 为基本传输单元,采用基于信用的双向流控防止缓冲溢出,配合 CRC 检错、重放缓冲与选择性重传实现链路级可靠传输,并以虚拟通道实现不同优先级流量的分级承载。
- 事务层:处理读写请求与响应、原子操作与归约类事务,针对 GPU 通信模式优化,适合小数据包与顺序交付,协议开销小于 PCIe。
需要强调的是,CRC 位宽、flit 位宽、传输字段位宽与虚拟通道数量属于具体代际的实现细节,不同代际并不一致,本篇不将其作为全代际通用规范引用,相关数字统一列入文末「协议细节待核验清单」。
3.2 内存语义与远端访问:三个概念必须分开
NVLink 事务层的原生事务是内存语义操作:load、store、atomic 与归约类操作 [X01]。围绕这些事务,工程讨论中经常混用三个概念,必须严格区分:
统一虚拟寻址(UVA)解决地址可见性问题。 支持 NVLink 的平台上,加速卡显存经 UVA 映射到同一虚拟地址空间,CUDA 驱动完成映射后,上层应用可用同一个指针表达本地与远端地址,实现零拷贝编程 [X06]。
点对点(P2P)访问能力解决通路问题。 指针可达不等于这次访问走 NVLink:能否经直连通路完成跨卡读写,取决于硬件拓扑与驱动是否建立了 P2P 映射。拓扑上无直连的 GPU 对,其访问仍会落到其他通路上。GPUDirect P2P 是建立这类映射的一种实现路径。
硬件缓存一致性解决副本一致性问题。 在 Grace Hopper 一类的超芯片平台上,NVLink-C2C 提供 CPU 与 GPU 之间的硬件缓存一致性,双向带宽900 GB/s(合计1.8 TB/s)、时延纳秒级 [22];在由 NVSwitch 组成的多加速卡域内,访问语义是统一虚拟地址下的远端显存直接访问,一致性维护的范围与强度取决于具体平台实现。
UVA 解决「地址能不能写进同一个指针」,P2P 解决「这次访问走不走直连通路」,硬件缓存一致性解决「多个副本由谁保证一致」。三者分属不同层次,不能由其中一项推出另外两项 [X06]。
由此也得到一条边界:不宜把 NVLink 描述为一条完全开放的远端内存总线。它提供的是在 NVIDIA 受控硬件与驱动栈内成立的内存语义,语义范围与强度由平台实现定义,第三方不能仅凭地址可见性推断一致性行为。
3.3 NVSwitch:从点对点链路到交换网络
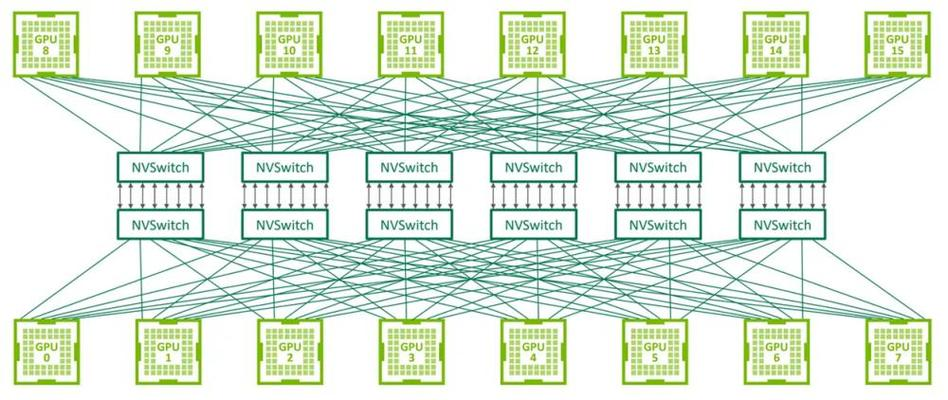
NVSwitch 是专用于 NVLink 网络的交换芯片,采用非阻塞交叉开关(XBAR)架构,配合 NVLink 协议实现加速卡间全连接 [X01]。NVSwitch 端口数随代际演进,公开规格为18、36、64、72(见第四章代际表)。
关于单跳特征,必须限定表述范围:在由单级 NVSwitch 组成的 NVLink 域内,任意两颗加速卡之间的交换路径为一级,路径跳数不随该域内加速卡数量变化;这一结论限定于该特定拓扑,域规模扩大到需要多颗 NVSwitch 级联或多层结构时,跳数与时延仍随结构变化。
还需区分跳数与时延:跳数不变不等于端到端时延为常数。SerDes 时延、交换芯片流水线时延、排队与流控等待都随负载与端口数变化,单跳结构消除的是「时延随跳数累加」这一项,不消除其余各项。
作为对照,PCIe 级联拓扑中端点间通信的时延随交换级数累加,且 GPU 集群中开启 ACS 时端点间流量还要额外经过 Root Complex 一次转发。这是 NVSwitch 单级交换相对 PCIe 树形拓扑的结构性优势,优势来自拓扑,与具体时延数值无关。
3.4 网内归约与集合通信卸载
NVIDIA 在 NVLink 域内提供的网内归约能力,产品术语为 NVLink SHARP(NVLS),由 NVSwitch 与配套软件栈协同实现 [X01]。
NVLS 的工程目标与 InfiniBand SHARP 相近——把归约类集合操作的计算下移到交换侧——但两者的协议载体、实现位置与可编程接口不同。描述 NVLink 域内的网内归约时应使用 NVLS 这一产品术语,不宜直接套用 InfiniBand SHARP 的机制描述 [X01]。
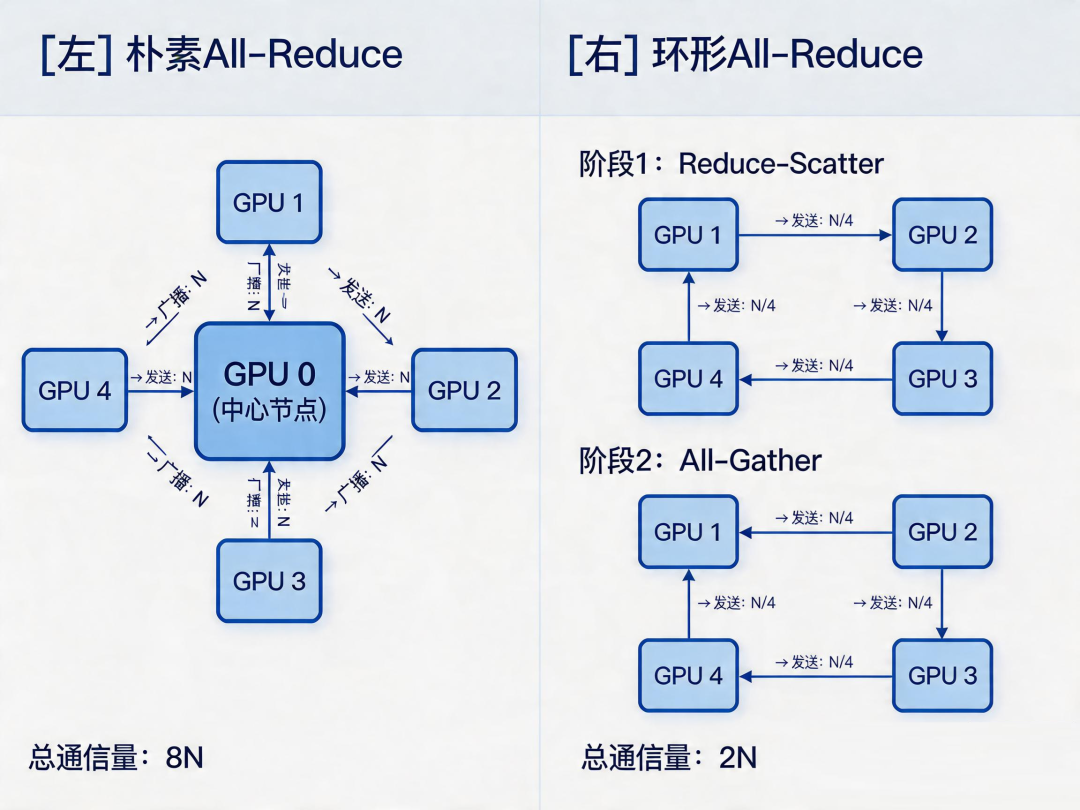
工作方式是:启用后,AllReduce 读取各参与方的部分结果一次,在交换芯片内求和后组播回所有参与者,通信密集阶段各接口需搬运的数据量约减半,集合操作的有效带宽近似翻倍。能力经 NCCL 与 NVSHMEM 向应用层暴露。
覆盖范围有明确限制:NVLS 覆盖归约与组播类集合操作,可卸载的数据类型与算子由硬件算术单元决定,落在支持范围之外的集合操作仍在软件侧完成;收益随消息尺寸与参与规模变化,小消息或参与方较少时收益有限。具体吞吐、可并行管理的组数与各代际支持的数据类型属产品实现细节,列入文末待核验清单。
3.5 可靠性与流控
可靠性由三层机制叠加:数据链路层的 CRC 检错配合重放缓冲与选择性重传,覆盖单条链路上的比特错误;基于信用的流控从机制上避免缓冲溢出丢包,虚拟通道与端到端重传配合实现无阻塞的 QoS 分级;Blackwell 之后的世代再引入控制面冗余与交换托盘热插拔等 RAS 特性 [X01]。
链路级重传、端到端重传与信用流控三者的分工是:链路级重传处理物理层残余误码,端到端重传处理跨交换路径的错误,信用流控让前两者不必面对溢出丢包。
3.6 跨机箱扩展:NVLink Network
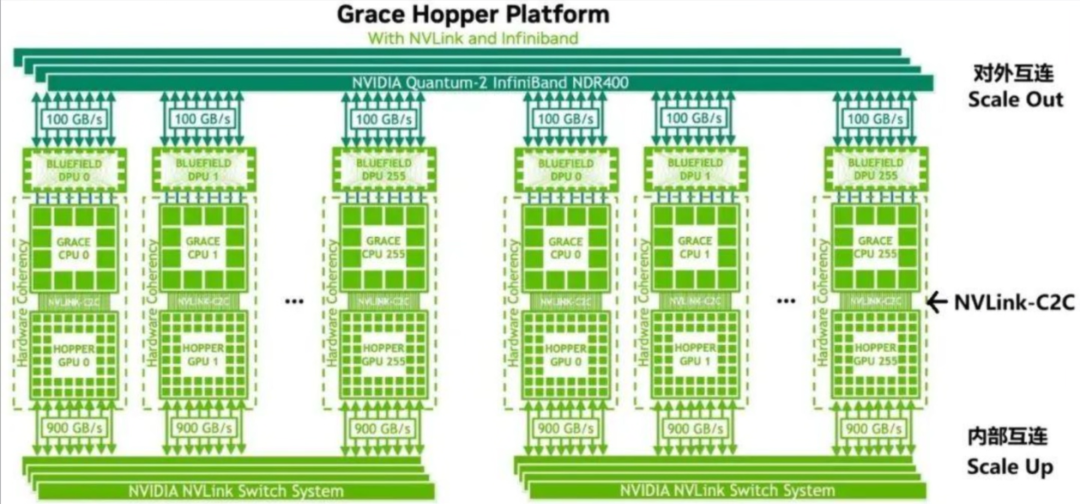
从 NVLink 4.0 起,NVLink Network 把协议从机箱内扩展到跨机箱与跨机柜:为每个端点分配网络地址,支持经外部 NVSwitch 路由;各端点被视为独立地址空间,运行时通过软件 API 建立连接;链路上增加链路级转换缓冲(TLB),由目的端校验并映射入站请求;并提供安全处理器与分区能力,可将端口子集隔离为独立网络 [X01]。
Hopper 世代的 NVLink Network 可将32个节点、256颗 GPU 纳入同一 NVLink 域 [X01];该形态的 NVSwitch 端口在电气上与400G 以太网及 InfiniBand 兼容,支持 OSFP 笼与光布线所需的额外前向纠错模式。需要注意的是,跨机箱形态下的访问语义与机箱内不完全相同——端点被视作独立地址空间,连接由软件显式建立——因此不能把机箱内的内存语义直接外推到跨机箱域。
四、NVLink 代际演进与域规模
4.1 从链路带宽到系统规模
NVLink 从 2016 年的 160 GB/s(4链路)一路走到 2026 年的 3.6 TB/s(36链路),十年翻了 22 倍。
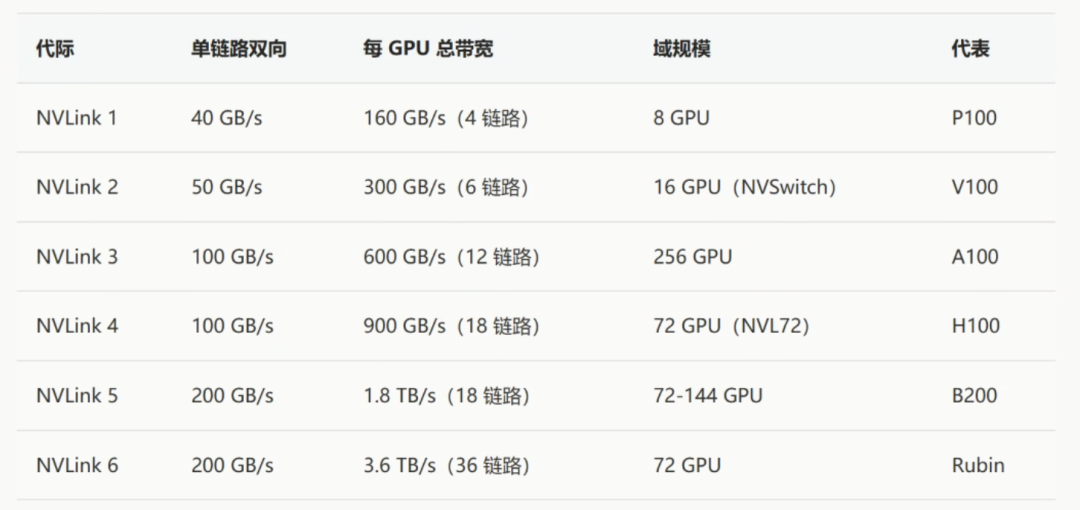
1.0到5.0期间,单 GPU 聚合带宽与最大域规模均实现数量级提升。跃迁由 SerDes 速率与调制方式驱动:3.0到4.0靠 PAM4 把单链路信号线数减半从而翻倍链路数,4.0到5.0靠 SerDes 速率翻倍实现单链路带宽翻倍。
4.2 机柜级超节点的工程意义
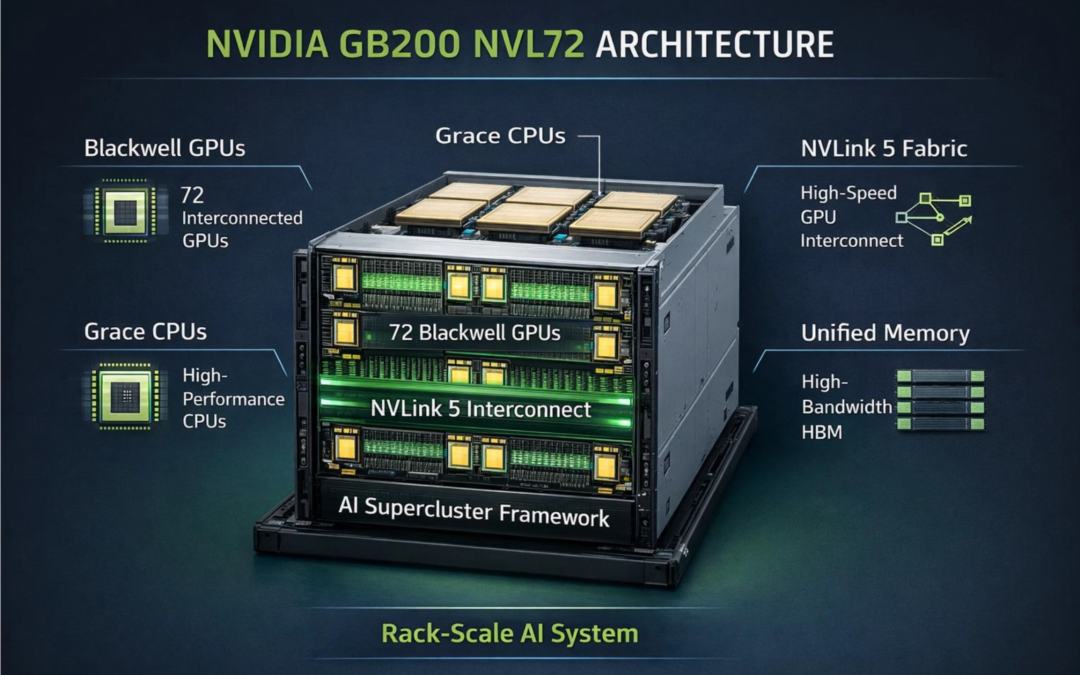
GB200 NVL72 由18个计算托盘与9个交换托盘构成,背板以 NVLink 5 协议与铜缆把72颗 GPU 与18颗 NVSwitch 芯片做满带宽连接,单 GPU 到 GPU 带宽1800 GB/s,机柜总带宽130 TB/s(双向) [12];机柜级交换容量口径为129.6 TB/s,VR200 NVL72 延续该工程结构并翻倍 [12]。
交换托盘的物理配置决定了这一容量:每托盘封装两颗 NVSwitch ASIC,暴露144个 NVLink 端口、每端口100 GB/s,单托盘提供14.4 TB/s 无阻塞交换能力,9个托盘合计构成机柜级全带宽交换。作为对照,Hopper 世代的 Gen3 为64个 NVLink 4 端口、3.2 TB/s 全双工,Blackwell 世代 Gen4 为72个 NVLink 5 端口、7.2 TB/s 全双工。
工程意义在于:机柜成为协议的物理边界——协议参数首次与固定的机械结构、供电与散热能力绑定,域规模不再由协议地址宽度单独决定,而由交换托盘数量、背板介质与机柜功率共同决定。这使得超节点从一个可伸缩的网络概念,变成一个可整体交付、可整体复制的物理单元。
4.3 产品代际与参数可信度分级
协议代际最终落到产品形态。NVIDIA 超节点沿三条代际线索推进,每一代解决一个核心问题 [12]。
第一代 Hopper(GH200 NVL72):通过 NVLink 与 NVLink-C2C 使每颗 GPU 可访问其他所有 CPU 与 GPU 的内存,实现 GPU 与 CPU 内存统一编址 [12]。
第二代 Blackwell(GB200/GB300 NVL72):把域规模稳定在72 GPU/机柜,形成可复制的标准化方案 [12]。这一代确立了机柜级超节点的物理边界,使协议参数与固定的机械结构绑定。
第三代 Rubin(VR200 NVL72):单 GPU 互连带宽较 NVLink 5 翻倍,Scale-out 侧同步升级,总交换容量较上代翻倍 [12]。代价是信号完整性约束向 PCB 材料层级下探(见超节点07讲第2.4节与超节点23讲)。
路线图上,NVIDIA 规划 Vera Rubin NVL144 与 Rubin Ultra NVL576,域内 GPU 数由72颗向576颗发展 [12]。对应的工程变化出现在 Kyber 机架架构——引入 NVLink Switch Blade,以 PCB 中板替代传统5000余根有源铜缆 [12]。576卡单机柜形态已逼近柜内铜互连的物理上限,继续放大必须依赖更高速率的封装内光互连,或转向分机柜级联拓扑。
效能侧,NVIDIA 官方披露 Rubin 平台训练性能为 Blackwell 的3.5倍,AI 软件运行性能提升5倍,训练 MoE 模型所需 GPU 数量降至前代的1/4 [22]。这三项为厂商自测口径,未披露统一的基准负载与对比配置。
涉及 NVLink 6 与 Rubin 的参数必须分三档引用:已发布产品规格、官方路线图、厂商自测效能。三者的可核查程度不同,混用会把预测值写成事实,也会把自测值写成可比指标 [12][22]。
4.4 NVLink Fusion:开放生态的边界
NVLink Fusion 提供的是授权接入,而不是规范开放——接入方获得的是在 NVIDIA 定义的实现范围内互联的资格,不是独立实现兼容协议栈的权利。这与 UALink(超节点12讲)与 ETH-X/ESUN(超节点13讲)的开放路径性质不同:后者走标准化组织或多厂商联盟,规范文本公开,任何成员可独立实现;前者是单厂商授权,实现范围与节奏由授权方决定。
五、NVLink 的能力边界与工程代价
第一,开放程度受限。 NVLink 是专有协议,规范不由标准化组织维护,第三方无法独立实现兼容部件。NVLink Fusion 提供的是授权接入而非规范开放,接入方受授权范围与 NVIDIA 产品节奏约束。对需要多厂商器件组网的部署方,这一点直接进入选型决策。
第二,域规模受交换芯片端口数与 SerDes 引脚限制。 单级全交换的代价是端口数与交换托盘数量随域规模线性增长,576 GPU 域必须由多颗 NVSwitch 或多层结构承载,物料与功耗随之上升 [24]。单颗加速卡可引出的链路数受封装约束,同样数量的 SerDes 用于提高单卡带宽还是扩展链路数,构成聚合带宽与域规模之间的直接竞争。
第三,铜缆距离构成物理天花板。 GB200 NVL72 以铜缆背板实现机柜内全连接,这一方案在72卡规模下成立。扩展至576卡时铜缆数量与插损均不可接受,必须以 PCB 中板替代 [12]。协议层虽与介质解耦,物理层的速率-距离权衡无法回避(见超节点23讲)。
第四,一致性能力依平台而异。 硬件缓存一致性在 NVLink-C2C 连接的 CPU-GPU 超芯片平台上成立;NVSwitch 组成的多加速卡域提供的是统一虚拟地址下的远端直接访问,一致性维护范围与强度必须按平台确认 [X06]。把超芯片平台的语义外推到整个 NVLink 域,是工程中常见的口径错误。
第五,网内计算的覆盖范围有限。 NVLS 覆盖归约与组播类集合操作,可卸载的数据类型与算子由硬件算术单元决定,落在支持范围之外的集合操作仍在软件侧完成。收益随消息尺寸与参与规模变化,小消息或参与方较少时收益有限。把网内归约当作通用加速手段而非特定集合操作的卸载,会高估其收益范围。
第六,生态锁定与供应链集中。 专用物理层意味着线缆、连接器与光模块均必须采用专用供应链,无法复用数据中心既有的以太网基础设施,采购与备件成本高于开放标准方案。同时,协议演进节奏由单一厂商决定,部署方的升级窗口必须与该厂商的产品周期对齐。
六、软件栈如何把互连能力转化为应用性能
6.1 NCCL:按拓扑与可用传输选路
协议能力必须经通信库调度才能转化为应用性能。NCCL 是覆盖 Scale-up 与 Scale-out 的集合通信库,具备拓扑感知能力,初始化时探测可用链路类型与带宽,据此在 Ring、Tree 等算法与具体传输通路之间做选择,可接近 GPU 到 GPU 的理论带宽,已集成进主流深度学习框架 [X01][X08]。
NCCL 的选路是输入(拓扑、带宽、消息尺寸)到算法与通路的动态求解结果,不是一条「有 NVLink 就走 NVLink」的固定规则。把它写成固定规则,会掩盖拓扑探测与算法选择这两个真正决定性能的环节 [X08]。
6.2 NVSHMEM:把内存语义直接交给应用
NVSHMEM 以分区全局地址空间(PGAS)风格暴露显存访问接口,允许一颗 GPU 直接读写另一颗 GPU 的对称堆内存。在 NVLink 域内,这类单边访问由硬件内存语义承载 [X01]。
与 NCCL 的差别在于粒度:NCCL 以集合操作为单位调度通信,一次调用覆盖一组参与方;NVSHMEM 以单边访存为单位暴露能力,通信由程序显式发起。后者更灵活,代价是同步责任转移到程序——数据可见性必须由程序按 API 约定的同步与屏障语义保证,而不是由集合操作的完成语义保证。
6.3 NIXL:推理数据平面的传输抽象层
NIXL(NVIDIA Inference Xfer Library)是面向推理场景的数据传输抽象层,为 KV Cache 迁移、权重加载与存储读写提供统一的传输接口,后端可覆盖 NVLink、PCIe、RDMA 与存储设备 [X01]。
它的定位是抽象层,不是指令生成器。NIXL 按内存类型与可用后端选择传输方式,向上暴露的是异步传输描述符与内存句柄;具体是否落到 NVLink 通路,由后端实现与注册内存类型决定。因此不能写成「NIXL 识别 NVLink 拓扑后优先以 load/store 指令完成域内传输」——该表述越过抽象层直接描述指令行为,把接口选择等同于指令选择。
价值体现在部署形态上:在上下文处理与解码分离的部署中,KV Cache 必须在实例间迁移。NIXL 把多种介质与多种后端统一到一套接口下,推理框架不必为每种链路各写一套搬运逻辑,也不必在链路换代时重写数据平面。
6.4 与 PCIe 的分工
域内协议与 PCIe 承担不同职责:NVLink 承担加速卡间的 Scale-up 通信,PCIe 及其交换结构承担 CPU 与 GPU、GPU 与网卡、GPU 与存储的连接以及 Scale-out 路径。GPUDirect P2P 以 NVLink 为物理载体完成多卡显存的统一虚拟寻址映射。两套协议在同一系统内并存,各自覆盖不同的通信距离与访问模式。
七、结束语
本篇的对照基准是:域内协议按内存语义设计,以精简三层栈、单级交换、硬件流控与网内归约为特征,带宽与域规模随 SerDes 代际与交换芯片能力跃升。对应的代价是协议封闭、域规模受端口数与介质距离约束、一致性能力依平台而异。
理解这一基准之后,才能看清后续协议的设计取舍。事实标准的 NVLink 协议栈之后,统一总线语义如何以一套协议覆盖片上、板内、机柜内与跨机柜多个层级,并复用以太网供应链——下一讲看灵衢 UB 协议。
在 云栈社区 的技术讨论中,NVLink 与 NVSwitch 作为域内 Scale-up 的基础设施,一直是高性能计算与 AI 训练领域的热点话题。关于 NVLink:
 发表于 6 小时前
|
查看: 6|
回复: 0


