今天这篇文章,我们以美国 Meta 公司 Prometheus(普罗米修斯)数据中心为例,来聊聊这个数据中心中 100 万块 GPU 是怎么工作的。
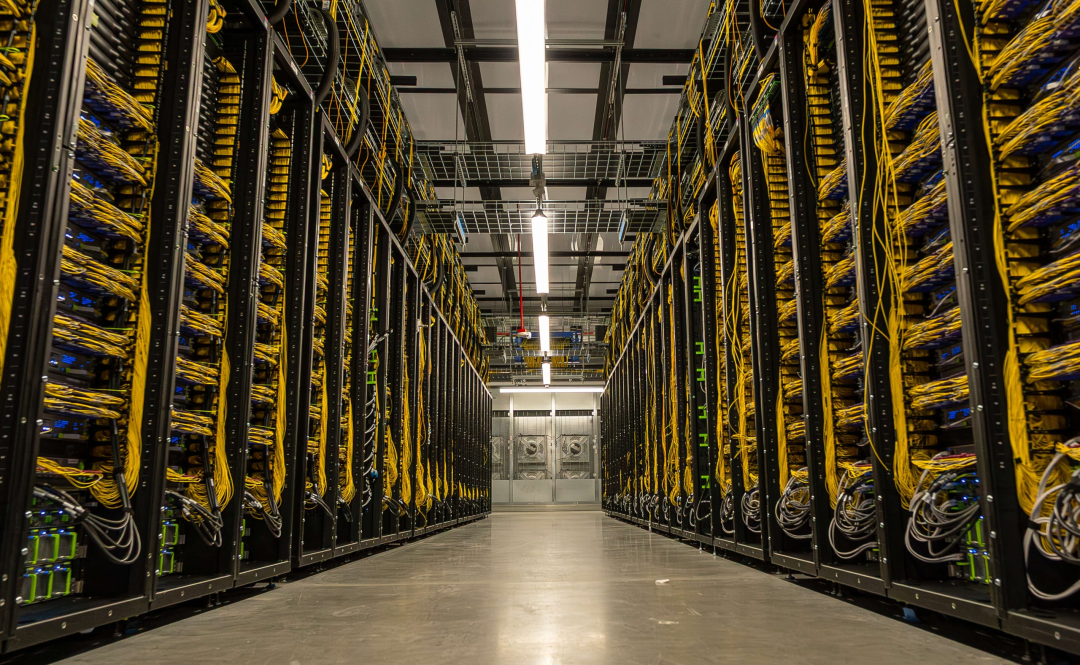
一、持续工作是 AI 超级集群的核心挑战
首先,我们来了解下 Meta Prometheus 集群。
Prometheus 是 Meta 在俄亥俄州纽奥尔巴尼(New Albany)建设的吉瓦(GW)级 AI 超算集群。
目前,该集群的第一阶段已完工,并已用于训练 Muse 系列基础模型(包括 Muse Wonder 模型)。Meta 表示,该站点正朝着约 100 万块 GPU 的规模扩展。
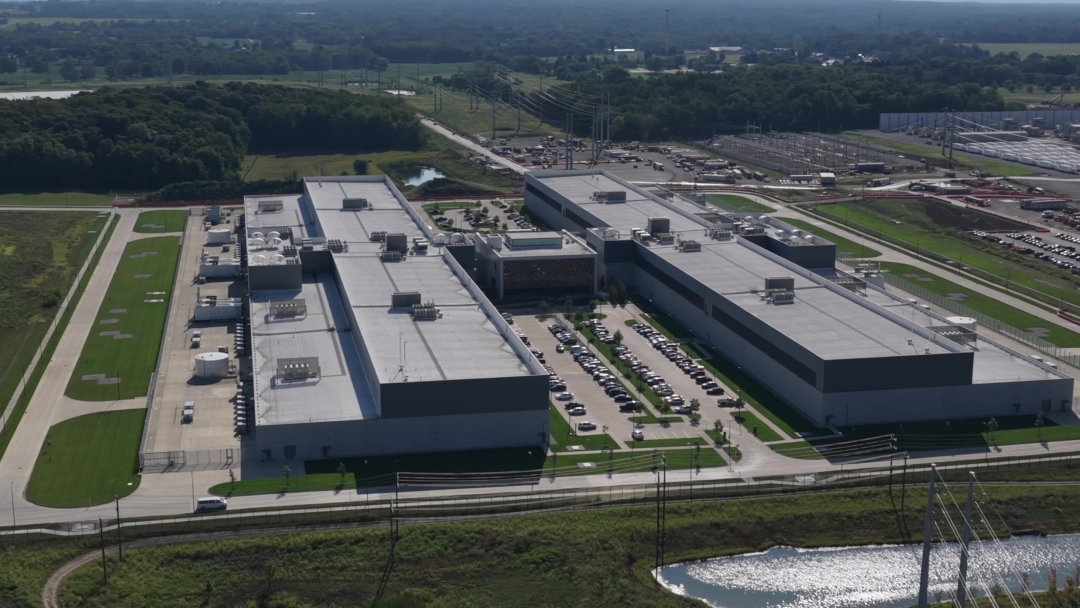
想象一下,100 万块 GPU 同时工作,这个复杂程度可想而知。
就像你雇了 100 万个工人同时做一道数学题,要求他们每秒钟都要同步交换计算结果。但只要其中一个人打瞌睡、算错数,或者传纸条时手抖了一下,整个项目就得推倒重来。
这是 Prometheus 超算集群每天都在面对的挑战。
因此,在这里,硬件堆砌只是最基础的部分——真正的技术难关,在于如何让这 100 万块“娇气”的芯片 24 小时不间断地协同工作。
二、为了算力,需要把 72 块 GPU 装进一个“超级大脑”
传统服务器像是一个个独立的小房间,每间房住 8 块 GPU,彼此用网线连接。但现代 AI 模型太大,8 块 GPU 根本不够用,数据传输的“网线”反而成了瓶颈。
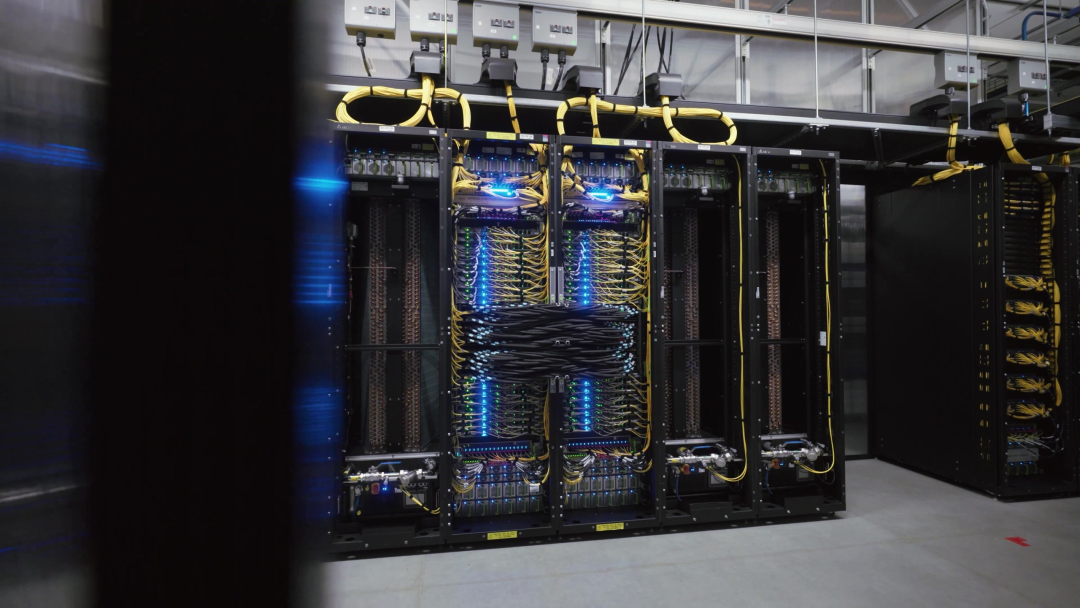
最新的解决方案叫做 NVL72 架构,相当于把 72 块 GPU 装进一个“超级大脑”。这些 GPU 不再通过外部网线,而是通过一种叫做 NVLink 的“高速神经束”直接相连,带宽达到 130TB/s——相当于每秒能传完 3 万部高清电影。在这个架构里,72 块 GPU 就像一块巨大的芯片一样协同工作。
目前 Meta 这个集群里正跑着两代“超级大脑”:
第一代叫 Catalina,使用 GB200 芯片,每块 GPU 配备 192GB 高速显存(HBM3e),两个机架组成一组,功耗高达 120 千瓦(相当于 120 台家用空调同时制热)。每块 GPU 还搭配了一颗 Grace CPU 和两块 ConnectX-7 400G 网卡,确保数据进出顺畅。
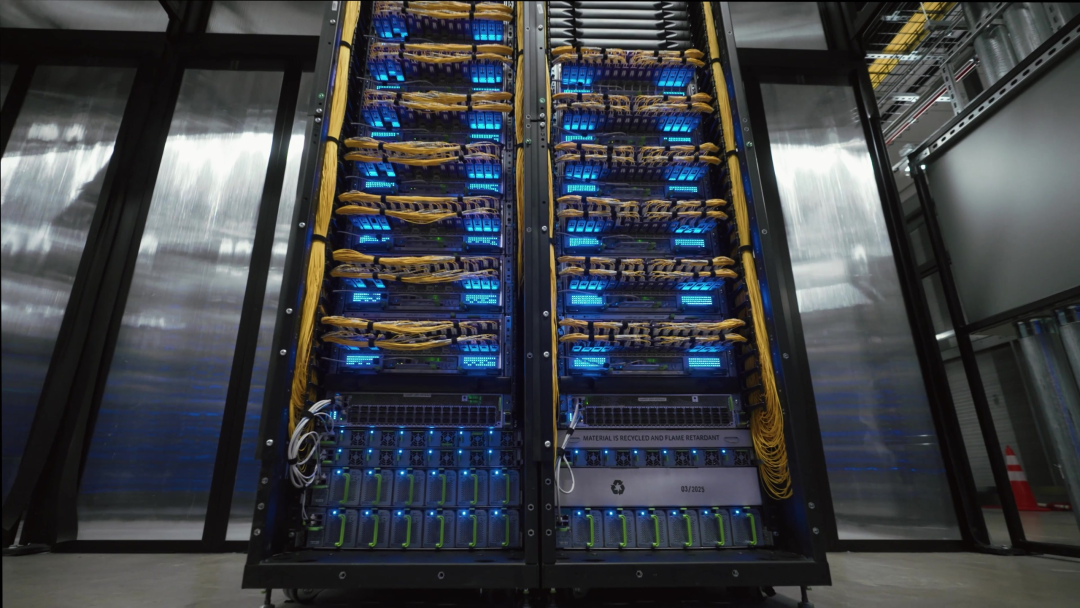
第二代叫 Clemente,升级到 GB300 芯片,显存增至 288GB,性能提升 10%,而且 72 块 GPU 能塞进一个机架。它采用了更新的 ConnectX-8 SuperNIC 网卡,原生支持 800G 高速网络。
明年还将接入第三代 San Miguel,使用更新的 Vera Rubin 芯片,单架功耗将突破 170 千瓦,显存带宽和计算能力将再翻一倍。
但把这么多芯片绑在一起也有副作用:一旦其中一块坏了,影响的不是 8 块,而是整个 72 块的“超级大脑”。这就像把鸡蛋放在同一个篮子里,篮子越大,摔一次的损失越惨重。
三、为了稳定,每 72 块 GPU,只让 64 块干活
面对这个难题,工程师想出了一个反直觉的策略:故意让 8 块 GPU“偷懒”。
在每个 72 块的“超级大脑”里,实际上只有 64 块 GPU 承担计算任务,剩下 8 块作为“替补队员”随时待命。一旦某块 GPU 出现故障,替补立即顶上,训练任务从最近的“存档点”继续,而不需要停机维修。
这种设计叫做“64/72 切片策略”,虽然看起来浪费了 11% 的算力,但实际上大幅减少了停机时间。
对于整个机架都损坏的极端情况,Meta 还额外准备了 2% 的备用机架。如果要启动一个需要 32768 块 GPU 的训练任务,实际上要占用 523 个机架(共 37656 块 GPU),多出来的 13% 就是用来“兜底”的。
四、不仅如此,还要给 100 万块 GPU 做“心电图”
即使有了替补机制,故障依然会发生。
最棘手的是信号问题:一个 NVL72“超级大脑”内部有 5184 条高速信号线,每条线以 200Gbps 的速度传输数据。哪怕只有一条线接触不良,整个系统就会频繁“卡壳”。
为了解决这个问题,工程师给集群装上了“心电图监测仪”——持续收集每一条链路的信号质量数据。
一旦发现某条链路“心律不齐”(信号衰减),就在它彻底罢工前主动更换。芯片的固件(内置软件)也可以像手机系统更新一样,在几小时内推送到 10 万块 GPU 上,快速修复已知的 bug。
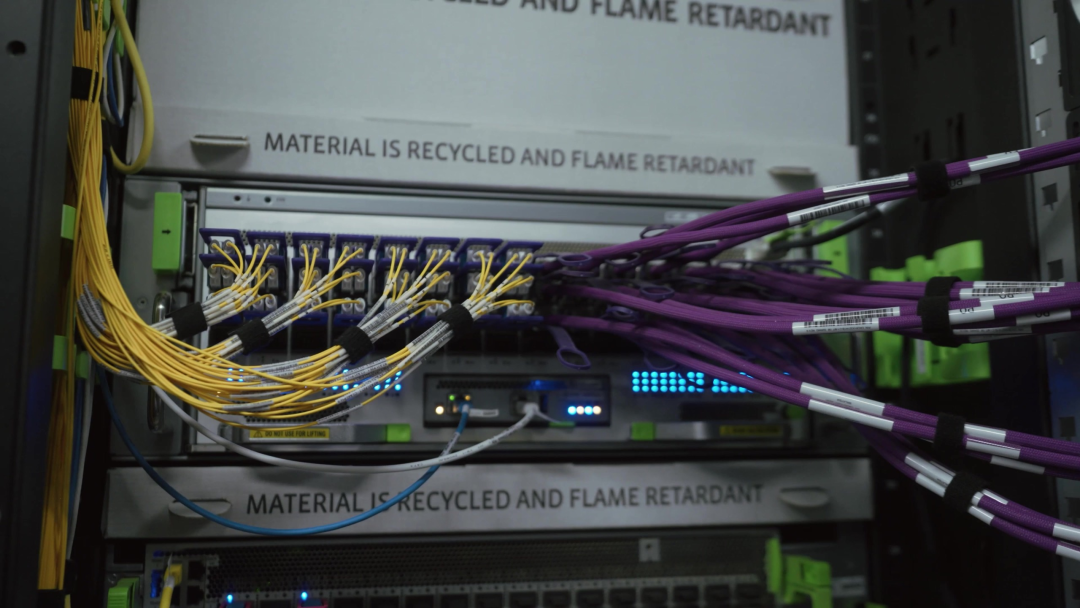
这些措施的效果惊人:2025 年中期,这个集群每天每 8000 块 GPU 要发生近 1000 次故障;一年后,故障率下降了 99%。现在,平均每 10 万个 GPU 小时才会发生一次中断,训练效率从 85% 提升到了 90% 以上。
五、跨越楼房的“信息高速公路”
100 万块 GPU 不可能装在同一个房间里,它们分布在多栋建筑中。这就带来了另一个物理难题:光纤速度是有限的。信号在光纤中传输,每公里需要 5 微秒,对于需要频繁同步的 AI 训练来说,这个延迟不可忽视。
Meta 的解决方案是“分层交通系统”:
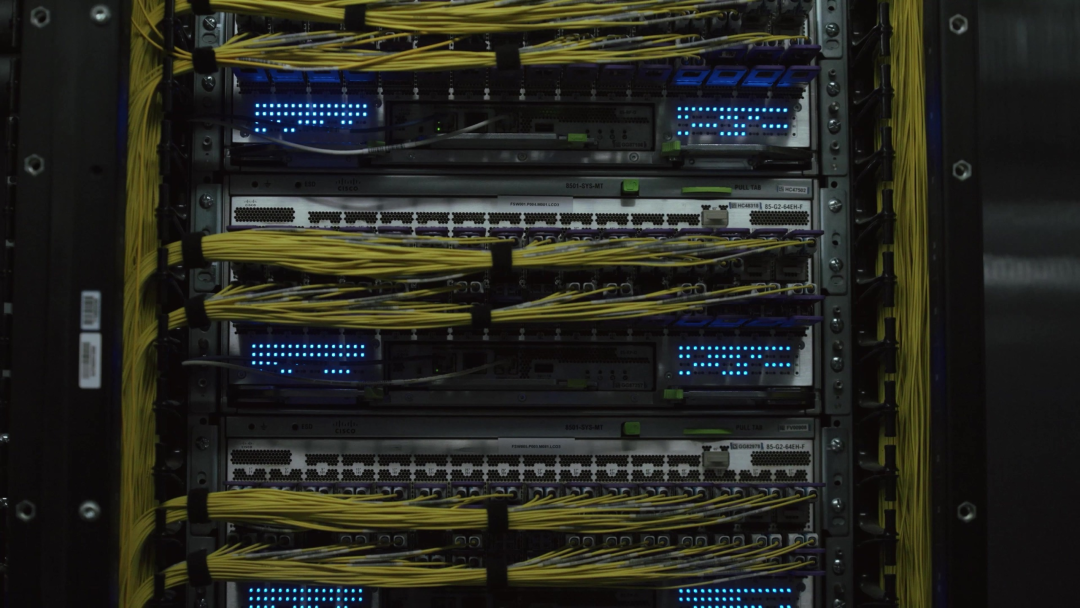
楼内高速:每栋建筑容纳约 2 万块 GPU,内部使用短距离光纤,保证延迟极低,处理需要频繁同步的计算任务。
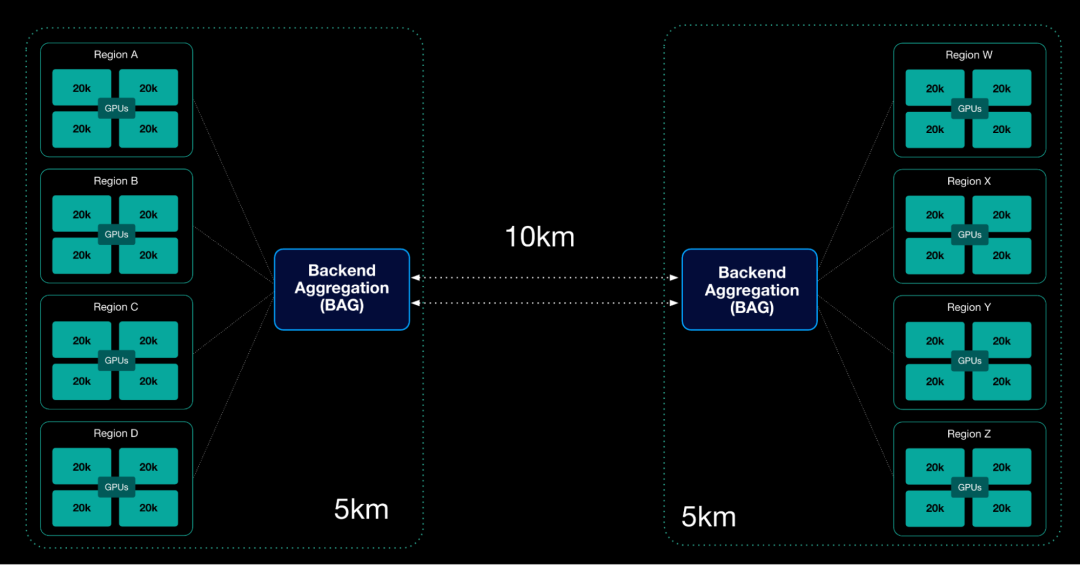
城际干线:楼与楼之间通过专用“Backend Aggregation”网络连接,使用 800G-ZR 相干光模块,跨越 2 公里到 100 公里的距离,传输对延迟不敏感的数据。
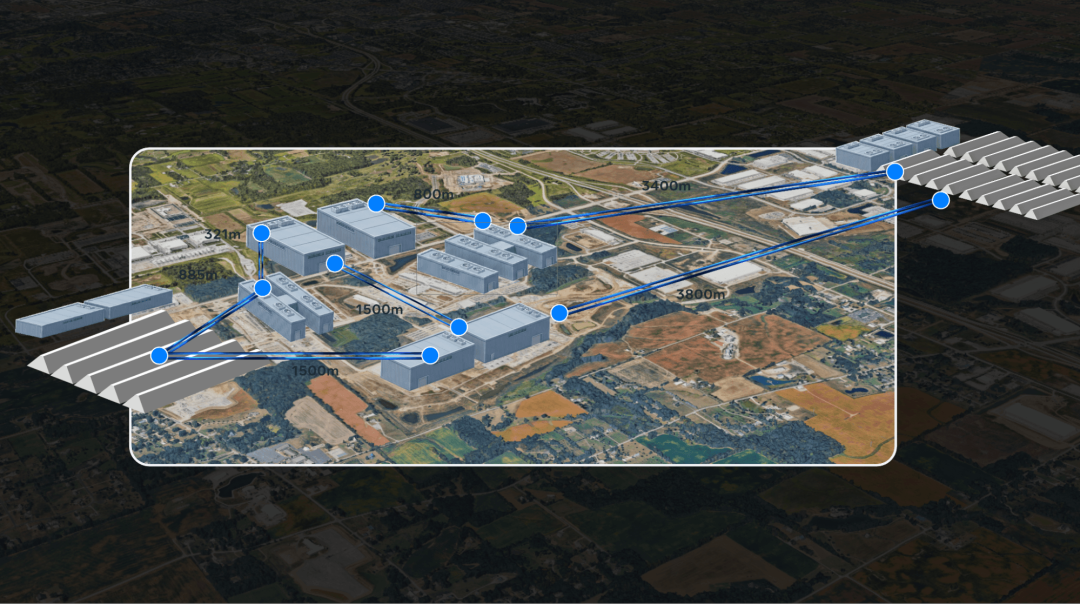
这就像城市规划:市区内修地铁(高速低延迟),城市间修高铁(大容量但稍慢)。整个园区铺设了数百万英里的光纤,使用了数万台交换机和数百万个光模块。
六、驯服“电力巨兽”
最危险的时刻,往往发生在“开始”和“停止”的瞬间。
当数万块 GPU 同时从休眠状态切换到全速计算状态时,功耗会在几秒内飙升 30%-40%,相当于瞬间多出几十兆瓦的电力需求——足以让电网过载跳闸。
为了平滑这种波动,Meta 开发了一套叫做 Dynamo Dimmer 的“电力油门”系统。
当集群接近供电上限时,系统会自动降低 GPU 的功率,就像开车时松开油门一样。同时,每个机架都配备了电池组,像“电力海绵”一样吸收瞬间的功率尖峰;整个园区还有大规模的储能电站作为后盾。
散热也是个大问题。
老建筑使用“风冷+液冷”混合模式,新建筑则采用全液冷——把服务器直接泡在冷却液里。Meta 甚至开源了他们的液冷机架设计,供整个行业参考。
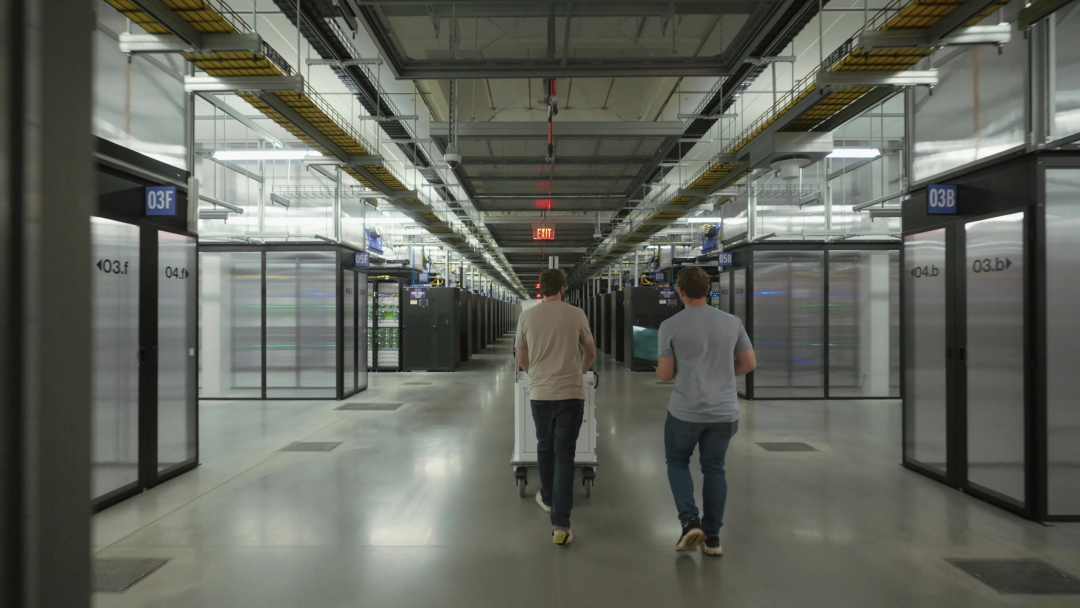
七、下一代:从零开始设计“完美集群”
Prometheus 的成功经验,正在被应用到 Meta 的下一代集群 Hyperion 中。
这个项目位于路易斯安那州里奇兰教区(Richland Parish),将从零开始设计,采用全液冷散热、与电网深度耦合,并针对百万卡规模优化网络架构。
从 Prometheus 的实践可以看出,未来的 AI 竞争不只是芯片数量的比拼,更是系统工程能力的较量。当 GPU 数量达到百万级,真正的技术壁垒在于:如何设计一个能自我诊断、自我修复、且不会把电网拖垮的庞大系统。
这 100 万块 GPU 背后,藏着的是一整套精密的工程哲学——不是如何让机器跑得更快,而是如何让它永不停歇。
 发表于 6 天前
|
查看: 43|
回复: 0
 /1


