如果说 GPU 是 AI 集群的心脏,那 PCIe Switch 就是服务器机箱里的交通路口。CPU、GPU、网卡、SSD 的每一次数据交换都要从它这里过闸。过去它不过是服务器里的沉默配角,直到大模型把单卡算力喂到极限、集群规模一路膨胀,这个常年被单一厂商垄断的细分芯片,才以“卡脖子”的姿态站到了聚光灯下。
PCIe Switch 到底是什么?
要理解 PCIe Switch,得先弄清楚 PCIe 本身。PCIe(高速外围互连)是一套串行点对点、全双工的计算机总线协议,负责把 CPU 这个“大脑”和所有外设连起来。问题在于,CPU 的根端口通道数量是有限的,而一台服务器要挂载的 GPU、网卡、SSD 往往远超这个数字。通道不够用了怎么办?PCIe Switch 就是为解决这件事而生的。
它相当于总闸前面的分配器,核心干三件事:一是扩展(Fan-out),把 CPU 有限的 x16/x8 上行通道扩展成几十甚至上百条下行通道,去挂载更多终端设备;二是点对点直连(P2P),让 GPU 之间的数据交换可以直接走 Switch,不必绕道 CPU,大幅压低延迟;三是多主机(Multi-Host)与 NTB(非透明桥),把一个 I/O 资源动态分配给多个主机,实现设备共享。
放在 AI 服务器里,它往往以星形拓扑出现:CPU 接上行口,GPU、网卡、SSD 挂在下行口。面向 AI 的高规格产品以 104 通道、144 通道为主,典型代表是博通的 PEX89104 与 PEX89144。与之相对的是直连方案——CPU 直接拉线到 GPU,省去 Switch,成本最低。2024 年至 2025 年,不少 8 卡服务器就采用了这种设计。
AI 浪潮里,它从“配角”变成了“咽喉”
AI 大模型时代彻底改写了 PCIe Switch 的身位。主流 8 卡训练服务器里,几乎所有的训练数据、模型参数、网卡通信请求,都必须经过 PCIe Switch 完成数据交换。没有旁路,没有备选路径——这就是产业界反复强调的“咽喉效应”。
国内 PCIe Switch 市场以算力场景为核心,AI 服务器是最主要的应用市场,高通道 Gen5 芯片基本都落在这个赛道。企业全闪存存储是第二大应用场景,其余通用服务器、HPC 高性能计算等领域整体占比较小。
根据赛迪顾问数据,2025 年中国 PCIe Switch 市场规模约 45.3 亿元,其中 AI 服务器场景占 76.7%,是市场增长的重要驱动力。预计 2025 年到 2028 年,国内 PCIe Switch 市场规模的年复合增长率约 29.3%。驱动逻辑也很直白:除了 AI 服务器市场的系统性增长外,过往训练或推理阶段 CPU 与 GPU 配比约 1:4,推理阶段正向 1:1 乃至更高演进。服务器内部互联节点数量大幅增加,PCIe Switch 的刚性需求被成倍拉动。
产业生态:博通独大,掉队者与闯入者
中国 PCIe Switch 市场正经历从“外资绝对垄断”向“国产加速替代”的格局重构。2025 年,国内市场呈现“一超多强、梯队分化”的竞争态势。以 AI 服务器应用场景为例,博通以 85% 的份额居中国市场榜首;众星微、数渡等中国厂商紧随其后。
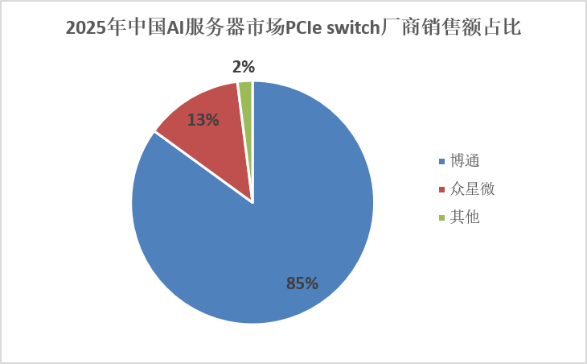
博通是全球绝对霸主。在国内 PCIe 5.0 Switch 细分市场,其市场份额达到 89%,在国产芯片出现前甚至接近 100% 垄断。目前博通的技术护城河在于 112G SerDes 的 Gen6 能力和完整的产品线,以及与全球头部云服务商的生态关系。
全球市场份额第二名是 Microchip。它在 PCIe 4.0 时代曾占优势,但在 5.0 这一代基本掉队,AI 服务器市场几乎没有份额。
真正的新变量来自 PCIe 6.0:Astera Labs(PCIe Retimer 龙头)已于 2024 年 10 月发布 Scorpio Smart Fabric Switch 系列,宣称是业内首款 PCIe 6.0 交换芯片;Microchip 也于 2025 年 10 月发布了 PCIe 6.0 Switch,产品系列名为 Switchtec™ Gen6,最高支持 160 Lane;Marvell 通过收购一家 CXL 厂商卡位,2026 年 3 月在 OFC 发布 Structera™ S 60260,260 Lane PCIe 6.0 Switch。
国产梯队:量产已破零,正在抢窗口。 国产替代从 2025 年开始实质推进,进度分化明显:
- 众星微作为光合组织核心成员,专注于服务器高速互连技术研发。其 PCIe Gen5 Switch 芯片已在国产 AI 服务器训练场景下实现规模出货,国内首个十万卡集群的应用是其代表案例之一。值得一提,10 月 15 日众星微发布了国内首款 PCIe 6.0 144 Lane Switch,依托原生 Fabric 支撑 XPU 高速互连,CXL3.1 提供内存池化能力。
- 数渡科技已被万通发展收购。其 PCIe5.0 Switch SD85 系列已发布,包含 48/104/144 通道版本,104 通道的 SD85104 于 2025Q4 量产。
- 芯动科技已推出 104/120 通道的 PCIe Gen5 Switch 芯片 GX9104/GX9120。
- 青芯半导体的 PCIe Gen5 Switch WL-G5144 于 2026 年 4 月正式发布,144 通道。
从工艺代差层面能直观看到差距:国内厂商当前制程水平整体落后海外头部厂商,面向下一代产品,双方依旧会维持一代左右的工艺差距。在核心 IP 层面,高速 SerDes 与 PCIe 控制器的成熟商用方案仍以海外厂商为主,国内相关 IP 企业虽已实现布局,但产品成熟度仍有待提升。
PCIe 开放生态 vs 各大厂私有生态
PCIe 依然是所有算力系统的通用地基,只是它的角色正在被更清晰地定义。
在今天的 AI 服务器里,PCIe 承担的职责高度一致:设备枚举、控制面交互、外设接入。GPU、NPU、网卡、SSD 上电后被谁发现、地址空间如何分配、CPU 如何下发指令,这套流程仍由 Root Complex—Switch—Endpoint 的树形拓扑完成。它是开放生态的最大公约数。
而在决定算力上限的那条链路上,私有协议确实已经接手。
英伟达是典型样本:GPU 之间的高带宽 Scale-up 由 NVLink + NVSwitch 承担,CPU 与 GPU 的紧耦合封装则依赖 NVLink-C2C。
国产厂商也陆续交出了各自的答卷。
华为昇腾遵循同样的分层逻辑。CPU 与 NPU 的设备枚举、控制交互及外设接入依托 PCIe,多卡机型还会搭配 PCIe Switch 扩展通道。但柜内 AI ASIC 芯片之间的大规模算力数据传输走自研 HCCS(新一代升级为灵衢互联)私有链路,卡间高带宽 Scale-up 流量不跑在 PCIe 上。
海光信息的 HSL(Hygon System Link)着力点不在替代某一条链路,而在把 GPU-to-GPU、CPU-to-GPU、CPU-to-CPU、GPU-to-NIC、GPU-to-SSD 全部收敛到同一协议体系下,配套 HySwitch 交换芯片,是一条以 CPU 为中心、半开放的国产总线路线。
摩尔线程的 MTLink 走专有 Scale-up 协议,从 S4000 的 240 GB/s 演进到第二代支持的单机 8 卡全互联,并以 MTLink Bridge 兼容标准 PCIe 服务器。
沐曦的 MetaXLink 在单芯片集成 7 个互连接口,支持 2-128 卡的 Full-Mesh、Hybrid Cube Mesh 等拓扑,突破 PCIe 在带宽与延迟上的限制。
壁仞科技的 BLink 单组 ×8 链路双向带宽 64GB/s,最高 8 卡全互联。其 BLink 2.0 进一步引入内存语义互连与在网计算,并用 NPO 光互连、分布式解耦架构把超节点扩展到 1024 卡。
由此可以观察到一条清晰趋势:柜内 xPU 高速互联正越来越多地采用自研私有路线,不再单纯依赖 PCIe 承载卡间高带宽算力流量。
但把这一现象理解为“开放生态退潮”并不准确。更贴切的说法是分工线在重新划定:PCIe 管“接入与可管理”,私有协议管“性能与规模”。两者不是替代关系,而是叠层关系。任何一台 AI 服务器,PCIe 树依然完整存在,只是高带宽数据找到了更短的旁路。
值得指出的是,开放一侧也并未停步:PCIe 向 Gen6/Gen7 持续提速;PCIe Switch 因 AI 服务器的扇出与池化需求而市场快速扩容;CXL 在 PCIe 物理层之上构建内存池化;UALink 则以开放标准正面切入 Scale-up 层。
对国产算力而言,真正的考题不在选哪条路,而在于:走私有路线的,能否同时把带宽、时延和软件栈一起做出来;走开放路线的,能否在生态协同中兑现规模。
供需撕裂:缺货、涨价与替代窗口
PCIe 与各类私有互联协议并行演进,二者并非此消彼长。相反,AI 算力建设的爆发催生海量硬件需求,进一步放大了底层互连芯片的供给缺口,PCIe Switch 的供需矛盾也随之凸显。
博通主力型号 PEX89104、PEX89144 长期处于供货紧张状态。其中 PEX89104 凭借均衡的通道规格与成本优势,是单机 8 卡 AI 服务器方案的首选。采用两颗芯片即可满足绝大多数整机的互联需求,也是市场需求量最大的单品。
博通该系列产品常规标准交付周期约 52 周,2026 年供应链紧张加剧阶段,部分订单交付周期甚至拉长至一年以上。供需失衡之下,现货市场价格持续上行,自 2026 年起 PEX89104 现货涨幅至少达到 50%。
芯片缺货与国产化进程呈现相互咬合的联动关系。一方面,GPU 算力卡、以太网交换芯片、PCIe Switch 等数据中心核心互连芯片同步紧缺,下游服务器厂商出于供应链安全考量普遍加大备货、超额锁单,进一步放大供需缺口。另一方面,海外芯片供应的不确定性,也成为国产 PCIe Switch 实现替代的重要催化剂。当前 OEM 与 ODM 厂商大多采用双路线备货策略,同步储备“博通方案+国产方案”两套技术选型。一旦海外供应链出现波动,或是产业政策对国产算力硬件形成倾斜,国产芯片的市场份额将从低基数起步稳步提升。
以国内 AI 服务器存量与新增规模测算:若国内 AI 服务器总量约 50 万台,单机平均使用 2 颗芯片,再加上未来推理需求带来 CPU 与 GPU 比例提升对 PCIe Switch 的增量需求,对应的年需求总量即可突破 100 万颗。国产替代的市场空间清晰可观。
结语
算力竞争不止于 AI 芯片,服务器内部的互连通信同样决定集群上限。PCIe 与私有互联协议各司其职、叠加共存,共同支撑大模型时代海量的数据交互。
PCIe Switch 这枚曾经的配角,如今已成为算力供应链的关键卡点。在海外供给波动与国内智算建设的双重驱动下,国产厂商迎来了难得的产业窗口期。但替代并非一蹴而就——从芯片设计、高速 IP 到整机适配、大规模集群验证,仍需长期持续投入。这也是云栈社区上关注算力硬件与互连技术的开发者们持续跟踪的方向之一。
 发表于 2 小时前
|
查看: 6|
回复: 0


