LightCounting 这份报告围绕 AI 算力爆发这一主线,系统梳理了大模型训练与推理侧的算力增长、供应链约束,并对比了 NVIDIA、谷歌、华为三大厂商的 AI 集群与互联架构。在此基础上,报告从 Scale-Up、Scale-Out、Scale-Across 三个互联场景切入,分析可插拔光模块、NPO、CPO、DCI 相干光以及 OCS 光交换机等技术路线的走向,最后给出了以太网光模块的分场景市场预测。
一、市场大环境
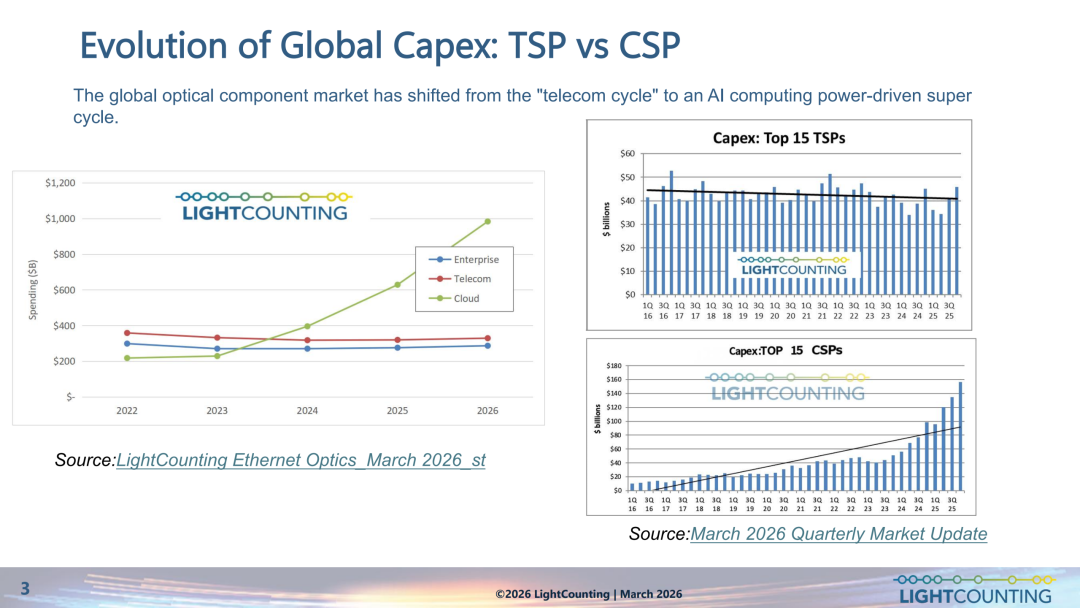
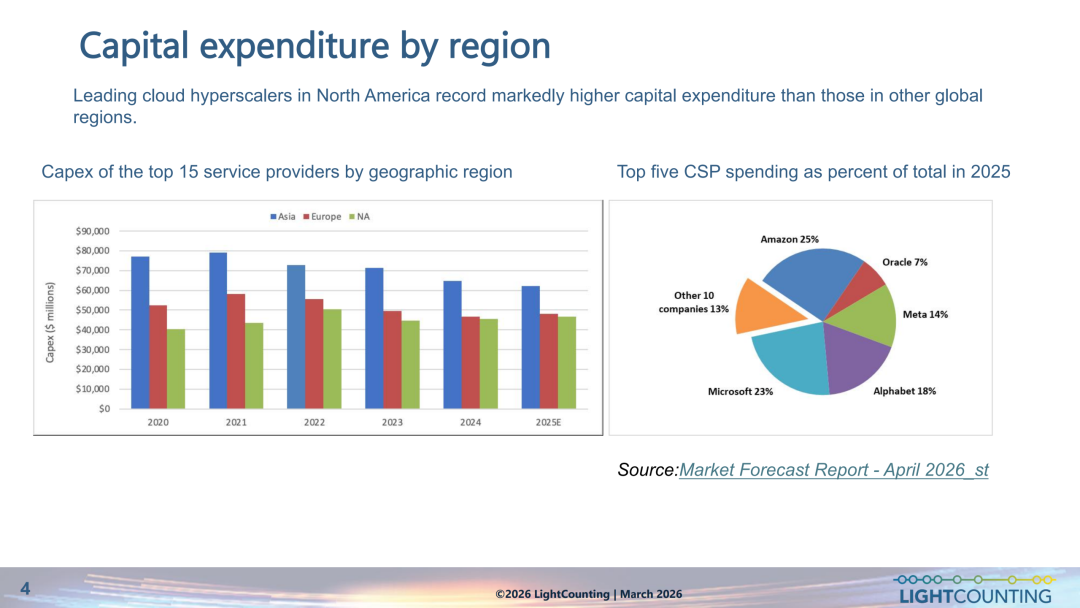
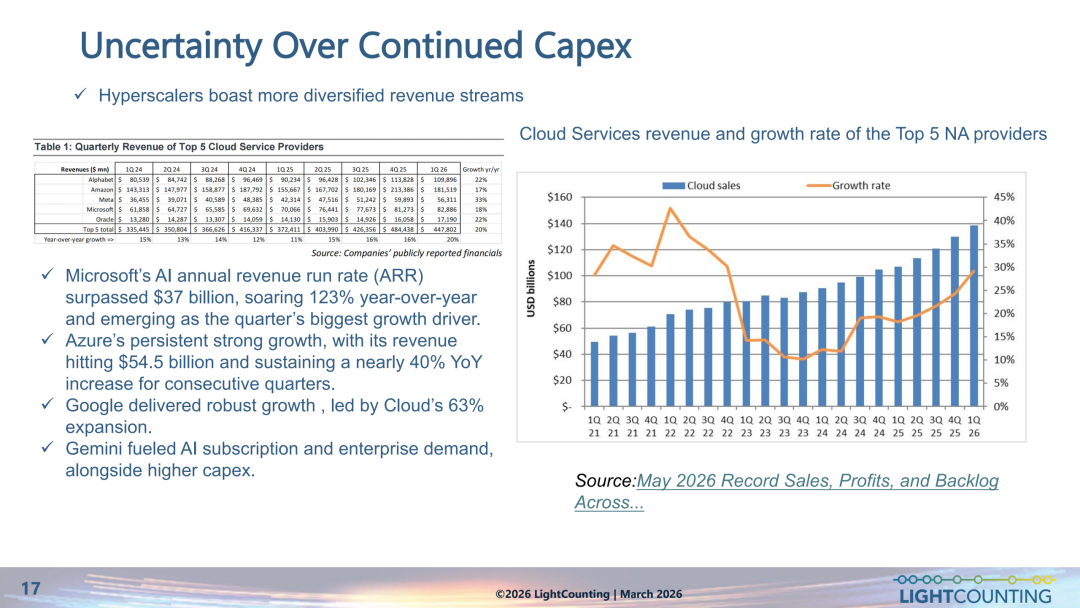
1. 资本开支结构变迁:北美云厂商的资本开支体量在全球处于绝对领先位置。2025 年,五大云厂商中亚马逊占比 25%、微软 23%、Alphabet 18%、Meta 14%、Oracle 7%。进入 2026 年,亚马逊、谷歌、微软、Meta 四家 AI 资本开支合计预计达到 7250 亿美元,同比增幅相当可观。
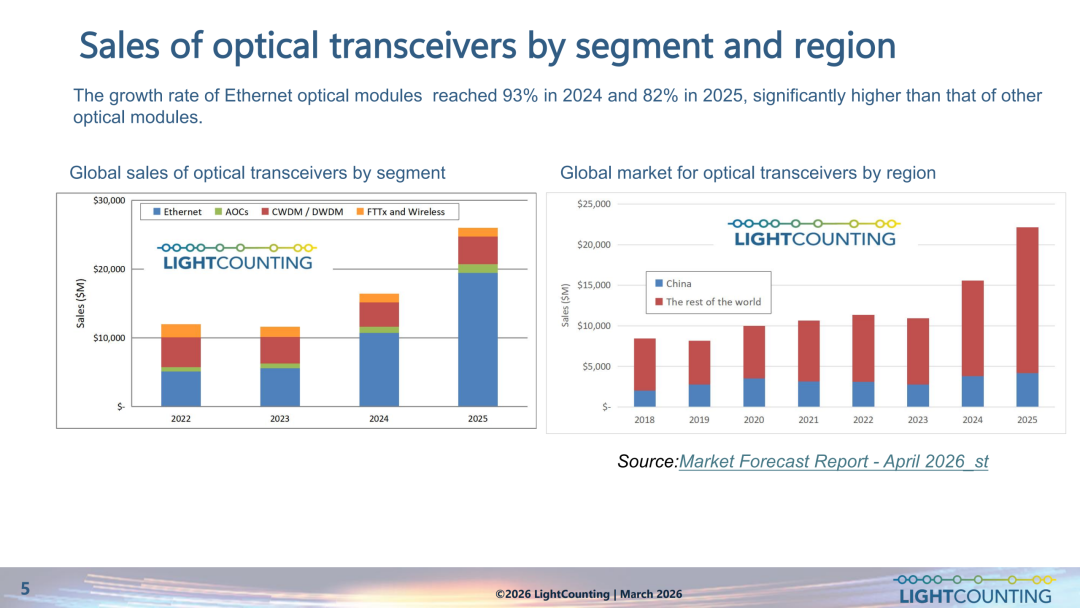
2. 光模块市场结构:以太网光模块是拉动市场增长的主要力量,2024 年增速达到 93%,2025 年仍有 82% 的增长,明显高于 AOC、CWDM/DWDM 以及接入类光器件。
3. 算力需求爆炸
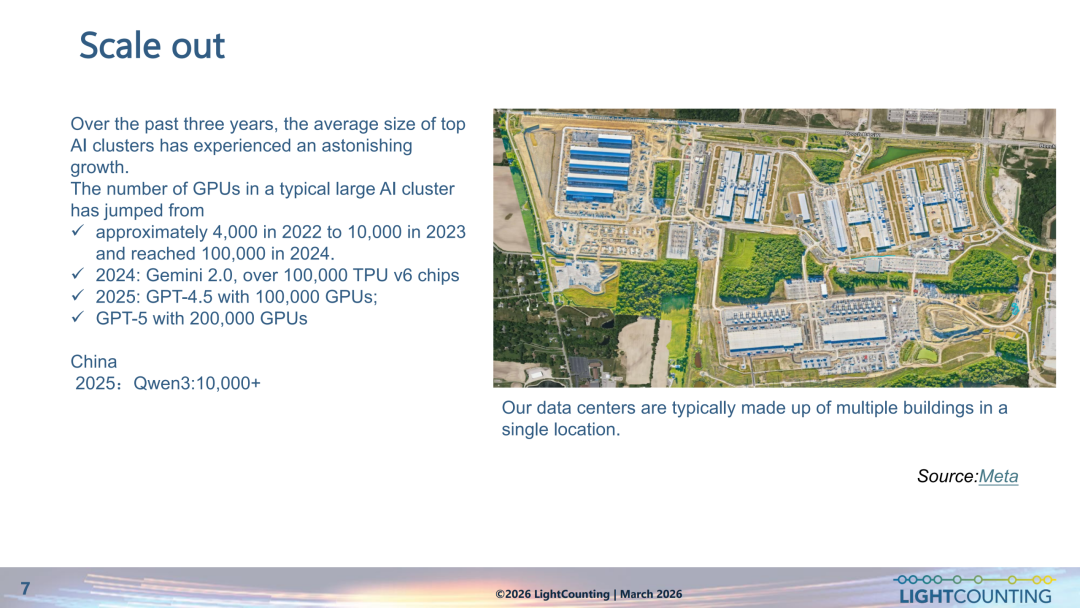
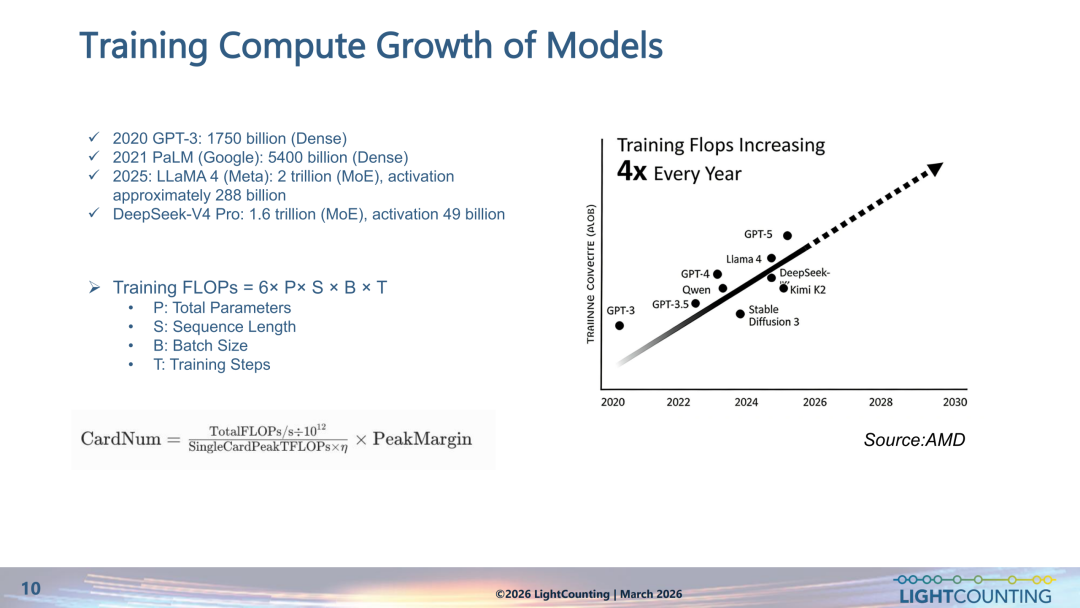
- 训练算力方面:模型训练的 FLOPs 每年约提升 4 倍,集群 GPU 规模也在快速扩张。大型 AI 集群的 GPU 数量从 2022 年约 4000 卡,增长到 2024 年的 10 万卡级别。
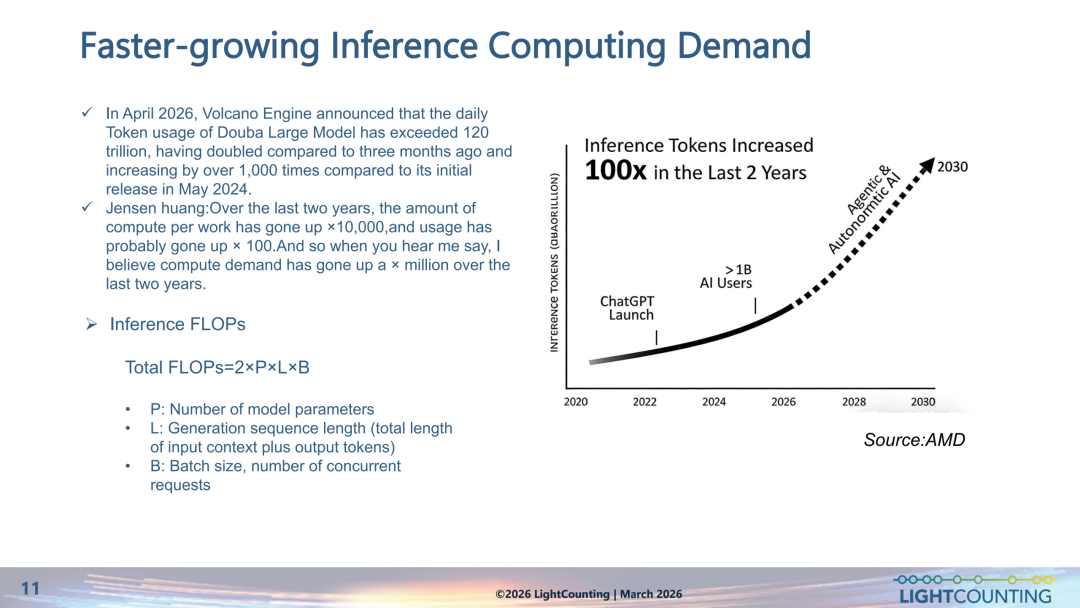
- 推理算力方面:过去两年推理 Token 规模增长了 100 倍,智能体 AI 还会进一步放大推理算力与互联需求。火山引擎豆包大模型日 Token 用量突破 120 万亿,这类案例从侧面印证了现实业务的爆发速度。
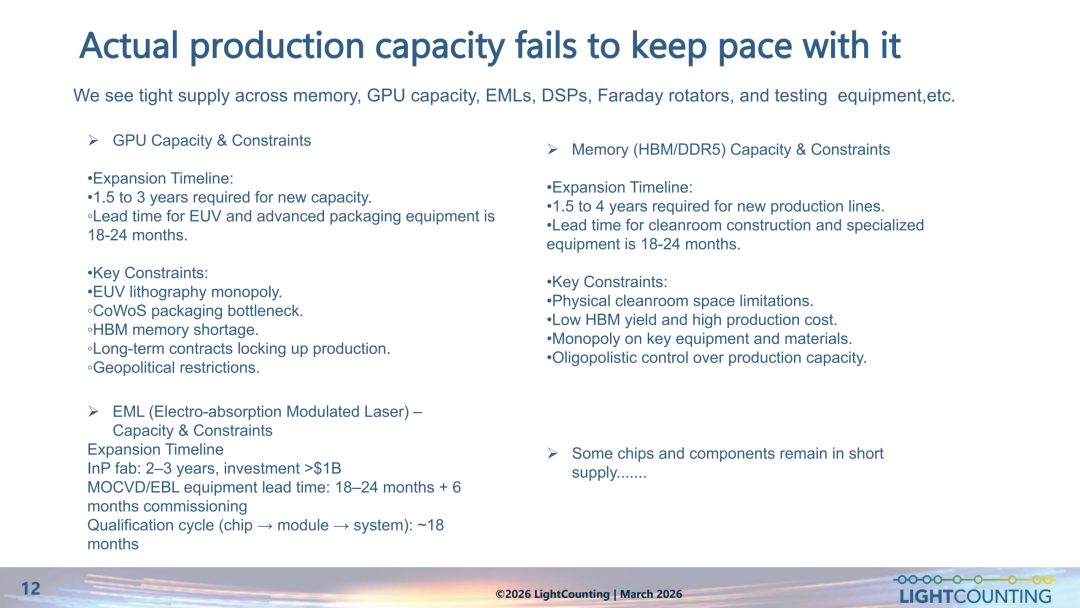
4. 供应链全面紧缺:GPU、HBM、EML 激光器、DSP 以及先进封装设备全面供给受限。EUV、CoWoS、InP 产线的建设周期长达 1.5 到 3 年,头部企业正在通过大额战略投资锁定上游供应链产能。
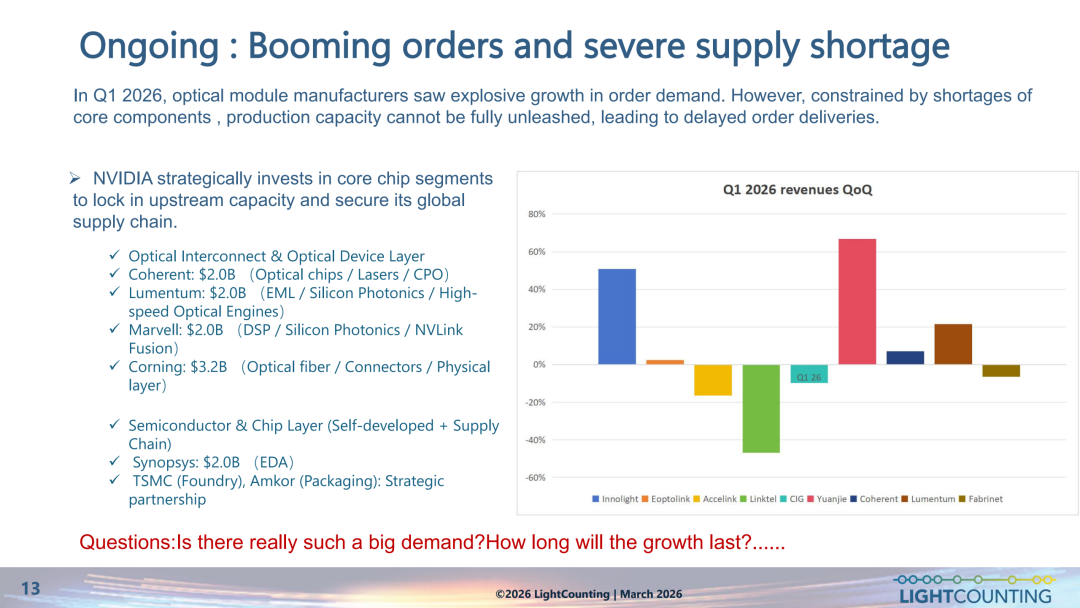
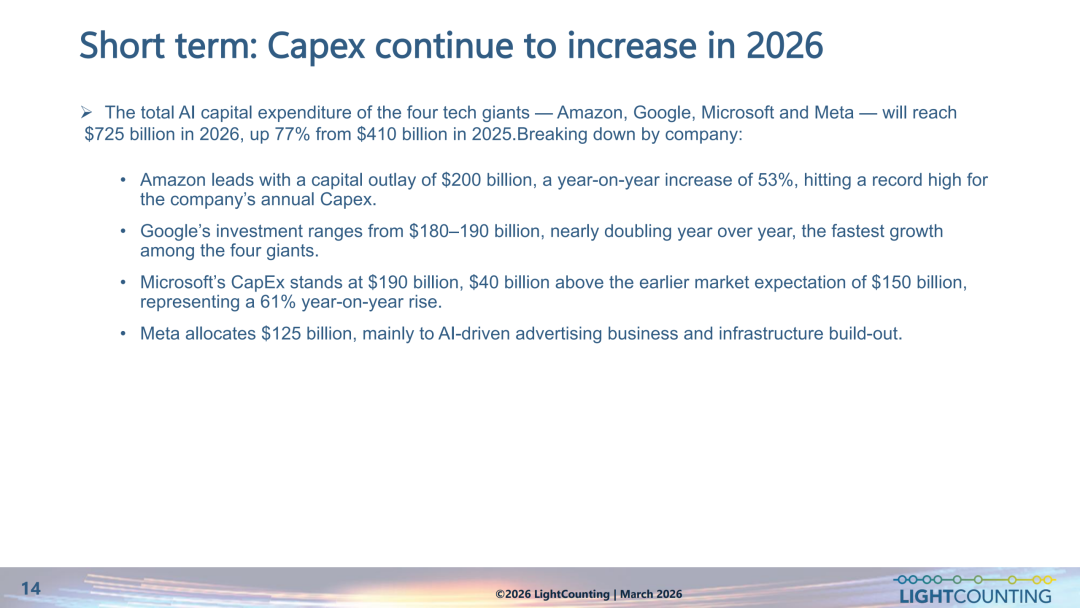
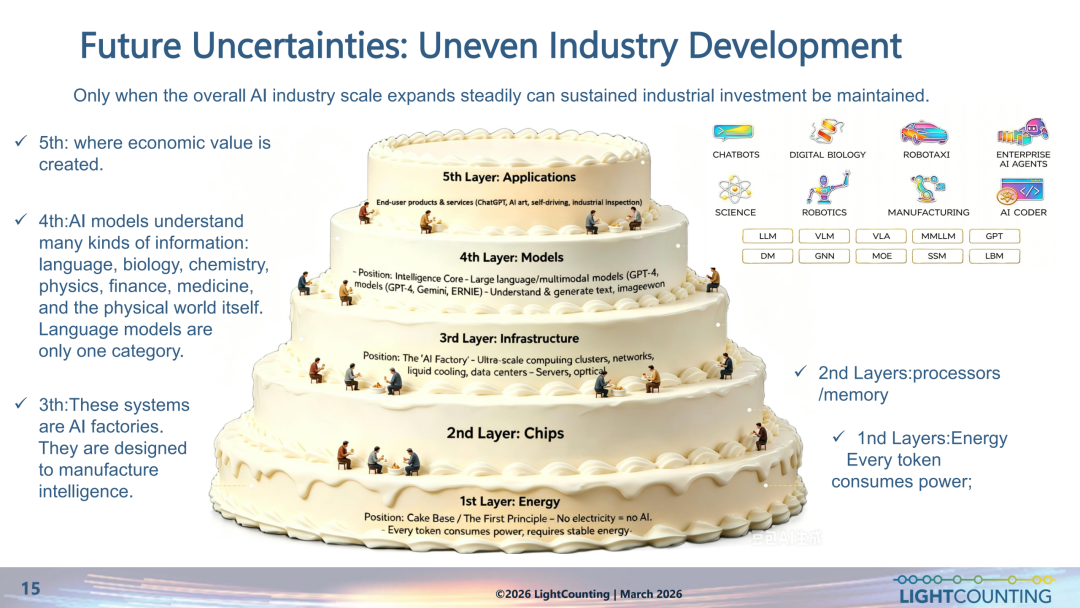
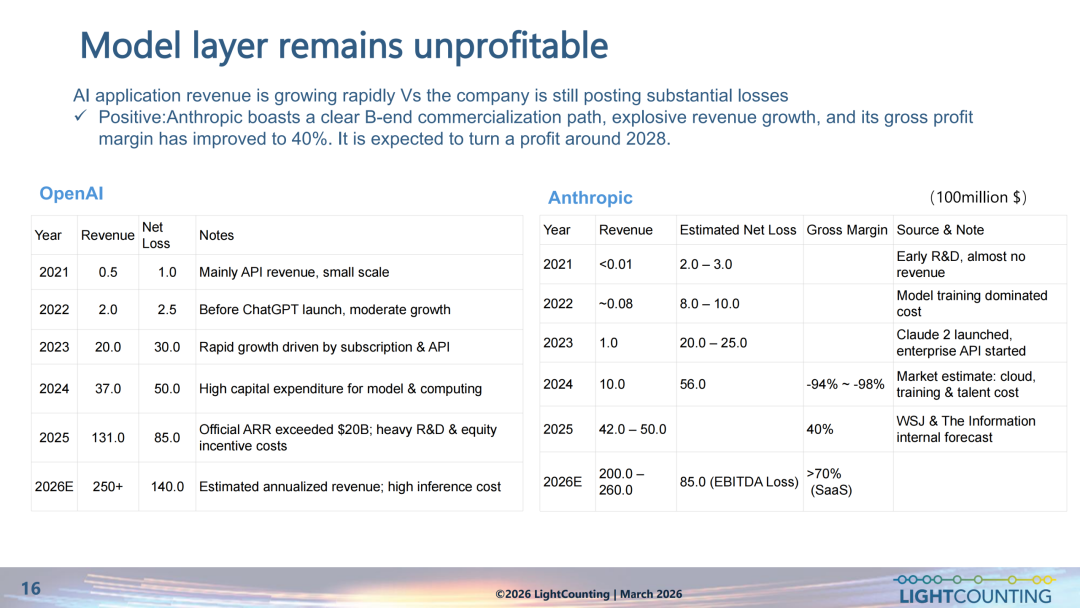
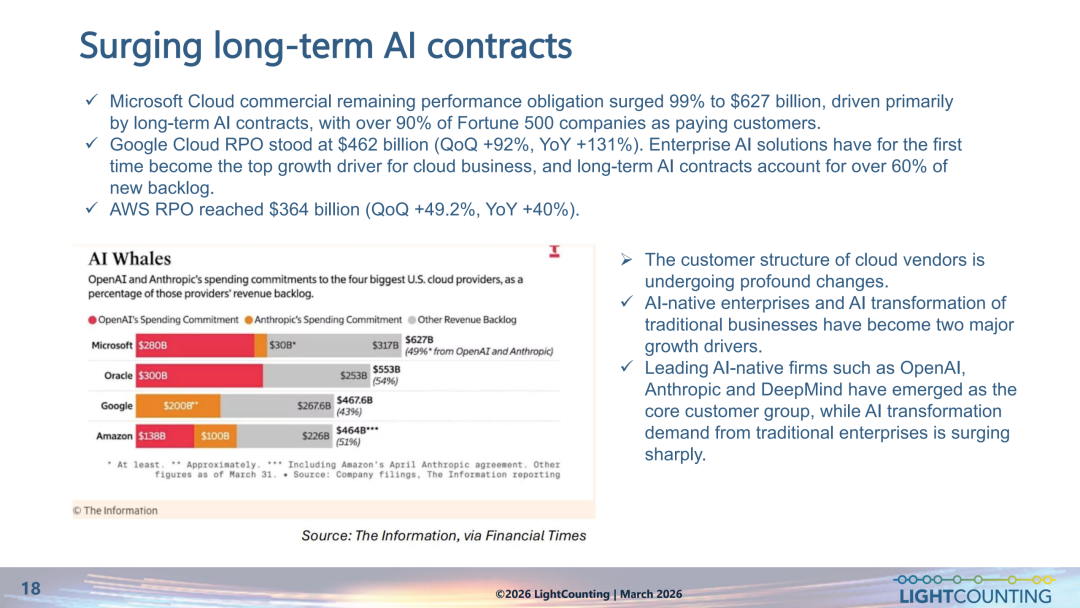
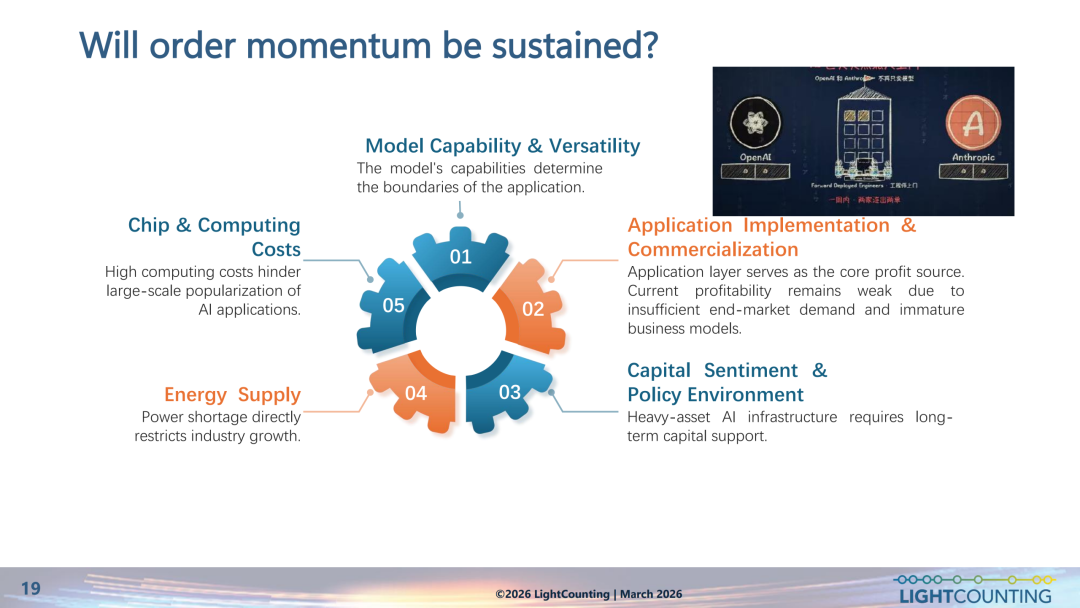
值得注意的是,订单可持续性和资本开支的增长后劲同样引发了市场讨论。从 AI 产业五层架构到模型层的盈利状况,再到云厂商的长期合同能见度,不确定性正在累积。
二、主流厂商 AI 集群与互联架构
1. NVIDIA 路线
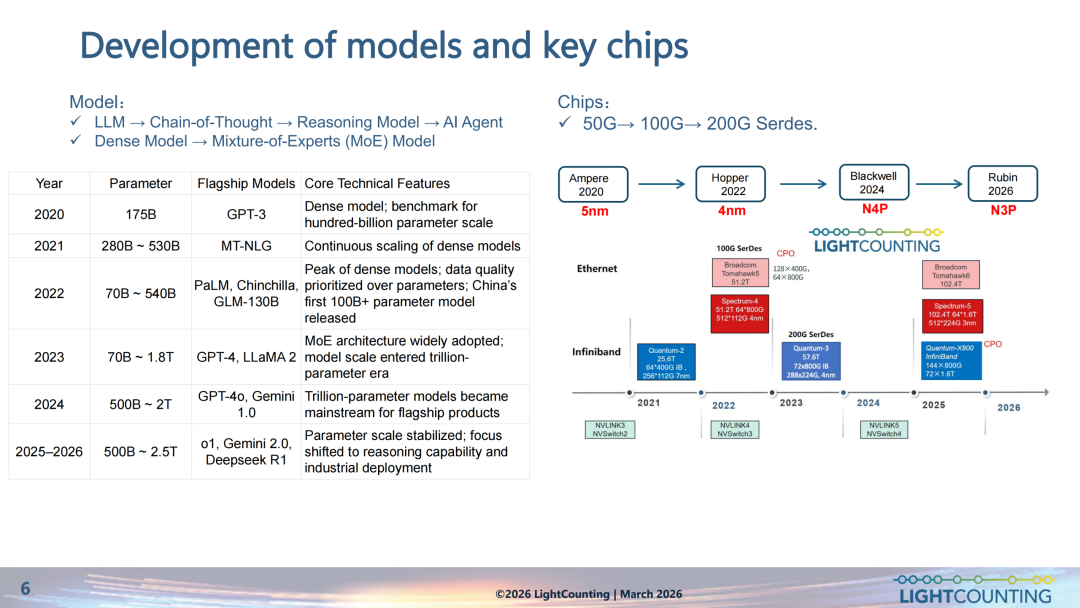
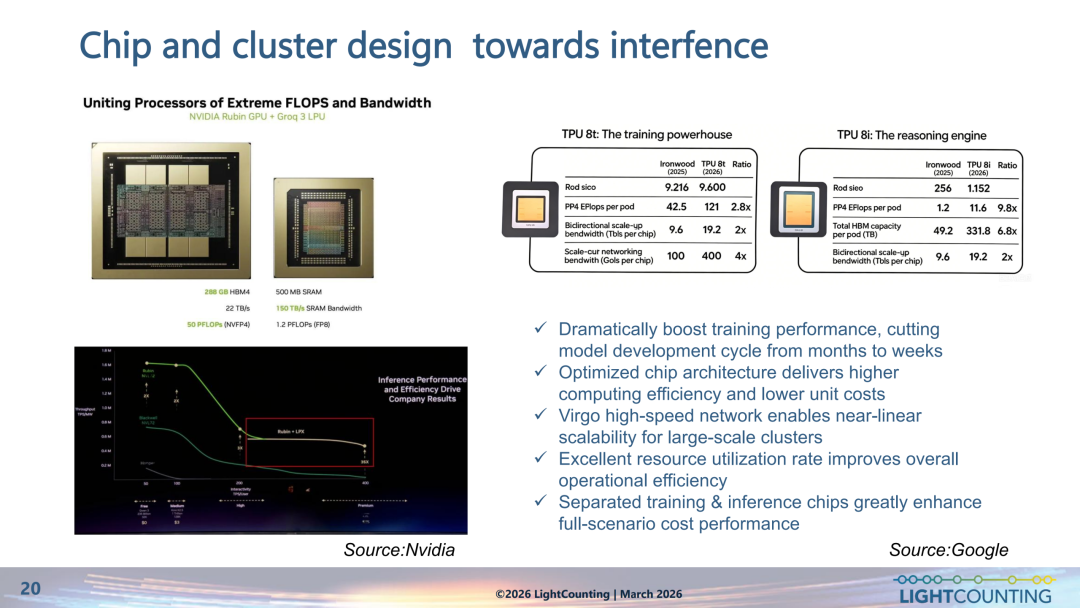
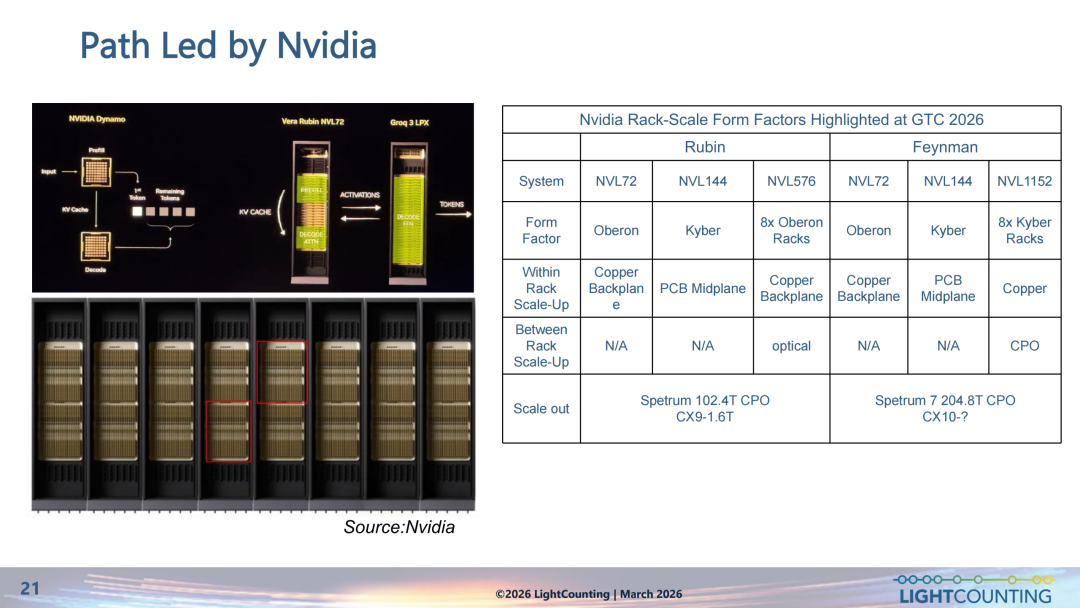
Rubin GPU 平台带来了 NVL72、NVL144、NVL576 等机架级系统。机架内部的 Scale-Up 采用铜背板方案,跨机架互连则逐步落地 CPO 光互连。交换机端 Spectrum 系列持续迭代,CPO 正在从纸面走向部署。面向推理场景,NVIDIA 推出了做 KV Cache 优化的 Dynamo 架构,并与 Groq LPU 协同提升推理效率。
2. 谷歌 TPU 路线
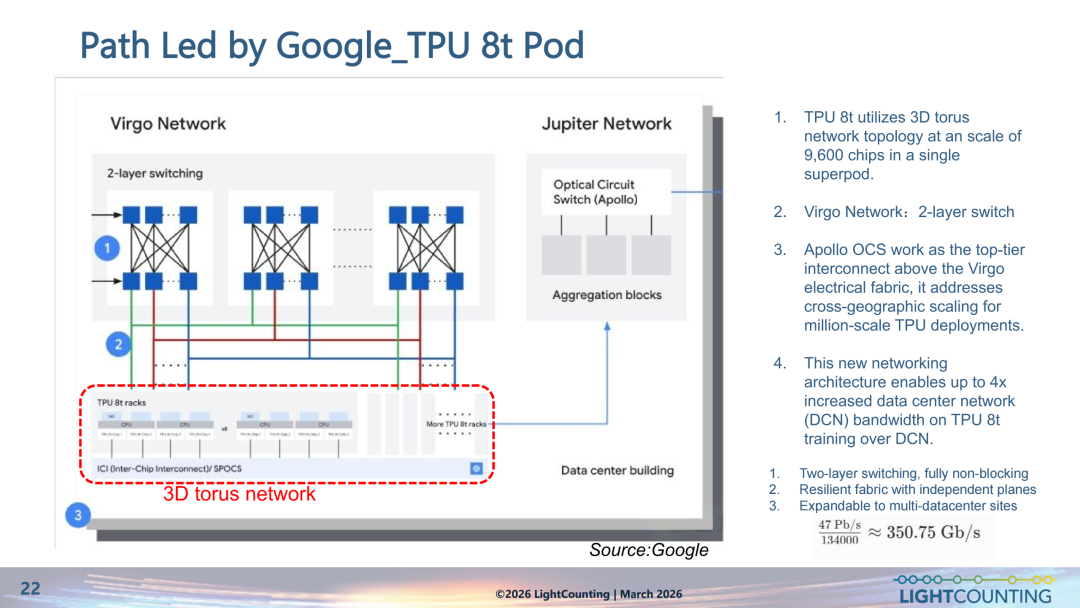
谷歌把训练和推理拆成了两套芯片:TPU-8t 与 TPU-8i。
- TPU-8t:Virgo 二层交换加 3D-torus 集群网络,上层搭配 Apollo 光电路交换机 OCS,单个 Superpod 最多可容纳 9600 颗芯片。
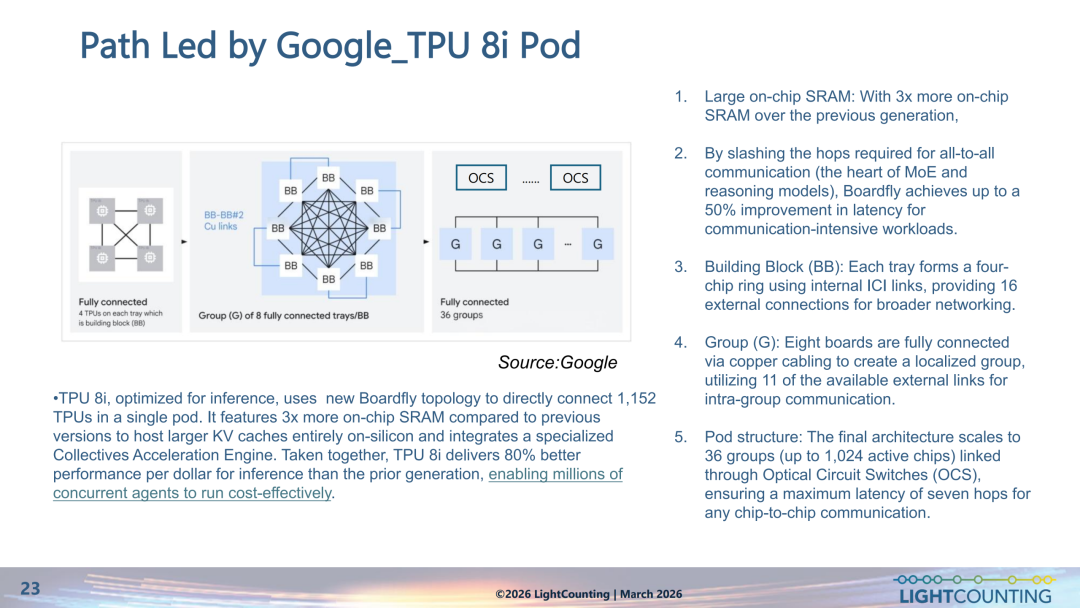
- TPU-8i 面向推理专用,采用 Boardfly 拓扑,片上 SRAM 扩大 3 倍,专门优化 MoE 与智能体推理通信,借助 OCS 实现大规模组网。
3. 华为路线
昇腾芯片持续迭代,从 Ascend 910C 到 950PR/DT、960、970,带宽、算力和数据格式支持都在提升。华为的 8K 超节点采用 2-Mesh + CLOS 架构,LPO/DPO 光链路负责 Scale-Out 扩展。
4. Scale-Up 技术路线百花齐放
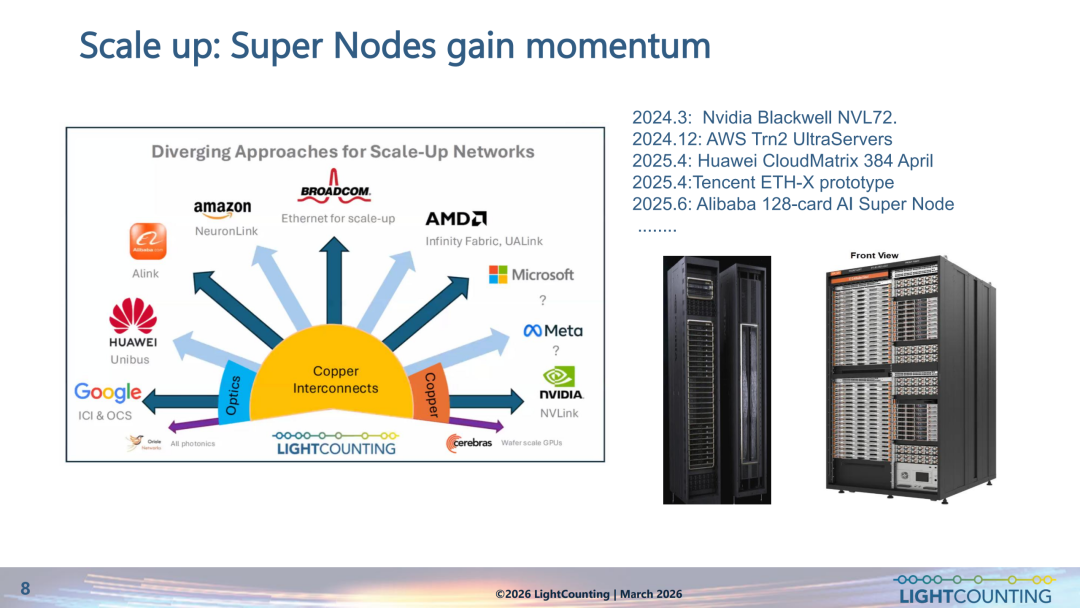
业界涌现出多条紧耦合互连方案:NVIDIA NVLink、AMD UALink/Infinity Fabric、AWS NeuronLink、华为 Unibus、谷歌 ICI、阿里 Alink 等等。铜互连与光互连两条路径并行演进。
三、3 大互联场景光技术路线
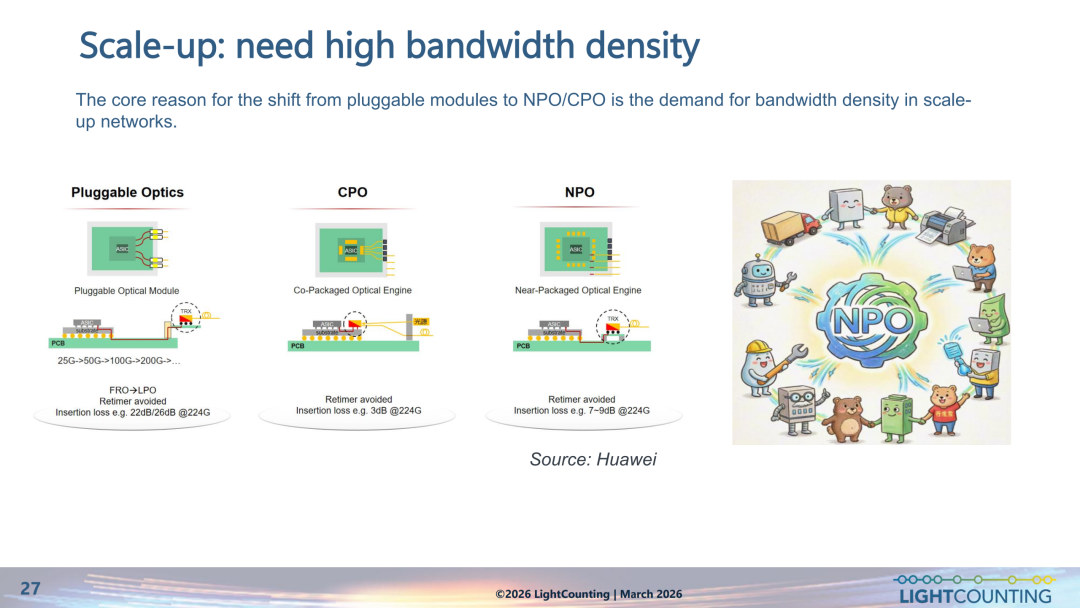
1. Scale-Up(机架内超节点紧耦合):追求极高的带宽密度,这也是推动行业从传统可插拔走向 NPO/CPO 的核心动因。
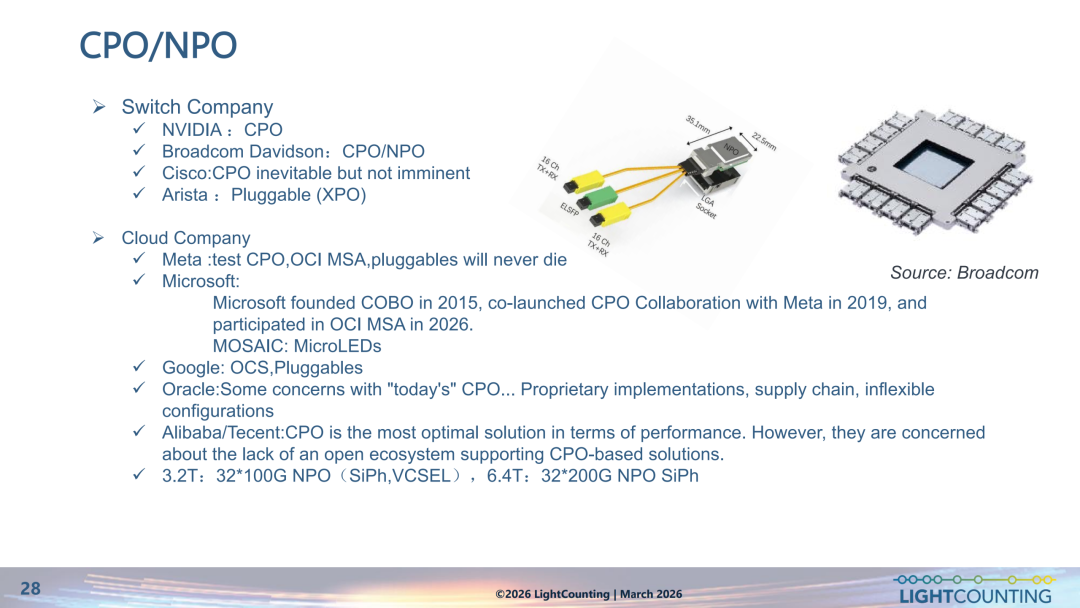
- CPO 共封装光引擎:光引擎和交换机 ASIC 封装在一起,插入损耗明显降低;NVIDIA、博通是主要推动者,Meta、微软开展验证,Oracle 则担忧供应链与封闭实现的风险。
- NPO 近封装光引擎:采用 LGA 插座形态,相比 CPO 兼顾了性能与可运维性,博通已推出对应的硬件方案。
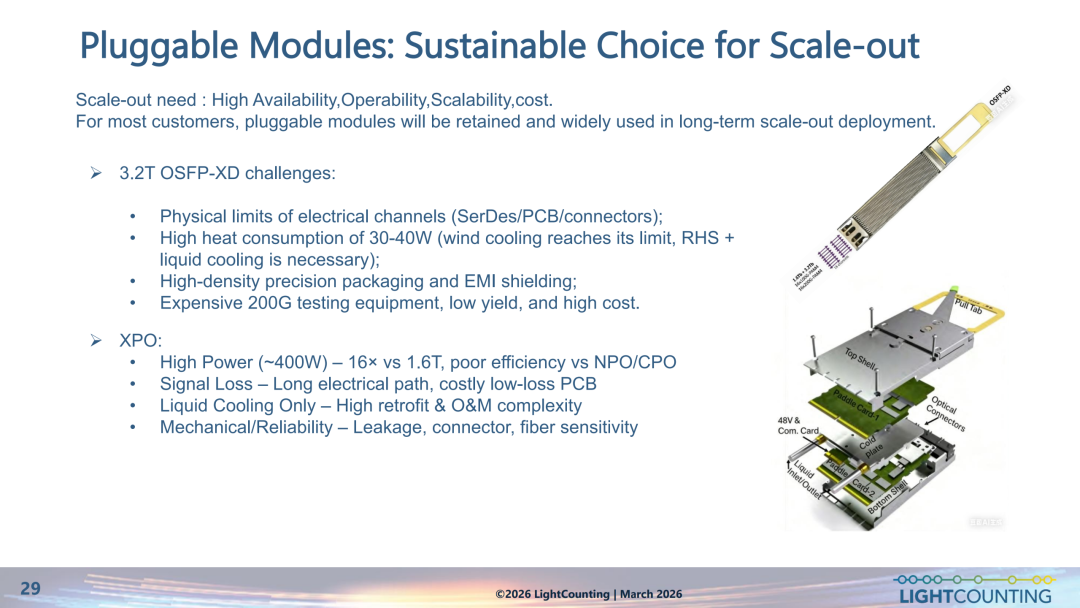
2. Scale-Out(集群跨机架):这个场景重视可靠性、可运维性和可替换性,因此可插拔模块长期不会消亡。XPO 超高密度可插拔代表了下一代方向,但面临功耗、散热、液冷改造和机械可靠性等现实挑战。
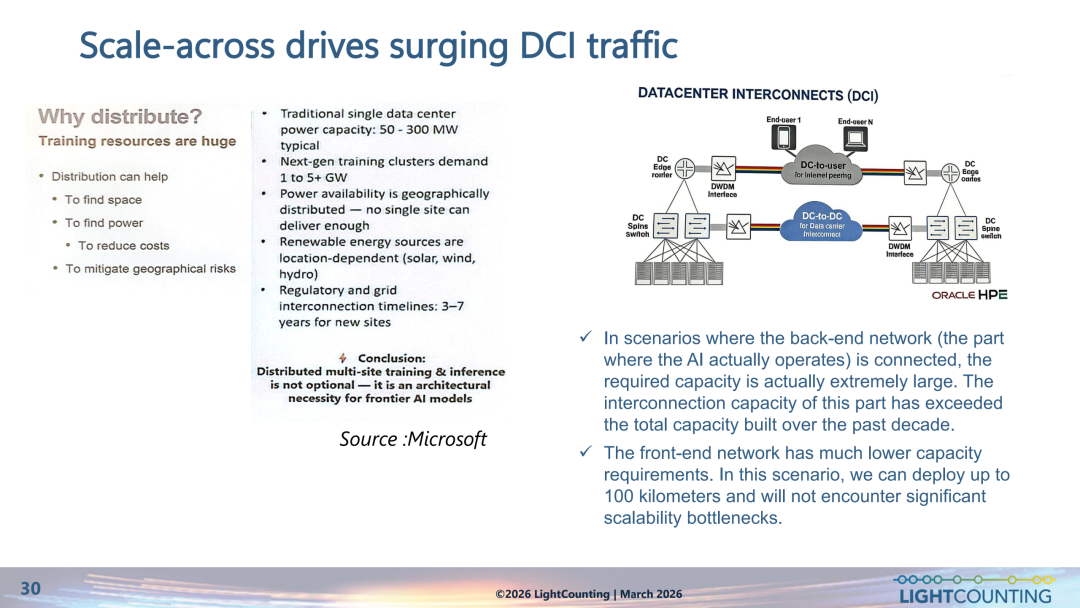
3. Scale-Across(跨数据中心 DCI):
- 下一代 AI 训练集群单站点功耗可达 1 到 5GW,受限于电力、土地和可再生能源布局,多分布式数据中心成为架构上的必然选择,DCI 流量随之爆发。
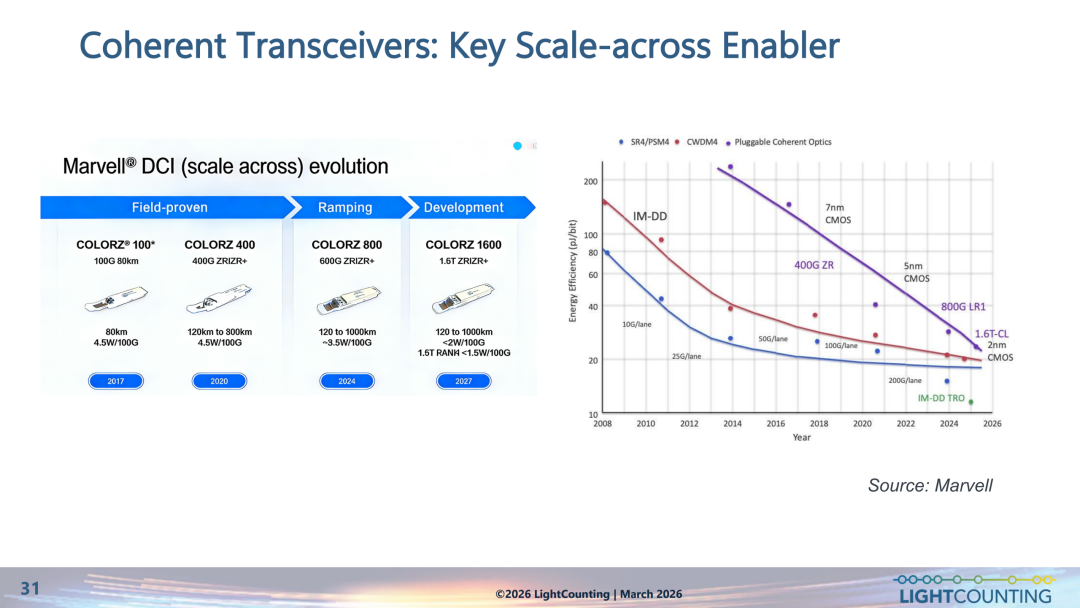
- 相干光模块是 DCI 的核心器件,Marvell COLORZ 系列正在向 800G、1.6T 演进。
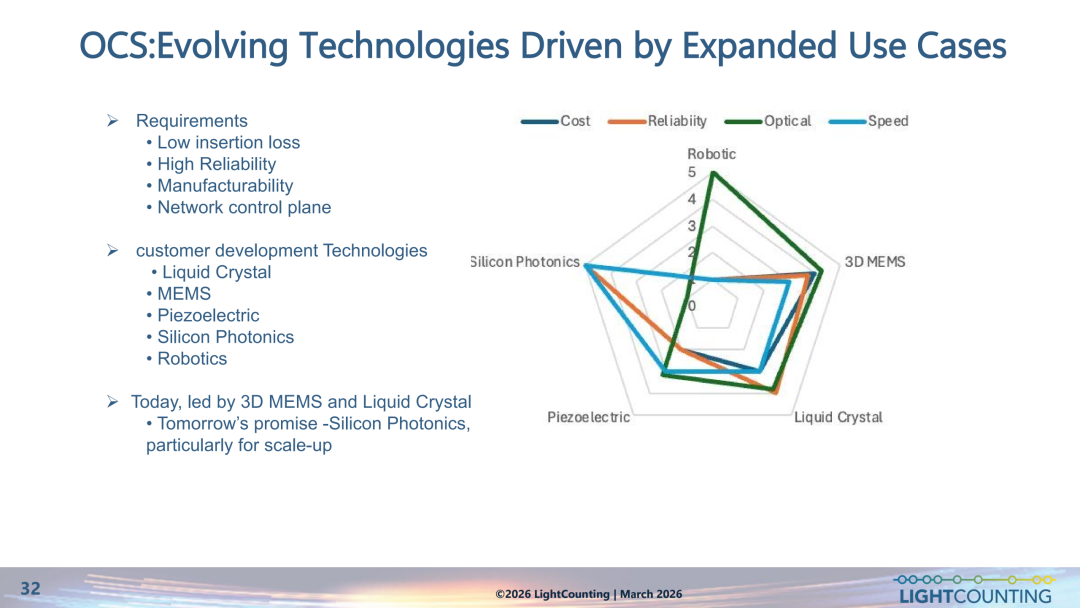
4. 光电路交换机 OCS:3D-MEMS、液晶、压电、硅光多种技术路线并存,在 AI 集群中用于大跨域组网。不同方案在损耗、可靠性、速度和成本上各有取舍。
四、市场预测
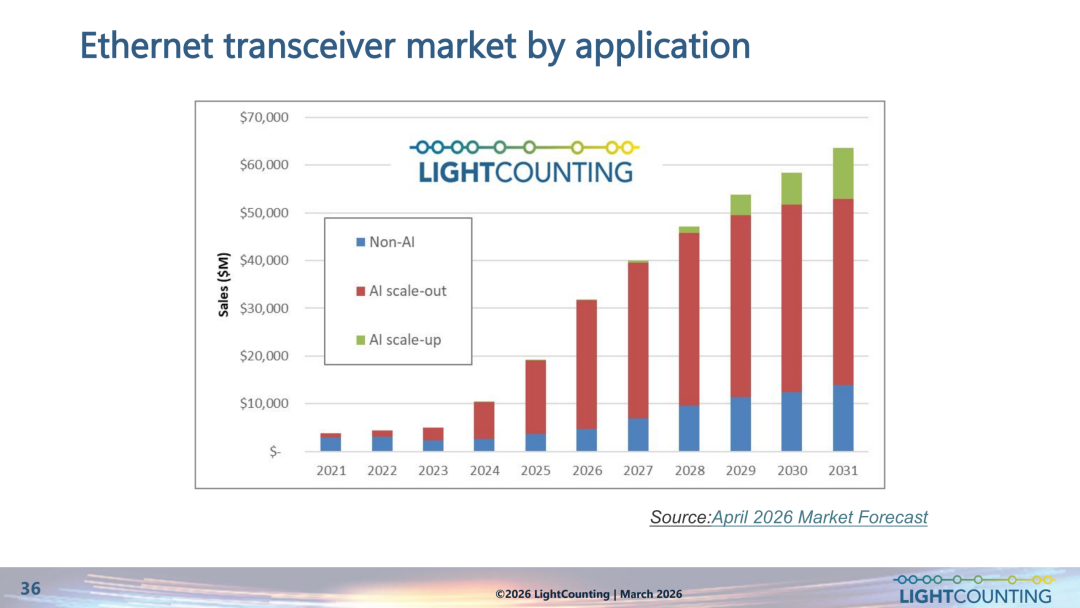
1. 市场规模预测:到 2031 年,基准情景下全球 AI 相关以太网光模块市场规模为 630 亿美元,较 2025 年增长 3.5 倍;乐观情景可达 1260 亿美元,对应 7 倍增长;悲观情景则会显著下修。市场拆分包含非 AI 业务、AI Scale-Out、AI Scale-Up 三大部分,AI 相关占比将持续抬升。
2. 技术结构变迁:CPO/NPO 的市场份额将从 2025 年的几乎为零,到 2031 年获得可观占比;LPO/LRO、Retimed 可插拔仍会长期共存。DCI 相干 DWDM 带宽需求持续高速增长。
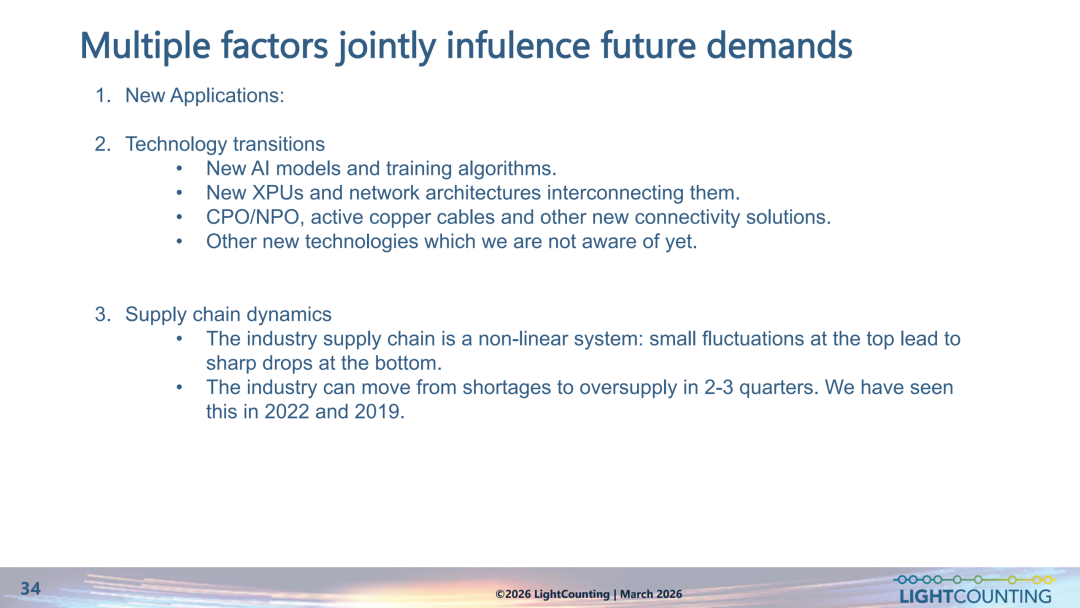
总的来看,LightCounting 的这份分析描绘了一条清晰的传导链:AI 模型能力跃升推动训练与推理算力激增,算力激增倒逼集群规模扩张与互联架构升级,最终把压力传递到光模块、CPO/NPO、相干 DCI 以及 OCS 等光互联环节。2026 年订单爆发与供应链紧缺是短期矛盾,而 2031 年的市场天花板,取决于模型能力、应用变现、资本情绪、能源供给和芯片成本这五个齿轮能否同步转动。
 发表于 前天 00:36
|
查看: 92|
回复: 0
 /1


