在 CPO(共封装光学)这条技术路线上,英伟达显然还不满足于现有方案。在 SEMICON West 2026 上,英伟达展示了两项面向下一代 AI 系统互连的光互连研究成果:一项是将光引擎从传统封装基板移至硅中介层上的 Optics-on-Interposer(OOI),另一项则是采用密集波分复用(DWDM)技术,实现单根光纤 256Gb/s 的数据传输。
这两项技术分别瞄准光互连链路的不同环节。OOI 希望进一步缩短芯片与光引擎之间的电信号传输距离,而 DWDM 则试图在不增加光纤数量的情况下,提高单根光纤的传输容量。
从技术方向来看,英伟达正在尝试把光互连做得更靠近计算芯片,同时进一步提高光纤侧的带宽密度。这也勾勒出其下一代 CPO 技术可能的发展方向。
需要说明的是,目前 OOI 和 DWDM 仍处于研究阶段,英伟达尚未公布具体产品导入计划及商业化时间表。
光引擎,从封装基板走向硅中介层
先来看 OOI。
传统 CPO 的核心思路,是将光引擎与交换芯片等计算芯片放在同一个封装内,以缩短电信号在芯片与光引擎之间的传输距离,降低高速电互连带来的功耗和信号完整性压力。
不过,即便采用 CPO,光引擎与计算芯片之间仍然存在进一步缩短距离的空间。
以英伟达现有的 CPO 方案为例,光引擎安装在封装基板上。计算芯片产生的电信号,需要经过硅中介层,再通过有机封装基板传输到光引擎,完成电光转换。
OOI 改变的正是这段传输路径。
英伟达提出将光引擎直接放置在硅中介层上,与计算芯片处于同一中介层之中。这样一来,计算芯片与光引擎之间便可以通过中介层上的高密度布线直接连接,不再需要经过有机封装基板。
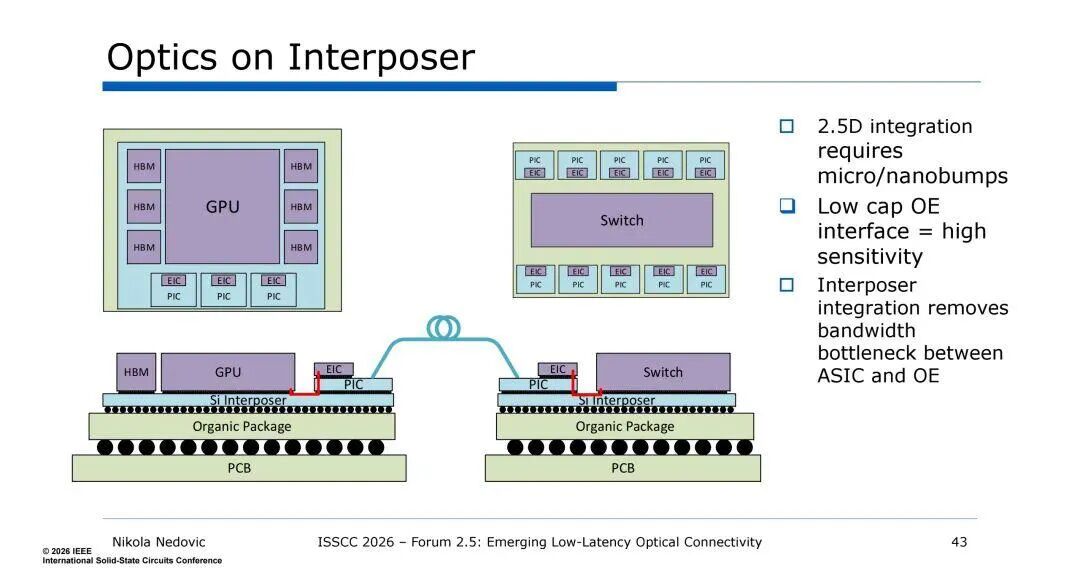
这一变化看起来只是光引擎安装位置的调整,实际上涉及整个封装内部互连架构的变化。
硅中介层能够提供比有机基板更高密度的布线能力。光引擎直接放置在中介层上,不仅可以缩短电信号传输路径,还能够利用中介层的高密度互连特性,实现更多并行电连接。
这背后还有一个值得关注的技术思路:与其不断提高单条电信号通道的传输速率,不如通过增加并行通道数量来满足带宽需求。
英伟达此前发表的研究论文《Beyond CPO》就讨论过这一方向。其核心思路是利用中介层的高密度布线能力,通过更多相对低速的并行电连接,提高芯片与光引擎之间的总带宽。
这与当前 AI 芯片不断增加互连带宽的需求相吻合。
随着 GPU 集群规模扩大,芯片之间需要交换的数据量持续增加,传统电互连面临功耗、距离和信号完整性等方面的压力。将光引擎进一步靠近计算芯片,是继续提升互连密度的一种路径。
当然,OOI 并不意味着整个封装不再需要有机基板。改变的是计算芯片到光引擎之间的信号传输路径,而不是彻底取消有机基板在供电、机械支撑等方面的作用。
单根光纤 256Gb/s,DWDM 进一步提高带宽密度
如果说 OOI 解决的是芯片到光引擎之间的电互连问题,那么英伟达展示的另一项技术 DWDM,则瞄准光纤传输环节。
这次展示中,英伟达通过 8 个不同波长的光信号,在单根光纤上实现了 256Gb/s 的数据传输。
具体来看,每个波长对应一条 32Gb/s 的数据通道,8 个波长同时传输,最终实现:
8 × 32Gb/s = 256Gb/s
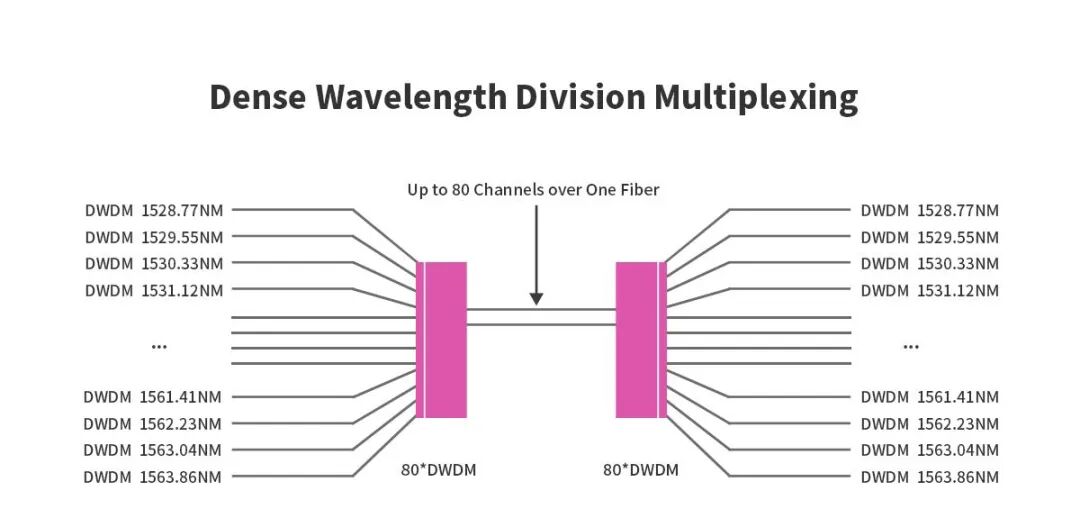
DWDM,即密集波分复用,基本原理并不复杂:不同波长的光信号可以同时在同一根光纤中传输,接收端再通过相应的光学器件将不同波长的信号分离出来。
过去一根光纤可能只承载一路数据,现在则可以同时承载多路数据。这样就能在不增加光纤数量的情况下,提高单根光纤的传输容量。
这项技术还有一个值得关注的地方:英伟达并没有简单地将单条通道的速率推得更高,而是通过多个波长并行传输,实现总带宽提升。
英伟达研究人员在 2026 年 3 月 OFC 会议上公布过相关研究成果,论文题为《A 256 Gb/s DWDM Optical I/O in a 3D-stacked EIC/PIC Silicon Photonics Platform》。
该研究采用 3D 堆叠的电子集成电路(EIC)和光子集成电路(PIC)平台,其中 EIC 采用 7nm 工艺,PIC 采用 65nm 工艺。其采用 8+1 通道结构,8 个数据通道各自实现 32Gb/s 传输,另外一个通道专门用于时钟传输,因此数据带宽合计为 256Gb/s。
需要注意的是,时钟通道不计入 256Gb/s 的数据带宽。此外,OFC 展示的实验平台与此次 SEMICON West 公布的 OOI 原型是否采用完全相同的电路配置,目前也没有得到确认。
从技术分工来看,DWDM 和 OOI 并不是相互替代的关系。前者提高光纤侧的传输容量,后者提高计算芯片与光引擎之间的电连接密度。两者如果能够结合,理论上可以进一步提高整个光互连链路的带宽能力。
下一代 CPO,难点不只是带宽
把光引擎放得更靠近计算芯片,同时利用 DWDM 提高光纤传输容量,技术方向很明确。但从实验室成果走向实际产品,中间还有不少问题需要解决。
首先是散热。OOI 将光引擎放置在计算芯片所在的硅中介层上,虽然缩短了电互连距离,但也意味着光引擎距离 GPU 等高功耗芯片更近。计算芯片产生的热量可能影响周围光学器件的工作稳定性,尤其是光器件对温度变化较为敏感,如何进行热管理将成为设计中的重要问题。
事实上,英伟达 2023 年发表的相关研究已经涉及温度控制环路的验证。此次 SEMICON West 的技术介绍,也将热管理列为需要重点解决的问题。
其次是封装和制造。光引擎从封装基板转移到硅中介层,意味着封装内部的互连、器件布局和制造流程都需要重新考虑。光学器件与计算芯片之间的高密度集成,对制造精度、组装良率以及光纤连接提出了更高要求。
还有一个容易被忽视的问题,是后期维护。
英伟达现有的 CPO 产品已经考虑到这一点。例如,在 Spectrum-X Ethernet Photonics 等方案中,激光光源采用外置设计,并放置在独立的温控环境中。这样既有助于控制温度对激光器的影响,也能够在光源出现问题时进行更换,而不必直接更换整个交换机。
与此同时,英伟达现有方案还采用可拆卸光纤连接器,以改善组装良率和制造自动化。
但在 OOI 架构中,光引擎进一步靠近计算芯片,集成度更高,也意味着器件出现故障后的维修和更换可能更加复杂。如何在高密度集成与可维护性之间取得平衡,是未来产品化必须面对的问题。
值得注意的是,英伟达并不是刚刚开始布局 CPO。
今年 5 月,英伟达宣布 Spectrum-X Ethernet Photonics 交换机进入全面量产阶段,说明其 CPO 技术已经开始从研发走向实际产品。现有产品的供应链涉及台积电的硅光子制造、日月光的封装测试,以及外置激光光源、光纤和相关组件供应商。
而此次 OOI 展示,则是在现有 CPO 基础上进一步推进光电集成。
从英伟达此前的研究论文,到 2026 年 3 月 OFC 公布 256Gb/s DWDM 实验成果,再到 10 月 SEMICON West 展示 OOI 原型,可以看到其研究方向正在逐渐清晰:一方面,通过硅中介层提高芯片与光引擎之间的互连密度;另一方面,通过 DWDM 提高光纤侧的传输容量。
当然,这并不意味着 OOI 马上就会成为英伟达下一代 GPU 或交换机的标配。目前两项技术仍处于研究阶段,英伟达没有公布产品型号、量产时间,也没有披露 OOI 的实际功耗改善幅度和带宽密度数据。
但有一点已经比较明确:随着 AI 集群对互连带宽的要求不断提高,CPO 的演进不会止步于将光引擎放进封装。如何进一步缩短电互连路径、提高光互连密度,并解决热管理和制造问题,将决定下一代 CPO 能够走多远。
对于英伟达而言,OOI 或许正是其继续推进这一方向的一次重要尝试。对光互连、CPO 等技术动态感兴趣的朋友,也可以到云栈社区一起讨论。
 发表于 1 小时前
|
查看: 3|
回复: 0
 /1


