提到向量数据库,很多人的第一反应还是 RAG:文档切块、嵌入成向量、存进去、做相似度检索,听起来就像是 RAG 的附属组件。但更准确地说,向量数据库应该被理解成一种“通用的相似度搜索引擎”,RAG 只是它比较常见的一个应用场景。
这个视角切换,会直接影响工程决策的起点:团队应该先考虑要不要把向量库抽象成内部基础设施,而不是先去纠结某个 RAG 框架到底集成了什么。本文以环境法律法规智能问答系统项目为例,把这个区分讲清楚,再梳理主流向量库的选型逻辑。
一、为什么需要向量数据库
传统关键词检索,比如 Elasticsearch 或者 SQL 里的 LIKE,本质上是匹配字面。用户搜“印染废水 COD 限值”,系统就去文档里查找出现过这几个字的位置。问题也很明显:同义词接不住,说法不同接不住,表述稍微变个样子也可能接不住。
向量检索做的不是字面匹配,而是语义匹配。它会把“印染废水 COD 限值”和文档里的“纺织染整工业水污染物排放标准规定 COD 排放限值 200mg/L”都编码成高维向量,再计算余弦相似度。这两个句子可以没有一个共用字词,只要语义接近,就能被找到。向量数据库存的是向量,查的是相似度。
不过语义检索有一个难点:高维向量的精确最近邻搜索是 O(Nd) 的线性扫描。一万条数据可以暴力算,一亿条就不现实了。向量数据库要解决的核心问题,是在保持高召回的前提下,把搜索时间压到亚线性级别。它靠的是 ANN(Approximate Nearest Neighbor,近似最近邻)索引算法:牺牲一点点精度,换取大幅提速。返回的结果不是数学意义上的绝对最近,而是“足够近”的结果。
二、Embedding:把文字变成向量
向量数据库存的是浮点数数组,不是文本。把文字变成向量,需要依赖 Embedding 模型。通俗地说,Embedding 就是把离散文字压缩到一个连续的高维向量空间里,让语义相近的文本在空间中也彼此靠近。
这里提到的两个项目都用 BGE,具体型号是 BAAI/bge-small-zh-v1.5。选择它并不是因为它最强,比它强的是 OpenAI text-embedding-3-large,主要考虑是三点:
- 中文效果好:专门为中文训练,不是英文模型顺带支持中文。
- 体积小:约 93MB,CPU 也能跑,不需要 GPU。
- 工业界广泛使用:社区成熟,可复现性强。
但 BGE 也有一个容易踩坑的地方:查询和文档要用不同的前缀。环境法律法规智能问答系统里的关键代码只有一行:
emb = self._model.encode(
    f"为这个句子生成表示以用于检索相关文章:{text}"
)
查询端要加指令前缀,文档端不加。如果忘了加,召回率会掉 5 到 15 个百分点。程序照样能跑,只是检索质量悄悄下降,这种问题排查起来非常费劲。
这个细节也反映出 Embedding 模型在设计取向上的差异:不同模型对“什么算相似”的定义并不一样。BGE 会把查询意图和文档内容区分对待,有的模型则不做这种区分。
三、不只是 RAG:向量数据库的其他用法
把向量数据库理解成通用相似度搜索引擎之后,RAG 就只是它的一种用法。非 RAG 的场景其实不少:
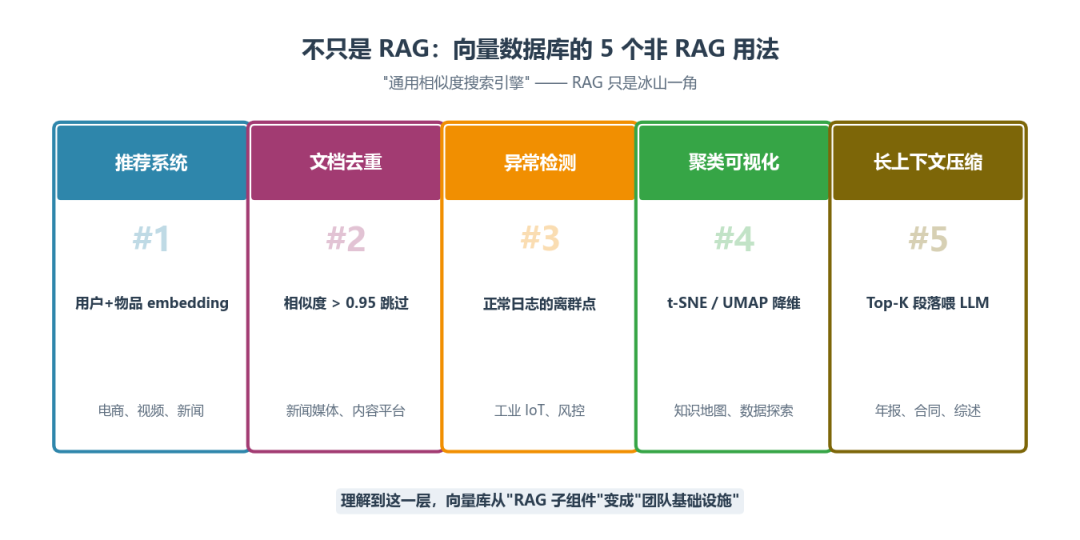
推荐系统:用户历史行为 embedding 加上物品 embedding,再找最近邻。电商的“猜你喜欢”、视频的“相似推荐”、新闻的“你可能也感兴趣”,背后都是这套逻辑。这里不一定需要 LLM,也不需要复杂规则引擎,向量检索本身就能完成。
文档去重和异常检测:这两个场景本质上是同一类问题的两面。把已知正常样本 embedding 起来,新样本进来算相似度:高于阈值归入正常类,低于阈值就标记为异常或重复。新闻媒体可以用相似度大于 0.95 跳过重复抓取,工业 IoT 可以用相似度低于 0.3 标记异常日志,背后的公式其实是同一套。
聚类可视化:通过 t-SNE 或者 UMAP 把高维向量降维到二维平面,用于知识地图、数据探索等任务。向量库天然适合作为这类可视化工作的数据底座。
长上下文压缩:可以理解为把 RAG 的内核应用到任意长文档场景。比如把年报或合同切成 N 段全部 embedding,查询时只取最相关的 3 段喂给 LLM。大模型的上下文窗口有限,向量库可以帮它“挑着看”。
把向量库抽象成团队基础设施,比在一篇 RAG 教程里出现一行 import 更具复用价值。
四、向量数据库的基本操作
不同向量库的 API 骨架都差不多:建索引、写入、查询、删除。以 ChromaDB 为例:
# 建库
client = chromadb.PersistentClient(path="./data/chroma_db")
collection = client.get_or_create_collection("env_laws")

# 写入
collection.add(documents=chunks, embeddings=embeddings, metadatas=metadatas, ids=ids)

# 检索
results = collection.query(query_embeddings=[query_vec], n_results=5)
索引算法是底层最复杂的部分。主流方案是 HNSW(Hierarchical Navigable Small World,分层可导航小世界图),思路有点像城市交通:高架快速路作为顶层稀疏图,先把你带到目标区域;然后下到地面道路,也就是底层密集图,再精确找邻居。查询时从顶层开始快速跳转,复杂度接近 O(log N)。Milvus、Qdrant、Weaviate 默认都用 HNSW 或它的变体。
不过真到了选型层面,我们更该看的是工程特性,比如部署模式、扩展性和生态,而不是谁家索引算法更新。
五、主流向量数据库选型
从实际场景出发,几个主流选项的定位会比较清楚:
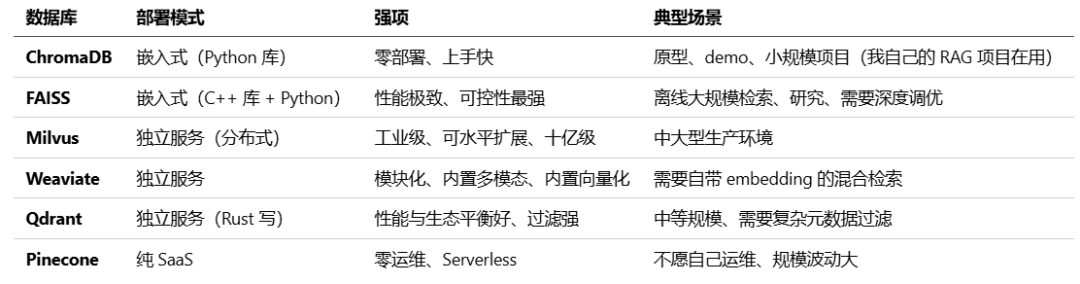
几万到几十万条数据,可以先选 ChromaDB 把链路跑通;性能敏感选 FAISS;亿级以上选 Milvus;不想自己运维就选 Pinecone。
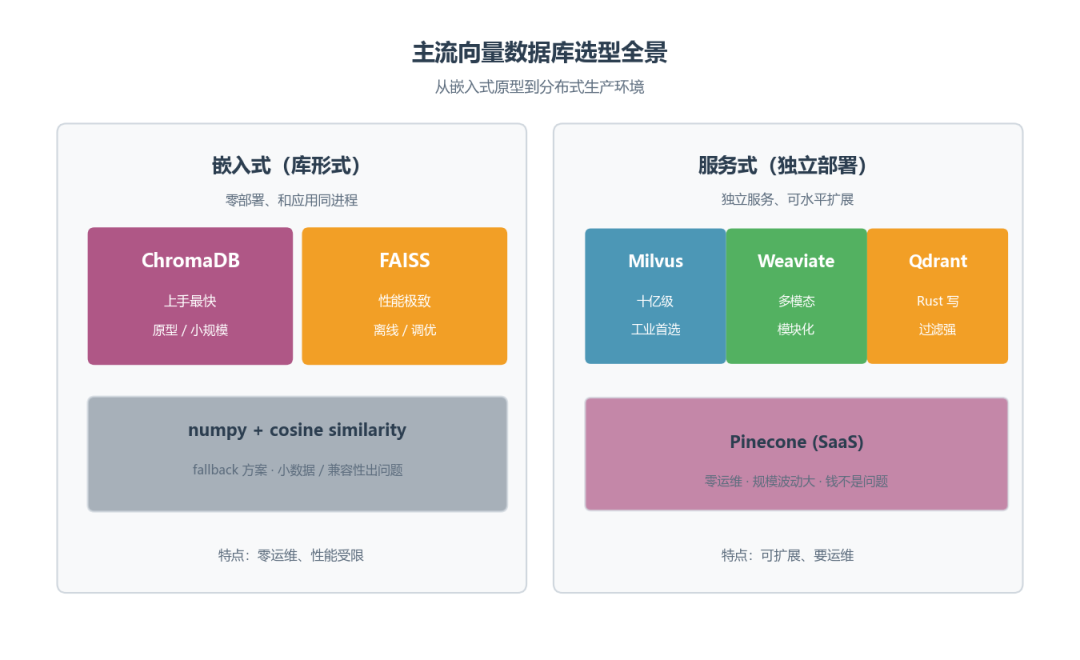
从嵌入式原型到分布式生产环境,向量库大致分成两条路线:ChromaDB、FAISS、numpy 余弦相似度走嵌入式路线;Milvus、Weaviate、Qdrant、Pinecone 走服务式路线。前者零运维,但性能受限;后者可扩展,但要承担运维成本。
六、几个实际教训
1. 评估不能只看能不能跑通。
上线前要做召回率测试,也就是看检索返回的结果里,真正相关文档被覆盖的比例。做法不难:人工标注 50 到 100 个“问题→相关文档”对,跑一遍检索再看命中率。
2. 别死磕出问题的 API。
ChromaDB 0.5.5 和 huggingface-hub 的版本冲突,曾导致 collection.query() 在某些环境里报错。当时因为时间有限,没有继续排查根因,而是绕过 ChromaDB 的查询 API,改用 SQLite 直接读 chroma.sqlite3 里的文档原文,再用 sentence-transformers 加 numpy 余弦相似度完成检索:
# 直接从 ChromaDB SQLite 读文档,不用 query API
cursor.execute(
    """
    SELECT em.string_value, em2.string_value, em3.string_value
    FROM embedding_metadata em
    LEFT JOIN embedding_metadata em2 ON em.id = em2.id AND em2.key = 'law_name'
    LEFT JOIN embedding_metadata em3 ON em.id = em3.id AND em3.key = 'source'
    WHERE em.key = 'chroma:document'
    """
)

# 然后用 BGE 编码 + numpy 余弦相似度做检索
向量库的底层数据,说穿了就是 SQLite 加浮点数数组。绕过 API 直接读取,完全可行。这也是 ChromaDB 这类嵌入式架构与 Milvus 这类独立服务之间的本质区别:嵌入式方案在灵活性上比想象中高得多。
3. Distance vs Similarity。
ChromaDB 返回的 distance 是距离,越小越相似,不是相似度。代码里用 (1 - distance) * 100 把它转成 0 到 100 的相关度分数给前端使用。如果不转换,前端展示的相关度就是反的:用户搜得越准,分数反而越低。
4. Chunk 策略决定上限。
向量检索的天花板往往由 chunk 质量决定,而不是由模型决定。在这个 RAG 项目里,做法是先按“第 X 章”切大段,再按“第 X 条”切小段,每个 chunk 控制在 500 字左右,并保留 50 字重叠。法律文档有清晰的章节结构,按结构切比按字符数滑窗切质量高很多。env_agent 的 init_chromadb.py 实现的就是这个策略:先用正则切章,再切条,合并短段落到接近 500 字,尾部保留 50 字 overlap 传给下一块。
5. 数据量大了之后,元数据过滤比相似度排序更重要。
正确顺序是先做元数据过滤,比如时间、来源、类别,把候选范围缩小,再做向量检索,这个顺序不能反。Milvus、Qdrant 都支持这种 hybrid filter 策略,召回速度和精度都会更好。这一点在百万级以上规模时才明显,原型阶段通常感知不到,但架构设计时就要提前把这层考虑进去。
理解了向量数据库的这层能力之后,它就不再只是某个 RAG 项目里的子组件,而更像是团队可以长期复用的基础设施。对开发者来说,是否理解这一点,往往决定了后续系统扩展时的架构弹性。如果你正在搭建自己的 RAG 或 Agent 项目,可以从 云栈社区的技术课程中进一步了解向量数据库、Embedding 与检索链路的具体实践。
 发表于 1 小时前
|
查看: 3|
回复: 0


