在做 wali_cmd(命令行速查小程序)时,我也犹豫过:139 条数据,需要向量数据库吗?把关键词模糊搜索跑通才确信,不需要。整套搜索没用一行向量代码,只用了 db.RegExp 多字段正则匹配和 popularity 排序。上一篇讲了小程序的整体框架,这篇重点讲讲小程序中「搜索」这一个环节。如果你也在做几百条数据的小程序,希望这篇能帮你省掉一次过度设计。
一、过度设计是怎么发生的
做小程序搜索,第一反应的流程是这样的:
- 项目立项,要做搜索功能
- 网上一搜「小程序 搜索」,大半结果在讲向量数据库
- 看几篇教程,复制粘贴 embedding 代码
- 照着教程申请大模型的 API Key、配置向量数据库、逐条算 embedding 写入
- 做完才发现:搜索延迟高、维护成本高,对几百条数据的小项目纯属杀鸡用牛刀
问题出在第二步。教程一般讲通用搜索方案,但搜索是分场景的。命令速查、单词卡片、通讯录这类「搜什么就是什么」的场景,关键词匹配比向量检索更精准、更便宜、更快。
向量检索的核心价值是语义模糊匹配:用户输入「心情不好怎么说」,能找到「沮丧」「郁闷」「down」。这种查询在小程序搜索里可能占比不到 5%。大部分是「怎么删文件」「查 IP」「找字符串」这类意图明确的查询,用关键词匹配就够。
把少比例(5%)的边缘需求当成主诉求去设计,是过度设计的典型路径。
判断搜索该不该升级,这里的标准是:用户搜 10 次,至少 7 次能找到目标。小数据 + 关键词搜索很容易达到这个标准,向量检索也未必做得更好。
那怎么避免?先定产品目标,再选技术。wali_cmd 的产品目标是「让用户快速找到需要的命令」,关键词搜索就服务这个目标。AI 化是现在的大趋势,但有实打实的成本:API 费用、embedding 计算、向量库运维。想尝试 AI 能力的话,可以先通过 RouteFast.ai 这类模型 API 中转服务低成本接入多家大模型;但对 139 条数据的小项目,这些成本带不来对应的用户价值,把精力花在数据准确性和 UI 流畅度上,回报更直接。往往普通数据库查询就够,没必要为了显得 AI 化硬上向量。
二、139 条数据用 NoSQL 怎么搜
NoSQL 是「非关系型数据库」的统称,和 MySQL 这类关系型数据库相对。关系型数据库要提前建表、写 SQL 查询;NoSQL 把数据存成 JSON 文档,不用建表、不用写 SQL,直接按字段存取。微信云数据库就是一种 NoSQL,wali_cmd 的 139 条命令就存在这种 JSON 文档里。
数据规模:139 条命令(80 Linux + 59 Windows),每条 description 平均 87 字、tags 数组 1~4 个关键词。
查询能力:微信云数据库支持 where + RegExp + orderBy + limit,对结构化字段做正则匹配。
核心代码(云函数 searchCommands/index.js):
async function searchCollection(collectionName, baseCondition, limit) {
  const res = await db.collection(collectionName).where(baseCondition)
    .orderBy('popularity', 'desc')    // 常用命令靠前
    .limit(limit)
    .field({                          // 只返回必要字段,省流量
      _id: true, name: true, category: true, subcategory: true,
      syntax: true, description: true, tags: true,
      popularity: true, platform: true
    })
    .get();
  return res.data;
}
关键词搜索(按 name / description / syntax / subcategory / category 五个字段分别查,合并去重):
const searchFields = ['name', 'description', 'syntax', 'subcategory', 'category'];
const seen = new Set();        // 去重在云函数里做,前端只负责展示
const results = [];

for (const field of searchFields) {
  const c = { [field]: db.RegExp({ regexp: safeRegex, options: '' }) };
  const data = await searchCollection(coll, c, 20);
  for (const item of data) {
    if (!seen.has(item._id)) {
      seen.add(item._id);
      results.push(item);
    }
  }
}

results.sort((a, b) => (b.popularity || 0) - (a.popularity || 0));
return results.slice(0, limit);
类目精确过滤:点击类目按钮时走另一条分支,condition = { category } 直接精确匹配,不走模糊搜索,避免 description 含「网络」的命令被「网络」类目误召回。
整套逻辑没用到任何 embedding、向量数据库、相似度计算。但它解决了 wali_cmd 的所有搜索需求:
- 搜「find」:直接命中(name 字段精确匹配)
- 搜「网络」类目:精确返回该类目下的命令,不被 description 含「网络」的命令误召回
实际请求是同一平台 5 次字段查询(跨平台时 5 字段 × 2 集合 = 最多 10 次),每次按 popularity 排序取前 N 条,云函数内去重后合并。总耗时 150~200ms。搜索是低频操作,用户偶尔查一下,这个量级完全够用。
这套写法不是一次性设计出来的,是真机联调里一步步改出来的。最初想用 _.or 一次查完多个字段,多字段嵌套在真机上不稳定,才改成字段单独查、云函数内合并去重。
召回率 ≠ 查得全。 向量检索的卖点是语义模糊召回,关键词检索的卖点是精确匹配。两者目标不同。对命令速查这类场景,用户搜「删除文件夹」就是想删文件夹,不是想找「清理目录树」这类相关动作。关键词精确匹配的「查得准」比「查得全」更重要。
三、什么时候才需要向量
什么时候才需要向量,以下是经验性的判断标准:
数据规模到 5000 条左右:关键词匹配的召回率开始下降,多个字段查询去重后,真实命中明显变少。长尾查询的召回质量变差。
出现「含义相近、字面不同」的查询:用户搜「手机没声音」,能搜到「听筒失灵怎么办」。这种查询关键词匹配召回率低,向量检索能补上。但前提是这类查询占比超过 10%~20%。第一节说过,多数小程序里这类查询不到 5%,远够不到这个阈值。
多语言 / 跨模态:用户用英文查中文内容,或用图片搜文字,关键词匹配失效,向量检索是唯一解。
用户明确反馈「找不到想要的」:这是最直接的信号。如果用户连续反馈「我搜 xxx 但找不到」,就该考虑升级了。
如果你确实走到了这一步:保留 NoSQL 作为初筛 + 向量作为精排的两阶段架构。不是「扔掉 NoSQL 直接换向量」,而是 NoSQL 先召回一批候选,再用向量重排前 10 条。这样兼顾了关键词的精确性和语义的模糊性。
四、按数据量级决策:可操作的清单
排序权重比搜索算法更关键。 wali_cmd 的搜索体验几乎取决于 popularity 字段(按使用频率手动标注)。find / ls / cd / grep 这种天天用的命令排在前面,用户一眼就能看到最常用的。好的排序权重设计,能弥补搜索算法本身的不足。反过来,再先进的向量检索,如果没有合理的排序权重,搜出来的东西用户还是不爱点。
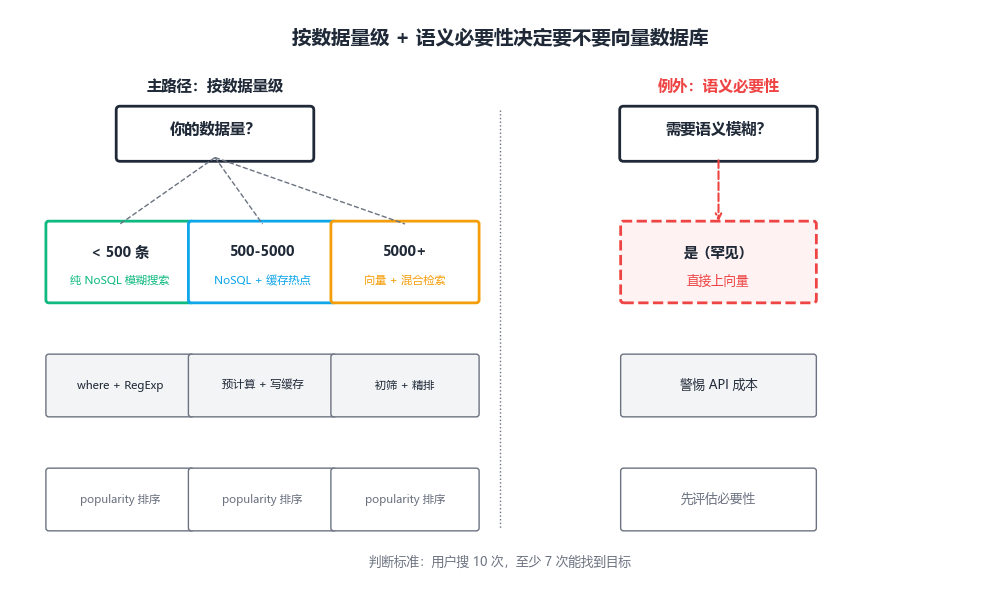
按数据量级 + 语义必要性决定要不要向量数据库的决策树(左:主路径按数据量级;右:例外路径按语义必要性,罕见)
如果你也在做类似规模的项目,按下面的清单逐条对照:
- 数据量 < 500:纯 NoSQL 模糊搜索(
where + RegExp + orderBy),足够
- 500~5000:NoSQL + 缓存热点查询(热门查询结果预计算、写缓存)
- 5000+:向量数据库 + 混合检索
对照这张图,再回看第一节的判断标准:小数据 + 关键词搜索能稳定做到「搜 10 次至少 7 次找到目标」,就说明当前方案够用,先别急着上向量。到底什么时候必须上向量,第三节给了四个判断信号。
回到 wali_cmd,139 条命令,纯 NoSQL 模糊搜索,这套架构至少能撑到 5000 条数据不重构。如果你也在做几百条数据的小程序,先别急着上向量:多数查询关键词就够,用 NoSQL 模糊搜索 + 好的排序权重,把省下的时间花在数据准确性和 UI 上,比堆技术栈更划算。类似的技术实践和讨论,可以到云栈社区一起交流。
 发表于 2 小时前
|
查看: 3|
回复: 0


