核心信息
① 美光判断:存储供不应求将至少持续2年,且目前尚无供需平衡时间表。
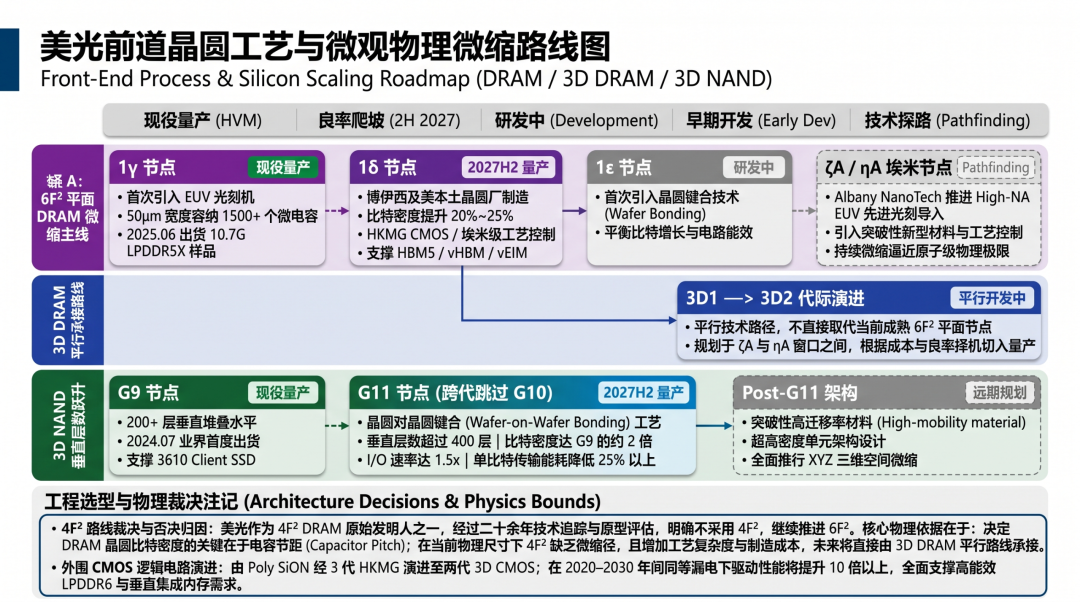
② 美光是 4F² DRAM 原创发明方之一,评估20余年后明确放弃该路线:因受制于电容节距(Capacitor Pitch),4F² 缺乏微缩可行性;平面将继续沿用 6F²,直到 1ζ/1η 节点由 3D DRAM 平行承接。
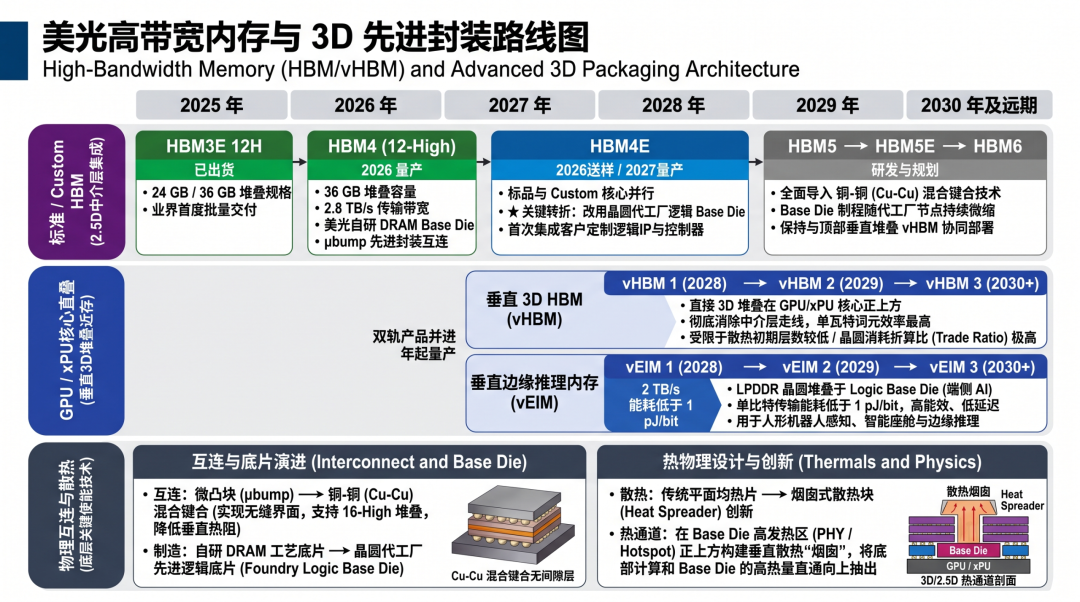
③ 自 HBM4E 起将全线 HBM 的 Base Die 制造转向代工厂(Foundry)先进制程,用于集成控制器并承接 GPU 卸载算力。
④ 垂直 3D HBM(vHBM 1)计划于2028年量产,直接堆叠在计算芯片正上方;但其晶圆折算比(Trade Ratio)极高,将大幅消耗 DRAM 晶圆产能。
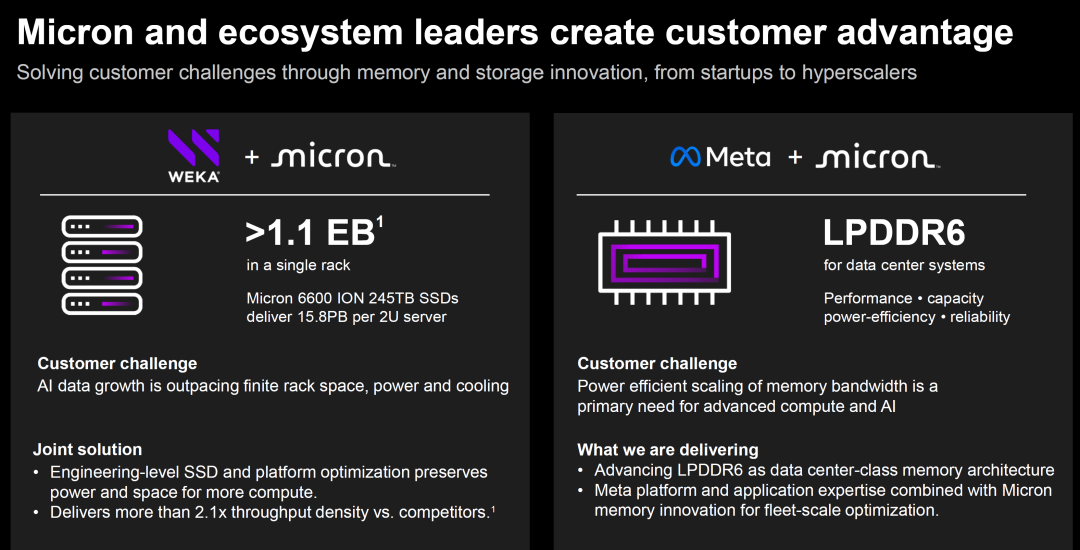
⑤ 联合 Meta 将 LPDDR6 确立为数据中心服务器主存,其能耗较 LP5 降低超 35%;同时规划推出 1TB RDIMM,用于承载大模型活跃上下文。
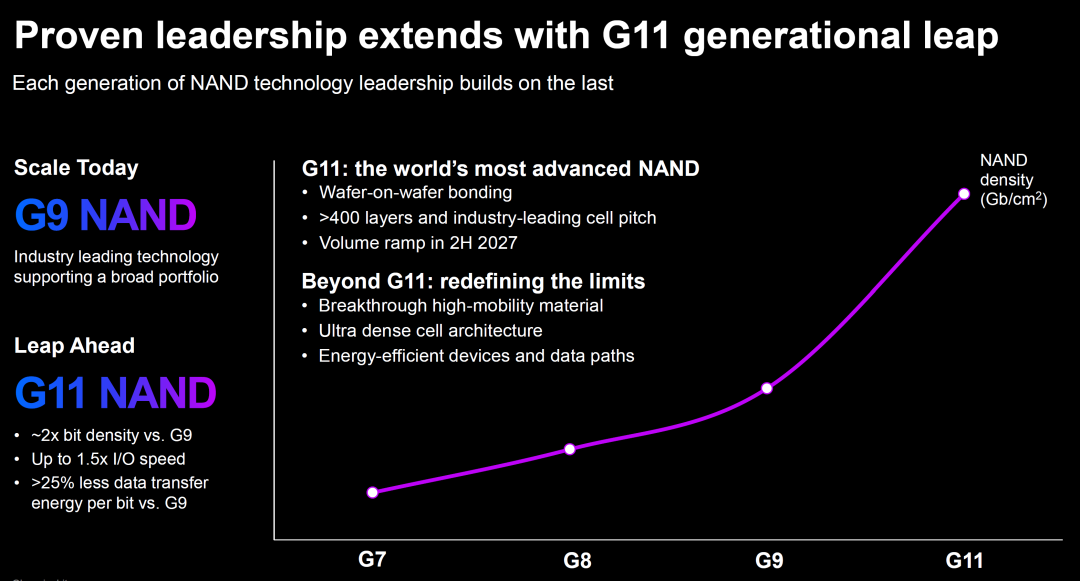
⑥ 计划于2027下半年量产 Gen11 3D NAND(跳过 G10),将首次引入晶圆对晶圆键合(Wafer-on-Wafer),实现 400+ 层堆叠,比特密度较 G9 提升约 2 倍。
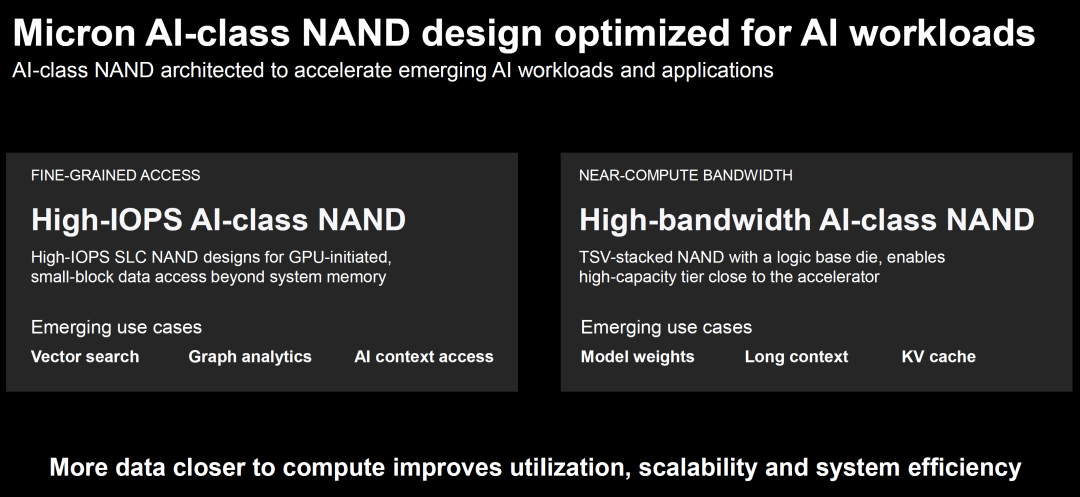
⑦ 规划推出 SLC 架构的 AI-Class NAND(提供 25M–100M IOPS 吞吐),供 GPU 直连存取以分流 KV Cache 与向量检索;同时排除在 GPU 边缘(Shoreline)集成闪存的方案。
⑧ 自动驾驶从 L2+ 演进至 L4+,带动单车 DRAM 需求增加 30 倍(物理 AI 需求普遍增长超 10 倍)。
一、DRAM
技术路线图
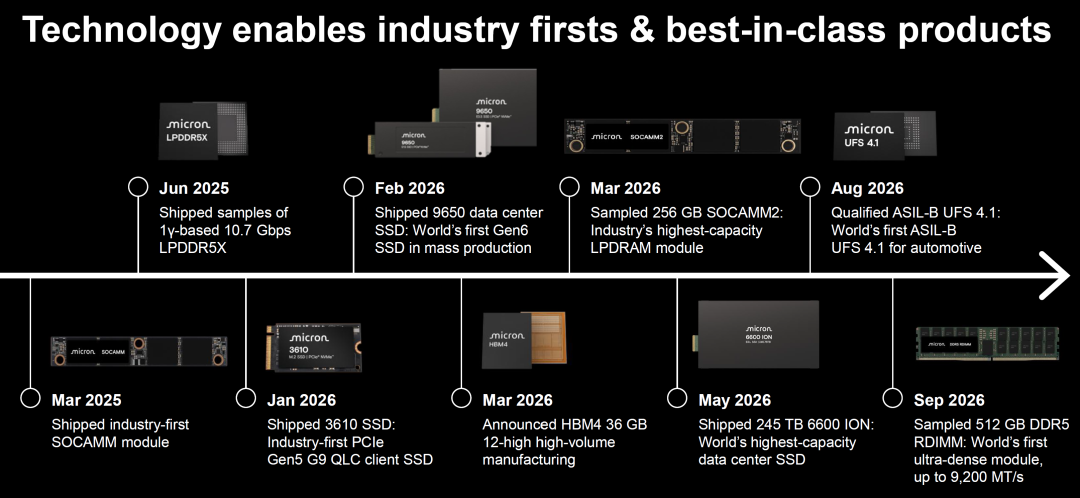
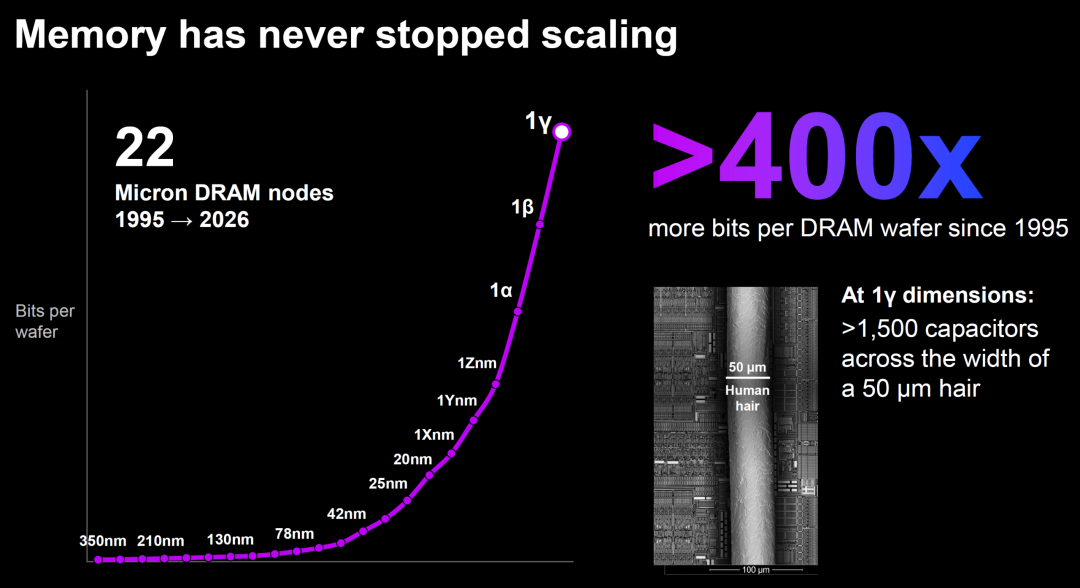
1γ 节点(现役量产主力):首个引入 EUV 的量产节点,在 50 μm 宽度(单根发丝直径)内集成超 1,500 个微型电容;自 1995 年以来单晶圆比特密度提升超 400 倍。2025 年 6 月已送样 1γ 制程 10.7 Gbps LPDDR5X。
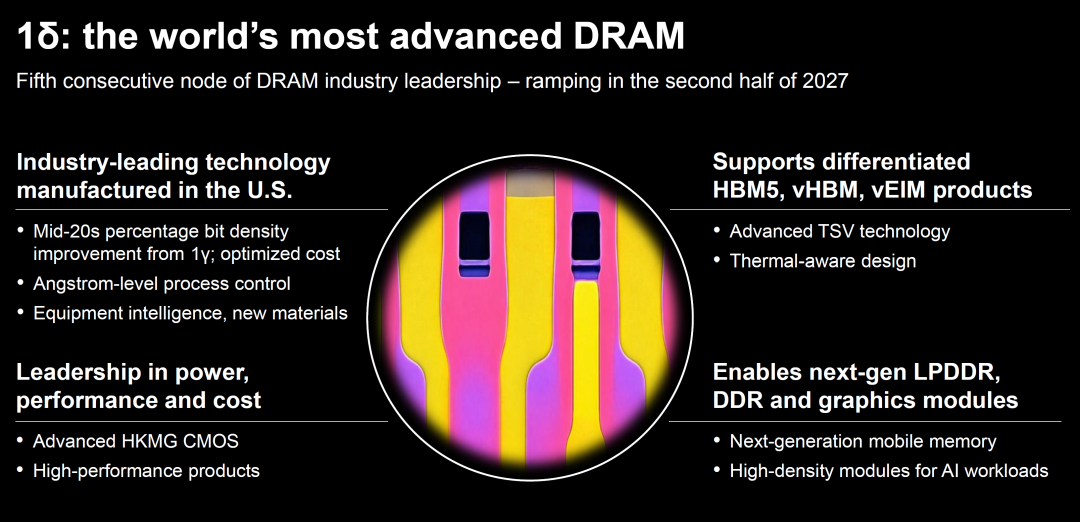
1δ 节点(2027 下半年量产):定于 2027 年下半年在博伊西及美国本土晶圆厂量产,比特密度较 1γ 提升 20%~25%(mid-20s%);引入埃米级工艺控制与高级 HKMG CMOS,用于支撑 HBM5、vHBM 与 vEIM。
1ε 与埃米级(ζA / nA):1ε 节点正式引入晶圆键合(Wafer Bonding);ζA 与 nA 埃米节点处于早期 Pathfinding 阶段,将联合 Albany NanoTech 导入 High-NA EUV 与新型材料。
4F² 结构裁决与 3D DRAM 规划
否决 4F² 路线:美光是 4F² DRAM 的发明人之一,在经过二十余年持续评估与原型验证后,明确决定不采用 4F²,继续沿用 6F²。核心物理依据:决定 DRAM 晶圆比特密度的核心瓶颈是电容节距(Capacitor Pitch),底层晶体管均需适配该节距,4F² 未能提供实际密度收益,反而增加了工艺复杂度与成本,且在当前节点之后缺乏可行微缩路径(No viable scaling path)。
3D DRAM 切入窗口:3D DRAM(规划 3D1、3D2)作为平行研发路线,计划在 1ζ 至 1η 节点之间,结合成本与性能成熟度择机切入量产。
外围逻辑与总线接口
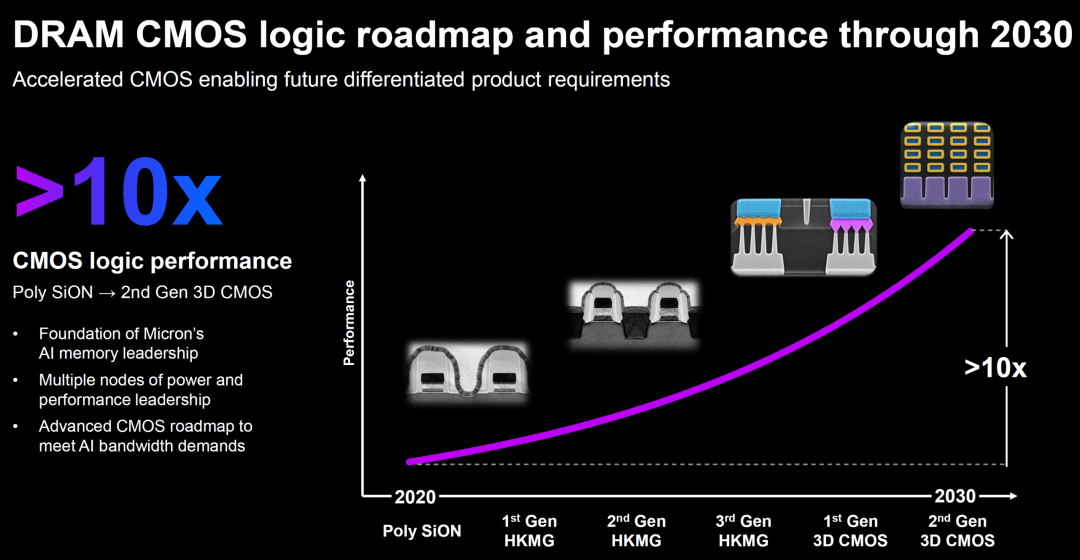
CMOS 性能演进:外围逻辑历经 Poly SiON、三代 HKMG,规划迈向两代 3D CMOS,目标在 2020–2030 年间将同等漏电下的驱动性能提升 10 倍以上。
高密度 RDIMM:已送样 512 GB DDR5 RDIMM(9,200 MT/s),后续规划 1 TB 规格承载大模型活跃上下文。
LPDDR6 与 DDR6:联合 Meta 制定数据中心级 LPDDR6 规范,能耗较 LP5 降低 35% 以上;服务器级 DDR6 带宽较 DDR5 提升 2 倍以上。2026 年 3 月已送样 256 GB SOCAMM2。
二、HBM 与先进封装
HBM4 / HBM4E 代际与 Base Die 转型
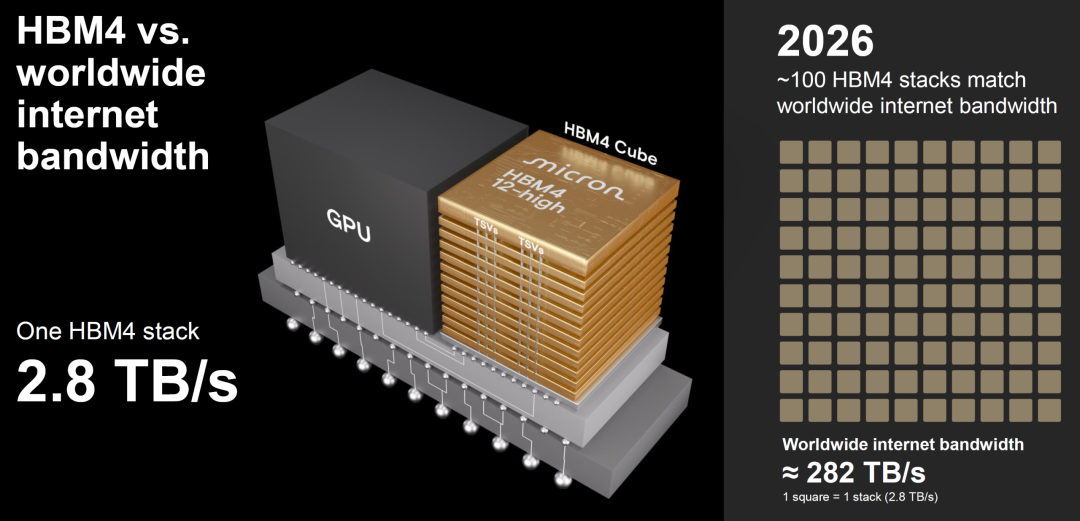
HBM4 规格:12-High、36 GB 已高量产,单 Stack 传输带宽达 2.8 TB/s(约 100 个 HBM4 Stack 累计带宽相当于全球互联网总带宽 282 TB/s)。
Base Die 转向晶圆代工:自 HBM4E 起,标准品与 Custom HBM 并行;Base Die 全面转向代工厂先进逻辑制程,用于集成客户定制逻辑 IP、内存控制器或卸载计算单元。
垂直 3D 集成架构(vHBM 与 vEIM)
垂直 3D HBM(vHBM):将 HBM 直接 3D 堆叠在 GPU/xPU 核心正上方,消除 Interposer 水平走线,极大缩短互连距离,最大化单瓦特词元产出;受限于散热,初期堆叠层数较低,系统方案采用"外围 HBM5E + 核心顶部 vHBM"协同部署。由于 I/O 密度激增,其 Trade Ratio 极高,将大幅增加晶圆消耗。
垂直边缘推理内存(vEIM):面向边缘端,将 LPDDR 堆叠于集成 Logic/PHY 的 Base Die 上,提供 2 TB/s 带宽与低于 1 pJ/bit 传输能耗;相比在 DRAM 内部嵌入计算单元的传统 PIM,vEIM 具备更高的有效带宽上限与定制灵活性。
封装互连与热设计
铜-铜(Cu-Cu)混合键合(Hybrid Bonding):突破微凸块(μbump)节距极限,消除芯片间隙以降低接触热阻,全面支持 16-High 垂直堆叠。
烟囱式散热块(Heat Spreader):在 HBM 晶圆堆侧方、正对 Base Die 发热热点(Hotspot/PHY)上方设置导热块,构建垂直散热烟囱以降低垂直堆叠热阻。
三、NAND 与 SSD
Gen11 3D NAND 工艺跨越
制造与层数:跳过 G10 命名,2027 年下半年量产;采用晶圆对晶圆键合(Wafer-on-Wafer Bonding),堆叠层数超过 400 层。
性能参数:较 G9 比特密度提升约 2 倍,I/O 速度提升最高 1.5 倍,单比特数据传输能耗降低 25% 以上。后续节点规划导入高迁移率新材料推进 XYZ 三维缩放。
AI-Class NAND 架构
High-IOPS AI-Class NAND:基于 SLC 小数据块架构,提供 2,500 万至 1 亿(25M–100M)IOPS,专供 GPU 直接存取,用于 KV Cache、向量检索与图分析。
High-Bandwidth AI-Class NAND:采用 TSV 堆叠 NAND 配合 Logic Base Die,紧邻加速器部署,作为近计算存储层承载模型权重与长上下文。
大容量数据中心 SSD
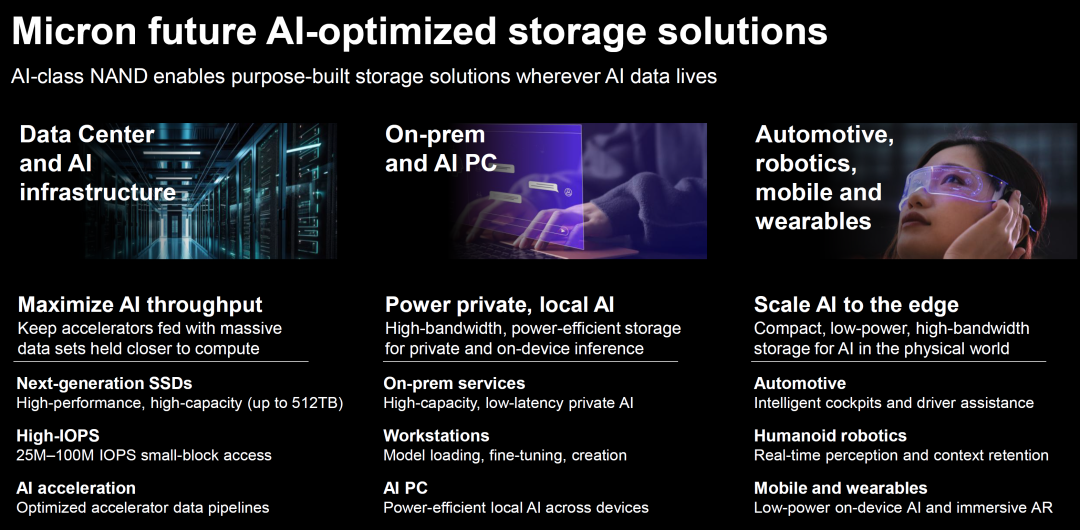
PCIe Gen6 9650 系列已量产(2026 年 2 月);245 TB 6600 ION 已出货(2026 年 5 月);后续高性能路线规划单盘容量提升至 512 TB。
四、边缘与物理 AI
车载安全存储:L4+ 自动驾驶单车 DRAM 需求达 L2+ 的 30 倍(物理 AI 整体需求提升 10 倍以上);2026 年 8 月通过业界首款车规级 ASIL-B 认证的 UFS 4.1 验证,专供智能座舱与 ADAS 边缘感知。
端侧模组形态:256 GB SOCAMM2 为 AI PC 与工作站提供高密度支撑;vEIM 与低功耗 LP6 专供人形机器人、可穿戴设备实现低延迟本地推理。
五、研发与规划
AI 工具链研发提速(开发周期压缩 50%~60%)
SSD 控制器研发:引入 AI 智能体 RTL 生成与验证、生成式 AI IP 移植、AI 根因分析及物理设计,从设计到流片(Tape-out)耗时缩短 50%。
SSD 整机工程交付:通过 AI 生成固件、智能测试选择与测试覆盖率智能体,产品达到客户交付状态的用时缩短 60%。
远期研发资本配置
Micron Ventures:资本承诺达 5.5 亿美元,围绕 AI 技术栈展开生态协同(如与 Liqid 合作)。
Albany NanoTech / NY CREATES:面向 5–10 年技术视界,针对 DRAM 推进 High-NA EUV 光刻工艺与设备验证。
Micron Research Labs:规划未来 10 年投资 100 亿美元设立全美首个专用内存研究中心,承接 10 年期以上的半导体物理与前沿计算架构预研。
会议实录摘要
以下内容根据美光科技"技术与产品领导力投资者研讨会"发言实录整理。会议主讲人为美光执行副总裁兼首席技术与产品官 Scott DeBoer 博士。
开场与战略背景
Scott DeBoer 指出,AI 正在彻底重构计算范式。AI 下一阶段的胜利,必须依靠内存、存储与算力的同步协同突破来实现。美光在带宽、容量、能耗效率与可靠性上全面领跑。除了产品研发,AI 也在全方位赋能工程团队的研发创新与项目执行能力——从基础物理模拟、芯片设计,到生产工艺偏差控制与全流程智能制造,美光在全生命周期开发中落地 AI 工具的能力均处于行业领先地位。
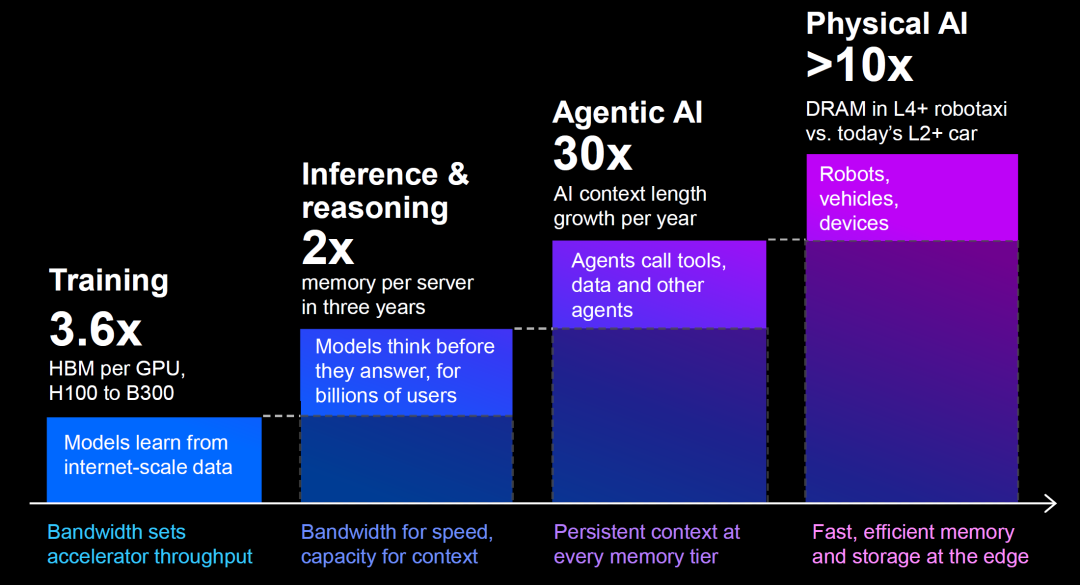
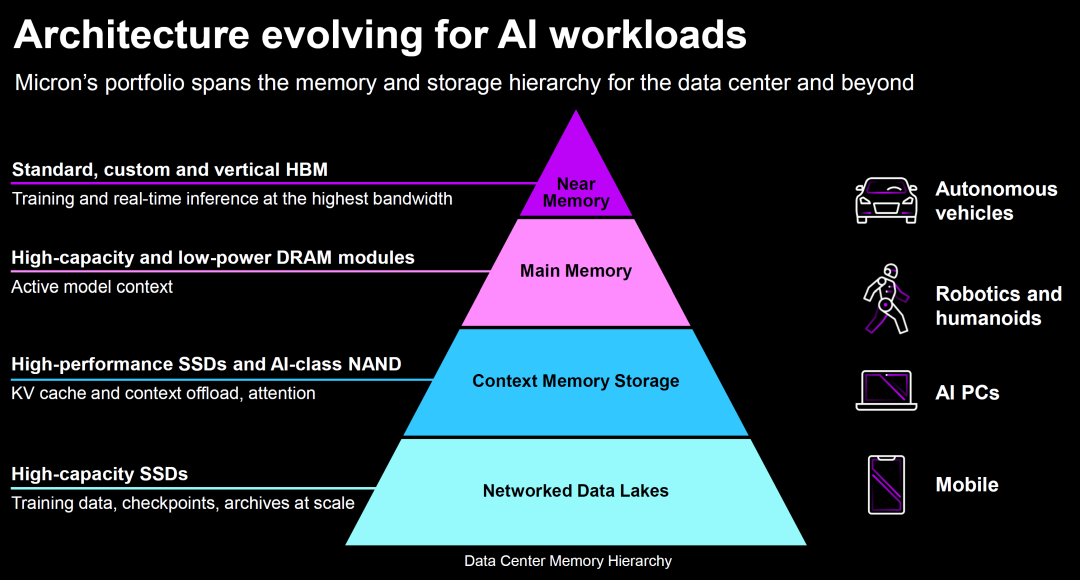
美光的产品组合覆盖全场景:从标准 HBM 到定制化 HBM,再到垂直集成 HBM(Vertical HBM);DDR 内存模组与低功耗 LPDRAM 在数据中心算力集群中同样不可或缺。终端侧,自动驾驶汽车、具身机器人、AI PC 与智能手机都在全面融入 AI 能力,对存储技术提出了差异化的物理要求。
行业里程碑
美光在业内率先将 LPDRAM 技术引入服务器生态,基于 LPCAMM 架构的 SOCAMM2 模块已成为该细分赛道的核心增长引擎。在数据中心 SSD 方面,美光率先实现了 PCIe Gen6 企业级 SSD 的量产落地。HBM4 目前已全面实现大规模晶圆量产,良率爬坡顺利。高密度 RDIMM 方面,美光近期已正式向客户送样单条 512 GB DDR5 RDIMM,这是全球首款达到该容量级别的商业化内存条。
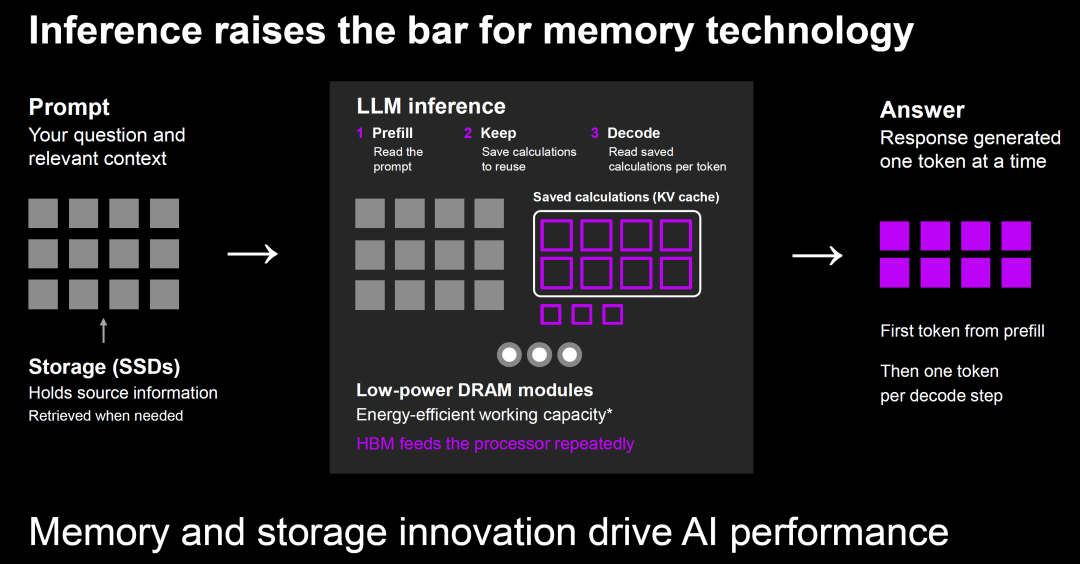
存储在 AI 推理中的核心作用
以一个基础的 Prompt 为例:提示词输入后,文本信息被加载至 DRAM,长上下文背景与检索数据从数据中心 SSD 调取;大语言模型推理引擎读取 Prompt,利用低功耗 DRAM 兼顾大容量与超高能效比;随后系统经历密集的 KV Cache 存取与矩阵计算,数据在 HBM 与 GPU 核心之间以极高吞吐量频繁交换,最终以词元为单位逐一 Decode 吐出答案。这些词元全程驻留在内存中,内存系统的响应速度是决定系统吞吐与时延表现的核心瓶颈。
DRAM 历史微缩与 1γ 节点
从 1995 年至今,美光已经跨越了 22 个 DRAM 技术节点,目前演进至 1γ(1-gamma)节点。这是业界首屈一指的高良率、高产能领先工艺。自 1995 年至今,美光 DRAM 晶圆上的每平方毫米比特密度提升了约 400 倍。在 1γ 节点下,一根人体头发丝的截面直径内可以并排容纳超过 1500 个 DRAM 微型电容器。
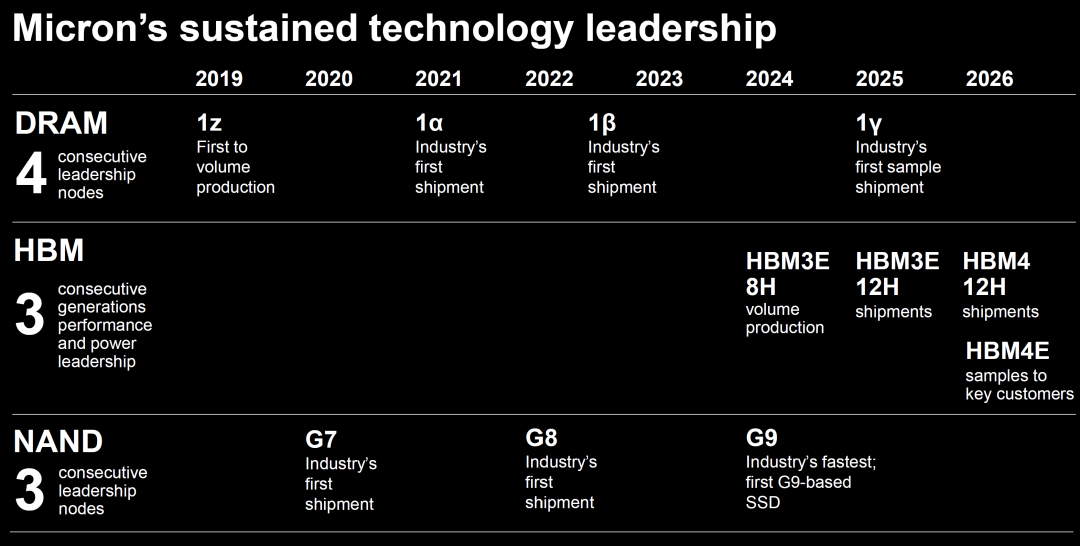
美光达成了连续四代 DRAM 节点领跑行业、连续三代 HBM 产品能耗比领先,以及 3D NAND 从 G7 到 G9 连续三个代际的技术领先。
HBM4 性能对比
单颗 HBM4 堆叠芯片能提供高达 2.8 TB/s 的显存带宽。作为对比,当前全球互联网实时骨干总带宽大约是 282 TB/s。大约 100 颗美光 HBM4 芯片的总带宽,就足以匹敌整个人类互联网的吞吐体量。
DRAM 技术路线图与 4F² 裁决
平面 2D DRAM 架构已持续微缩数十年,目前正逼近原子级物理极限,但美光有绝对把握在现有平面架构上再推进数个先进制程节点。美光的战略是确保在成本模型与性能收益最平衡的黄金时间节点,再正式商用导入 3D DRAM 架构。
1γ 节点目前已全面步入晶圆量产阶段,是美光历史上首次全面导入高产能 EUV 光刻机台的工艺节点。紧随其后的 1δ(1-delta)节点计划于 2027 年下半年正式爬坡量产。1ε(1-epsilon)节点将创新性地引入晶圆级键合(Wafer Bonding)技术。前沿探索层面,1ζ(1-zeta)埃米级节点以及更远期的 1η(1-eta)埃米级制程将导入 High-NA EUV、新型互连材料与开创性制造工艺。
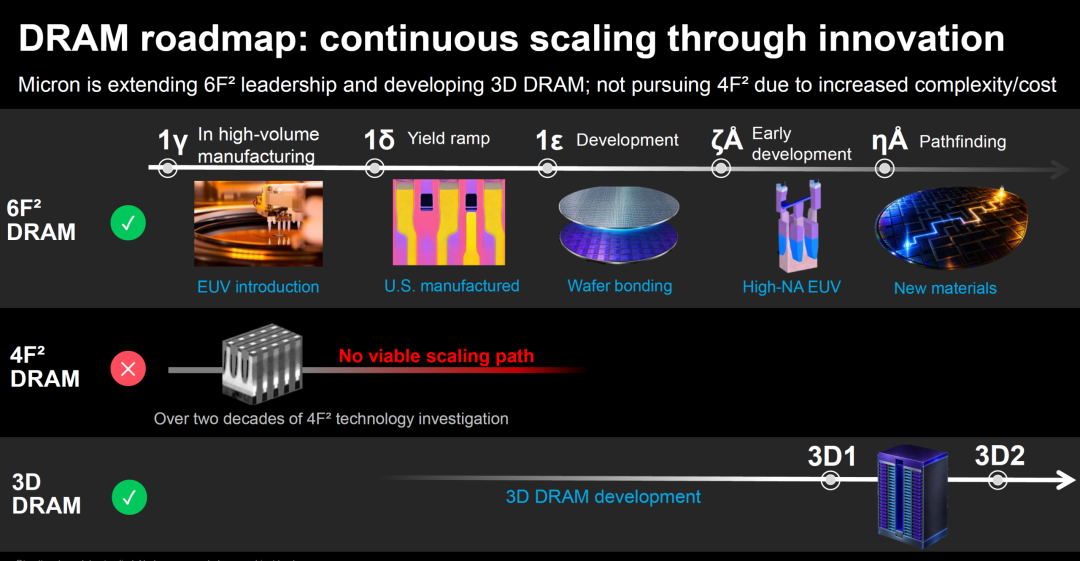
关于 4F²:美光正是 4F² DRAM 最初的发明者,过去二十年间进行了极为深入的底层物理与制造可行性评估。之所以没有选择量产推进,核心原因在于:
- 4F² 架构在演进数个节点后会迅速触碰物理天花板,长期微缩潜力不可行。
- 行业对于什么决定 DRAM 每晶圆比特密度存在认知误区。真正锁死 DRAM 晶圆比特密度上限的是微型电容器的间距(Capacitor Pitch)、微观物理体积与电容纵横比,而不仅取决于外围晶体管排列是 6F²、4F² 还是 8F²。所有先进工艺的本质都是围绕电容器间距的微缩极限制定微影方案。
3D DRAM 作为独立并行研发管线,商业化量产的窗口期将取决于技术就绪度与产品 ROI 的战略决策。
1δ 节点详情
1δ 节点预计是美光连续第五个领跑行业的旗舰制程节点,计划于 2027 年下半年全面启动量产爬坡。它将带来 20% 至 30% 区间的每晶圆比特密度跃升,针对美光下一代 HBM5、Vertical HBM 以及 Vertical EIM 进行深度物理优化。
DRAM 外围 CMOS 演进
DRAM 外围逻辑电路(CMOS Logic)是美光过去几年构筑差异化性能的护城河。在单一存储制程内,美光会针对不同终端应用衍生出多个客制化外围 CMOS 变体。从 2020 年到 2030 年,在同等漏电流约束下,外围 CMOS 的晶体管驱动电流性能提升了接近 10 倍,并将逐步引入多代 HKMG 与 3D CMOS 垂直逻辑架构。
下一代 DRAM 产品
LPDDR6:美光芯片设计团队的巅峰之作。相比 LPDDR5/5X,LPDDR6 实现了 35% 以上的功耗骤降,在特定超高密度规格下节能幅度更显著。LPDDR6 不仅将统治高端移动终端,更将在超大规模数据中心服务器的 Scale-Out 架构与异构算力池化中扮演关键角色。
DDR6:DDR6 将带来相较于 DDR5 翻倍(2 倍)的极致峰值带宽。
高密度 RDIMM:已送样单条 512 GB RDIMM,下一代将直接推出单条 1 TB RDIMM。
HBM 演进:从标准到定制到垂直
HBM 技术正从标准品架构稳步迈向定制化 HBM(Custom HBM)。未来标准型与定制型 HBM 将在 AI 产业生态中长期并行。美光将客户的专用逻辑 IP 与美光的存储控制 IP 无缝融合到底部 Base Die 中。
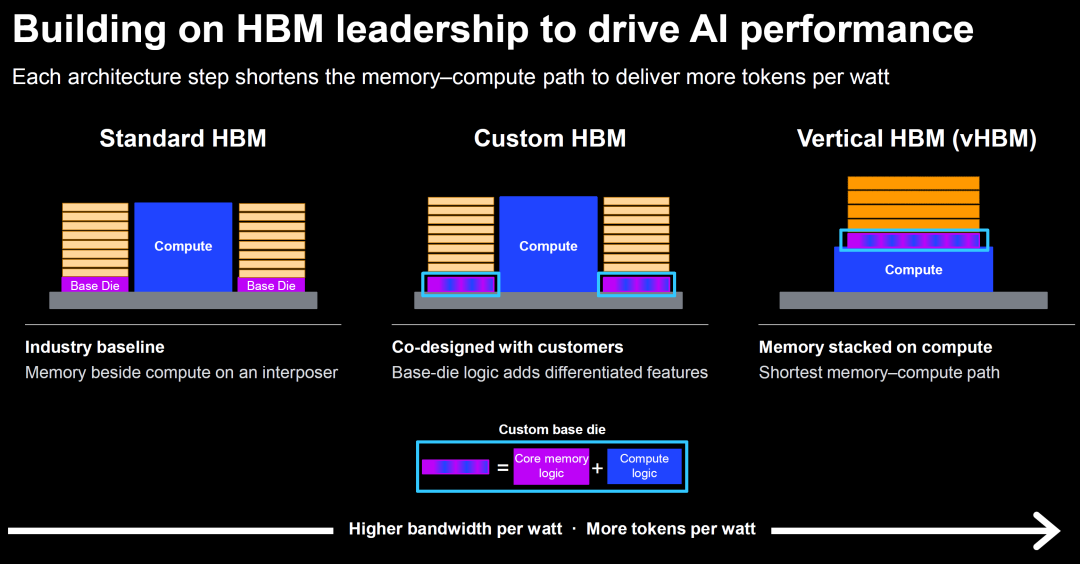
垂直集成 HBM(Vertical HBM,即 vHBM)将存储晶圆直接通过先进垂直封装,原生堆叠在 XPU 计算核心正上方,打破传统片上封装的布线距离极限。混合键合(Hybrid Bonding)技术是美光重兵投入的战略高地——不采用混合键合,就无法在物理层面制造出跨入特定带宽量级的下一代存储产品。
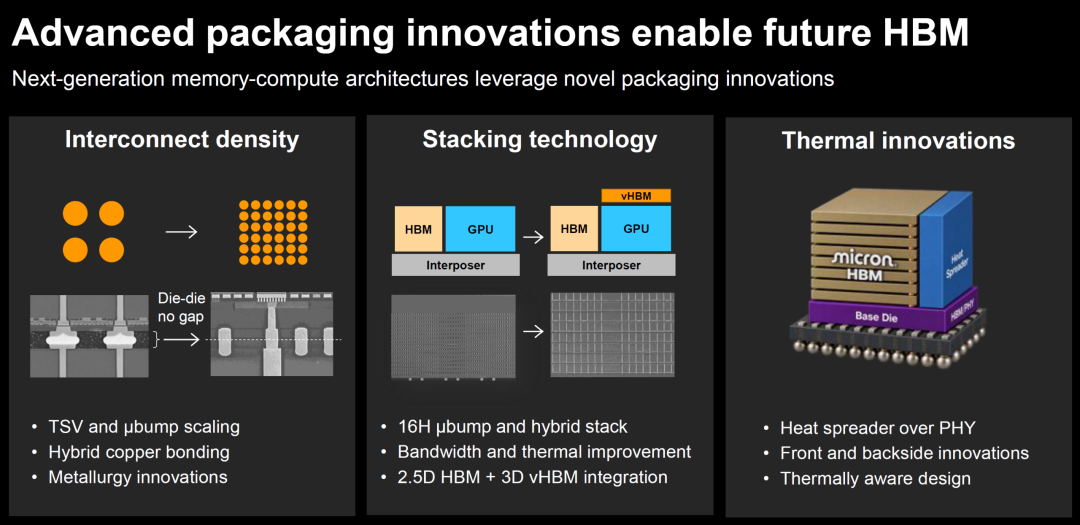
16-Hi 超高层数 HBM 堆叠中,混合键合不仅在互连带宽与传输引脚密度上拥有决定性优势,在芯片立体热传导性能上更是带来质的飞跃。
热管理与 vHBM/vEIM 对比
在垂直 HBM 架构下,热量不仅来自底部的逻辑 Die,更来自其下方全速运转、功耗高达数百瓦乃至上千瓦的 XPU 计算核心。美光已落地一项创新:在 HBM 芯片堆叠内部、针对底部逻辑 Die 热源最集中的核心热点,原生植入超导热散热结构——相当于在 HBM 内部开辟了一条将底层核心热量快速导出至散热顶盖的垂直热烟囱。
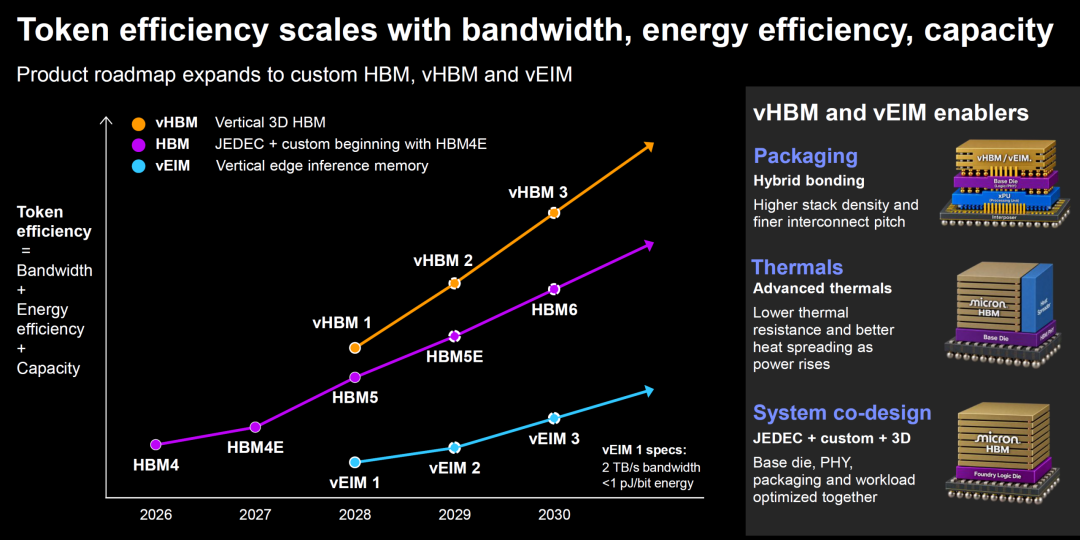
垂直 EIM 对整机待机能耗与动态功耗具有极高敏感性,完全针对边缘设备的能耗预算量身定制;而垂直 HBM 则为极致算力而生,以峰值带宽为绝对研发取向。
NAND 路线图与 Gen11
Gen11 NAND 是一次断代式技术跨越:每平方毫米比特密度直接翻倍,IO 传输接口速率提升 1.5 倍,数据吞吐过程中的每比特能耗大幅压低。Gen11 完全基于晶圆级对准键合(Wafer-to-Wafer Bonding)工艺打造,垂直微缩堆叠层数将一举突破 400 层物理大关,计划于 2027 年下半年启动大规模量产爬坡。
AI-Class NAND 双轨战略
超高 IOPS 的 AI 级 NAND:原生 SLC 微观架构与极小物理块(Small Block)设计,专用于亚微秒级超低时延的极速存储,承载海量高并发小 I/O 检索。
超高带宽 AI 级 NAND:TSV 立体堆叠 NAND 芯片配合底层高速逻辑基片,部署在距离主算力核心物理距离极近的关键互联拓扑节点。美光明确排除将 NAND 堆叠在 GPU 物理边缘海岸线的方案——经过系统测算,那样做在系统延迟与能耗上毫无工程价值。
客户协同案例
Liqid 合作:美光通过风投基金早期战略领投 Liqid,随后深化为产业级战略合作伙伴。
Meta 合作:美光与 Meta 联合发布了数据中心下一代 LPDDR6 行业白皮书,将 LPDDR6 这一源自移动端的低功耗架构成功引入超大规模数据中心计算架构,攻克了服务器级高 RAS 特性、超高硬件可靠性与 LPDDR6 极速能效的系统级融合优化。
AI 加速研发
美光深度利用 AI 智能体全自动生成底层固件代码、执行自动化的硬件根因分析(Root Cause Analysis),并由智能体主导承担产品物理可行性验证的核心预研。数据中心自研主控芯片从纯硅级物理设计到最终 Tape-Out 流片的速度提升了 2 倍(耗时缩短 50%);数据中心企业级 SSD 端到端研发周期砍掉了 60%。
问答要点
关于存储成本占比:在任何给定的硬件计算系统中,增加存储物理容量并提高存储数据带宽,整个系统所能释放的端到端吞吐能力会以非线性幅度跃升。存储始终是决定 AI 大模型推理吞吐与 Agent 系统智能上限的核心瓶颈。
关于 4F² 争论:业界认为 4F² 相较于成熟的 6F² 架构能在晶圆密度上提供质的突破,这在物理层面上是一种行业误读。4F² 的极限微缩在底层物理与电气隔离上存在无法解决的硬伤,全行业最终必然会直接跨入真正的 3D DRAM 时代,而不是在 4F² 的死胡同里无谓徘徊。
关于 Base Die 转向代工厂:在 HBM4 时代,美光完全依靠内部精湛的 DRAM 工艺跑通了 Base Die,并不强制需要先进制程逻辑工艺。但演进到 HBM4E 时代,极端的数据吞吐速率与近存能效优化已在物理层面强制要求 Base Die 迁移至更先进的逻辑 CMOS 工艺。垂直 HBM 架构中,Base Die 采用先进逻辑节点不仅是刚需,且将承载高速中继与系统管理逻辑。
关于 vEIM 与 PIM 对比:存内计算(PIM)路线能承载的算力规模极其受限,且会大幅扰乱原本精密的存储阵列电气平衡。垂直集成边缘推理内存(Vertical EIM)所能榨取出的真实计算吞吐与有效带宽,远碾压传统 PIM 所能企及的极限。从亚皮焦每比特(Sub-pJ/bit)的极端低功耗区间,到逼近数据中心 HBM 量级的性能怪兽,美光可以在这一性能与能耗的光谱区间内进行任意维度的定制开发。
关于 vHBM 的带宽优先:vHBM 立项与存在的唯一根本支点就是带宽。在把存储直接堆在数千瓦核心热源 GPU 头顶的同时,盲目堆砌海量存储容量的工程难度将呈指数级倍增。最优形态是将外围主打大容量池化的高性能 HBM5E、与核心正上方主打极限并发吞吐的垂直 HBM 深度异构并联。vHBM 对前端晶圆产能的消耗是成倍放大的,这是半导体工程与商业博弈中必须精确平衡的关键杠杆。
关于供需格局:在未来两年内,整个半导体存储行业将持续处于结构性供不应求的失衡状态,短期内看不到供需天平重回宽松的可能。
美光当前正处于公司历史上综合技术壁垒与旗舰产品竞争力的最巅峰。支撑全线颠覆性硬件产品的先进制程底层技术,是美光无与伦比的核心护城河。
下载官方PPT:https://s25.q4cdn.com/621799436/files/doc_downloads/2026/10/MU-TP-Webinar.pdf
 发表于 2 小时前
|
查看: 10|
回复: 0


