亚马逊仓库中堆积的GB300机架,并非“算力过剩”的证据,而是AI基础设施竞赛中最具讽刺意味的结构性断裂——资本以芯片的速度向前冲刺,却被电网以年为单位的时间尺度死死按住。稀缺的从来不是GPU本身,而是“通电的GPU小时”;积压的也从来不是需求,而是将需求转化为供给所需的物理条件。这一断裂的代价,正在以自由现金流转负、资产隐性折旧和终端算力租金上涨的形式,被逐层分摊。
一、积压的规模与财务后果:付款在前,通电在后
据Business Insider获得的亚马逊内部文件及员工会议录音,AWS正将英伟达GB300机架暂存于“中间仓库”,直接原因是目标数据中心“有空间容纳更多机架,但没有足够的可用电力将其开机”。仅2026年8月,AWS就预计接收约50亿美元的GB300机架,此后每月持续接收约30亿美元,并在“可预见的未来”维持这一节奏。至少一个AWS供应链团队对于“如何将机架送入数据中心”缺乏“清晰的预测路径”。
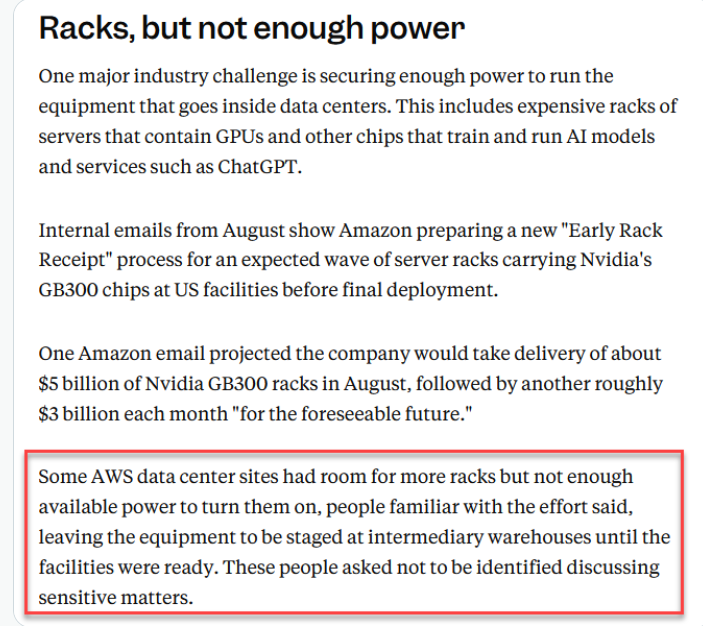
这一局面的财务代价,因一项名为“提前收货”(Early Rack Receipt)的流程而被急剧放大。按照AWS此前的惯例,付款发生在设备实际安装至数据中心之后,在途设备的资金成本由供应商承担。但新的流程使AWS在机架抵达数据中心之前便取得所有权并支付款项——在争夺英伟达GPU配额的竞争中,锁定硬件优先于锁定电力,因为“如果不在有安装位置之前抢先下单,硬件就可能被竞争对手截获”。其直接后果是:现金已经流出,而资产尚未产生任何收入。安装每延误一个月,就多一个月为一项零收益资产支付资本成本。
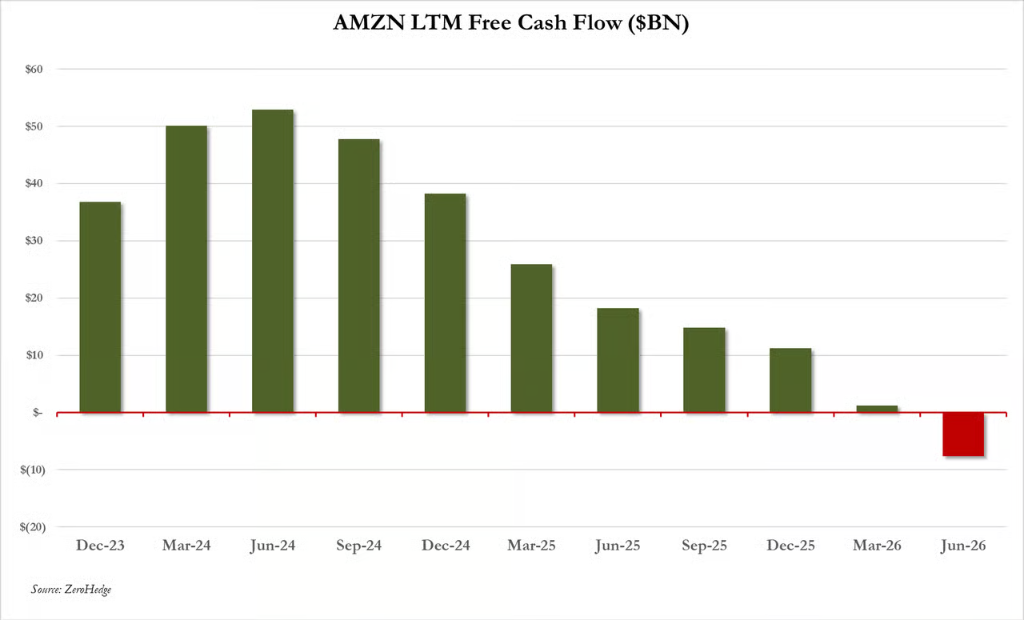
财务数据已经将这一逻辑的代价清晰地呈现出来。亚马逊自由现金流从2024年第一季度约500亿美元,骤降至2026年第一季度约10亿美元,到2026年第二季度进一步转为负76亿美元。在2026年9月的内部会议上,AWS首席财务官John Felton对负责AI基础设施的高管Prasad Kalyanaraman直言:“你让我们公司的自由现金流转负了,恭喜。”Kalyanaraman没有反驳,并确认自由现金流预计将在“未来几年左右”持续为负。亚马逊2026年全年资本支出预计达到创纪录的2200亿美元,接近2022年全年资本开支的四倍,在所有大型科技同业中居首。
二、电力瓶颈的实质:不是“电不够”,而是“电来不及”
将问题简单概括为“美国缺电”,会错失瓶颈的真正性质。高盛的研究将当前制约概括为四个“T”——涡轮机(turbines)、变压器(transformers)、输电(transmission)与技术工人(tradespeople)。这是一条供应链与工程时间尺度的问题,而非一次能源总量的问题。
设备交期是最硬的约束。大型电力变压器的交付周期已拉长至最长128周,发电机升压变压器达144周,重型燃气轮机从下单到商业运行需要五到七年。研究机构MSI Economics的测算显示,2026年至2027年间计划交付的12至16吉瓦数据中心相关容量中,实际处于施工阶段的仅约5吉瓦。换句话说,即使所有已宣布的项目都顺利推进,物理设备的制造与交付能力本身就在系统性地推迟“通电”的时间表。
并网排队则是另一重时间壁垒。在美国,数据中心接入电网的平均等待时间为一到三年,而在部分欧洲市场,并网排队已排至2030年代,亚马逊高管披露欧洲新建数据中心的电网接入等待时间长达七年。全球范围内,包括数据中心在内的超过2500吉瓦项目滞留在电网连接队列中。并网时间“已成为亚马逊数据中心投资的最大决定因素之一”,这意味着芯片采购的节奏与电力可用性的节奏遵循两套完全不同的时钟。
人力短缺进一步收紧了时间窗口。Kalyanaraman在内部会议中透露,亚马逊在西德克萨斯州因管道工和电工短缺,不得不自建工人住宿区,供施工人员在项目完工前的两到三年内就地居住。伯恩斯坦的判断是准确的:“电力许可、冷却系统、电气设备、施工和硬件各自按不同节奏推进,时机难以完美契合”。芯片可以在数月内从英伟达的产线抵达仓库,但一个数据中心从获得电力许可到真正通电,是以年为计量单位的。
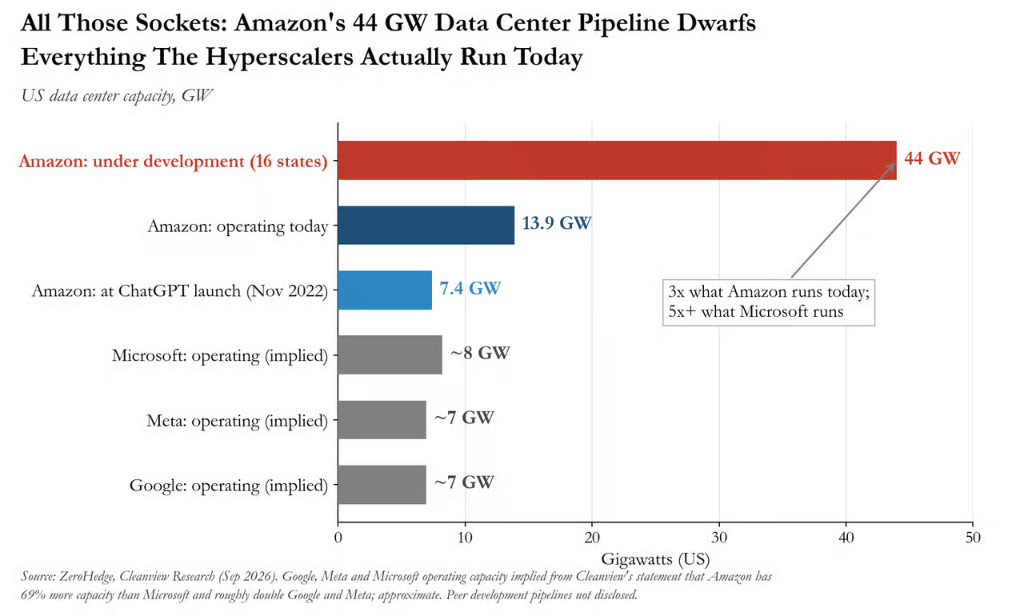
在这一约束下,亚马逊的开发规模反而放大了时间错配的暴露面。Cleanview Research数据显示,亚马逊在全美16个州拥有44吉瓦的数据中心容量正在开发中,是其现有13.9吉瓦运营规模的三倍以上;而这13.9吉瓦已是业内最大规模,比微软多69%,约为谷歌和Meta的两倍。AWS内部甚至设有名为“Secured Power at Risk”(受威胁的已保障电力)的仪表盘,追踪输电瓶颈与“用则保留、弃则失去”条款——一旦项目错过里程碑,亚马逊可能失去已获得的电网配额。Kalyanaraman曾于2023年向CEO Andy Jassy承诺AWS将在2027年前走出产能紧张,如今公司预计2027年需求仍将超过可用产能。
三、“提前收货”与SPV:资本结构在时间错配下的应激反应
“提前收货”流程的本质,是将芯片的采购周期与电力的可用周期之间的错位,转化为资产负债表上的现金流出前置。而2026年10月曝出的80亿美元SPV交易,则是对同一错位的进一步金融化回应。
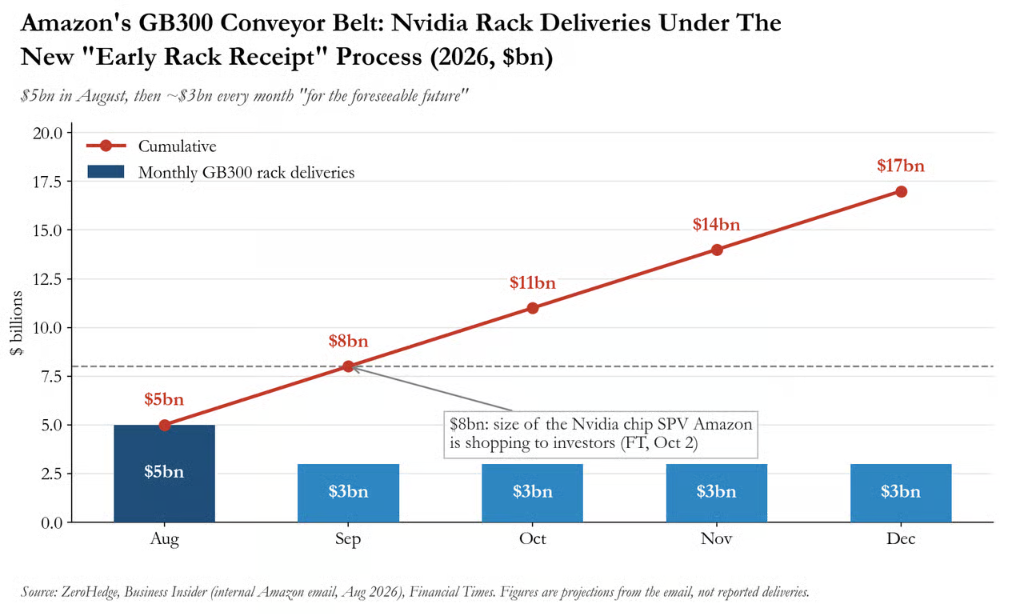
据英国《金融时报》报道,亚马逊计划通过一个特殊目的载体(SPV),将价值约80亿美元的英伟达Grace Blackwell芯片转让给外部投资者,随后再从该SPV回租使用;SPV通过发行债务融资,亚马逊不持有该实体任何股权。官方目标是实现更“轻资产”的资产负债表。但将时间线并置来看,耐人寻味之处在于:8月启动“提前收货”,当月接收约50亿美元GB300机架;9月AWS CFO在内部确认自由现金流转负;10月初即对外寻求出售80亿美元芯片。8月与9月的预计交付金额之和,恰好等于SPV规模。
这一结构的经济实质值得追问:投资者购入SPV所持有的芯片,承担的是一项在物理上持续折旧、但在功能上尚未产生任何收入的资产。Grace Blackwell架构将被英伟达下一代Vera Rubin取代,芯片在仓库中闲置的每一个月,都是其五年经济寿命中被消耗却零回报的一个月。亚马逊通过SPV将这部分资产移出表内,回租安排则保留了使用权,但租金支付构成了新的、持续的现金流出。这并非消除成本,而是将即期的资本负担转换为跨期的租赁义务——一种在时间错配持续存在时的资本结构适应,而非解决方案。
标普全球已就科技巨头日益依赖的表外结构与“互联融资结构”发出警告,指出这些安排使真实杠杆水平难以被准确评估。亚马逊的SPV交易在这一背景下,应被理解为AI基础设施投资周期中现金流压力外化的一个样本,而非孤立的财务技巧。
四、仓库里的芯片,为何反而推高了GPU租金
常规的供需直觉是:大量GPU积压在仓库,应当压低租赁价格。实际走向恰恰相反。
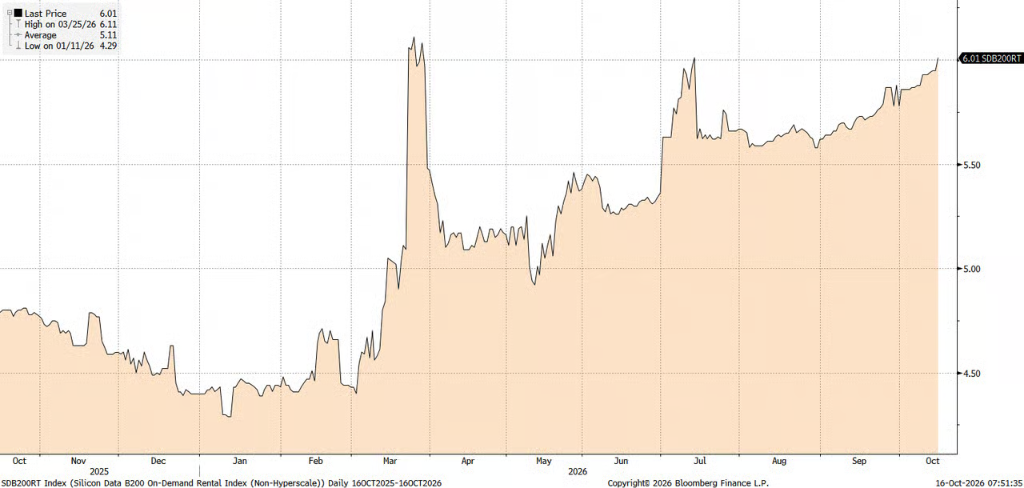
高盛追踪的Silicon Data B200即时租用指数(非超大规模云端)报每GPU小时6.01美元,接近3月6.11美元的历史纪录,较1月低点4.29美元上涨约40%。B200、H200、H100乃至老旧的A100,都维持着可观的租金水平。高盛Delta-One交易台负责人Rich Privorotsky的概括切中要害:“相对于可投资的通电算力的可用供给,有太多资本在寻找归宿……理论上应该快速折旧的算力依然保值。可用算力的稀缺性是无可否认的。”
这一价格信号揭示的机制是清晰的:仓库中的GPU产生的GPU小时数为零,它不构成有效供给。真正在市场上被定价的,是已经接入电力、处于可调度状态的算力。芯片采购的加速并未增加这一意义上的供给,反而通过推高对“通电算力”的竞争性需求,在短期内强化了后者的稀缺溢价。终端租用GPU的AI实验室、企业和初创公司,承担的是这一结构性瓶颈的最终成本。纳德拉在2026年3月的访谈中已将同一逻辑表述得近乎直白:“最大的问题不是计算能力过剩,而是电力……如果你做不到这一点,实际上你可能会有一堆芯片堆放成库存,无法插电使用。这就是我今天面临的问题。”微软的承认表明,这不是亚马逊独有的执行失误,而是超大规模云商在当下技术—物理约束下的共同处境。
五、总结:一场被电网时间尺度重新定价的军备竞赛
亚马逊的“仓库里堆着30亿美元一个月的GB300”,是AI基础设施竞赛进入新阶段的标志性图景。它的含义不是AI算力需求见顶,也不是英伟达芯片失去了吸引力,而是竞赛的约束条件已经发生了位移。当芯片供给的瓶颈逐步让位于电力与物理基础设施的瓶颈,竞争优势的定义也随之改变:能够以多快的速度将资本转化为“通电的算力”,比能够以多快的速度锁定芯片配额,变得更为关键。
亚马逊的选择——提前付款、提前确权、将资产移入SPV回租——是在这一位移中试图同时维持芯片锁定与资产负债表可管理性的应激反应。这些安排可以缓解报表层面的即期压力,但无法缩短变压器128周的交期,无法加速并网排队的队列,也无法变出足够数量的电工和管道工。在电力就绪之前,仓库中的芯片仍然是一项正在折旧、尚未开始产生收入的资产;而终端算力租金的上行,正是市场对这一物理约束的定价。
这场竞赛的讽刺之处在于:所有参与者都在以最快的速度购买那些尚无法使用的硬件,而真正稀缺的东西,恰恰是无法通过购买来加速获得的东西。对这一话题感兴趣的读者,也欢迎来云栈社区与更多从业者交流。
 发表于 前天 07:07
|
查看: 5|
回复: 0


