凌晨三点,告警群响了:MySQL 主从断了。运维同学爬起来,登机器、看日志,定位到某台从库复制中断,于是手动执行 STOP SLAVE; RESET SLAVE; CHANGE MASTER TO ...; START SLAVE;,再盯着 SHOW SLAVE STATUS 等它慢慢追上。整套流程熟得不能再熟,但每次都得人肉盯守——因为 Kubernetes 其实并不理解“从库复制断了”意味着什么。它只会看到:Pod 还在 Running。
这就是有状态应用在 Kubernetes 里的老难题。Deployment、StatefulSet 这些原生控制器能管 Pod 死没死、副本够不够,但管不了“数据库主从一致吗”“备份做了吗”“能不能安全滚动升级”这类问题。
2016 年,CoreOS 提出了 Operator 模式。思路很直接:把运维工程师的操作步骤写成代码,跑在集群里,7×24 小时盯着你的应用。
一、为什么需要 Operator
1.1 原生控制器管到哪为止
K8S 自己内置了一堆控制器:Deployment 管副本数对不对,StatefulSet 管有状态 Pod 按序启停,Job 管跑完没,DaemonSet 管每个节点上有没有。它们共同的套路是“期望状态 vs 实际状态”的调谐(reconcile)。你告诉它我要 3 个副本,它就盯着,少了补、多了删。
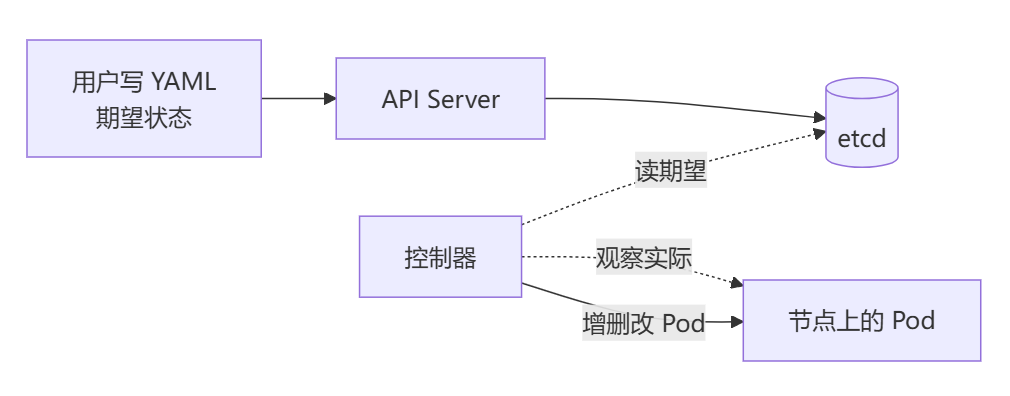
这套机制对无状态服务已经足够:Web API 挂了重启就行,副本之间没区别。可一旦应用有状态,问题就来了:
| 场景 |
原生控制器能做 |
原生控制器做不了 |
| MySQL 主从 |
起 3 个 Pod、给每个稳定名字 |
谁是主?谁是从?主挂了怎么选新主、怎么让从库重新指过去 |
| Redis 集群 |
起 N 个 Pod |
节点之间怎么握手、槽位怎么分配、扩缩容时怎么迁移数据 |
| Elasticsearch |
起 N 个 Pod |
集群发现、索引分片重平衡、节点离开时数据怎么处理 |
| 备份与恢复 |
啥也不做 |
定时备份到 S3、按时间点恢复、备份校验 |
| 滚动升级 |
滚动重启 Pod |
先升从还是先升主?版本兼容性检查?失败回滚? |
关键差距在于:原生控制器只懂 Pod 这个壳子,不懂壳子里跑的应用。它不知道 MySQL 的 SLAVE 状态,不知道 ES 的 cluster_health,也不知道升级前要先做 snapshot。
1.2 Helm / Script / StatefulSet 都差点意思
有人会说,这些事我用 Helm Chart 加一堆 post-install hook 不也行?或者写个 Bash 脚本 跑在 CronJob 里?
可以,但都是一次性动作,不是持续盯守。Helm 装完就没了,脚本到点跑一次。而数据库运维是事件驱动 + 持续观察的活:主库挂了要立刻选主,新节点加进来要自动加入集群,备份失败要重试。这些都需要一个常驻进程,能感知集群状态变化、能调用应用 API、能自己做决策。
StatefulSet 解决了 Pod 名字稳定 + 持久卷按序绑定,但它的“有序”只是启停顺序,不是应用语义。它不会因为“这是从库,所以必须先于主库升级”而改变行为。
1.3 Operator 的核心思路:把运维知识编码
Operator 的核心思想一句话就是:把运维工程师对某应用的操作知识,写成一个 K8S 控制器,让这个控制器替你盯着应用、做该做的事。
打个比方:
- Deployment 是个 Pod 数量管理员:你写
replicas: 3,它保证有 3 个。
- Operator 是个 MySQL 集群管理员:你写“我要一个 1 主 2 从的 MySQL 集群,每天备份”,它保证集群就是这个样子,主挂了自动选主,备份按时做。
它本质上还是控制器模式,只是这个控制器“懂应用”。Operator 不是 K8S 内置的某种新资源类型,而是一种工程方法,用 K8S 已有的扩展机制——CRD + 自定义控制器——拼出来。
CoreOS 当年第一个 Operator 是 etcd-operator,把 etcd 集群的部署、扩容、故障恢复、升级全自动化了。之后 Prometheus、MySQL、PostgreSQL、Kafka、Redis……几乎所有主流有状态软件都有了官方或社区的 Operator。
二、Operator 的技术原理
2.1 两个核心:CRD + 自定义控制器
一个 Operator 由两块组成:
- CRD(CustomResourceDefinition,自定义资源定义):告诉 K8S 我要新增一种资源类型,例如就叫
MySQLCluster。装好之后,用户就能像写 Deployment 一样写 kind: MySQLCluster 的 YAML,然后执行 kubectl get mysqlcluster 也能查到。
- 自定义控制器(Custom Controller):一个常驻进程,通常跑在一个 Pod 里,盯着
MySQLCluster 资源的变化,按你写的逻辑去调谐——建 Pod、配 Service、跑备份、改主从。
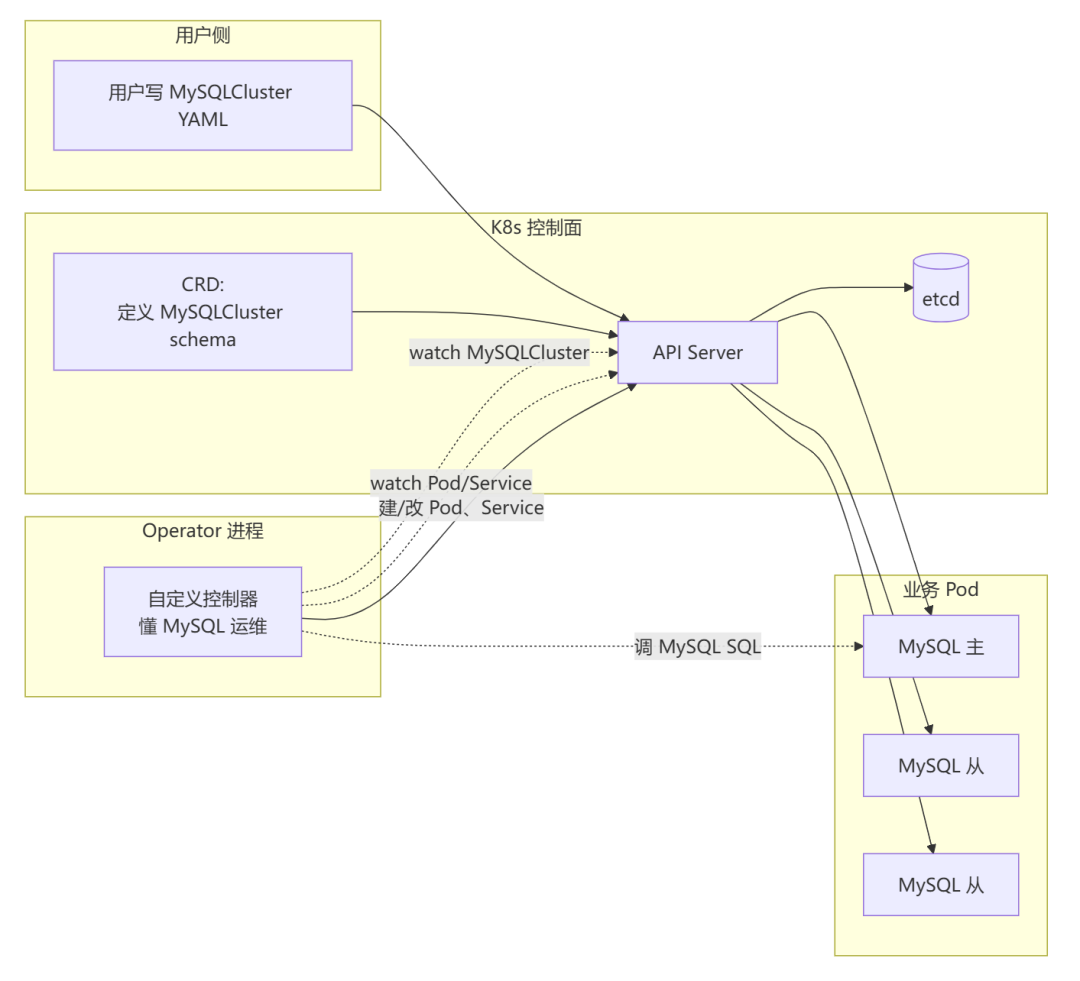
CRD 是资源声明,控制器是执行逻辑,缺一不可。光有 CRD 没控制器,kubectl apply 一个 MySQLCluster 啥也不会发生;光有控制器没 CRD,控制器就没东西可 watch。
2.2 调谐循环:靠期望 vs 实际反复对账
控制器的核心是一个调谐循环(reconcile loop)。它的逻辑很朴素,就是对账。基本逻辑如下:
for 每个被盯的资源:
    读期望状态(用户在 YAML 里写的)
    观察实际状态(去查 Pod、Service、MySQL 主从状态)
    if 实际 != 期望:
        做动作让它接近期望(建 Pod、改配置、跑 SQL)
注意下面几个关键点:
- 不是事件触发了动作,是对账触发了动作。 控制器不是收到
MySQLCluster 创建事件就跑一段代码,而是观察到 MySQLCluster 的期望状态和实际不一致,就做点什么消除差距。事件只是触发一次对账的由头,对账本身可以由任何变化触发,比如 Pod 挂了、定时器到了、上次对账失败重试等。
- 幂等。 同一段对账逻辑跑 10 次和跑 1 次结果一样。因为对账看的是差距,没差距就啥也不做。
- 单次对账要快、要能中断。 控制器不会在一次对账里把所有事做完,做一步就返回,等下一轮再继续。比如建主库 Pod 后这一轮就结束,等 Pod 起来触发下一轮再配从库。
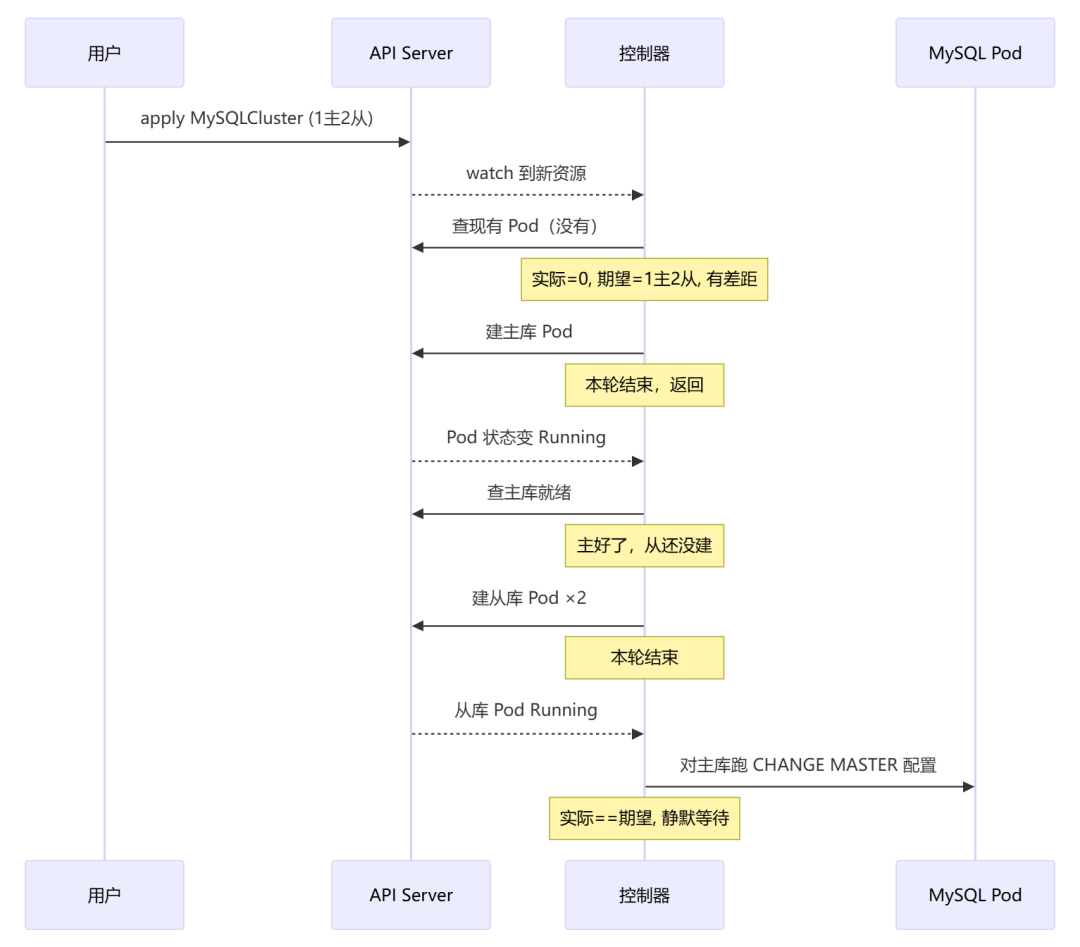
这种“不指望一次干完、每轮做一点、最终收敛”的风格,是 K8S 控制器区别于传统脚本的核心。它天然适配分布式系统里状态变化随时发生的现实。
2.3 控制器怎么懂应用?直接调应用自己的 API
原生控制器主要调 K8S API 来建 Pod、改 Service。Operator 多了一层:它可以调用应用自己的管理接口。
比如 MySQL Operator 要让某个从库指向新主库,不是去改 YAML,而是连上 MySQL 跑 CHANGE MASTER TO MASTER_HOST='mysql-0', ...; START SLAVE;。Elasticsearch Operator 要把节点踢出集群,会先调 ES 的 _cluster/voting_config_exclusions API,让它安全下线。
所以一个 Operator 的代码通常长这样:
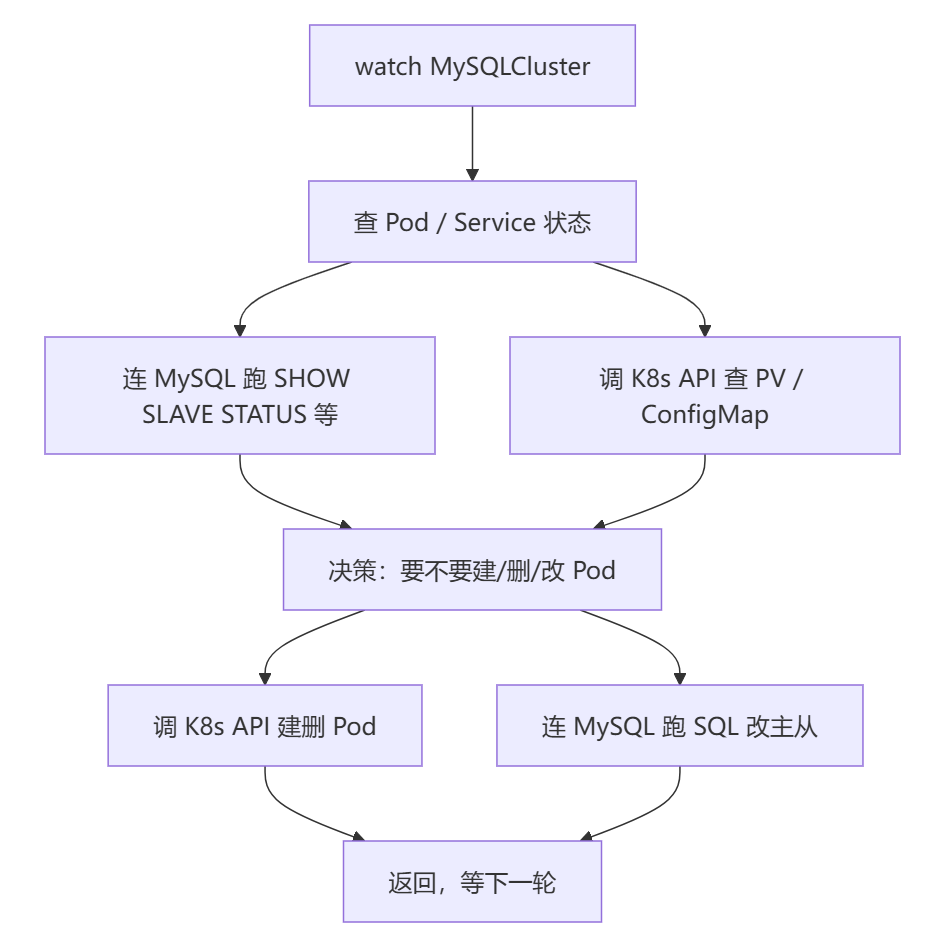
“懂应用”就是这部分逻辑:它把运维手册里的“如果从库复制断了,先 STOP SLAVE,再 RESET,再 CHANGE MASTER 指向新主,再 START SLAVE”翻译成代码。
2.4 CRD 的 schema:给自定义资源定规则
CRD 不只是起个名字,还能定义 schema(用 OpenAPI v3),让 K8S 帮你校验用户写的 YAML。比如 MySQLCluster 可以规定:
spec.replicas 1 必须是整数,≥1;spec.version 必须匹配某个 MySQL 版本号格式;spec.backup.schedule 是 cron 格式字符串;
校验不通过,kubectl apply 直接被 API Server 拒掉,控制器根本不会被触发。这比写脚本时自己 if [ -z "$REPLICAS" ] 健壮得多。
CRD 还能定义 status 子资源。控制器把观察到的实际状态写回 status 字段(比如 status.phase: Ready、status.currentMaster: mysql-0),用户执行 kubectl describe mysqlcluster xxx 就能看到。这是期望状态和实际状态分开存放的标准做法——spec 是用户写的期望,status 是控制器写的实际。
2.5 Operator 不等于 Helm,也不替代 Helm
下面是两个组件的对比表:
|
Helm |
Operator |
| 主要解决 |
一次性部署 + 模板化 YAML |
持续运维 + 应用语义自动化 |
| 跑在哪 |
仅在安装时(客户端工具) |
常驻在集群里 |
| 响应变化 |
不响应,要 helm upgrade |
自动响应、自动调谐 |
| 懂应用 |
不懂,只是模板渲染 |
懂,能调应用 API |
| 典型场景 |
装个 Chart、版本升级 |
主从切换、备份恢复、故障自愈 |
它们更应该是互补关系,实际中常常配合使用:Helm 把 Operator 自己装进集群,Operator 再去管应用。比如 helm install prometheus-operator 装的是 Operator,Operator 再去管 Prometheus 实例。
三、实操:装一个现成的 Operator
写一个 Operator 从零开始要不少代码。这里先用一个社区现成的 Operator,体验一下声明式有状态应用是什么感觉。选的是 Prometheus Operator,它成熟、文档全,能直观看到 CRD 怎么把装一个监控简化成一行 YAML。
3.1 环境与准备
环境中需要 Kubernetes 1.30+,先新建命名空间:
kubectl create namespace jyfy
3.2 装 Operator 本体
Prometheus Operator 用 Helm Chart 装最省事:
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
helm install kube-prometheus-stack prometheus-community/kube-prometheus-stack \
  --namespace jyfy \
  --set kubeStateMetrics.enabled=true
装完看一眼,会发现集群里多了一堆 CRD 和一个 Operator Deployment:
# 看新增的 CRD
kubectl get crd | grep monitoring
# 看 Operator 自己
kubectl -n jyfy get deploy | grep prometheus-operator
kube-prometheus-stack 这个 Chart 干了两件事:装了 Operator(一个 Deployment),还顺手用 CRD 资源建了一套默认 Prometheus / Grafana / Alertmanager。Operator 装好后,之后任何对 Prometheus 资源的改动,它都会自动调谐。
3.3 声明一个 Prometheus 实例
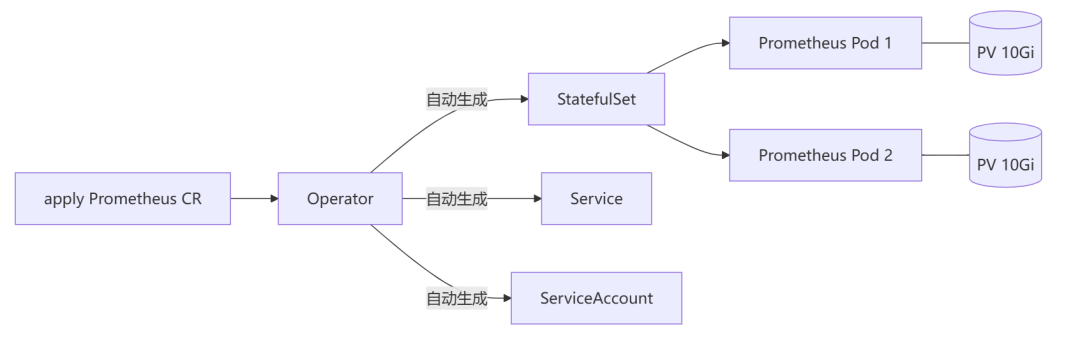
Operator 的价值在于:你不再手写 Prometheus 的 ConfigMap、Deployment、StatefulSet,而是写一个 Prometheus 自定义资源,告诉 Operator “我要一个这样的 Prometheus”,剩下的它来。下面是 my-prom.yaml:
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: my-prom
  namespace: jyfy
spec:
  replicas: 2
# 高可用:两个 Prometheus 实例
  shards: 1
  version: v2.55.0
  serviceAccountName: prometheus
  serviceMonitorSelector: {}
# 选所有 ServiceMonitor
  resources:
    requests:
      cpu: 200m
      memory: 512Mi
    limits:
      cpu: 1
      memory: 1Gi
  storage:
    volumeClaimTemplate:
      spec:
        storageClassName: standard
        resources:
          requests:
            storage: 10Gi
  retention: 15d
应用并观察:
kubectl apply -f my-prom.yaml
kubectl -n jyfy get prometheus
kubectl -n jyfy get pod -l prometheus=my-prom -w
你会看到 Operator 自动建了 StatefulSet,给每个 Prometheus Pod 挂上 10Gi 的 PV,配好 Service。从头到尾你都没碰过 StatefulSet 的 YAML——这就是 Operator 的意义。
3.4 用 ServiceMonitor 让它抓自己的指标
Operator 模式的另一个妙处是:连“告诉 Prometheus 去抓什么”也是声明式的。Prometheus Operator 提供了 ServiceMonitor CRD——你写一个 ServiceMonitor,Operator 自动把它翻译成 Prometheus 配置,完全不用碰 ConfigMap。
下面是 my-sm.yaml,让 Prometheus 抓 kubelet 的指标:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: kubelet-sm
  namespace: jyfy
  labels:
    release: kube-prometheus-stack
# 要能被上面的 Prometheus 选中
spec:
  endpoints:
  - port: https-metrics
    interval: 30s
    scheme: https
    bearerTokenFile: /var/run/secrets/kubernetes.io/serviceaccount/token
    tlsConfig:
      insecureSkipVerify: true
  selector:
    matchLabels:
      k8s-app: kubelet
  namespaceSelector:
    matchNames:
    - kube-system
kubectl apply -f my-sm.yaml
kubectl -n jyfy get servicemonitor
进 Prometheus 控制台(kubectl -n jyfy port-forward svc/kube-prometheus-stack-prometheus 9090:9090,浏览器打开 http://localhost:9090/targets),能看到 kubelet 已经在抓取列表里了。整个过程没改一行 Prometheus 配置文件——Operator 帮你把 ServiceMonitor 翻译成 prometheus.yml 并热加载。
3.5 改一改试试调谐
Operator 最值得亲手验证的,就是改 spec 后它自动收敛。把 my-prom.yaml 里的 replicas: 2 改成 replicas: 3,再 kubectl apply:
# 改完 apply
kubectl apply -f my-prom.yaml
# 看 Operator 怎么反应
kubectl -n jyfy get pod -l prometheus=my-prom -w
几秒内会看到第三个 Prometheus Pod 被拉起来。再把 retention: 15d 改成 retention: 30d,apply 后 Operator 会重启 Prometheus 进程,让新参数生效。
反过来,直接删掉这个 Prometheus 资源:
kubectl -n jyfy delete prometheus my-prom
Operator 会把对应的 StatefulSet、Pod、PV 一起收走。这是声明式的另一半:资源没了,期望状态变成“不存在”,Operator 就把实际也清到不存在。
3.6 自己写一个 Operator 试试
体验完现成的,想给自己某个有状态服务写个 Operator,不用从零撸 controller-runtime。有两个主流脚手架可以用:
- kubebuilder(K8S 官方 SIG 维护):用 Go +
controller-runtime,生成项目骨架、CRD、控制器模板,make manifests 自动出 CRD YAML。
- Operator SDK(Red Hat 维护,基于 kubebuilder):除了 Go,还支持 Helm Operator(把 Helm Chart 直接包成 Operator)和 Ansible Operator(用 Ansible playbook 写调谐逻辑),适合不写 Go 的同学。
最小路径通常是:

核心工作量集中在 Reconcile 函数。以开头的 MySQLCluster 举例:它拿到一个 MySQLCluster 对象,去查实际状态、做决策、调 K8S API 和应用 API。框架帮你处理 watch、队列、重试、leader 选举这些通用杂活。
写 Operator 的几个常见踩坑提醒:
- 别在 Reconcile 里阻塞等 Pod 起来。 看到 Pod 还没 Ready 就返回,让下一轮再来查,否则一个慢 Pod 卡死整个控制器。
- status 一定要写回。 否则用户
kubectl describe 看不到状态,调试地狱。用 status 子资源 + updateStatus 而不是 update,避免和 spec 写冲突。
- OwnerReference 要设对。 Operator 建的 Pod、Service 要带上归属指向,指向 CR。CR 删了,K8S 自动级联删子资源,不用你手动清理。
- finalizer 处理删除。 有外部资源(S3 备份、外部 DNS 记录)需要在 CR 删除时清理,要加 finalizer,在 Reconcile 里看到
DeletionTimestamp 就先清外部再摘 finalizer。
小结
| 事项 |
解释 |
| 为什么 |
有状态应用的运维知识(选主、备份、滚动升级)原生控制器不懂,靠人盯和脚本不可持续 |
| 是什么 |
一种工程模式:CRD(自定义资源)+ 自定义控制器,把运维操作编码成常驻代码 |
| 核心机制 |
调谐循环:反复对比期望 vs 实际,幂等、可中断、最终收敛 |
| 怎么懂应用 |
不只调 K8S API,还调应用自己的接口(SQL、HTTP API) |
| 和 Helm 关系 |
Helm 管一次性部署,Operator 管持续运维,配合着用 |
| 怎么上手 |
先装现成的(Prometheus Operator)体验声明式运维;要自己写用 kubebuilder / Operator SDK |
Operator 没有发明新架构,它就是把 K8S 已有的控制器 + CRD 机制,用来承载一类它原本管不了的事——应用内部的运维逻辑。当你的服务复杂到“重启 Pod 还不够、还得懂它内部状态”时,Operator 就是目前最合适的解法。
 发表于 22 小时前
|
查看: 4|
回复: 0


