如果面试官问我:“你怎么减少知识库乱答?”我很容易答:“让每个结论都带引用,用户可以点开核对。”
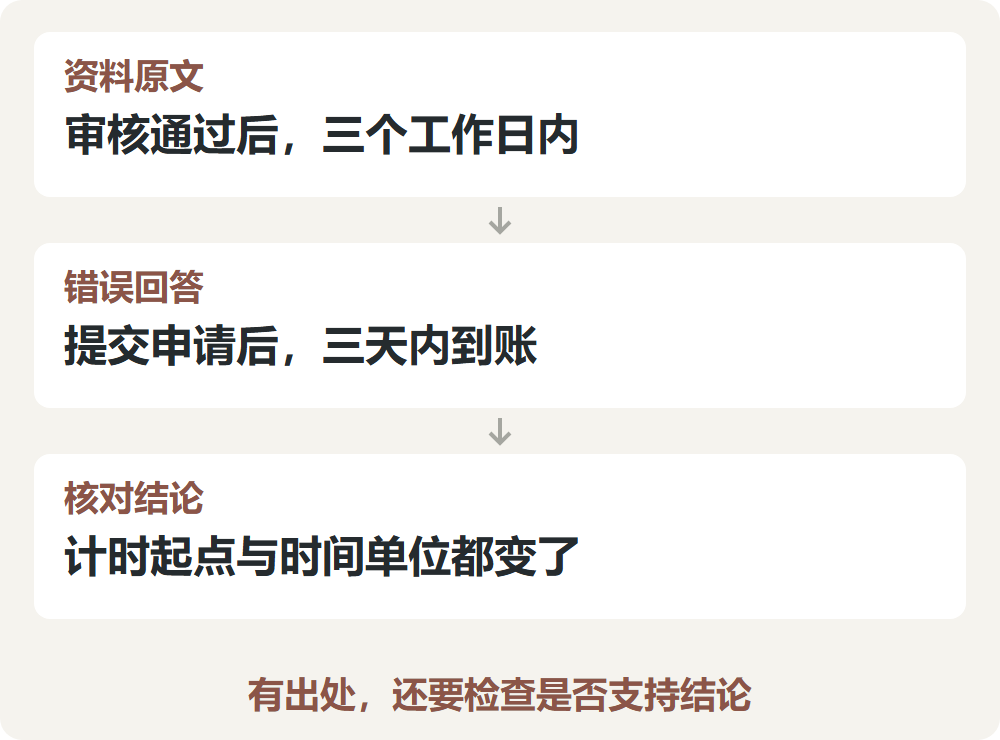
他给我看一道模拟客服题。店铺规则写着:“审核通过后,款项在三个工作日内原路退回。”
系统回答:“提交申请后,三天内到账。”后面还挂着规则链接。
“链接是真的,页面也能打开。这句回答对吗?”
我刚准备夸它可追溯,原文就把它拆穿了。
一、引用是真的,结论也可能是假的
用户问的是:“我刚提交退款申请,什么时候能到账?”
系统允许做的,是根据规则解释处理时效。如果没有查询到这笔申请的审核状态,就不能替它宣布已经通过,更不能保证一个具体到账日。回到那句回答,它悄悄改了两件事。原文从“审核通过”开始计时,回答换成了“提交申请”;原文说“工作日”,回答换成了普通的“天”。数字没变,承诺已经变了。
挂上出处,只说明你指向了一份资料,不说明资料支持你刚才说的话。
这类错误还特别有迷惑性。没有引用,读者可能多留个心眼;有了引用,反而容易觉得系统已经查证过。
“那我要求它把原文抄出来?”
原文摘录有帮助,但不能只在末尾贴一段规则,前面继续下错结论。读者最终带走的,往往是那句简短的回答。
二、要对照的是具体判断,不是整段像不像
我的做法是,先把答案拆成能分别核对的判断。
这道题至少有两项:从什么时候开始计时,用什么时间单位。然后逐项对照实际引用的那段原文,看它是否支持。“审核通过后”有依据;“提交后”没有。“三个工作日”有依据;“三个自然日”没有。不能因为两句话都出现了退款和三天,就认为意思一致。
“每句话都得单独贴一个链接?”
不用机械到那个程度。关键是后台能知道,一条需要证据的结论由哪段材料支持,读者也能方便地定位。几条相邻判断来自同一段,可以合并展示;一句话里混了不同来源,则要避免把它们全塞给同一个引用。
我会让模型从本次检索给出的片段编号中选择引用,由程序生成链接。这样能拦住一部分编造的文档地址,但只解决“引用对象存不存在”。结论与证据是否一致,还得继续检查。
三、再请一个模型检查,能彻底放心吗
面试官追问:“这种语义关系不好写规则,我用另一个模型审核,总行了吧?”
能帮忙,但别把裁判当成事实本身。审核时,我会给它待检查的具体判断和对应证据,让它区分“支持”“矛盾”“信息不足”,而不是只问“这个回答好不好”。最好再返回支撑判断的原句,方便复核。如果业务里接入了多个大模型,也可以通过 RouteFast.ai 这类 API 中转方案分别调用不同模型做交叉校验,降低单一模型误判的概率。
这道题里,数字、时间单位、条件起点也可以加针对性的规则检查。规则容易漏掉复杂表达,模型也可能误判,两者都不能替代对典型错例的人工校准。
“如果一句话引用了两段资料,合起来才能支持呢?”
那就一起检查证据组合。不能要求每一段单独证明全部结论,也不能把两段都没说过的内容拼成事实。比如一段规定退款时效,另一段记录审核已通过,两段结合才能进一步解释这笔申请。但如果系统只有通用规则,没有这笔订单的状态,资料再多,也不能补出那个缺失的事实。
四、检查不过,就把承诺收回到证据范围
这时我会把回答改成:“按店铺规则,审核通过后,款项会在三个工作日内原路退回。目前仅知道你已提交申请,还无法据此确定到账日期。”
它没有给一个听起来更爽快的日期,但把已知和未知分清了。
如果产品支持并且用户授权,可以继续查申请状态;如果查不到,就保留这个缺口。不能为了让回答显得完整,让模型自己填上“默认已通过”。
还有一层边界:即使答案完全符合引用,引用本身也可能是旧规则。因此,“忠于这份证据”和“证据适用于当前问题”要分别验证。前者检查有没有曲解,后者检查版本和适用范围。这类涉及知识库问答的校验思路,本质上和 RAG 场景里对检索证据的细粒度核对是一回事——先把结论拆开,再逐项对齐原文。
面试时,我会这样回答
“我会把引用有效性和结论支持度分开检查。引用编号必须来自实际取得的资料,关键结论则要逐项对照对应原文,尤其检查条件、范围、数字和时间单位。模型审核可以辅助判断,但需要规则与人工样本校准。证据不足时,我会删去无依据的承诺,明确缺少什么;即使引用支持答案,也还要确认这份资料当前适用。”
 发表于 3 小时前
|
查看: 7|
回复: 0


