聚类算法能够自动发现数据中的隐藏结构并进行分组,从而帮助理解数据的内在模式。通过有效划分数据簇,聚类可以揭示数据中的异质性和相似性,并为后续分析与建模提供基础。有效的聚类结果还能提升分类、异常检测等下游任务的表现。
下面整理 10 种最常用聚类算法:K-Means、层次聚类、DBSCAN、高斯混合模型、均值漂移、模糊 C 均值、期望最大化算法、谱聚类、Birch、Affinity Propagation,覆盖原理、核心公式与 Python 实现。
下面从 K-Means 开始,使用 Python 和 scikit-learn 逐一实现。
1. K-Means 聚类
K-Means 是一种基于质心(Centroid)的聚类算法,目标是将数据分成 K 个聚类,使得同一聚类中的数据点具有较高的相似性,不同聚类的数据点差异较大。算法通过迭代优化,每次将数据点分配到最近的质心,并更新质心的位置,直至聚类结果稳定。
算法原理
K-Means 聚类算法的基本原理是通过最小化数据点到其所属聚类质心的欧几里得距离的平方和,来找到最佳聚类。
步骤如下:
- 初始化:随机选择 K 个数据点作为初始质心(也可以使用其他方式如 K-Means++ 进行初始化)。
- 分配簇:对于数据集中的每个数据点,计算其与每个质心之间的距离,将其分配到最近的质心对应的簇中。
- 更新质心:重新计算每个簇的质心,即簇中所有数据点的均值。
- 重复:重复步骤 2 和 3,直到质心不再发生变化或达到预定的迭代次数。
核心公式
K-Means 算法的目标是最小化以下代价函数(即簇内平方和):
$$
J = \sum_{i=1}^{K} \sum_{x \in C_i} \| x - \mu_i \|^2
$$
其中:
- K 是簇的数量。
- C_i 表示第 i 个簇。
- x 是数据集中属于簇 C_i 的第 j 个点。
- μ_i 是第 i 个簇的质心(即所有 x 的均值)。
核心公式推导
推导的目的是找到最优质心 μ_i,使得代价函数 J 最小化。
- 初始化:设数据集为 X,希望将其分成 K 个簇 C_i,每个簇质心为 μ_i。
- 分配簇:对每个数据点 x,计算到每个质心的距离,将 x 分配到距离最近的质心所属的簇中:
$$
C_i = \left\{ x : \arg\min_j \| x - \mu_j \|^2 = i \right\}
$$
- 更新质心:更新质心 μ_i,使其等于当前簇中所有点的均值:
$$
\mu_i = \frac{1}{|C_i|} \sum_{x \in C_i} x
$$
- 推导最优质心:对 J 关于 μ_i 求导并令导数为零:
$$
\frac{\partial J}{\partial \mu_i} = -2 \sum_{x \in C_i} (x - \mu_i) = 0
$$
可得:
$$
\sum_{x \in C_i} (x - \mu_i) = 0
$$
因此:
$$
\mu_i = \frac{1}{|C_i|} \sum_{x \in C_i} x
$$
这表明质心 μ_i 是其所属簇中所有数据点的均值。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs
from sklearn.metrics import silhouette_score

# 生成虚拟数据集
np.random.seed(42)
X, y = make_blobs(n_samples=1000, centers=5, cluster_std=1.0, random_state=42)

# K-Means聚类
kmeans = KMeans(n_clusters=5, random_state=42)
y_kmeans = kmeans.fit_predict(X)

# 计算轮廓系数
sil_score = silhouette_score(X, y_kmeans)

# 绘制聚类结果
plt.figure(figsize=(18, 8))

# 子图1:原始数据分布
plt.subplot(1, 3, 1)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50, cmap='rainbow', edgecolors='k')
plt.title("Original Data Distribution", fontsize=14)
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")

# 子图2:K-Means聚类结果
plt.subplot(1, 3, 2)
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='rainbow', edgecolors='k')
plt.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1], s=300, c='yellow', edgecolors='k')
plt.title(f"K-Means Clustering (k=5)\nSilhouette Score = {sil_score:.2f}", fontsize=14)
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")

# 子图3:每个簇的数据点数量
plt.subplot(1, 3, 3)
unique, counts = np.unique(y_kmeans, return_counts=True)
plt.bar(unique, counts, color='dodgerblue', edgecolor='k')
plt.xticks(unique)
plt.title("Number of Points per Cluster", fontsize=14)
plt.xlabel("Cluster")
plt.ylabel("Number of Points")

# 显示图像
plt.tight_layout()
plt.show()
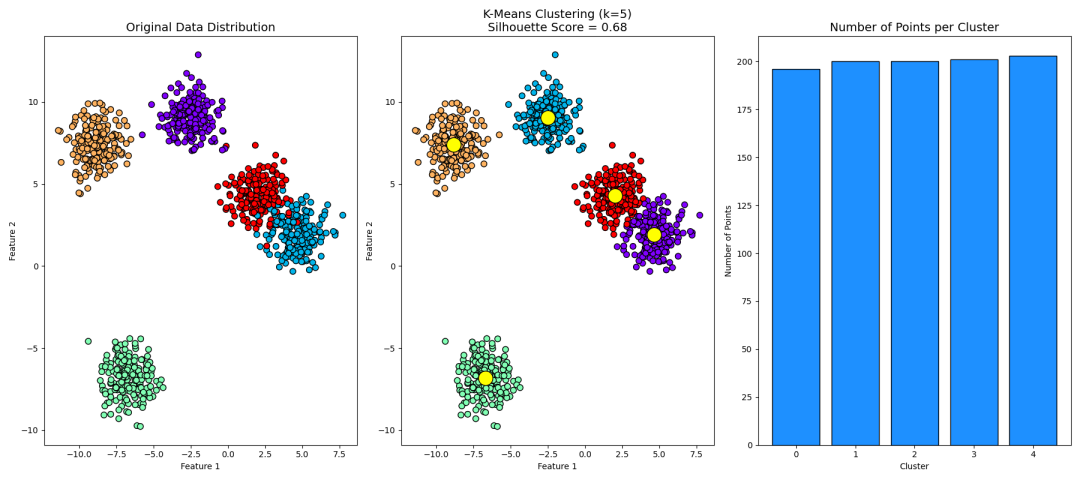
- 第一个子图显示原始数据的分布情况。
- 第二个子图展示 K-Means 聚类结果,聚类中心用黄色标记,并在标题中显示轮廓系数来评估聚类质量。
- 第三个子图显示每个簇中数据点的数量。
2. 层次聚类
层次聚类是一种基于树状结构的聚类方法,分为自底向上(凝聚层次聚类)和自顶向下(分裂层次聚类)两种方式。它不需要预先指定聚类数目,可以生成一个聚类树(树状图)。
算法原理
层次聚类通过不断合并或拆分簇来构建树状结构:
- 凝聚层次聚类:从每个点作为一个簇开始,逐步合并最近的簇,直到所有点都被合并到一个簇中。
- 分裂层次聚类:从所有点作为一个簇开始,逐步拆分簇,直到每个点成为一个单独的簇。
核心公式
在层次聚类中,距离度量是关键。常见的簇间距离度量方式有:
$$
d(C_i, C_j) = \min_{x \in C_i, y \in C_j} \|x - y\|
$$
$$
d(C_i, C_j) = \max_{x \in C_i, y \in C_j} \|x - y\|
$$
$$
d(C_i, C_j) = \frac{1}{|C_i||C_j|} \sum_{x \in C_i} \sum_{y \in C_j} \|x - y\|
$$
核心公式推导
以单链法为例:
- 初始设置:每个数据点作为一个独立簇,计算所有点对之间的距离。
- 找到最近的簇:选择两个簇 C_i 和 C_j,使它们之间最小距离最小。
- 合并簇:将这两个簇合并成一个新簇,并计算新簇与其他簇的距离。
- 重复:重复上述步骤,直到所有数据点合并为一个簇或达到某个预定簇数。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from sklearn.datasets import make_blobs
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

# 设置随机种子
np.random.seed(42)

# 生成虚拟数据集
n_samples = 1000
n_features = 5
n_clusters = 3

X, y = make_blobs(n_samples=n_samples, n_features=n_features, centers=n_clusters, cluster_std=1.0)

# 标准化数据
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 使用PCA将数据降维至2维,方便可视化
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_scaled)

# 使用层次聚类
linked = linkage(X_scaled, 'ward')

# 聚类分配
max_d = 7.5# 最大距离,调整该值可以改变聚类数量
clusters = fcluster(linked, max_d, criterion='distance')

# 设置颜色列表,确保颜色鲜艳
colors = sns.color_palette("hsv", n_clusters)

# 创建图形
plt.figure(figsize=(16, 8))

# 绘制PCA后的散点图
plt.subplot(1, 2, 1)
for i in range(1, n_clusters + 1):
    plt.scatter(X_pca[clusters == i, 0], X_pca[clusters == i, 1], label=f'Cluster {i}', color=colors[i-1])

plt.title('PCA of Hierarchical Clustering')
plt.xlabel('PCA Component 1')
plt.ylabel('PCA Component 2')
plt.legend()

# 绘制层次聚类树状图
plt.subplot(1, 2, 2)
dendrogram(linked,
           orientation='top',
           distance_sort='descending',
           show_leaf_counts=False,
           color_threshold=max_d,
           above_threshold_color='grey',
           truncate_mode='lastp',
           p=n_clusters)

plt.axhline(y=max_d, color='r', linestyle='--')
plt.title('Hierarchical Clustering Dendrogram')
plt.xlabel('Sample Index or (Cluster Size)')
plt.ylabel('Distance')

# 显示图形
plt.tight_layout()
plt.show()
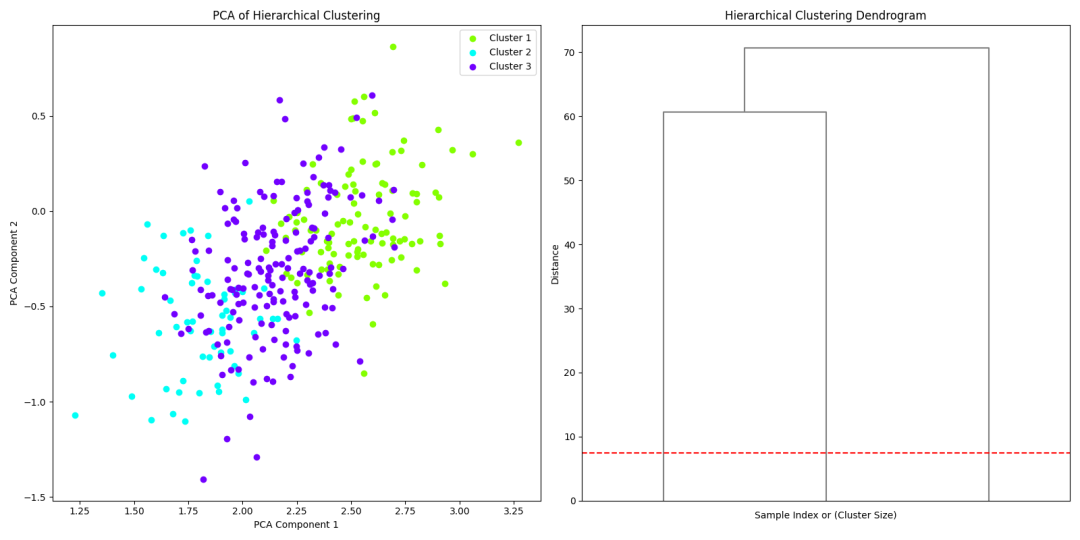
- 左图展示 PCA 降维后数据点分布,并根据聚类结果用不同颜色标记。
- 右图绘制层次聚类树状图,并标注距离阈值线。
3. DBSCAN
DBSCAN 是一种基于密度的聚类算法,适用于发现任意形状的簇,并能够处理噪声数据点。它通过密度的概念,将高密度区域的点聚集成簇,低密度区域的点则被视为噪声。
算法原理
DBSCAN 通过以下步骤进行聚类:
- 核心点 (Core Point):对于数据集中某个点,如果在其 ε 邻域内的点数不小于最小点数 MinPts,则该点为核心点。
- 密度可达性 (Density Reachability):如果点 p 是核心点,并且点 q 位于 p 的 ε 邻域内,则点 q 由 p 密度可达。
- 密度相连性 (Density Connectivity):如果点 p 和 q 都由点 o 密度可达,则点 p 和点 q 密度相连。
通过上述步骤,DBSCAN 将所有密度可达的点组成一个簇,而不属于任何簇的点被标记为噪声点。
核心公式
DBSCAN 的核心在于定义 ε 邻域和判断核心点。
$$
N_{\epsilon}(p) = \{ q \in D \mid \text{distance}(p, q) \le \epsilon \}
$$
- 核心点判断:如果 |N_ε(p)| ≥ MinPts,则 p 是一个核心点。
核心公式推导
- 密度可达性:一个点 q 由核心点 p 密度可达,如果 q 位于 p 的 ε 邻域内。
- 密度相连性:如果存在一系列点 p1,...,pn,使得 p1 = p,pn = q,并且 p_{i+1} 由 p_i 密度可达,则 p 和 q 密度相连。
通过这些定义,DBSCAN 能够通过遍历数据集,找到所有密度相连点群并标记为簇。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons, make_blobs
from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler

# 生成虚拟数据集
n_samples = 1500
X1, _ = make_moons(n_samples=n_samples, noise=0.1, random_state=42)
X2, _ = make_blobs(n_samples=n_samples, centers=3, random_state=42, cluster_std=1.0)
X2 = StandardScaler().fit_transform(X2)

# 合并数据集
X = np.vstack((X1, X2))

# 运行DBSCAN算法
dbscan = DBSCAN(eps=0.3, min_samples=10)
labels = dbscan.fit_predict(X)

# 获取聚类标签数
n_clusters = len(set(labels)) - (1 if -1 in labels else 0)

# 创建子图
fig, axs = plt.subplots(1, 3, figsize=(18, 6))

# 图1:原始数据分布
axs[0].scatter(X[:, 0], X[:, 1], c='gray', edgecolor='k', s=30)
axs[0].set_title("Original Data Distribution")
axs[0].set_xlabel("Feature 1")
axs[0].set_ylabel("Feature 2")

# 图2:DBSCAN聚类结果
unique_labels = set(labels)
colors = plt.cm.Spectral(np.linspace(0, 1, len(unique_labels)))
for k, col in zip(unique_labels, colors):
    if k == -1:
        col = 'k'  # 噪声点标记为黑色
    class_member_mask = (labels == k)
    xy = X[class_member_mask]
    axs[1].scatter(xy[:, 0], xy[:, 1], c=[col], edgecolor='k', s=30)

axs[1].set_title(f"DBSCAN Clustering Result\nEstimated clusters: {n_clusters}")
axs[1].set_xlabel("Feature 1")
axs[1].set_ylabel("Feature 2")

# 图3:聚类后的数据点密度图
axs[2].scatter(X[:, 0], X[:, 1], c=labels, cmap='rainbow', edgecolor='k', s=30)
axs[2].set_title("Density of Clustered Points")
axs[2].set_xlabel("Feature 1")
axs[2].set_ylabel("Feature 2")

# 调整布局
plt.tight_layout()
plt.show()
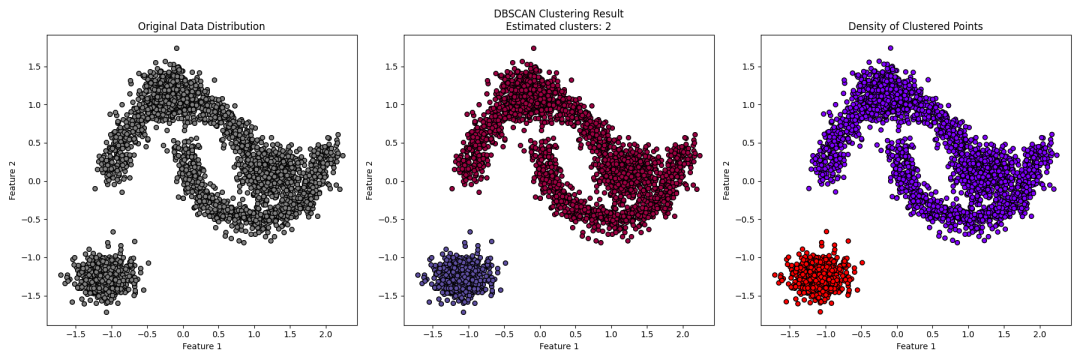
- 第一个子图显示原始数据的分布。
- 第二个子图显示 DBSCAN 聚类后的结果,不同颜色表示不同簇,黑色表示噪声点。
- 第三个子图显示聚类后数据点的密度情况,通过颜色映射反映不同簇的密度。
4. 高斯混合模型
高斯混合模型 (GMM) 是一种基于概率模型的聚类算法,它假设数据集是由多个高斯分布组成的混合体,并通过最大化似然估计来找到最优参数。
算法原理
GMM 通过以下步骤进行聚类:
- 初始化:随机初始化 K 个高斯分布的参数(均值、协方差矩阵和混合系数)。
- E 步骤(期望步骤):计算每个数据点属于每个高斯分布的后验概率。
- M 步骤(最大化步骤):根据后验概率,更新高斯分布的参数。
- 重复:交替执行 E 步骤和 M 步骤,直到参数收敛或达到预定的迭代次数。
核心公式
GMM 的目标是最大化数据的似然函数:
$$
\mathcal{L}(\theta) = \prod_{i=1}^{N} \sum_{j=1}^{K} \pi_j \mathcal{N}(x_i \mid \mu_j, \Sigma_j)
$$
其中:
- N 是数据点数量。
- K 是高斯分布数量。
- π_j 是第 j 个高斯分布的混合系数。
- N(x_i|μ_j, Σ_j) 是第 j 个高斯分布在点 x_i 的概率密度值。
核心公式推导
GMM 的推导涉及 EM 算法:
- E 步骤:计算后验概率:
$$
\gamma(z_{ij}) = \frac{\pi_j \mathcal{N}(x_i \mid \mu_j, \Sigma_j)}{\sum_{l=1}^{K} \pi_l \mathcal{N}(x_i \mid \mu_l, \Sigma_l)}
$$
- M 步骤:更新参数:
$$
\mu_j = \frac{\sum_{i=1}^N \gamma(z_{ij}) x_i}{\sum_{i=1}^N \gamma(z_{ij})}
$$
$$
\Sigma_j = \frac{\sum_{i=1}^N \gamma(z_{ij})(x_i - \mu_j)(x_i - \mu_j)^T}{\sum_{i=1}^N \gamma(z_{ij})}
$$
$$
\pi_j = \frac{1}{N} \sum_{i=1}^N \gamma(z_{ij})
$$
- 迭代:重复 E 步骤和 M 步骤,直到参数收敛。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.mixture import GaussianMixture
from sklearn.datasets import make_blobs
from matplotlib.patches import Ellipse

# 生成虚拟数据集
np.random.seed(42)
n_samples = 1500

# 使用make_blobs生成有4个中心的二维数据集
X, y_true = make_blobs(n_samples=n_samples, centers=4, cluster_std=1.0, random_state=42)

# 添加一些随机噪声
X = np.dot(X, np.random.RandomState(42).randn(2, 2))

# 用高斯混合模型进行聚类
gmm = GaussianMixture(n_components=4, covariance_type='full', random_state=42)
gmm.fit(X)
y_gmm = gmm.predict(X)

# 创建一个图形,包含四个子图
fig, axs = plt.subplots(2, 2, figsize=(14, 12))

# 子图1:原始数据集的散点图,标注真实类别
axs[0, 0].scatter(X[:, 0], X[:, 1], c=y_true, s=40, cmap='viridis', zorder=2)
axs[0, 0].set_title("Original Data with True Labels")
axs[0, 0].set_xlabel("Feature 1")
axs[0, 0].set_ylabel("Feature 2")

# 子图2:GMM聚类结果的散点图
axs[0, 1].scatter(X[:, 0], X[:, 1], c=y_gmm, s=40, cmap='viridis', zorder=2)
axs[0, 1].set_title("GMM Clustered Data")
axs[0, 1].set_xlabel("Feature 1")
axs[0, 1].set_ylabel("Feature 2")

# 子图3:GMM的预测概率分布(软分配)
prob_density = gmm.predict_proba(X)
axs[1, 0].scatter(X[:, 0], X[:, 1], c=prob_density.max(axis=1), s=40, cmap='viridis', zorder=2)
axs[1, 0].set_title("GMM Predicted Probabilities")
axs[1, 0].set_xlabel("Feature 1")
axs[1, 0].set_ylabel("Feature 2")

# 子图4:在散点图上绘制GMM的高斯椭圆
def draw_ellipse(position, covariance, ax, color):
    """在给定位置和协方差矩阵处绘制高斯椭圆。"""
    if covariance.shape == (2, 2):
        U, s, Vt = np.linalg.svd(covariance)
        angle = np.degrees(np.arctan2(U[1, 0], U[0, 0]))
        width, height = 2 * np.sqrt(s)
    else:
        angle = 0
        width, height = 2 * np.sqrt(covariance)
    ell = Ellipse(position, width, height, edgecolor=color, facecolor='none')
    ax.add_patch(ell)

# 绘制GMM的椭圆
axs[1, 1].scatter(X[:, 0], X[:, 1], c=y_gmm, s=40, cmap='viridis', zorder=2)
for pos, covar, color in zip(gmm.means_, gmm.covariances_, ['red', 'green', 'blue', 'purple']):
    draw_ellipse(pos, covar, axs[1, 1], color)
axs[1, 1].set_title("GMM with Gaussian Ellipses")
axs[1, 1].set_xlabel("Feature 1")
axs[1, 1].set_ylabel("Feature 2")

plt.tight_layout()
plt.show()
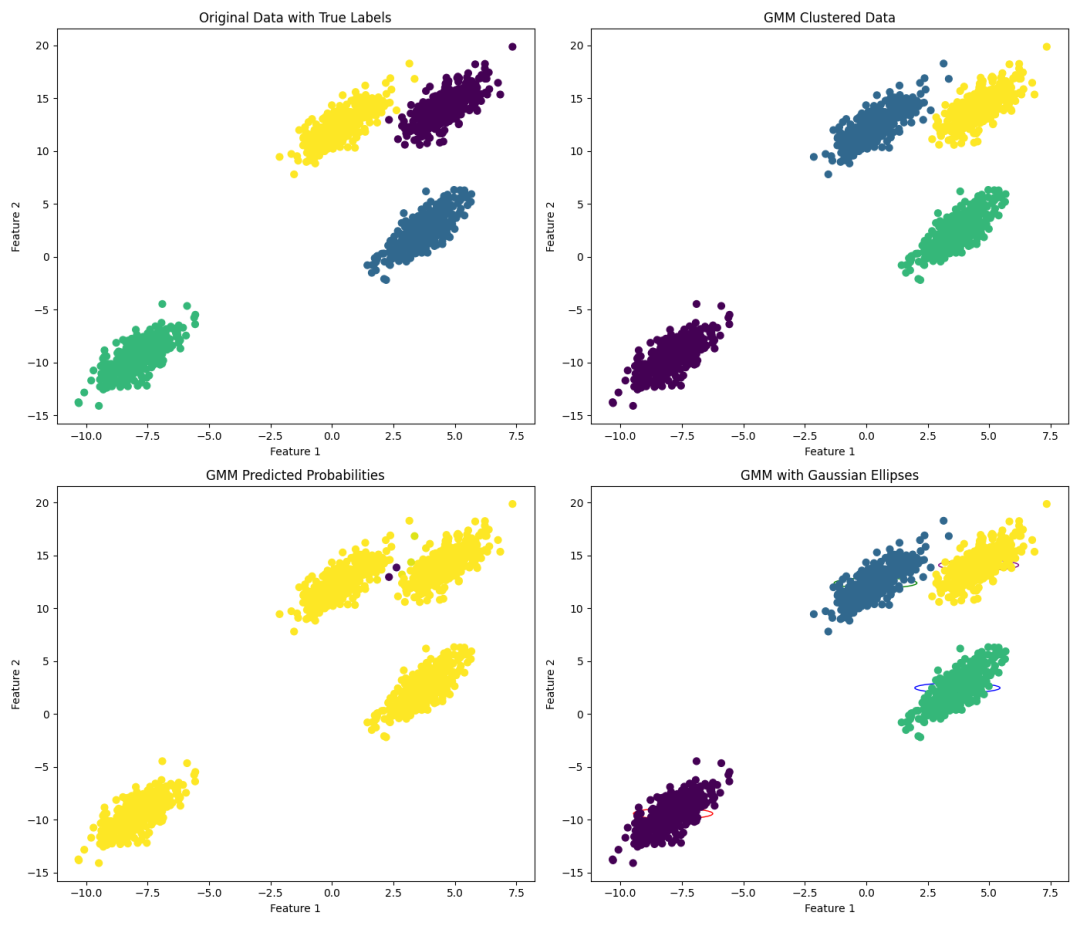
- 子图 1:原始数据集的散点图,标注真实类别。
- 子图 2:GMM 聚类结果散点图,不同颜色表示不同聚类结果。
- 子图 3:GMM 预测概率分布,颜色代表数据点属于最可能聚类的概率。
- 子图 4:在散点图上绘制 GMM 中每个高斯分布对应的椭圆,表示模型学习到的分布形状和大小。
5. 均值漂移
均值漂移 (Mean Shift) 是一种基于密度梯度上升的聚类算法。它通过不断迭代地移动点到密度更高的区域,最终汇聚到密度峰值,从而形成簇。
算法原理
Mean Shift 的基本思想是:
- 初始化一个随机点,然后在它的邻域内找到质心(数据点的加权均值)。
- 将点移动到这个质心位置。
- 重复上述过程,直到点不再移动。
最终,所有点都将汇聚到数据密度的高峰处,形成不同的簇。
核心公式
Mean Shift 的核心公式如下:
$$
m(x) = \frac{\sum_{x_i \in N(x)} K(x_i - x) x_i}{\sum_{x_i \in N(x)} K(x_i - x)}
$$
其中:
- m(x) 是新的质心位置。
- x 是当前点的位置。
- x_i 是邻域 N(x) 内的点。
- K 是核函数(常用高斯核)。
核心公式推导
- 密度估计:给定点 x,其核密度估计为:
$$
\hat{f}(x) = \frac{1}{n h^d} \sum_{i=1}^n K\left(\frac{x - x_i}{h}\right)
$$
- 梯度上升:对密度函数求导,得到均值漂移向量,表示点 x 应该移动的方向和距离。
- 迭代:不断更新点的位置,直到收敛到密度峰值。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import MeanShift
from sklearn.datasets import make_blobs
from sklearn.preprocessing import StandardScaler
from itertools import cycle

# 生成虚拟数据集
centers = [[1, 1], [5, 5], [8, 1], [8, 8]]
cluster_std = [0.4, 0.5, 0.3, 0.7]  # 每个簇的标准差不同,增加复杂度
X, _ = make_blobs(n_samples=1000, centers=centers, cluster_std=cluster_std, random_state=42)

# 标准化数据集
X = StandardScaler().fit_transform(X)

# 应用均值漂移算法
mean_shift = MeanShift(bin_seeding=True)
mean_shift.fit(X)
labels = mean_shift.labels_
cluster_centers = mean_shift.cluster_centers_
n_clusters = len(np.unique(labels))

# 颜色配置
colors = cycle('bgrcmykbgrcmykbgrcmykbgrcmyk')

# 创建图像
plt.figure(figsize=(18, 8))

# 图1:原始数据分布
plt.subplot(1, 3, 1)
plt.title('Original Data Distribution')
for k, col in zip(range(n_clusters), colors):
    my_members = (labels == k)
    plt.plot(X[my_members, 0], X[my_members, 1], col + '.')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=300, c='yellow', marker='x')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')

# 图2:基于密度的均值漂移算法的结果
plt.subplot(1, 3, 2)
plt.title('Mean Shift Clustering')
for k, col in zip(range(n_clusters), colors):
    my_members = (labels == k)
    plt.plot(X[my_members, 0], X[my_members, 1], col + '.')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=300, c='yellow', marker='x')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')

# 图3:簇分布密度的2D直方图
plt.subplot(1, 3, 3)
plt.title('Cluster Density 2D Histogram')
plt.hist2d(X[:, 0], X[:, 1], bins=50, cmap='jet')
plt.colorbar(label='Density')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=100, c='white', edgecolor='black', marker='x')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')

plt.tight_layout()
plt.show()
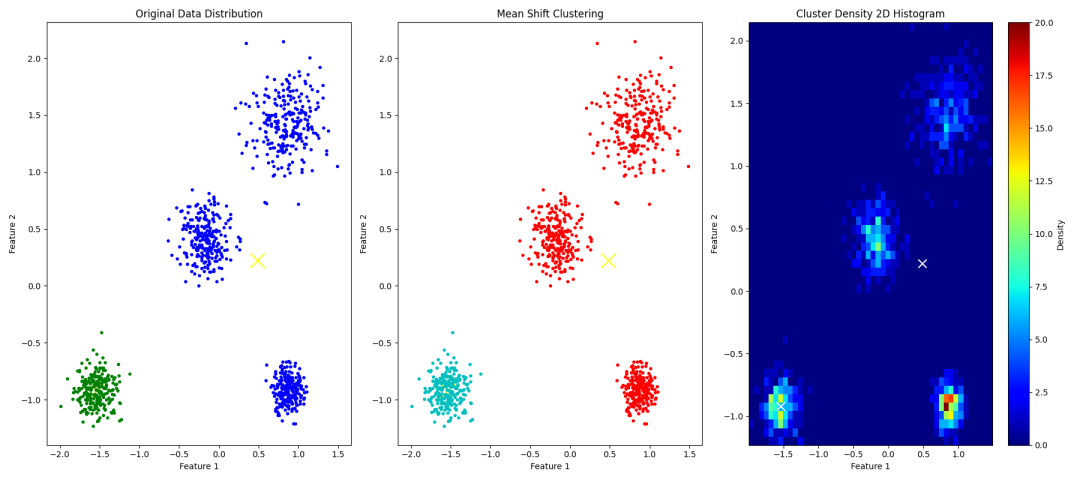
- 图 1:展示原始数据分布。
- 图 2:展示均值漂移后的聚类结果。
- 图 3:使用 2D 直方图展示簇分布密度。
6. 模糊 C 均值
模糊 C 均值 (Fuzzy C-Means, FCM) 是一种允许一个数据点同时属于多个簇的聚类算法。每个数据点对每个簇都有一个隶属度,隶属度的和为 1。算法通过最小化加权平方和来确定簇的质心。
算法原理
FCM 的基本思想是通过迭代优化隶属度和质心,使得数据点更接近它们的质心,并且隶属度反映数据点对不同簇的归属程度。
算法步骤:
- 初始化隶属度矩阵 U,其中每个元素表示数据点 x_i 对簇 j 的隶属度。
- 计算每个簇的质心。
- 更新隶属度矩阵 U。
- 重复步骤 2 和 3,直到隶属度矩阵收敛。
核心公式
FCM 的目标是最小化以下目标函数:
$$
J = \sum_{i=1}^{N} \sum_{j=1}^{C} u_{ij}^m \| x_i - v_j \|^2
$$
其中:
- u_{ij} 是数据点 x_i 对簇 j 的隶属度。
- m 是模糊化参数,通常 m > 1。
- v_j 是簇 j 的质心。
核心公式推导
- 初始化隶属度矩阵:随机初始化 U,使每行隶属度求和为 1。
- 优化目标函数:分别对 vj 和 u{ij} 求导并设为零。
- 质心更新公式:
$$
v_j = \frac{\sum_{i=1}^N u_{ij}^m x_i}{\sum_{i=1}^N u_{ij}^m}
$$
- 隶属度更新公式:
$$
u_{ij} = \frac{1}{\sum_{k=1}^C \left( \frac{\| x_i - v_j \|}{\| x_i - v_k \|} \right)^{\frac{2}{m-1}}}
$$
- 迭代直到收敛。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
import skfuzzy as fuzz
from scipy.interpolate import griddata

# 生成虚拟数据集
n_samples = 1500
centers = [[2, 2], [8, 3], [5, 8]]
cluster_std = [1.0, 1.0, 1.0]
X, y = make_blobs(n_samples=n_samples, centers=centers, cluster_std=cluster_std, random_state=42)

# 模糊C均值聚类
cntr, u, u0, d, jm, p, fpc = fuzz.cluster.cmeans(X.T, 3, 2, error=0.005, maxiter=1000, init=None)

# 聚类结果分类
cluster_labels = np.argmax(u, axis=0)

# 为绘制等高线图准备网格数据
x = np.linspace(X[:, 0].min() - 1, X[:, 0].max() + 1, 100)
y = np.linspace(X[:, 1].min() - 1, X[:, 1].max() + 1, 100)
X_grid, Y_grid = np.meshgrid(x, y)
grid_points = np.c_[X_grid.ravel(), Y_grid.ravel()]

# 使用griddata对模糊隶属度进行插值
Z = np.zeros((X_grid.shape[0], X_grid.shape[1], 3))

for j in range(3):
    # 插值每个网格点的隶属度
    Z[:, :, j] = griddata(X, u[j], grid_points, method='linear').reshape(X_grid.shape)

# 绘图
fig, ax = plt.subplots(1, 3, figsize=(18, 6))

# 原始数据的散点图
ax[0].scatter(X[:, 0], X[:, 1], c='gray', marker='o', s=30, edgecolor='k', alpha=0.5)
ax[0].set_title('Original Data', fontsize=15)
ax[0].set_xlabel('Feature 1')
ax[0].set_ylabel('Feature 2')

# 模糊隶属度的等高线图
for j in range(3):
    ax[1].contourf(X_grid, Y_grid, Z[:, :, j], alpha=0.8, levels=np.linspace(0, 1, 11))
ax[1].scatter(X[:, 0], X[:, 1], c='gray', marker='o', s=30, edgecolor='k', alpha=0.5)
ax[1].set_title('Fuzzy Membership Contours', fontsize=15)
ax[1].set_xlabel('Feature 1')
ax[1].set_ylabel('Feature 2')

# 聚类结果的散点图
colors = ['r', 'g', 'b']
for i in range(3):
    ax[2].scatter(X[cluster_labels == i, 0], X[cluster_labels == i, 1], c=colors[i], marker='o', s=50, edgecolor='k', label=f'Cluster {i+1}')
ax[2].set_title('Clustered Data (FCM)', fontsize=15)
ax[2].set_xlabel('Feature 1')
ax[2].set_ylabel('Feature 2')
ax[2].legend()

plt.tight_layout()
plt.show()
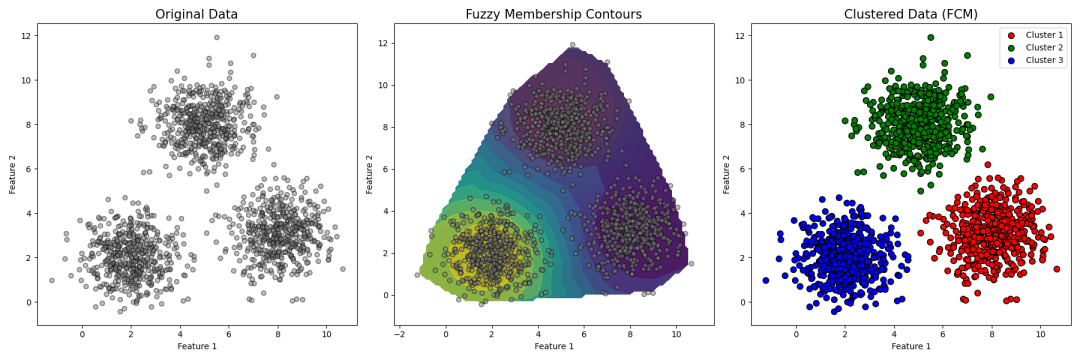
- 原始数据散点图:显示未聚类的数据分布。
- 模糊隶属度等高线图:显示每个点对不同簇的隶属度,使用等高线表示强弱。
- 聚类结果散点图:显示聚类后每个数据点的类别。
7. 期望最大化算法
EM 算法是一种常用的最大似然估计方法,适用于含有隐变量的统计模型。它通过迭代期望步骤(E 步)和最大化步骤(M 步)来估计模型参数,直到参数收敛。
算法原理
EM 算法主要用于处理含有隐变量的概率模型,例如高斯混合模型。在 E 步中估计隐变量的期望值;在 M 步中最大化似然函数更新参数。
算法步骤:
- 初始化:初始化模型参数。
- E 步骤:计算隐变量的期望值。
- M 步骤:更新模型参数以最大化似然函数。
- 迭代:重复 E 步骤和 M 步骤,直到参数收敛。
核心公式
EM 算法的目标是最大化对数似然函数:
$$
\log \mathcal{L}(\theta) = \log P(X \mid \theta) = \log \sum_Z P(X, Z \mid \theta)
$$
其中:
- θ 是模型参数。
- X 是观察数据。
- Z 是隐变量。
核心公式推导
- E 步骤:计算隐变量的条件期望:
$$
Q(\theta, \theta^t) = E_{Z \mid X, \theta^t}[\log P(X, Z \mid \theta)]
$$
- M 步骤:最大化 Q 函数以更新参数:
$$
\theta^{t+1} = \arg\max_\theta Q(\theta, \theta^t)
$$
- 迭代:重复上述步骤,直到参数收敛。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.mixture import GaussianMixture
from matplotlib.patches import Ellipse

# 设置随机种子,保证结果可复现
np.random.seed(42)

# 生成虚拟数据集
n_samples = 1500

# 高斯分布1
mean1 = [-5, 0]
cov1 = [[3, 1], [1, 2]]
data1 = np.random.multivariate_normal(mean1, cov1, int(0.4 * n_samples))

# 高斯分布2
mean2 = [0, 10]
cov2 = [[2, -1], [-1, 2]]
data2 = np.random.multivariate_normal(mean2, cov2, int(0.3 * n_samples))

# 高斯分布3
mean3 = [10, 5]
cov3 = [[1, 0.5], [0.5, 1]]
data3 = np.random.multivariate_normal(mean3, cov3, int(0.3 * n_samples))

# 合并数据集
X = np.vstack((data1, data2, data3))

# 可视化初始数据
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.scatter(X[:, 0], X[:, 1], s=10, color='purple', alpha=0.6)
plt.title('Initial Data Distribution')
plt.xlabel('X1')
plt.ylabel('X2')

# 使用期望最大化算法(EM算法)
gmm = GaussianMixture(n_components=3, covariance_type='full', random_state=42)
gmm.fit(X)

# 获取初始的高斯分布参数
def plot_gaussian_ellipse(mean, cov, ax, color='black'):
    # 计算椭圆的宽度和高度
    v, w = np.linalg.eigh(cov)
    v = 2. * np.sqrt(2.) * np.sqrt(v)  # width and height of ellipse
    # 计算椭圆的角度
    u = w[0] / np.linalg.norm(w[0])
    angle = np.arctan2(u[1], u[0])  # 计算旋转角度
    angle = np.degrees(angle)  # 从弧度转换为度
    # 创建并添加椭圆
    ell = Ellipse(xy=mean, width=v[0], height=v[1], angle=angle, color=color, alpha=0.4)
    ell.set_clip_box(ax.bbox)
    ax.add_patch(ell)

# 可视化EM算法拟合的高斯分布
ax2 = plt.subplot(2, 2, 2)
plt.scatter(X[:, 0], X[:, 1], s=10, color='purple', alpha=0.6)
for i in range(gmm.n_components):
    plot_gaussian_ellipse(gmm.means_[i], gmm.covariances_[i], ax2, color='blue')
plt.title('Gaussian Mixture Model - Initial Fitting')
plt.xlabel('X1')
plt.ylabel('X2')

# 预测类别
labels = gmm.predict(X)

# 可视化聚类结果
ax3 = plt.subplot(2, 2, 3)
colors = ['red', 'green', 'blue']
for i in range(gmm.n_components):
    plt.scatter(X[labels == i, 0], X[labels == i, 1], s=10, color=colors[i], alpha=0.6)
    plot_gaussian_ellipse(gmm.means_[i], gmm.covariances_[i], ax3, color=colors[i])
plt.title('Final Clustering Result')
plt.xlabel('X1')
plt.ylabel('X2')

# 可视化EM算法收敛过程的对数似然值
ax4 = plt.subplot(2, 2, 4)
try:
    # 检查 gmm.lower_bound_ 是否是一个可迭代对象
    if hasattr(gmm, 'lower_bound_') and isinstance(gmm.lower_bound_, np.ndarray):
        n_iter = np.arange(1, len(gmm.lower_bound_) + 1)
        plt.plot(n_iter, gmm.lower_bound_, marker='o', color='orange', linestyle='--')
    else:
        plt.text(0.5, 0.5, 'Log Likelihood Data Unavailable', horizontalalignment='center', verticalalignment='center')
except AttributeError:
    plt.text(0.5, 0.5, 'Log Likelihood Data Unavailable', horizontalalignment='center', verticalalignment='center')
plt.title('EM Algorithm Convergence')
plt.xlabel('Iterations')
plt.ylabel('Log Likelihood')

plt.tight_layout()
plt.show()
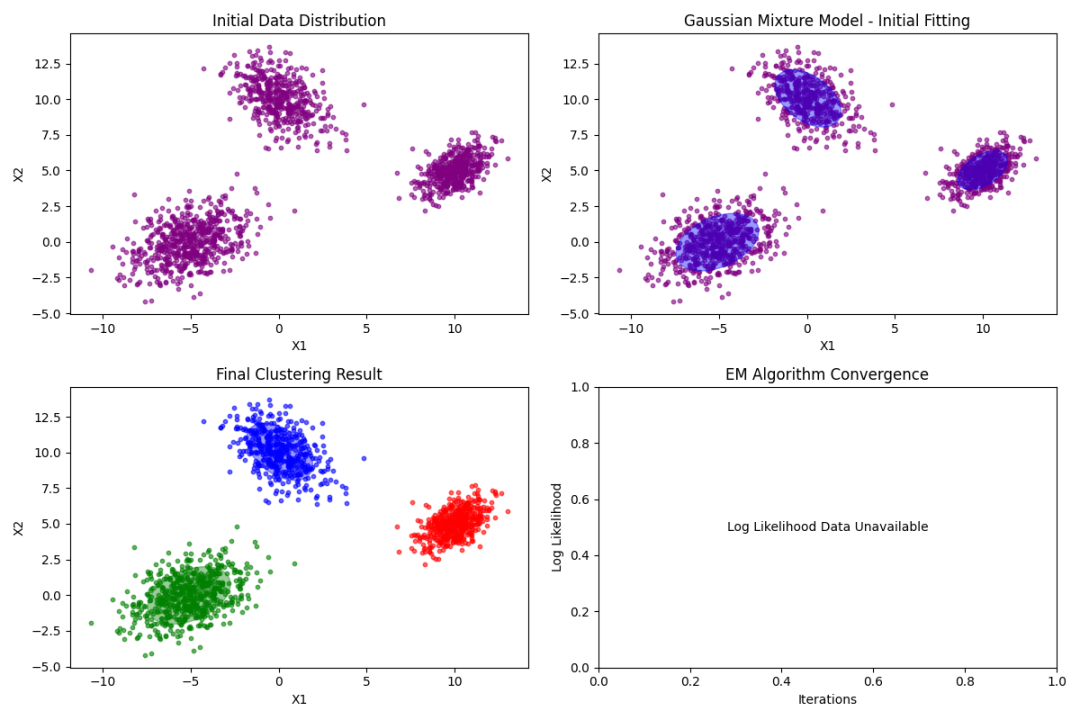
- 第一个图展示初始数据分布。
- 第二个图展示 EM 算法初始的高斯分布拟合结果。
- 第三个图展示最终聚类结果和每个聚类的高斯分布拟合情况。
- 第四个图展示 EM 算法对数似然值随迭代次数的收敛曲线。
8. 谱聚类
谱聚类是一种利用图论和线性代数方法进行聚类的算法。它通过对相似度矩阵进行谱分解,将数据点映射到低维空间,然后在低维空间中应用传统聚类方法(如 K-Means)。
算法原理
谱聚类基于以下步骤:
- 构建相似度矩阵:计算数据点之间的相似度,构建相似度矩阵 W。
- 计算拉普拉斯矩阵:计算图的拉普拉斯矩阵 L,其中 L = D - W,D 是度矩阵。
- 谱分解:对拉普拉斯矩阵 L 进行特征值分解,选择前 k 个特征向量。
- 聚类:将特征向量组成的矩阵作为新特征空间,在新特征空间中应用 K-Means 聚类。
核心公式
谱聚类的关键是拉普拉斯矩阵 L 的定义和谱分解:
$$
L = D - W
$$
其中:
- W 是相似度矩阵。
- D 是度矩阵,其对角元素 D_{ii} = ∑j W{ij}。
核心公式推导
- 拉普拉斯矩阵:构建拉普拉斯矩阵 L,它捕捉图的全局结构。
- 谱分解:对 L 进行特征值分解:
$$
L v = \lambda v
$$
- 低维嵌入:选择前 k 个最小特征值对应的特征向量,形成新的特征空间。
- 聚类:在新特征空间中应用 K-Means 聚类。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import SpectralClustering
from sklearn.metrics import pairwise_distances
from sklearn.preprocessing import normalize

# 生成虚拟数据集
n_samples = 1000
n_features = 2
centers = 4
cluster_std = [1.0, 2.5, 0.5, 1.5]
X, y = make_blobs(n_samples=n_samples, n_features=n_features,
                  centers=centers, cluster_std=cluster_std, random_state=42)

# 应用 Spectral Clustering
spectral = SpectralClustering(n_clusters=4, affinity='rbf',
                              gamma=1.0, random_state=42)
y_spectral = spectral.fit_predict(X)

# 计算相似度矩阵
similarity_matrix = np.exp(-pairwise_distances(X, metric='sqeuclidean'))
similarity_matrix = normalize(similarity_matrix, norm='l1', axis=1)

# 设置绘图
fig, axs = plt.subplots(2, 2, figsize=(14, 12))

# 原始数据集的散点图
axs[0, 0].scatter(X[:, 0], X[:, 1], c=y, cmap='viridis', s=50)
axs[0, 0].set_title('Original Dataset with True Labels', fontsize=16)
axs[0, 0].set_xlabel('Feature 1')
axs[0, 0].set_ylabel('Feature 2')

# Spectral Clustering 结果的散点图
axs[0, 1].scatter(X[:, 0], X[:, 1], c=y_spectral, cmap='rainbow', s=50)
axs[0, 1].set_title('Spectral Clustering Results', fontsize=16)
axs[0, 1].set_xlabel('Feature 1')
axs[0, 1].set_ylabel('Feature 2')

# 相似度矩阵的热力图
cax = axs[1, 0].imshow(similarity_matrix, cmap='hot', aspect='auto')
fig.colorbar(cax, ax=axs[1, 0])
axs[1, 0].set_title('Similarity Matrix (Heatmap)', fontsize=16)
axs[1, 0].set_xlabel('Sample Index')
axs[1, 0].set_ylabel('Sample Index')

# 聚类后的样本数量柱状图
unique, counts = np.unique(y_spectral, return_counts=True)
axs[1, 1].bar(unique, counts, color=['red', 'green', 'blue', 'orange'])
axs[1, 1].set_title('Number of Samples per Cluster', fontsize=16)
axs[1, 1].set_xlabel('Cluster Label')
axs[1, 1].set_ylabel('Number of Samples')

# 调整布局
plt.tight_layout()
plt.show()
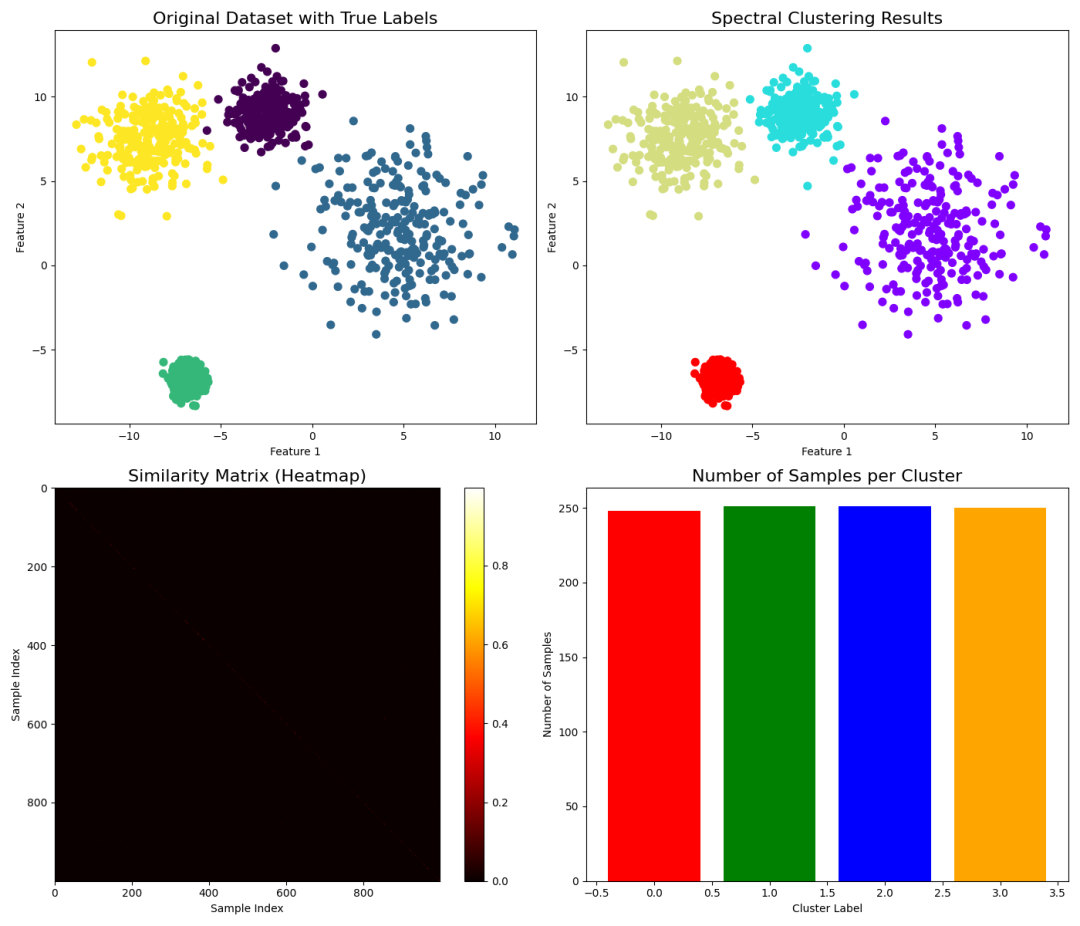
- 原始数据集散点图:展示数据集中真实标签分布。
- 谱聚类结果散点图:展示谱聚类得到的聚类结果。
- 相似度矩阵热力图:展示样本间相似度矩阵。
- 聚类后样本数量柱状图:展示每个簇中的样本数量。
9. Birch
Birch 是一种基于层次聚类思想的聚类算法,特别适用于处理大规模数据集。它通过构建树结构来有效地进行数据聚类。
算法原理
Birch 算法的主要步骤是:
- 构建 CF 树(Clustering Feature Tree):将数据点插入到 CF 树中,形成簇的层次结构。
- 聚类:根据 CF 树进行聚类,得到最终簇。
核心公式
CF 树的核心是 Clustering Feature(CF)的定义:
$$
CF = (N, LS, SS)
$$
其中:
- N 是数据点的数量。
- LS 是数据点的均值向量的总和。
- SS 是数据点的平方和。
核心公式推导
- CF 计算:对每个簇计算 CF 值,更新公式为:
$$
N \leftarrow N + 1
$$
$$
LS \leftarrow LS + x
$$
$$
SS \leftarrow SS + x^2
$$
- 树结构:使用 CF 值构建 CF 树,并根据树的层次结构进行聚类。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import Birch
from sklearn.datasets import make_blobs
from mpl_toolkits.mplot3d import Axes3D
from sklearn.decomposition import PCA

# 生成虚拟数据集(高维数据)
n_samples = 1500
n_features = 10  # 生成更多的特征
random_state = 170
X, y = make_blobs(n_samples=n_samples, n_features=n_features, random_state=random_state, centers=6, cluster_std=1.0)

# 通过 PCA 将数据降维到3维
pca = PCA(n_components=3)
X_pca = pca.fit_transform(X)

# 应用Birch聚类算法
birch_model = Birch(threshold=1.5, n_clusters=6)  # 设置 n_clusters 参数
y_pred = birch_model.fit_predict(X)

# 创建图形
fig = plt.figure(figsize=(18, 9))

# 2D Scatter plot of original data
ax1 = fig.add_subplot(231)
ax1.scatter(X[:, 0], X[:, 1], c=y, cmap='rainbow', s=10)
ax1.set_title('Original Data (2D)')
ax1.set_xlabel('Feature 1')
ax1.set_ylabel('Feature 2')

# 2D Scatter plot of PCA reduced data
ax2 = fig.add_subplot(232)
ax2.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='rainbow', s=10)
ax2.set_title('PCA Reduced Data (2D)')
ax2.set_xlabel('Principal Component 1')
ax2.set_ylabel('Principal Component 2')

# 2D Scatter plot of Birch clusters
ax3 = fig.add_subplot(233)
ax3.scatter(X[:, 0], X[:, 1], c=y_pred, cmap='rainbow', s=10)
ax3.set_title('Birch Clustering (2D)')
ax3.set_xlabel('Feature 1')
ax3.set_ylabel('Feature 2')

# 3D Scatter plot of original data
ax4 = fig.add_subplot(234, projection='3d')
ax4.scatter(X_pca[:, 0], X_pca[:, 1], X_pca[:, 2], c=y, cmap='rainbow', s=10)
ax4.set_title('Original Data (3D)')
ax4.set_xlabel('Principal Component 1')
ax4.set_ylabel('Principal Component 2')
ax4.set_zlabel('Principal Component 3')

# 3D Scatter plot of Birch clusters
ax5 = fig.add_subplot(235, projection='3d')
ax5.scatter(X_pca[:, 0], X_pca[:, 1], X_pca[:, 2], c=y_pred, cmap='rainbow', s=10)
ax5.set_title('Birch Clustering (3D)')
ax5.set_xlabel('Principal Component 1')
ax5.set_ylabel('Principal Component 2')
ax5.set_zlabel('Principal Component 3')

plt.tight_layout()
plt.show()
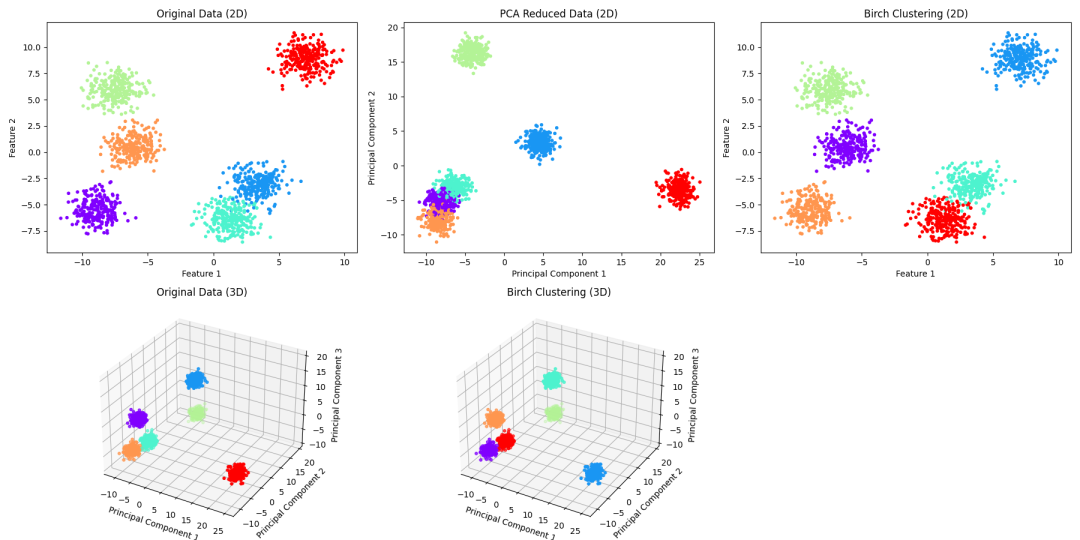
- 2D 图展示原始数据和 PCA 降维后的数据。
- 3D 图展示原始数据和 PCA 降维后的数据。
- Birch 聚类结果在 2D 和 3D 图中均有展示。
10. Affinity Propagation
Affinity Propagation 是一种基于消息传递的聚类算法,它通过在数据点之间传递“责任”和“可用性”消息来寻找簇的中心。它不需要预设簇的数量。
算法原理
Affinity Propagation 的主要步骤是:
- 计算相似度矩阵:计算数据点之间的相似度(通常为负距离)。
- 初始化消息:初始化每对点之间的责任和可用性消息。
- 迭代更新消息:通过迭代更新责任和可用性消息,直到收敛。
- 确定簇中心:根据最终的消息确定簇中心。
核心公式
消息传递的核心公式包括责任消息 r(i,k) 和可用性消息 a(i,k):
- 责任消息 r(i,k):表示点 i 对点 k 的责任:
$$
r(i,k) \leftarrow s(i,k) - \max_{k' \ne k} \left(a(i,k') + s(i,k')\right)
$$
- 可用性消息 a(i,k):表示点 k 对点 i 的可用性:
$$
a(i,k) \leftarrow \min\left(0, r(k,k) + \sum_{i' \notin \{i,k\}} \max(0, r(i',k))\right)
$$
对于 k = i,可用性更新为:
$$
a(k,k) \leftarrow \sum_{i' \ne k} \max(0, r(i',k))
$$
核心公式推导
- 责任消息:当前点 i 对簇中心 k 的责任。
- 可用性消息:点 k 对点 i 的可用性。
- 迭代:不断更新责任消息和可用性消息,直到所有消息收敛,最终确定簇中心。
Python 案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import AffinityPropagation
from sklearn.datasets import make_blobs
from sklearn.metrics import pairwise_distances
import matplotlib.cm as cm

# 设置随机种子
np.random.seed(42)

# 生成虚拟数据集
n_samples = 500
centers = [[1, 1], [-1, -1], [1, -1], [-1, 1]]
cluster_std = [0.2, 0.3, 0.2, 0.3]
X, _ = make_blobs(n_samples=n_samples, centers=centers, cluster_std=cluster_std)

# 计算相似性矩阵(负欧氏距离)
similarity = -pairwise_distances(X, metric='euclidean')

# 使用Affinity Propagation进行聚类
af = AffinityPropagation(affinity='precomputed', random_state=42)
af.fit(similarity)
cluster_centers_indices = af.cluster_centers_indices_
labels = af.labels_

# 获取不同的聚类中心和标签
n_clusters = len(cluster_centers_indices)

# 设置颜色映射
cmap = cm.get_cmap('hsv')
colors = cmap(np.linspace(0, 1, n_clusters))

# 创建一个图形
fig, axes = plt.subplots(1, 2, figsize=(18, 7))

# 绘制第一个图形:聚类结果的散点图
for k, col in zip(range(n_clusters), colors):
    class_members = (labels == k)
    cluster_center = X[cluster_centers_indices[k]]
    axes[0].plot(X[class_members, 0], X[class_members, 1], '.', color=col, markersize=10, label=f'Cluster {k+1}')
    axes[0].plot(cluster_center[0], cluster_center[1], 'o', markerfacecolor=col,
                 markeredgecolor='k', markersize=20)
for x in X[class_members]:
        axes[0].plot([cluster_center[0], x[0]], [cluster_center[1], x[1]], color=col, alpha=0.5)

axes[0].set_title(f'Affinity Propagation Clustering\nwith {n_clusters} Clusters')
axes[0].legend()

# 绘制第二个图形:簇中心距离的热力图
distances = pairwise_distances(X[cluster_centers_indices], metric='euclidean')
im = axes[1].imshow(distances, interpolation='nearest', cmap='plasma')
axes[1].set_title('Cluster Center Distance Heatmap')
plt.colorbar(im, ax=axes[1])

# 设置图形整体标题
plt.suptitle('Affinity Propagation Clustering Analysis', fontsize=16)

# 展示图形
plt.show()
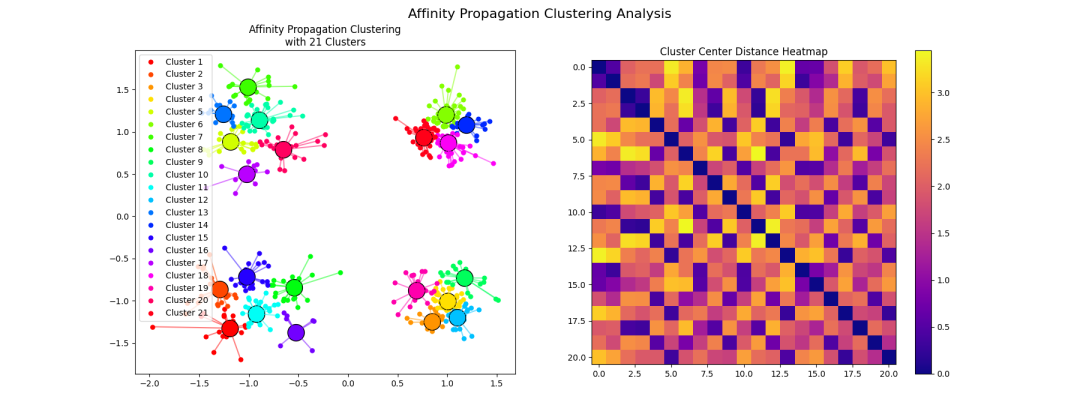
- 散点图:展示每个簇的数据点,并用连线连接每个点到它的簇中心。
- 热力图:展示不同簇中心之间的距离,使用热力图表示。
以上是十种常见聚类算法的核心原理、公式推导与 Python 实现。不同算法适用于不同数据分布和业务场景,建议结合实际数据规模、噪声处理需求与可解释性进行选择。在云栈社区,后续也会持续更新更多机器学习算法实践,欢迎带着具体场景来讨论。
 发表于 4 天前
|
查看: 12|
回复: 0


