你大概率也经历过这种疲惫:每次给 AI 派活,都要先把同一套规则在对话框里复制一遍。
“排版请遵守这五条格式”“Word 必须用 DXA 单位计算列宽”“不要输出大段套话”。如果你把这些规则一股脑塞进 System Prompt 或所谓的项目知识库,没过几天就会发现:上下文窗口被挤占了上万 Token,账单翻倍,模型反而更容易产生幻觉、漏看核心限制。
Anthropic 在 GitHub 开源的 anthropics/skills,就是冲着这个工程泥潭来的。它之所以能在短时间内收获超过 17 万 Star,关键在于换了一条路:把模型能力模块化、按需挂载成标准协议,而不是逼着用户堆叠更长的提示词。
项目卡片
- 项目:anthropics/skills[1]
- 状态:173k+ Star / Anthropic 官方维护 / Agent Skills 开放标准参考实现
- 一句话判断:大模型时代的可插拔“经验包”,把专业踩坑规则与自动化脚本打包成标准积木。
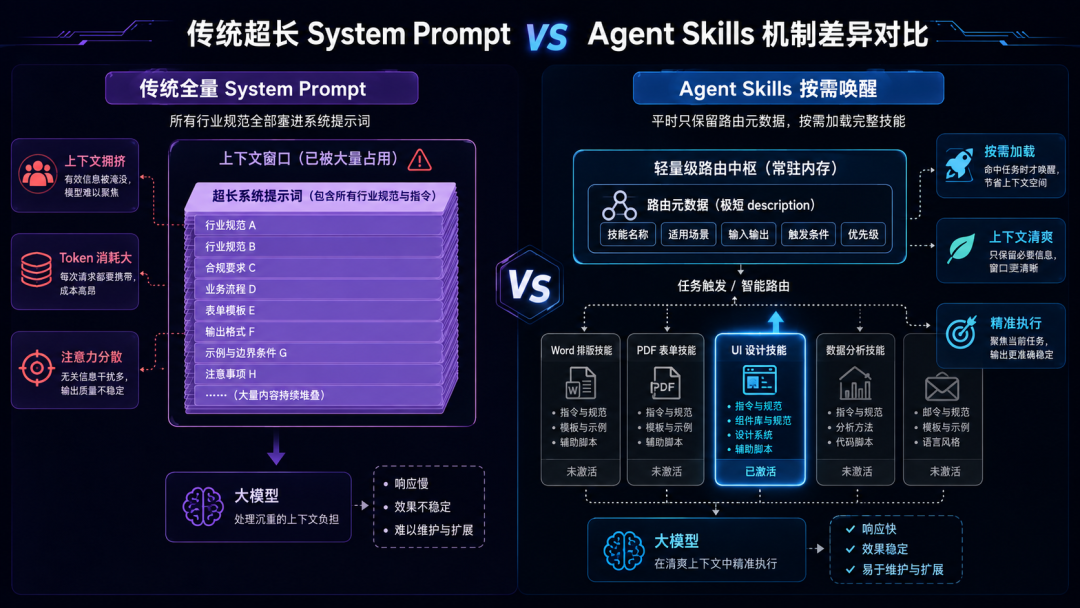
为什么提示词越叠越长,模型反而越笨?
在真正用 Agent 落地复杂任务时,开发者几乎都会撞上“上下文拥堵”这堵墙。
常规做法往往走两个极端:要么靠人工“手抄”工作流,每次新建会话贴一遍背景;要么搞一个超级庞大的系统设定,把所有领域的专业规范全部塞进开头。
把规则全部堆在前面的代价非常具体:
- 显性成本暴增:哪怕这次只是问一句日常问候,每次对话都要重复计算数千甚至上万 Token 的前置开销。
- 注意力分散:模型处理超长上下文时,“迷失在中间”(Lost in the Middle)是客观规律。规则越多,彼此打架的概率就呈指数上升。
- 缺少确定性脚手架:纯靠自然语言约束排版或文件格式,遇到边缘场景模型必然自由发挥。
Anthropic 提出的解法非常直接:把通用模型底座、外部工具(MCP)与任务专业知识(Skills)彻底解耦。
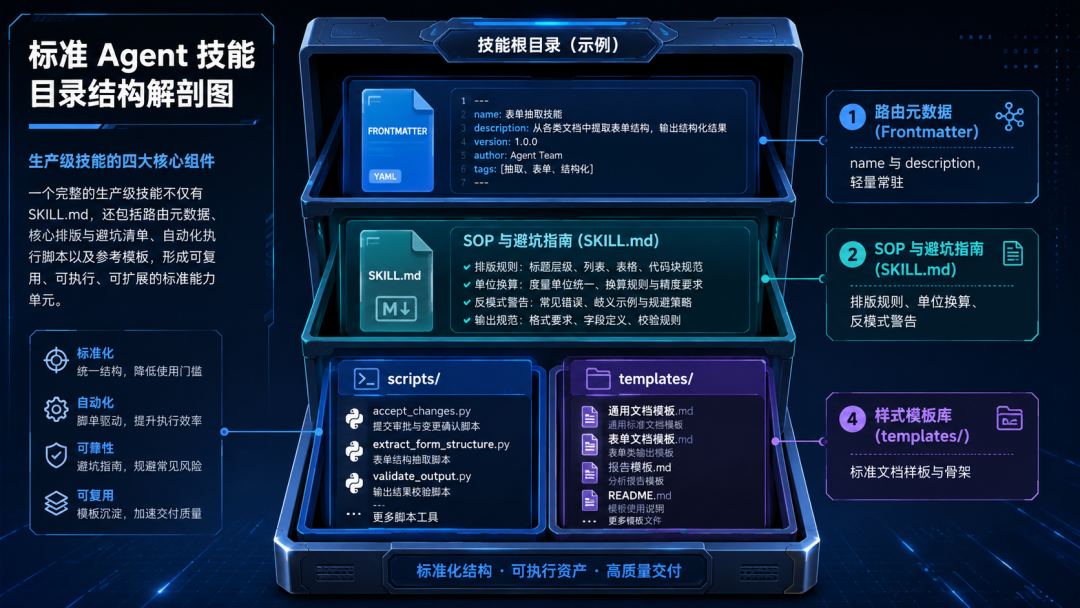
如果把 MCP 比作连接外部数据库和 API 的“外设接口”,那 Skills 就是指导 Agent 在特定场景下怎么干活的“标准作业程序”(SOP)。每个 Skill 本质上就是一个独立的文件夹,核心是一个 SKILL.md,配上可选的辅助脚本(scripts)、预设模板(templates)和参考文档(references)。
平时在 Agent 的常驻规划视野里,只挂载每个技能极短的 description(几句话的路由元数据)。只有当用户提出“帮我做一份 Word 汇报”或“给我的前端做一套 UI 主题”时,对应的全套指令与脚本才会被动态唤醒。
翻开官方源码,它教给模型的到底是什么?
很多人初看仓库可能会以为:这不就是一堆 Markdown 提示词合集吗?
真正让我改观的,是仓库里公开的生产级文档处理技能——skills/docx、skills/pdf、skills/pptx 和 skills/xlsx。这四套技能不是演示 demo,而是 Anthropic 直接从线上 Claude 官方能力里抽出来的核心资产。
点开 skills/docx/SKILL.md,你几乎看不到任何“请你扮演资深文字排版专家”这种正确的废话。正文开篇就是直击要害的工程判断:
- “.docx 本质是一个装满了 XML 文件的 ZIP 压缩包;新建走 docx-js,编辑已有文档必须解压改 document.xml 重新打包”;
- “表格排版必须做双重宽度设定(列和单元格全写死 DXA),写百分比在 Google Docs 必崩”;
- “列表绝对不要直接插入圆点字符 •,必须调用 numbering 配置”。
更关键的是,它不仅仅给规则,还把配套的 Python/Node 脚本一起塞进了目录。处理复杂 PDF 表单时,Agent 不用凭空脑补坐标,直接调用现成的 extract_form_structure.py 测量边界;处理 Word 修订时,直接运行 accept_changes.py。
这就是 Agent Skills 展现出的最大价值:它把高段位工程师踩遍深坑后总结出的死规矩和自动化工具,打包成 Agent 能直接闭环的行动资产。
普通开发者与个人用户,现在能怎么用?
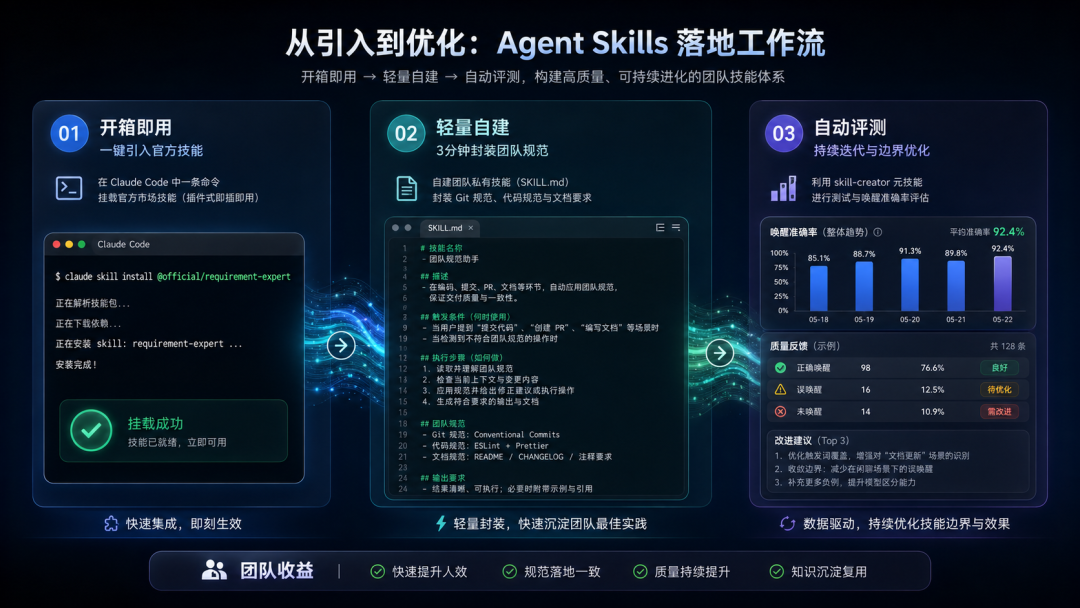
如果你只是个人日常使用,或者团队正在搭建私有 Agent 工作流,目前有三条最现实的接入路径:
1. Claude Code 终端一键挂载
如果你使用 Anthropic 的官方命令行工具 Claude Code,仓库本身就是一个现成的插件市场。只需要一条命令:
/plugin marketplace add anthropics/skills
/plugin install document-skills@anthropic-agent-skills
安装完成后,你在终端里直接对它说:“把这份需求草稿整理成带目录和封面样式的 Word 文档”,它就会自动加载 docx 技能中的格式约束与脚手架,直接生成符合排版规范的文件。
2. 直接抄作业:自建个人“专业技能包”
不需要向任何人申请权限,你自己就可以在任何支持该规范的 Agent 系统里写技能。标准极其极简:
一个名为 my-skill/ 的文件夹,里面放一个 SKILL.md:
---
name: team-git-workflow
description: "当用户准备提交代码、发起 PR 或询问分支规范时使用此技能。包含提交规范与自动化检查清单。"
---

# 团队 Git 工作流

- 提交信息必须遵守 Conventional Commits 格式。
- 禁止直接向 main 分支推送。
把团队内部最容易出错的代码规范、API 接口调用偏好、固定文档模版做成技能包,无论是放到版本库给全员共享,还是个人多端复用,都能立刻见效。
3. 搭配元技能做持续评估
仓库里还附带了一个极具启发性的技能:skills/skill-creator。它自身就是一个“技能创造者”——当你告诉它“我想做一个帮我审查 SQL 慢查询的技能”时,它会引导你明确边界、撰写规范,甚至运行评估脚本来测试技能被模型唤醒的准确率。
它的能力边界与真实代价
不过,Agent Skills 绝非没有代价的灵丹妙药。在实际应用中,有两个最容易踩坑的边界:
第一,路由准确度完全依赖 frontmatter description 的克制程度。技能的唤醒机制靠的是匹配描述。如果你的 description 写得过于宽泛(比如“在需要写代码时使用”),或者多个技能之间职责重叠,Agent 在初期规划时就会高频误唤醒,反而重新引爆上下文拥塞。高质量的技能描述必须写清楚明确的触发关键词以及“在什么情况下不要触发”。
第二,它解决的是“流程规范”而非“逻辑能力”。如果一个底层模型本身在某个编程语言或推导逻辑上欠缺基础,挂载 Skill 只能给它规范边界,无法替代模型本身的推理实力。它负责把 70 分的模型行为标准化拉升到 85 分,但不能凭空把 40 分变成 90 分。
当大模型能力越来越同质化,决定 Agent 在生产环境能否稳定落地的,不再是谁的提示词写得天花乱坠,而是谁把业务 Know-How 封装得足够轻量、可测和可复用。anthropics/skills 给出的,正是目前最接地气的一张标准答卷。
引用链接:
[1] anthropics/skills: https://github.com/anthropics/skills
 发表于 3 天前
|
查看: 2|
回复: 0


