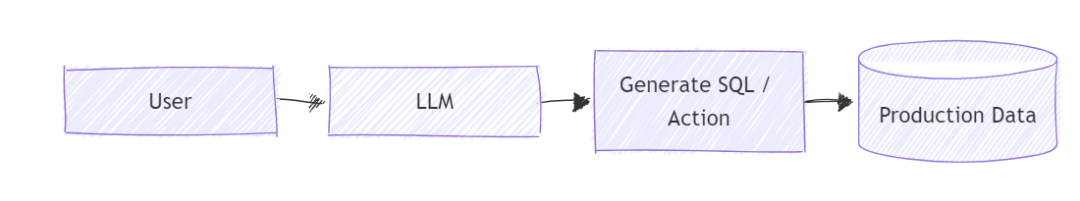
早期的数据智能应用主要围绕自然语言问数展开:用户提出一个问题,大模型完成意图理解、SQL 生成和结果解释。而当 Agent 开始参与数据接入、数仓建设、任务编排、数据治理甚至生产任务发布之后,大模型就不再只是一个“回答问题的助手”,而开始成为数据生产流程中的执行主体。
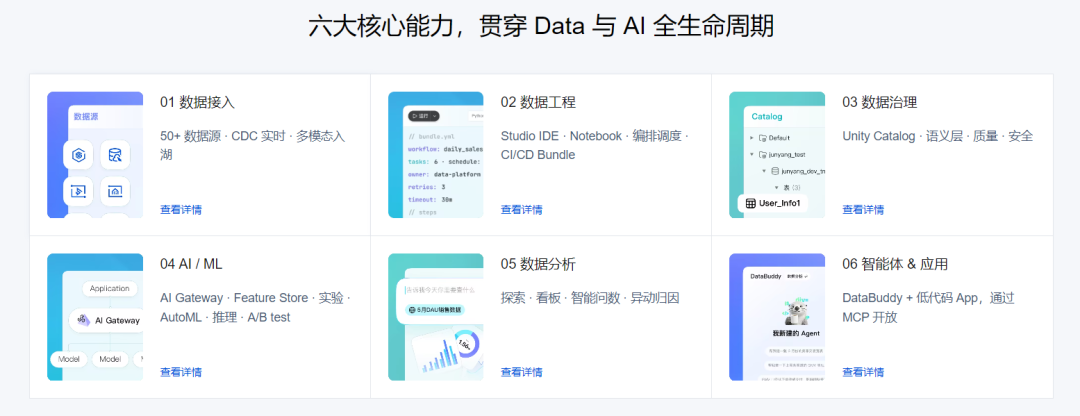
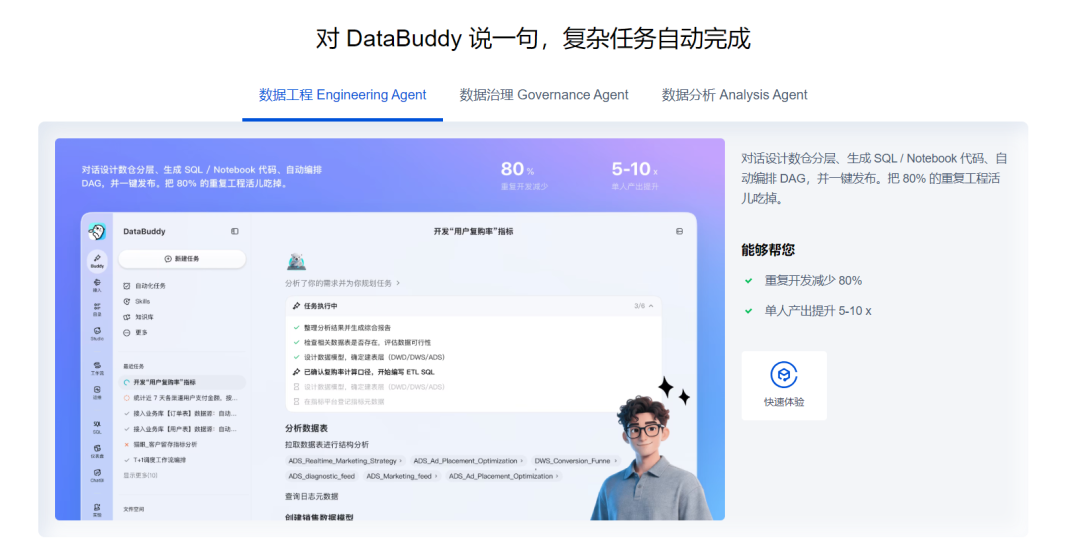
腾讯云 DataBuddy 正是在这一背景下构建的一套 Agent-Native Data + AI 数据智能平台。腾讯云将其定义为一套 Agent 原生、全托管的 Data + AI 一体化平台,通过统一元数据、统一语义层以及工程、治理、分析三类 Agent,将原本依赖人工操作的数据平台逐步转变为“AI 工作、人把关”的工作模式。
https://cloud.tencent.com/document/product/1835/135576
本文将介绍 DataBuddy 是什么以及它能够完成哪些数据工作,然后再从 Runtime、语义工程、安全治理和评测反馈几个层面分析其技术原理。
DataBuddy 是什么:把数据平台变成 Agent 的工作环境
传统数据平台主要面向人设计。数据工程师需要进入开发平台编写 SQL,配置同步任务和工作流;分析师需要进入 BI 系统定义指标和制作报表;数据管理员则需要在 Catalog、数据质量和权限系统之间完成治理工作。
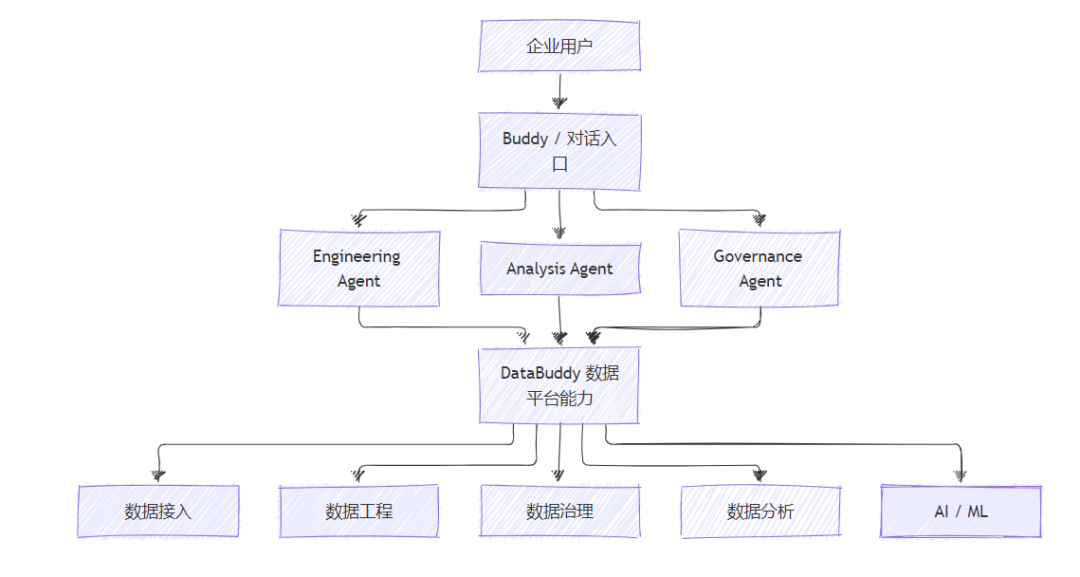
DataBuddy 把这些原本分散在不同产品和界面中的数据能力统一到 Data + AI 平台之中,并进一步把这些能力封装为 Agent 可以调用的 Tool、Skill 和 MCP 服务,让用户可以通过自然语言目标驱动数据工作。
腾讯云当前将 DataBuddy 的整体产品架构划分为业务交付层、能力平台层以及引擎与存储层,其覆盖的数据链路从数据接入一直延伸到建仓、语义化、数据消费和数据治理。
| 工作领域 |
DataBuddy 承担的工作 |
典型任务 |
| 数据接入 |
数据源连接、离线同步、CDC、数据入湖 |
将 MySQL 业务库实时同步到数据湖仓 |
| 数据工程 |
SQL 开发、数仓建模、Workflow 编排、任务运维 |
建立 ODS/DWD/DWS 并配置每日增量同步 |
| 数据分析 |
自然语言问数、指标分析、报表与 Dashboard |
分析最近三个月 GMV 变化及异常原因 |
| 数据治理 |
Catalog、血缘、质量、敏感数据、语义模型 |
发现敏感字段并建立质量规则 |
| 数据科学 |
特征、实验、模型管理和模型服务 |
完成模型训练、注册及在线部署 |
| Agent 开发 |
自定义 Agent、MCP、API、应用部署 |
构建企业自己的数据分析 Agent |
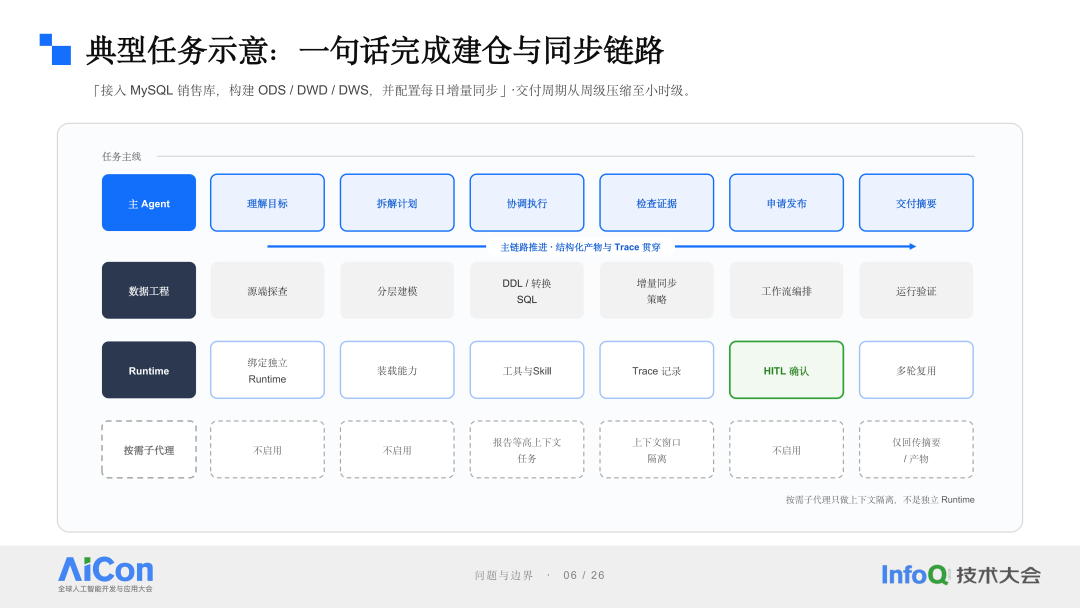
例如,用户提出:
“接入 MySQL 销售库,构建 ODS、DWD、DWS,并配置每日增量同步。”
传统平台要求工程师依次完成数据源配置、表结构探查、模型设计、DDL 编写、转换 SQL 开发、同步任务配置、工作流编排和运行验证;DataBuddy 的数据工程 Agent 则试图把这一整条链路理解成一个任务,由 Agent 完成规划,并通过 Runtime 调用平台能力逐步交付。腾讯云当前的数据工程 Agent 文档也将其描述为从需求理解一直到任务上线的完整工程链路。
DataBuddy 架构:模型负责判断,Runtime 负责执行
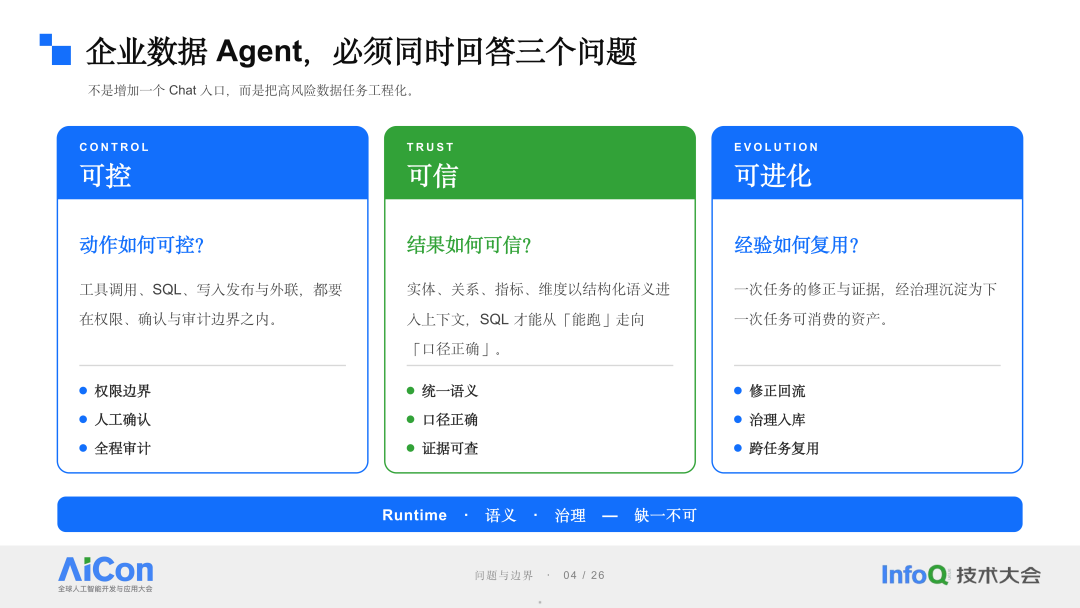
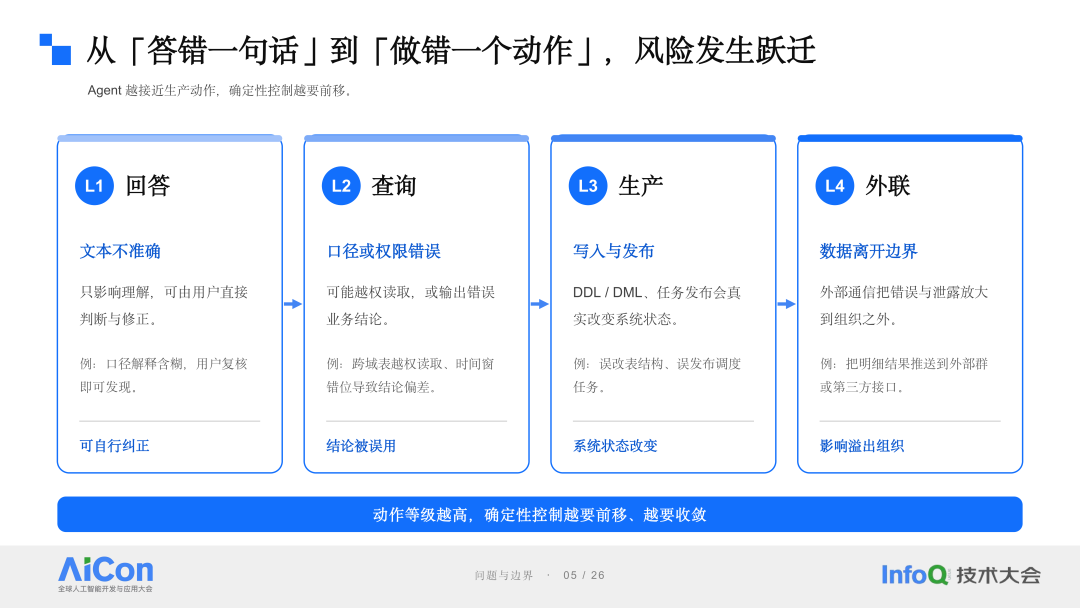
Agent 可以判断“下一步需要创建一张 DWD 表”,但是具体创建表的动作需要由 Runtime 中受约束的 Tool 执行;Agent 可以判断“这个同步任务已经准备好发布”,但是任务是否可以真正发布,需要经过 Permission 和 HITL;Agent 可以判断“应该计算订单金额”,但订单金额究竟采用哪个字段和过滤条件,则应该由统一语义层提供,而不是由模型临时猜测。
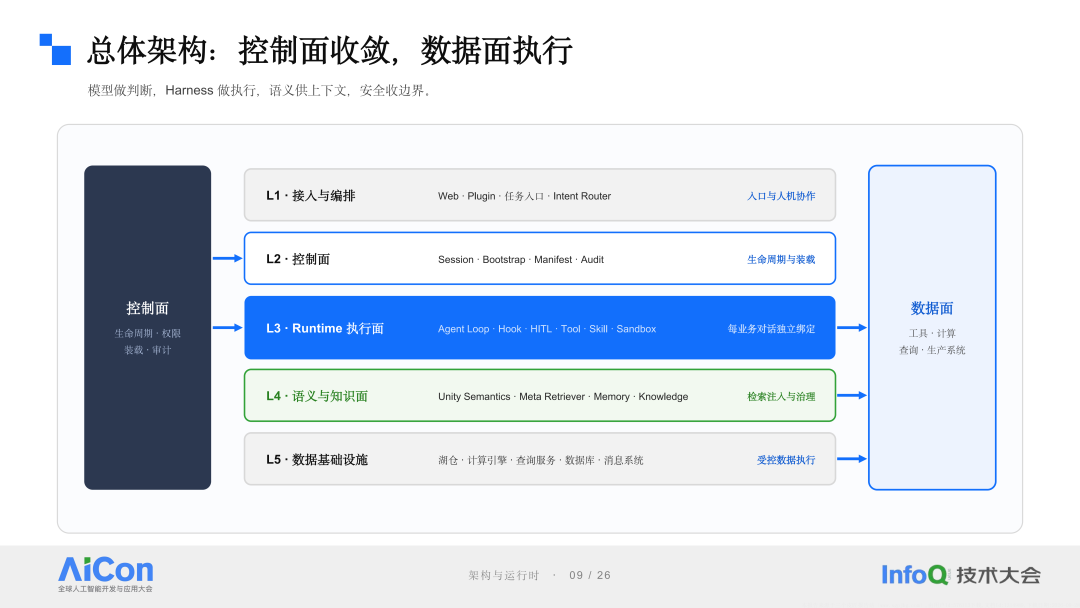
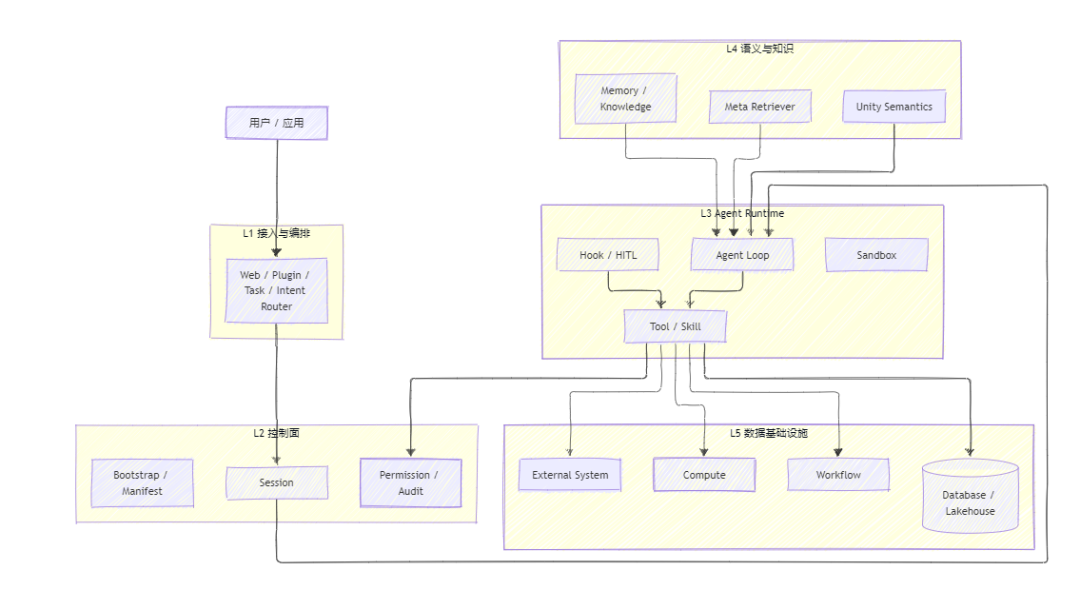
模型能够拥有多少自主判断权,以及系统应该把哪些确定性问题从模型手中拿回来。
DataBuddy Runtime:把模型判断转换成确定性动作
DataBuddy Runtime 是整套架构中承上启下的一层。报告将 Tool、Skill、Hook、HITL、Trace、Memory 和 MCP 等能力组织在 Runtime 周围,其核心思想是“把确定性交给程序,把判断留给模型”。
当用户要求 Agent “创建每天凌晨执行的增量同步任务”时,LLM 适合完成的是:
识别同步目标
→ 判断增量字段
→ 选择同步策略
→ 判断需要创建一个定时任务
但是下面这些工作并没有必要让模型自行处理:
数据库连接
任务 API 参数格式
权限验证
任务 ID 生成
调用重试
错误码处理
审计日志
DataBuddy Runtime 中不同组件承担的职责并不相同。
| 组件 |
主要职责 |
典型例子 |
| Agent |
任务理解和全局决策 |
判断需要建立 DWD 模型 |
| Tool |
确定性的原子操作 |
创建表、执行 SQL、创建 Workflow |
| Skill |
多 Tool 组成的业务 SOP |
创建增量同步任务 |
| Hook |
生命周期中的规则拦截 |
Tool 执行前进行检查 |
| HITL |
高风险动作确认 |
发布任务前询问用户 |
| Trace |
保存执行证据 |
保存 Tool Call、输入和返回结果 |
| Sandbox |
保存运行现场 |
SQL 文件、中间结果、Checkpoint |
| MCP |
标准化外部能力 |
Catalog Function、HTTP API |
腾讯云目前也把 MCP 定义为 Agent 调用 DataBuddy 内部数据资产和外部能力的统一桥梁,使 Agent 可以通过统一协议调用 Catalog Function、HTTP API 以及其他工具,而不必理解底层系统之间的协议差异。
因此,Agent 实际面对的应该是这样的能力:
create_incremental_sync(
    source_table,
    target_table,
    incremental_key,
    schedule
)
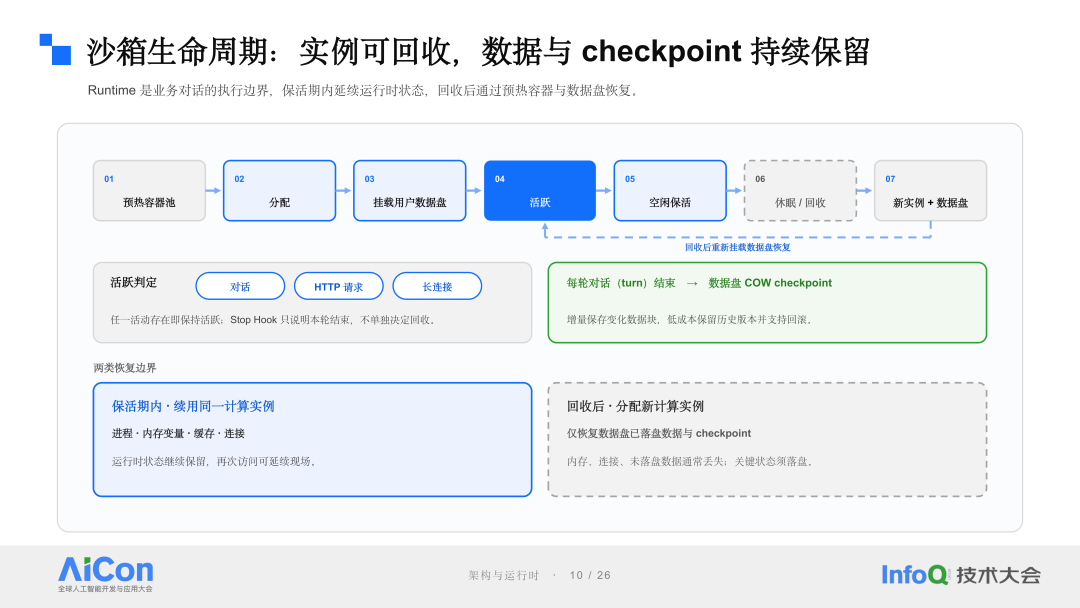
DataBuddy Sandbox:Agent 运行现场
一个简单的问数任务可能通过一两轮模型交互即可完成,而一个真实的数据工程任务可能持续几十轮,并产生模型定义、DDL、转换 SQL、任务配置和运行日志。如果系统只依赖模型的 Context Window,那么一旦上下文被压缩、截断或者会话恢复,任务执行状态就可能丢失。
DataBuddy 因此设计了独立的 Sandbox 生命周期。报告显示,Runtime 在活跃期间可以保持进程、缓存、连接和内存状态;当实例进入空闲并最终被回收之后,系统仍然会通过持久化数据盘和 COW Checkpoint 保存关键状态,并在重新分配实例之后恢复已经落盘的数据。
DataBuddy Unity Semantics:让 Agent 理解业务
数据库引擎无法告诉 Agent 哪一个才是企业当前的权威定义,而 LLM 即使生成了语法完全正确的 SQL,也可能给出错误的业务结论。
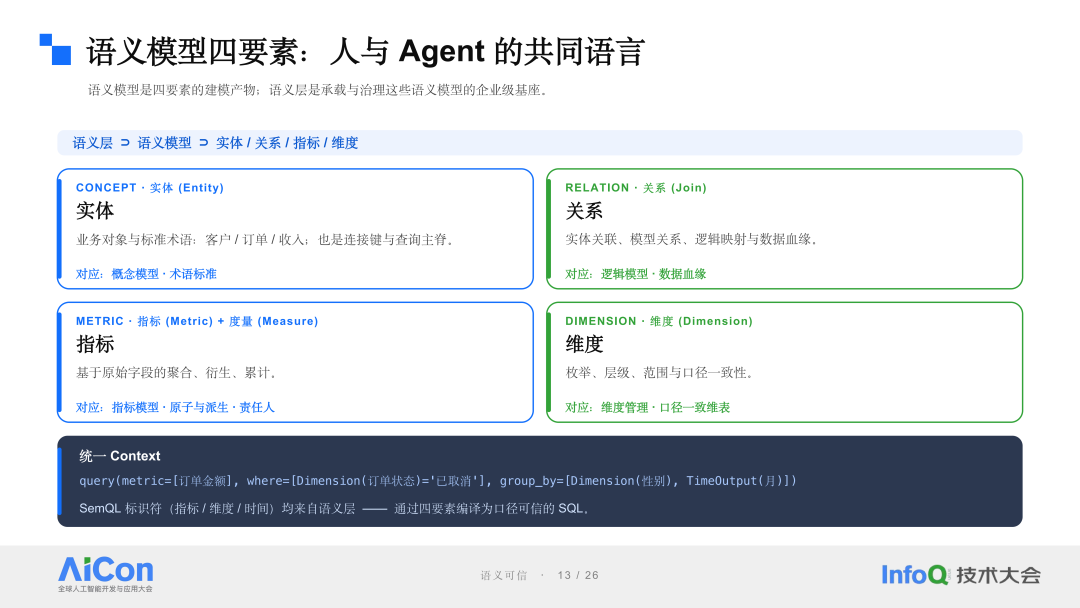
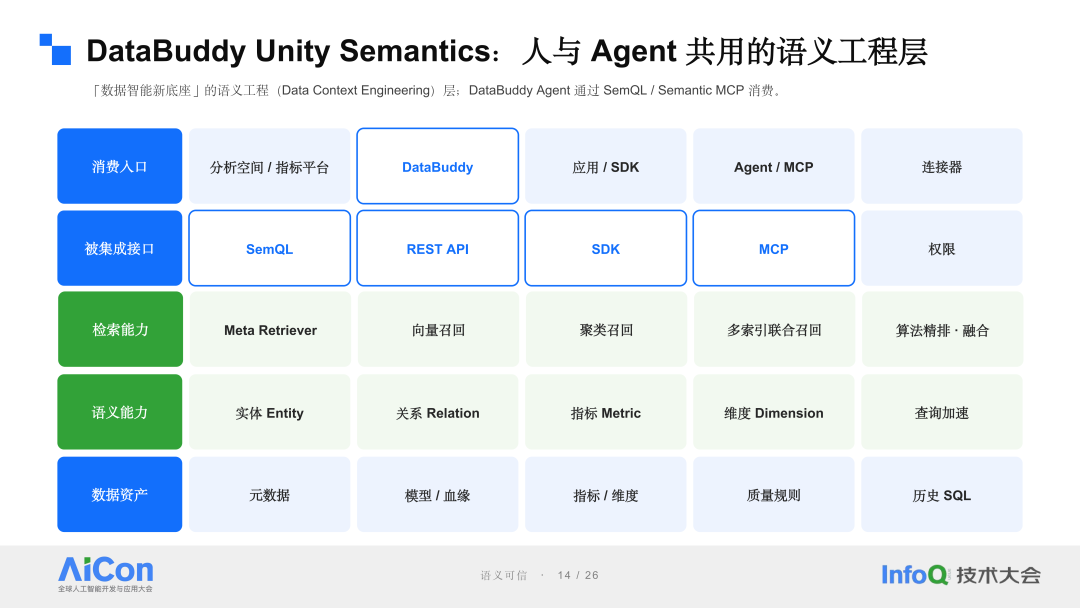
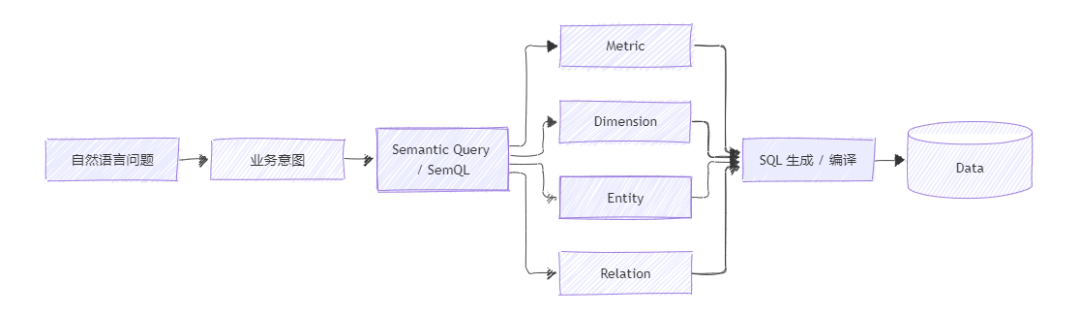
DataBuddy 因此在物理数据与 Agent 之间建立了统一语义层。腾讯云当前的产品文档将语义模型定义为物理表和业务消费之间的一层业务抽象,并将其面向用户的主要对象描述为 Model、Metric 和 Dimension。
| 语义元素 |
描述的问题 |
示例 |
| Entity |
企业中有哪些业务对象 |
客户、订单、商品 |
| Relation |
这些对象之间是什么关系 |
客户拥有订单 |
| Metric |
企业如何计算业务指标 |
GMV、订单数、复购率 |
| Dimension |
企业如何观察和切分指标 |
地区、渠道、时间 |
这样一来,Agent 就不需要首先思考:
应该 Join fact_order 和哪张表?
而可以首先思考:
用户查询的是“订单金额”这个 Metric,需要按照“区域”这个 Dimension 分析。
SQL 不再承担定义业务含义的责任,而更多成为业务语义的一种执行形式。
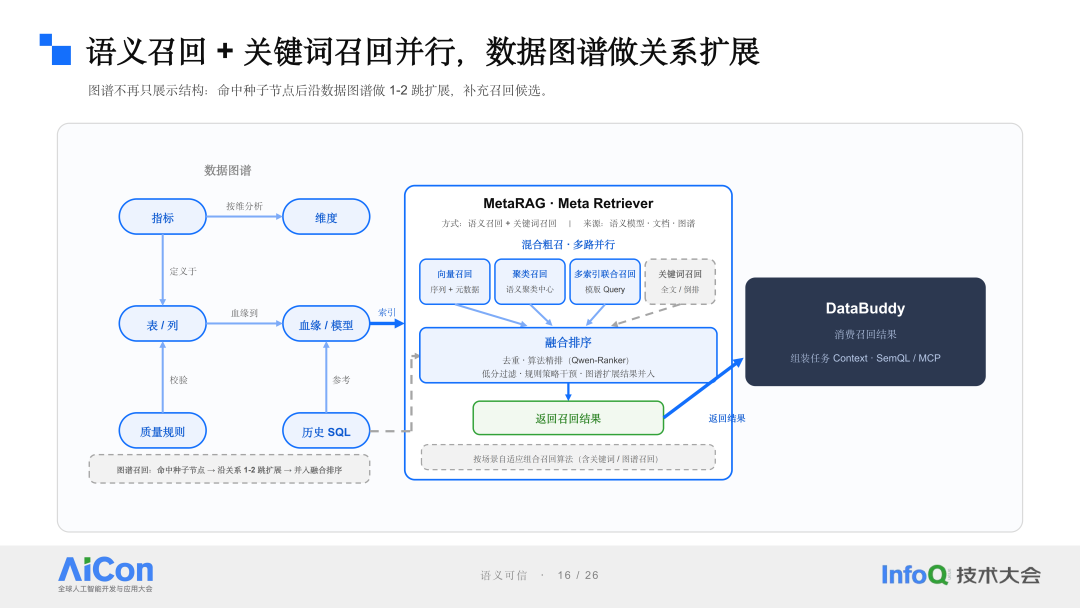
大型企业可能拥有几万张表、几十万个字段、大量指标、血缘关系、质量规则以及历史 SQL,而模型一次任务只需要其中非常小的一部分。
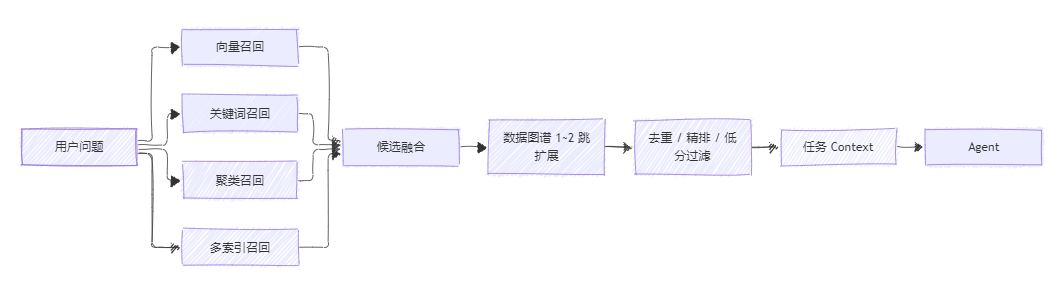
因此,DataBuddy 又在 Semantic Layer 之上建立了 Meta Retriever,用来解决“当前任务到底应该把哪些企业数据知识交给 Agent”的问题。
系统需要根据当前用户身份和任务,从全量企业资产中构造一个最小、相关、可信并且满足权限要求的 Context,然后再交给 Agent 推理。在 DataBuddy 这类 Agent-Native 数据平台中,LLM 的角色已经不只是生成回答,而是作为任务规划与判断的核心参与到数据工程链路中。
DataBuddy Coverage:语义层必须知道自己的边界
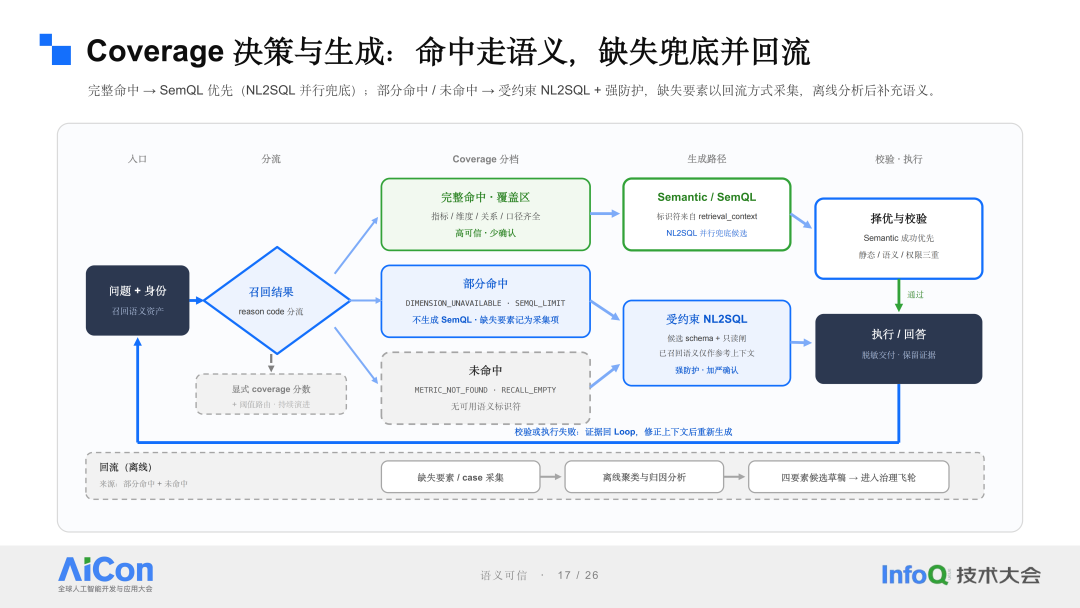
任何企业都很难一次性完成全部数据资产的语义治理,因此 DataBuddy 并没有假设所有问题都能够从 Semantic Layer 中得到完整答案。
| Coverage |
当前状态 |
查询策略 |
| 完整命中 |
指标、维度、关系、口径完整 |
Semantic / SemQL 优先 |
| 部分命中 |
部分语义缺失 |
受约束 NL2SQL |
| 未命中 |
没有可靠语义标识符 |
NL2SQL 兜底并加强控制 |
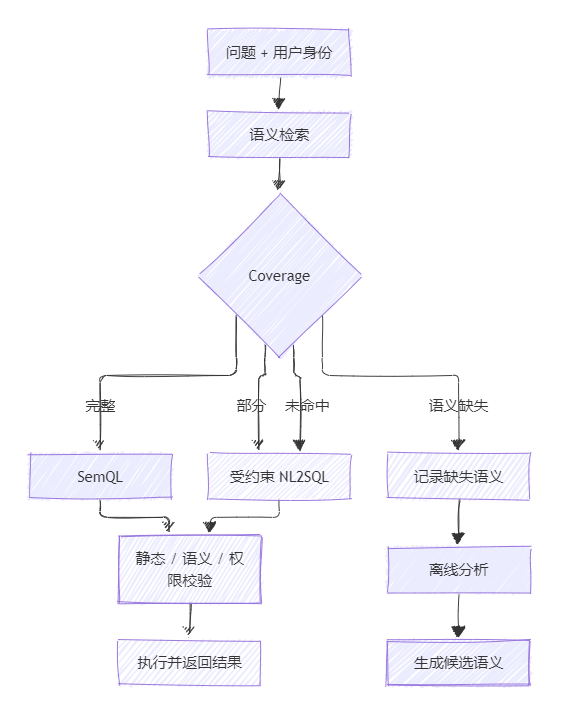
DataBuddy 并没有试图用语义系统彻底取代 NL2SQL,而是将 NL2SQL 作为语义未覆盖区域的兜底机制。当语义资产充分时,系统优先采用确定性更高的 Semantic 路径;当语义资产不足时,系统才退回生成能力更强但风险也更高的 NL2SQL,并相应提高权限、校验和人工确认等级。
DataBuddy 安全控制:限制模型能够造成的影响
DataBuddy 提出了三个需要重点控制的风险要素:敏感数据、非可信内容以及状态改变或外联。当这些风险叠加时,系统需要提升处置级别,而 DDL、DML、任务发布和外部发送等状态改变操作还会独立触发 HITL。
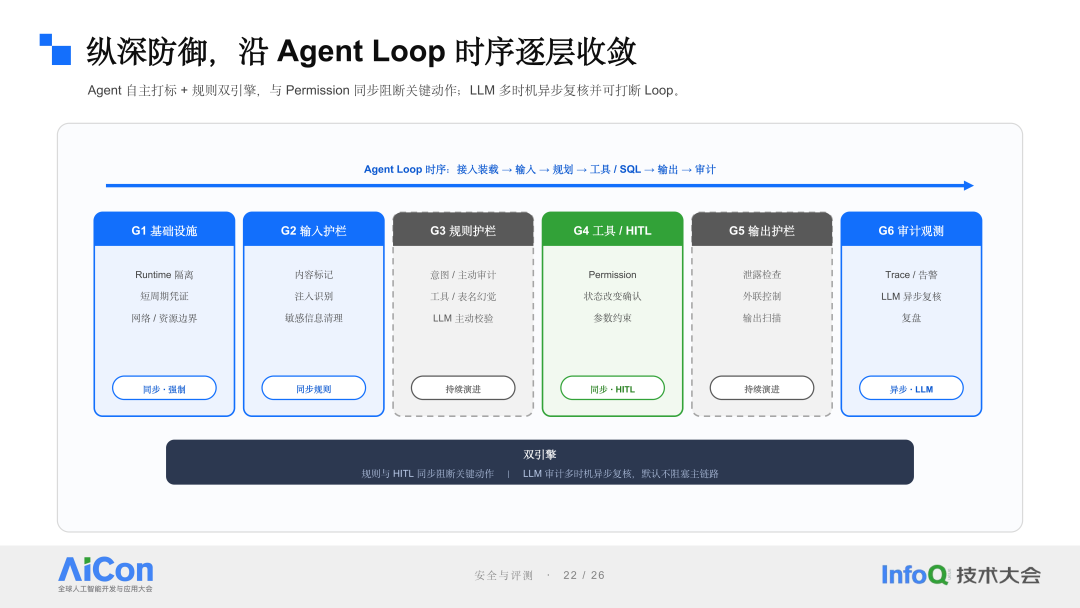
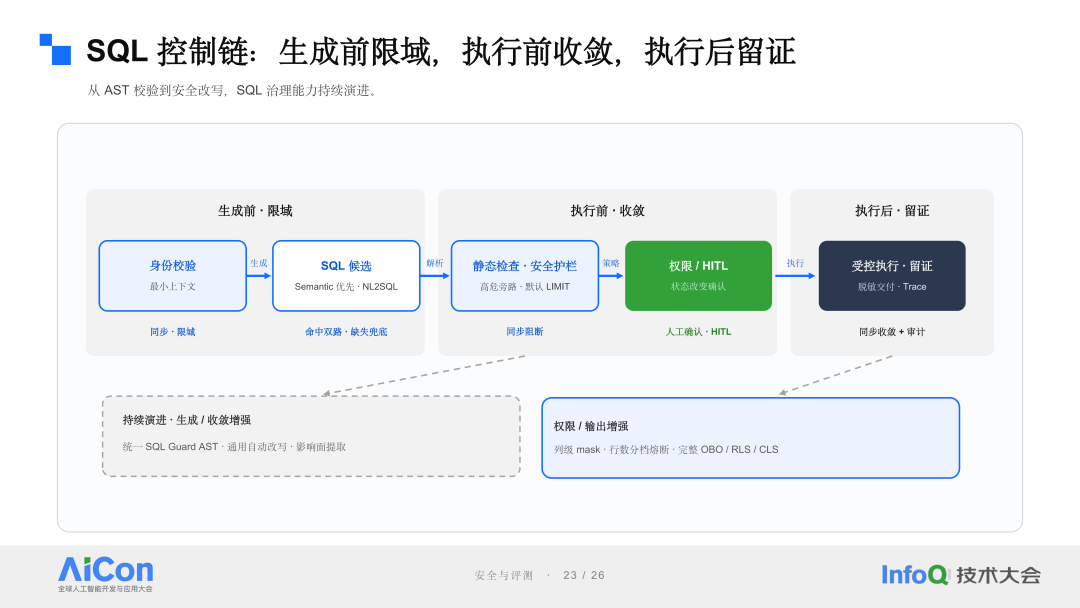
确定性的安全规则负责同步阻断,LLM 更适合承担辅助判断和异步审计。
如果一次生产数据删除操作最终仍然依赖另一个 LLM 判断是否危险,那么系统实际上只是让一个概率模型监督另一个概率模型,并没有真正建立安全边界。
DataBuddy Memory 与治理
DataBuddy Memory 划分为 Session、Personal、Team 和 Enterprise 四个层次。随着作用域扩大,知识的权威程度也逐步提高。
| Memory 层级 |
主要内容 |
权威性 |
| Session |
当前任务上下文和状态 |
低 |
| Personal |
用户偏好和个人经验 |
较低 |
| Team |
团队业务共识 |
较高 |
| Enterprise |
企业级权威知识 |
高 |
DataBuddy 评测闭环
DataBuddy 因此将任务交付拆成三类证据:
| 证据 |
需要回答的问题 |
| Artifact |
最终交付了什么 |
| Trace |
Agent 实际执行了什么 |
| Validation |
为什么可以认为任务已经正确完成 |
对于一个建仓任务来说,Artifact 可以包括 DWD 模型、DDL、SQL 和同步配置;Trace 可以保存某轮 publish_sync_job 的 Tool Call、HITL 请求以及用户确认;Validation 则可以包含 Schema 检查、数据抽样、质量规则和审批结果。
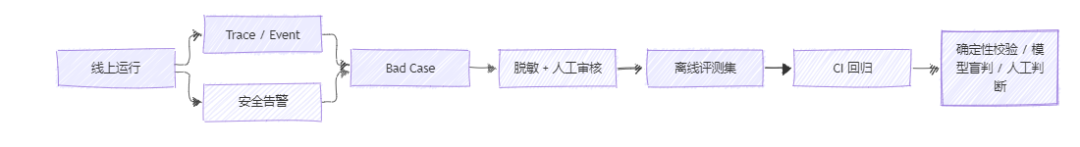
DataBuddy 还进一步把离线评测与线上观测结合起来。离线测试集通过 CI 执行回归,而线上 Trace、安全告警和 Bad Case 在完成脱敏和人工审核以后,又可以重新进入离线评测集。从整体设计来看,DataBuddy 的路径很清晰:它不是再给数据平台加一个聊天入口,而是把数据工程本身拆成可约束、可审计、可回滚的 Agent 任务流。
 发表于 4 天前
|
查看: 11|
回复: 0


