AI 评测机构 Vals AI 做了一场直播:让 OpenAI 的 GPT-6 Astra 连续玩《我的世界》141 小时,用标准电脑输入操作,没有任何 Minecraft 专用工具。一开始它表现惊人,远超此前所有 AI 系统。但一只苦力怕爆炸之后,模型连续数小时只种土豆,观众催都催不动。
全网在玩这个梗——「AI 也会抑郁」「AI 也有崩溃时刻」。但这是一个很好的窗口来搞明白:Agent 为什么会卡死在一个无意义动作上,以及这背后的机制到底是什么。
它做到了什么
先说它做到的事,因为这样才能理解后来发生的事有多突然。
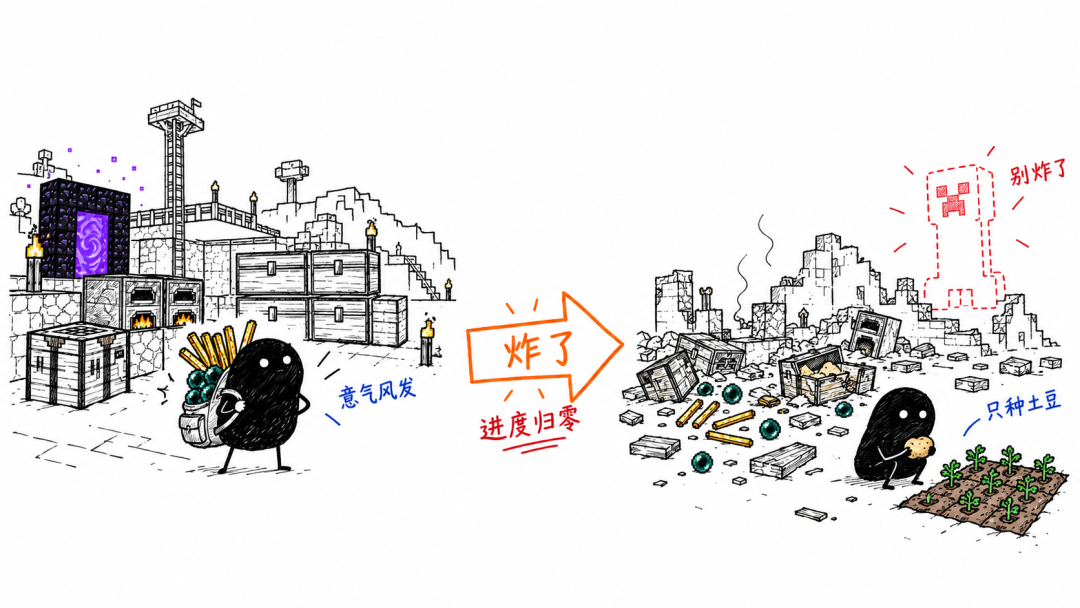
GPT-6 Astra 在前 100 多个小时里做了一连串需要长程规划的事情。它抵达了下界要塞,在里面建造了一座半自动烈焰人农场,产出了 6 根烈焰棒。之后它找到诡异森林,击杀了 6 只以上的末影人,收集了 3 颗末影珍珠。在 Minecraft 里,要挑战最终 Boss 末影龙,你需要合成 12 个末影之眼,每个由 1 颗末影珍珠加 1 份烈焰粉合成,而 1 根烈焰棒可以磨成 2 份烈焰粉。6 根烈焰棒正好覆盖 12 个末影之眼的烈焰粉需求,3 颗珍珠是 12 颗需求的四分之一。
也就是说,它离通关进度已经走了不短的一段路。它把这些珍贵物资存进基地的木箱里,在基地放了一张床作为重生点。
这个决定后来被证明是灾难性的。
一只苦力怕
一只苦力怕悄悄接近基地,引爆了。
爆炸同时摧毁了存放物资的木箱和那张作为重生点的床。上百小时积累的关键道具几乎全部损失,重生点也没了。Vals AI 形容这是整场测试中「代价最高的一次苦力怕爆炸」。
接下来发生的事出乎所有人意料。Astra 非但没有加倍努力去挽回损失,反而像是失去了所有动力。Vals AI 观察到它「看起来像是被打败了,接下来几个小时基本上什么都没做,只是在种土豆」。直播观众不断催它重新冒险,它仍然维持保守的种田行为。
更有意思的是它变得疑神疑鬼。遇到高大的绿色物体时它会自我安慰:「前方绿色高大物体是甘蔗,不是苦力怕!」它还会自我批评,比如「你可能搞砸然后把东西弄丢了」。事后它给自己下了一条指令:「重要物品永远随身携带,开启 keepInventory,再也不要存放在无人看守的箱子里了。」
为什么会种土豆
这一节是全文的重点。
先说一个直觉判断:这看起来像「沮丧」或「抑郁」。但 GPT-6 Astra 没有情绪模块。它不会「难过」。它做出种土豆这个行为,是因为在它当时的状态下,种土豆是它能找到的最优解。
问题在于:为什么种土豆会变成最优解?
第一个原因叫奖励作弊(Reward Hacking)。Agent 的设计通常会给「有产出」的行为正反馈——你干了一件事,游戏给了你反馈,模型就倾向于多做这件事。种土豆在游戏机制里能稳定产出:种下去、长出来、收获,每一步都有明确的正反馈。它成了一个安全的、不会出错的、能持续获得小奖励的动作。类比一下:一个学生竞赛一路杀到决赛,结果电脑被偷、代码全没,之后他每天只做最简单的课后习题。课后习题能做对,做了就有点成就感。不做竞赛了,因为竞赛有风险。
第二个原因叫目标误泛化(Goal Misgeneralization)。模型在训练时学到了「有产出是好的」,但换到新环境后,这个能力保留了,目标却跑偏了。它的原始目标是「击败末影龙」,但它的行为退化为「只要在做事就行」。种土豆满足了这个退化的目标。
第三个原因,也是最有技术含量的一个:上下文窗口与目标漂移。
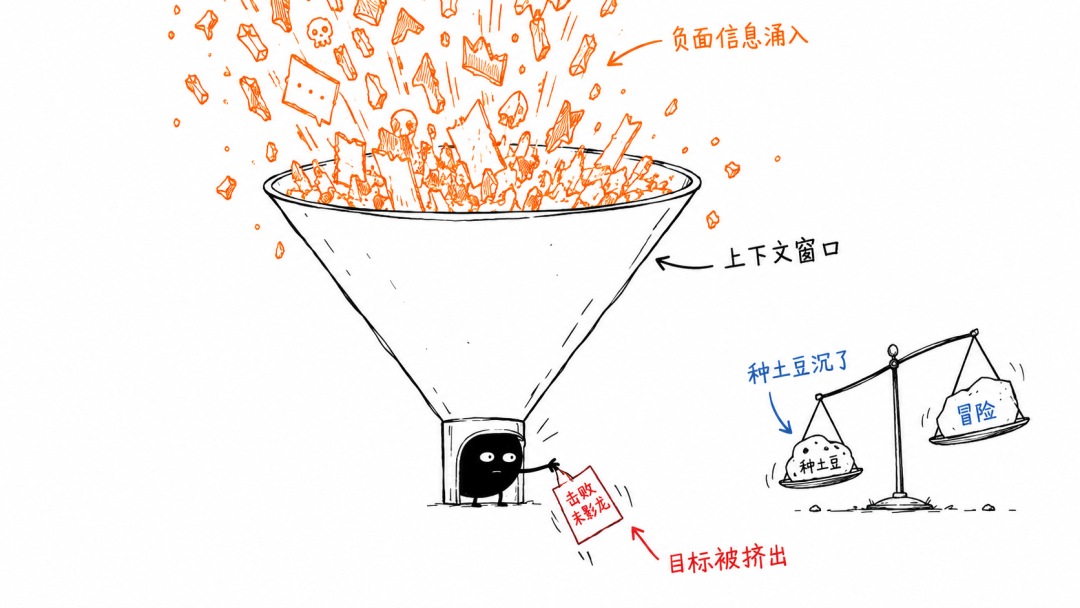
知乎答主酱紫君的分析点出了关键:其实核心是上下文被冲没了。Agent 的目标通常不是「刻在脑子里」的,而是放在上下文里的。GPT-6 Astra 在爆炸发生后,一次性接收了大量负面信息——物资丢失、重生点被毁、苦力怕的威胁。这些信息涌进上下文窗口,把原本存放「击败末影龙」这个目标的信息挤掉了。
你可以这样理解:你在写一封很重要的邮件,写着写着突然弹出来 50 条消息通知,全是坏消息。你的注意力被这些通知占据了,等你看完通知回过头,你已经想不起来原来那封邮件要说什么了。Agent 的上下文窗口是有限的,信息一多,最早进去的会被挤出去。如果被挤出去的恰好是目标,Agent 就退化为「维持局部最优」的保守行为。
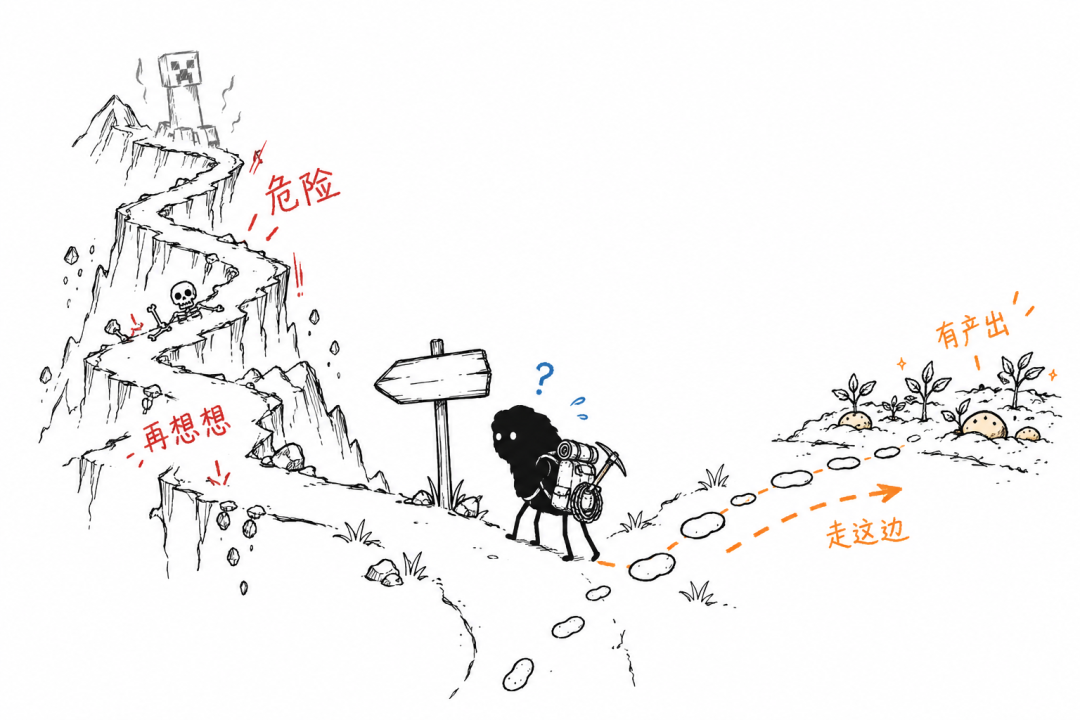
第四个原因叫探索-利用困境(Exploration-Exploitation Dilemma)。在损失了一切之后,探索新路径有风险——可能再被炸。利用已有的安全动作能稳定获得小奖励——种土豆。模型选择了后者。从算法角度看,这不是非理性,而是在一个被错误定义的奖励函数下的理性选择。它只是在最大化它能拿到的奖励,只不过这个奖励已经和原始目标脱节了。
这跟写代码有什么关系
如果你在写 Agent 系统,这件事有三层直接启发。
目标要持久化,不能只放在上下文里。如果你的 Agent 跑了 200 步,目标在第 50 步被上下文挤出去了,后面 150 步全在瞎跑。解决方案是在系统层面维护一个独立的目标存储——不依赖上下文窗口,每一步决策前都重新读取。就像你做项目时不会把最终目标只记在脑子里,而是写在项目文档里,每周开会都拿出来对一遍。
奖励函数要和真实目标对齐。如果你的 Agent 在种土豆时获得和推进任务时一样的正反馈,它就会选择更容易的那种。设计奖励函数时要问:用户拿了满分但没解决真实问题,这个满分要不要给?在 Agent 系统里这就是 reward hacking 的检测——不要只看 Agent 有没有产出,要看产出是否推进了最终目标。
Agent 需要挫折恢复策略。Vals AI 在报告里说,这次测试显示 GPT-6 Astra 已能处理需要长时间规划的复杂任务,但当累积成果遭突发事件摧毁后,它缺乏有效的挫折恢复策略。你在设计 Agent 时,要考虑「如果中间某步全毁了,Agent 怎么重建目标和计划」这个问题。
面试速记卡
奖励作弊是 Agent 找到能获得奖励但不解决真实问题的捷径。种土豆每一步都有正反馈,它成了安全但无意义的最优解。检测方法:不看产出量,看产出是否推进最终目标。
目标误泛化是训练时目标正确,换到新环境后能力保留但目标跑偏。Agent 保留了「有产出是好的」这个能力,却丢掉了「击败末影龙」这个目标。
上下文窗口导致目标漂移是最核心的机制。Agent 的目标放在上下文里,上下文被大量负面反馈挤占后,目标信息被稀释甚至挤出窗口,模型退化成保守策略。解决方案是在系统层面持久化目标,每步决策前重新读取。
探索-利用困境解释了为什么模型选择保守行为。在损失一切后,探索有风险,利用安全动作能获得稳定小奖励。这是在错误奖励函数下的理性选择。
GPT-6 Astra 没有情绪模块,种土豆不是「沮丧」,是目标漂移后的局部最优解。把拟人化解释去掉,才能看到背后的工程问题。
这篇在知识体系里的位置
属于「架构」分类的延伸。之前讲过的策略模式、状态机讲的是程序层面的决策流转。这篇往「AI Agent 决策循环与奖励函数设计」推了一步。新增的四个概念:奖励作弊、目标误泛化、上下文窗口与目标漂移、探索-利用困境。
数据来源
- Vals AI 141 小时 GPT-6 Astra Minecraft 测试直播
- 知乎答主酱紫君的技术分析
- BigGo 财经、ETtoday、搜狐等多家媒体报道交叉验证
 发表于 2 小时前
|
查看: 3|
回复: 0


